 zekayapar
GLM 4.7 Flash: ROCm ve CUDA ortamlarında
Ryzen AI Max+ 395 ve iki RTX 5090 üzerinde aynı BF16 model: kod, JSON, araç çağırma ve eşzamanlı isteklerin sonuçları.
ROCm ortamı
- GLM-4.7-Flash · BF16
- Ryzen AI Max+ 395 · Radeon 8060S
- 128 GB birleşik bellek
- vLLM 0.31.0 · ROCm 7.2.3
- TP1 · BF16 KV · 6 GiB KV
- 16K bağlam · 5 sequence · eager
CUDA ortamı
- GLM-4.7-Flash · BF16
- 2× RTX 5090 · kart başına 32 GB
- Threadripper PRO 5955WX
- vLLM 0.30.0 · CUDA 13.2 paketleri
- TP2 · BF16 KV · 19.872 token KV
- 16K bağlam · 5 sequence · eager
GLM-4.7-Flash’ın aynı BF16 ağırlıklarını iki farklı bilgisayarda çalıştırdım. Bir tarafta 128 GB birleşik belleğe sahip Ryzen AI Max+ 395, diğer tarafta Threadripper PRO 5955WX ve iki RTX 5090 var. Model aynı olsa da bellek düzeni ve çalıştırma biçimi farklı. Bu yüzden tek bir hız sayısıyla karar vermek yerine kod, JSON, araç çağırma ve eşzamanlı istekleri ayrı ayrı ölçtüm.
Her bilgisayarda 153 ölçüm isteği ve bunlardan ayrı 30 ısınma isteği var. Sonuçlarda doğru cevap ile istenen biçimde cevap vermeyi de ayırdım. HTTP 200 almak, örneğin geçerli JSON aldığım anlamına gelmiyor.
İki kurulum
| ASUS | Yapar | |
|---|---|---|
| Donanım | Ryzen AI Max+ 395, Radeon 8060S, 128 GB birleşik bellek | Threadripper PRO 5955WX, 2× RTX 5090 |
| Model dağıtımı | TP1 | TP2 |
| Motor | vLLM 0.31.0 + ROCm 7.2.3 | vLLM 0.30.0 + CUDA 13.2 paketleri |
| Model / KV | BF16 / BF16 | BF16 / BF16 |
| KV bütçesi | 6 GiB | yaklaşık 1 GiB; 19.872 token |
16K bağlam, en fazla 5 aktif sequence, 1.024 token batch, eager çalışma, kapalı prefix cache ve kapalı MTP ortak ayarlar. Düşünme kapalı; sıcaklık 0. Aynı istemler ve aynı puanlayıcı kullanıldı. Seeds 42, 43 ve 44 tekrarları birbirinden bağımsız yeni sorular değildir.
Önce cevaplar
| Kontrol | ASUS | Yapar |
|---|---|---|
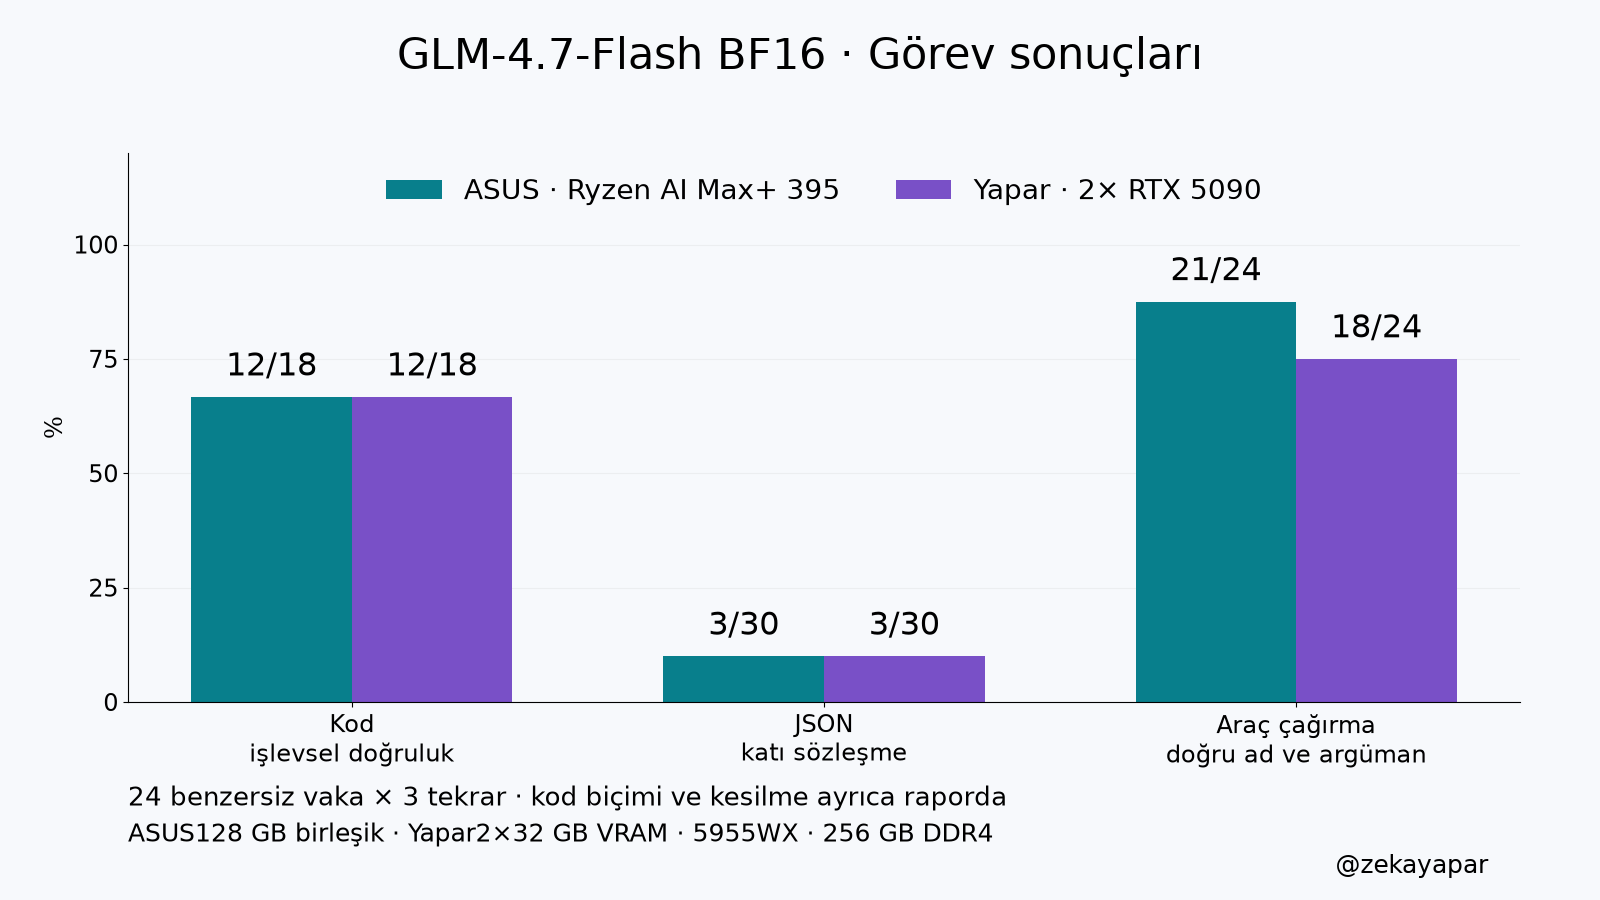
| Kod: testleri geçen ve kesilmemiş | 12/18 | 12/18 |
| JSON: katı sözleşmeye uygun ve doğru | 3/30 | 3/30 |
| Araç: doğru ad ve argümanlar | 21/24 | 18/24 |
Kodun yalnız istenen kaynak biçiminde gelmesi ASUS’ta 3/18, Yapar’da 6/18. Kod testlerini geçmek ile Markdown kullanmama şartını yerine getirmek farklı kontroller. İşlevsel kontrolde varsa dış Markdown çiti ayrılıyor; fonksiyonun kodu düzeltilmiyor.
Yük bölümündeki 81 kayıt çıkarma yanıtının hiçbirinde iki cihaz da katı çıktı sözleşmesini geçemedi: sonuç iki tarafta da 0/81. Cevabın sözleşmesi hızdan ayrı kontrol ediliyor. Grafiklerdeki hız, doğru cevabın hızı diye okunmamalı; her şeklin başarı sayısı ayrıntılı tabloda birlikte veriliyor. Bu küçük görev seti genel kodlama ya da muhakeme sıralaması değil.
Araç çağırmadaki fark üç bağımsız soru değil: aynı stok sorusunun üç tekrarında ASUS depo argümanını izmir, Yapar İzmir üretti. Sabit altın sözleşme küçük harfli izmir beklediği için Yapar üç puan kaybetti. Kod biçimindeki fark da aynı fonksiyonun üç tekrarında Markdown çiti kullanılıp kullanılmamasından geliyor. Bu ayrıntılar genel kalite yorumu yapmayı sınırlar.
İstekler çoğalınca
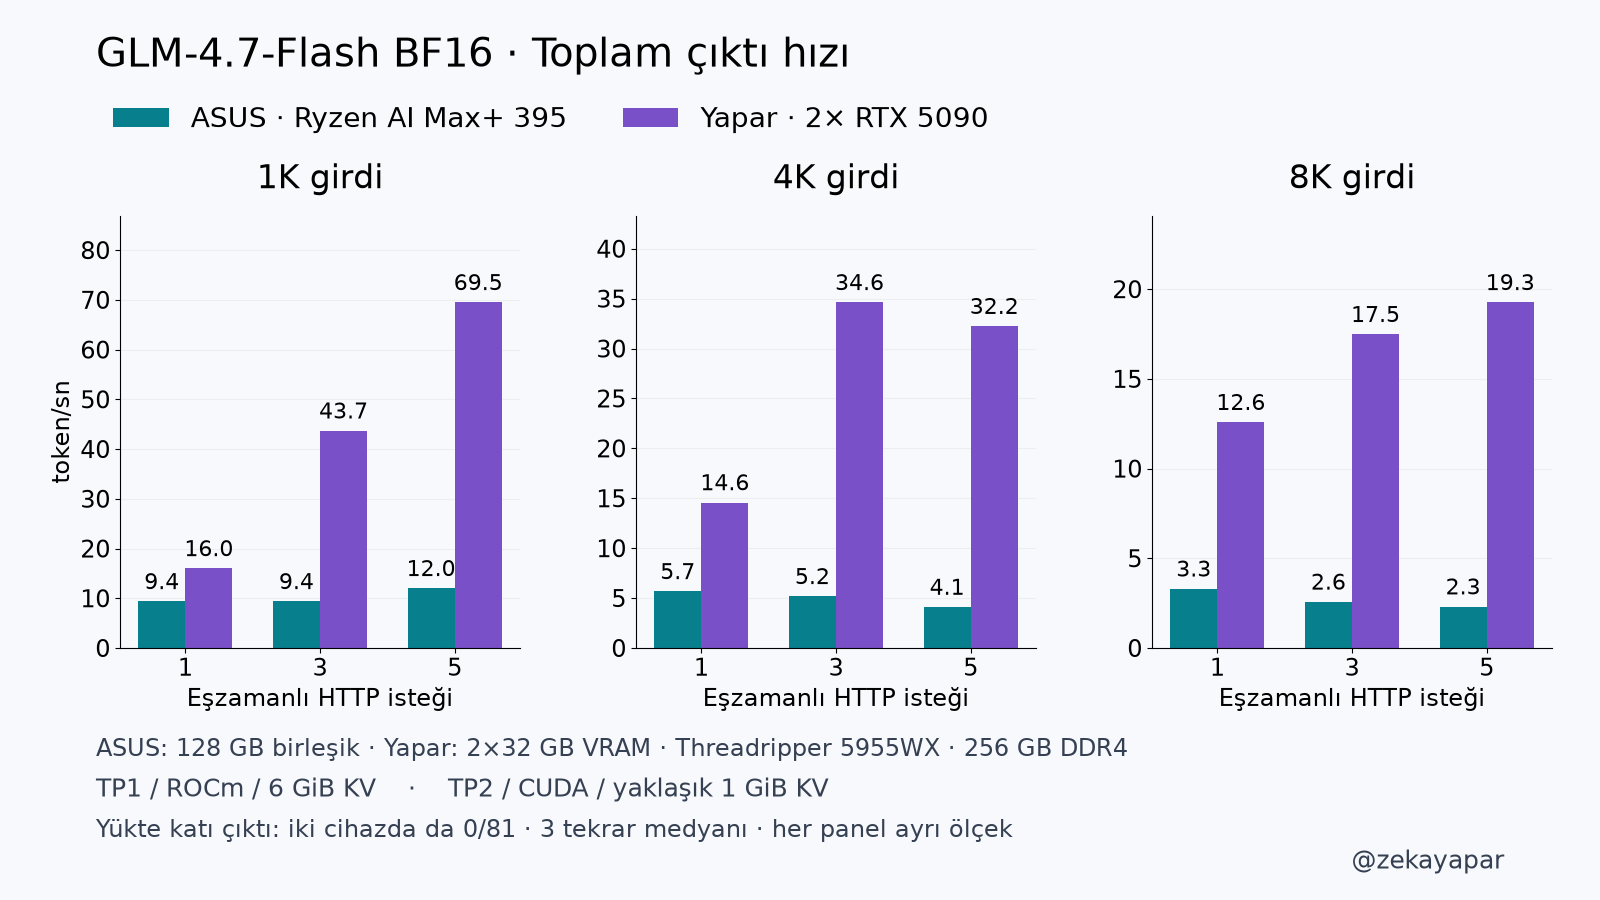
1K, 4K ve 8K hedef girdileri 1, 3 ve 5 eşzamanlı HTTP isteğiyle, her koşulu üç kez tekrarlayarak çalıştırdım. Çıktılar en fazla 256 token; doğal bitiş korunuyor. Modelden her yanıtta 256 token üretmesini zorlamadım. Bu nedenle kısa kayıt çıkarma cevaplarının toplam hızını, uzun metin üretme kapasitesi diye kullanmıyorum.
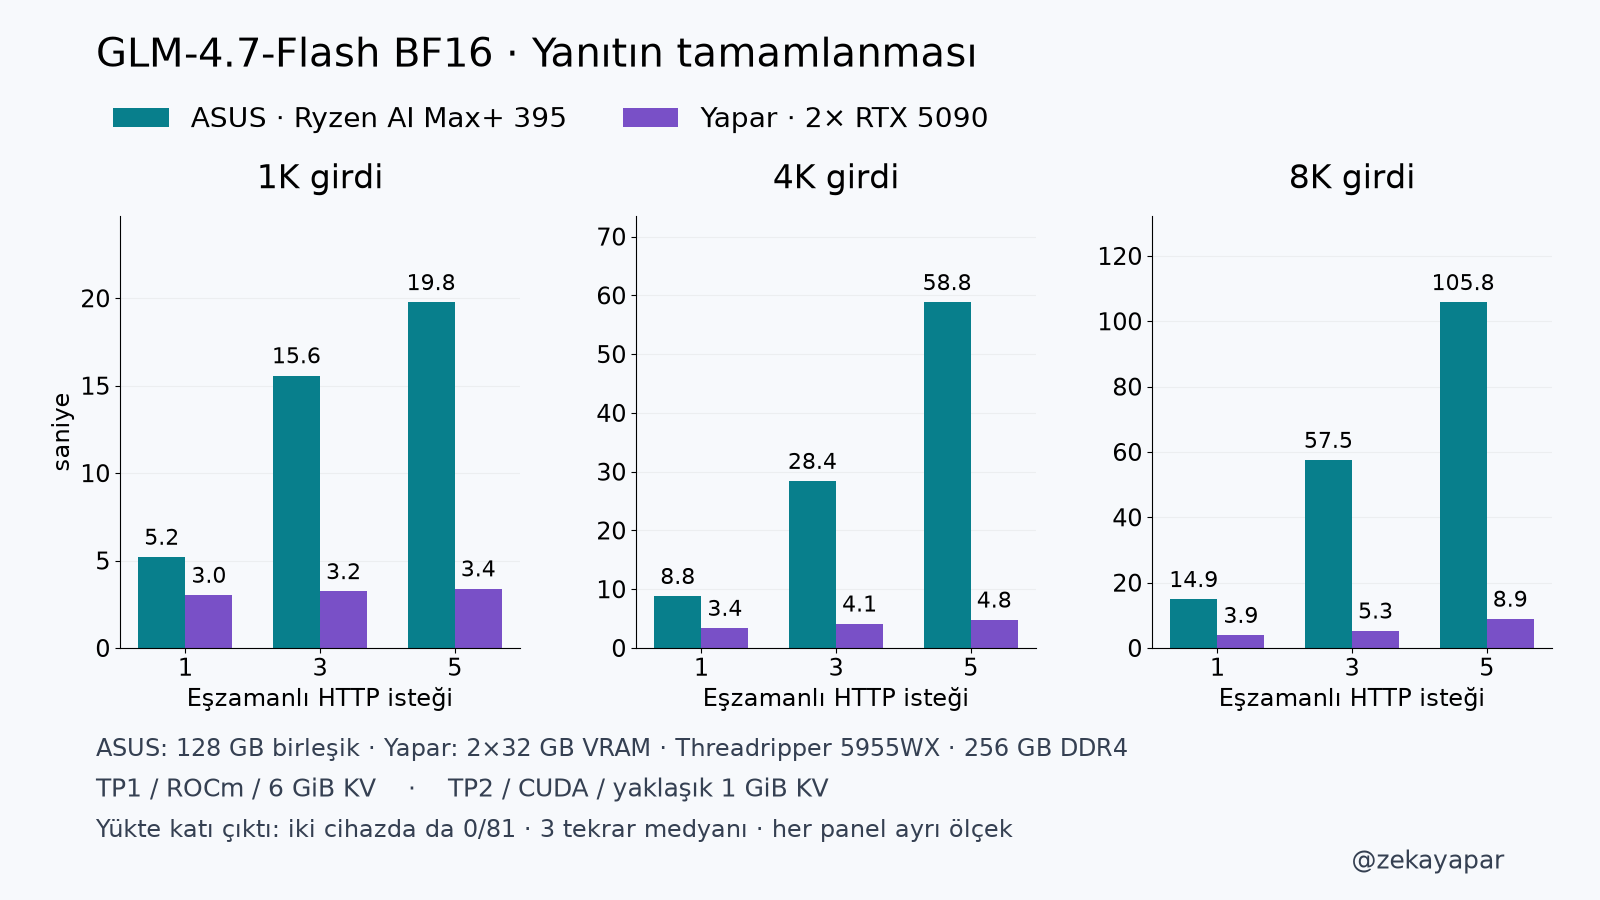
| Girdi / istek | ASUS toplam token/sn | Yapar toplam token/sn | ASUS E2E sn | Yapar E2E sn |
|---|---|---|---|---|
| 1K / 1 | 9,37 | 16,00 | 5,20 | 3,03 |
| 1K / 3 | 9,37 | 43,68 | 15,58 | 3,24 |
| 1K / 5 | 11,99 | 69,49 | 19,76 | 3,39 |
| 4K / 1 | 5,67 | 14,58 | 8,80 | 3,38 |
| 4K / 3 | 5,17 | 34,63 | 28,39 | 4,11 |
| 4K / 5 | 4,10 | 32,24 | 58,80 | 4,78 |
| 8K / 1 | 3,30 | 12,58 | 14,89 | 3,92 |
| 8K / 3 | 2,57 | 17,48 | 57,48 | 5,25 |
| 8K / 5 | 2,30 | 19,26 | 105,78 | 8,87 |
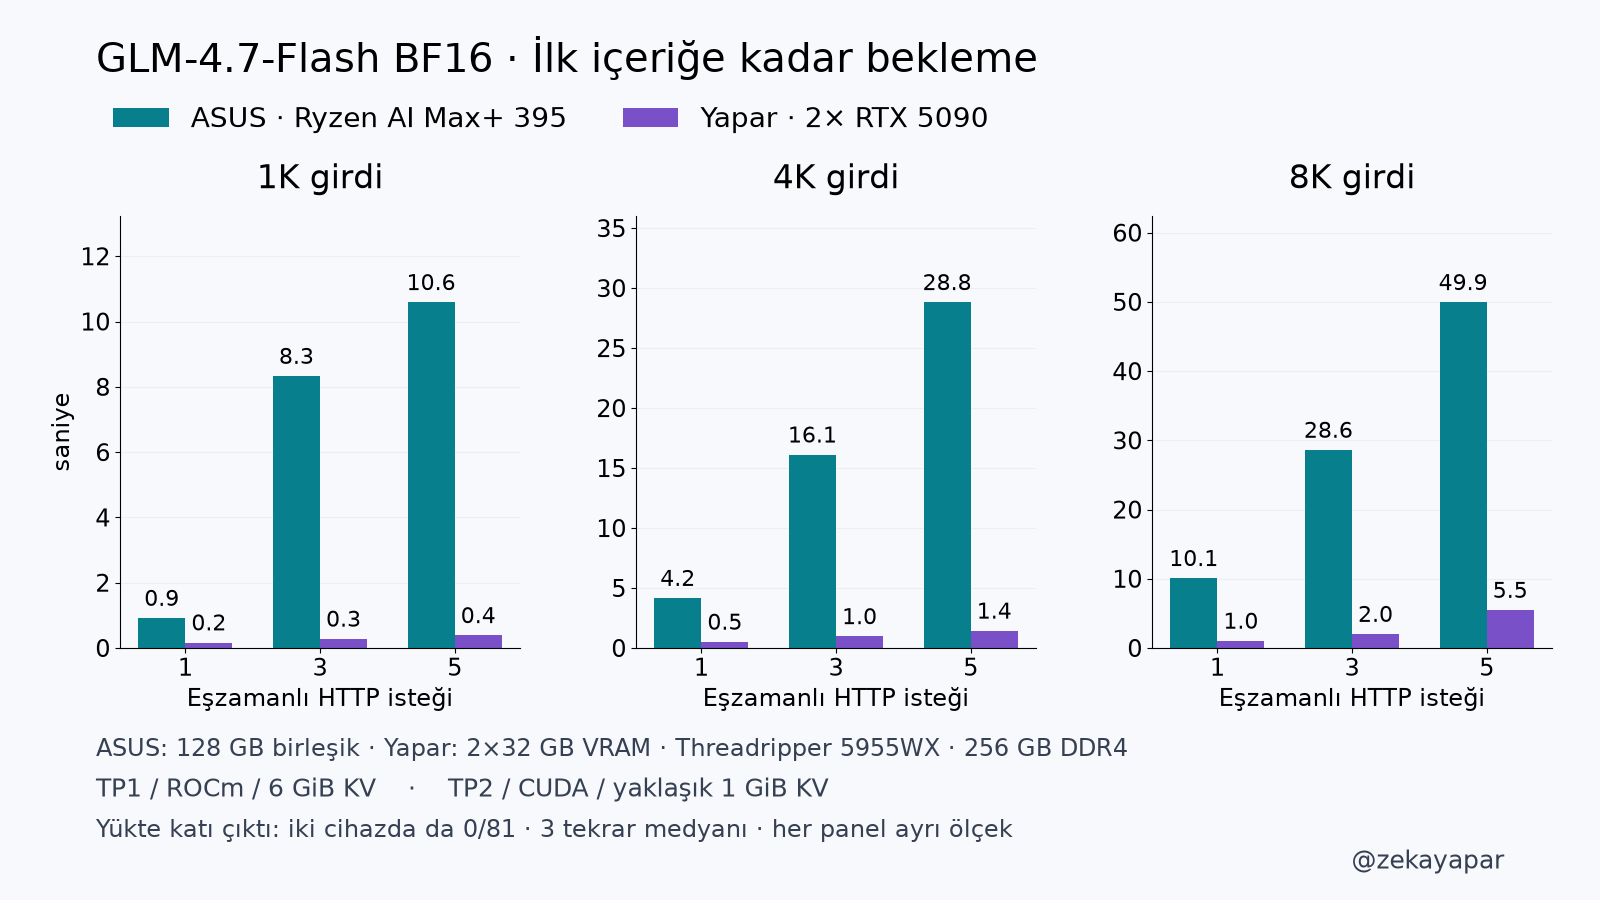
Toplam çıktı hızı, partide üretilen bütün çıktı tokenlarının ilk istek başlangıcı ile son isteğin bitişi arasındaki süreye bölünmesi. E2E, tek isteğin gönderilmesinden bitmesine kadar geçen süre. Tabloda üç partinin toplam hız medyanı ile o koşuldaki isteklerin E2E medyanı gösteriliyor; ikisi aynı süre değildir. İlk içeriğe kadar bekleme de ayrı grafikte.
Bellek farkı sonucu etkiliyor
Yapar’da ağırlıklar kart başına yaklaşık 28,08 GiB tuttu. KV için kalan alan iki kartta da aynı uzunlukta beş isteği bellekte tutmaya yetmiyor. Beş HTTP isteğini birlikte göndermek, beş isteğin bütün KV verisinin aynı anda GPU’da kalması anlamına gelmiyor. Motorun bekletmesi veya yeniden hesaplaması gecikmenin parçası. İki tarafta da tüm koşuyu kapsayan sayısal preemption sayacı arşivi yok; boş log eşleşmeleri veya birkaç log görüntüsü sıfır preemption kanıtı değil. ASUS’taki 6 GiB KV ile bu farkı görmezden gelip sonucu yalnız GPU markasına bağlayamam.
CUDA/ROCm sürümleri, TP1/TP2 dağıtımı, işlemciler ve kernel yolları da farklı. ASUS tarafında attention LSE düzeni için yalnız başlatılan süreçte uygulanan bir adaptör var; sayısal kontrolü ve kaynak kodu teknik kayıtta duruyor. Sonuçlar bu iki kurulum için; bütün AMD veya NVIDIA cihazları için değil.
İstek ve token bütçesi
ASUS: 153 ana istek, 372.998 girdi ve 6.217 çıktı tokenı; 0 HTTP/SSE hatası, 0 kesilme. Yapar: 153 ana istek, 372.998 girdi ve 6.256 çıktı tokenı; 0 transport/istemci hatası. 129 yanıt doğal bitişle, 24 yanıt araç çağrısıyla tamamlandı; kesilme yok.
Isınma, model indirme, yükleme, kernel derleme ve ön kabul bu token/süre toplamlarına dahil değil. HTTP sürelerini toplamak da eşzamanlı istekler nedeniyle toplam duvar saati süresi vermez. Güç ve enerji için bağımsız ölçüm yapılmadı.
Aynı deneyi tekrarlamak
24 benzersiz kalite vakası: 6 Python fonksiyonu, 10 JSON/mantık sorusu, 8 sentetik araç çağrısı. Her biri üç seed ile ölçüldü. Yük tarafında 9 farklı girdi/eşzamanlılık şekli, üçer parti var. Kod için 1.024, diğer kalite vakaları için 512 çıktı tokenı üst sınırı kullanılıyor. Kod çıktıları onarılmadan sınırlı çalıştırıcıda test ediliyor; JSON ve araç sözleşmeleri altın sonuçla karşılaştırılıyor.
Model kaynağı: GLM-4.7-Flash resmî model sayfası ↗ . Sabit revision: 7dd20894a642a0aa287e9827cb1a1f7f91386b67. İstemler, gerçek token sayıları, örnek yanıtlar, ayarlar ve hata kayıtları aynı ölçüm paketinde tutuluyor.