 zekayapar
Local LLM ne zaman mantıklı? Yazılım geliştirmede hız, kalite ve maliyet
Altı yerel model ve Codex ile aynı yazılım görevleri: çalışan teslimler, hız, tokenlar ve donanım, abonelik, API maliyetleri.
Kısa Özet
Yazılım işleri için sıfırdan pahalı bir bilgisayar almayı düşünüyorsam, önce ihtiyacımı karşılayan cloud aboneliğiyle başlarım. İşlerim kullanım sınırları içinde bitiyorsa donanım yatırımı gerekmeyebilir. Daha pahalı pakete geçme gerekçem de yalnız model adı değil, işimi kesen limitler ve bekleme olur.
Bilgisayar zaten elimdeyse, verinin dışarı çıkmaması gerekiyorsa veya aynı tür işleri sürekli tekrarlıyorsam local daha anlamlı olabilir. Ama modelin o işleri güvenilir biçimde bitirmesi gerekiyor; elektrik kadar kurulum, bakım ve yanlış kodu düzeltme zamanı da hesabın içinde.
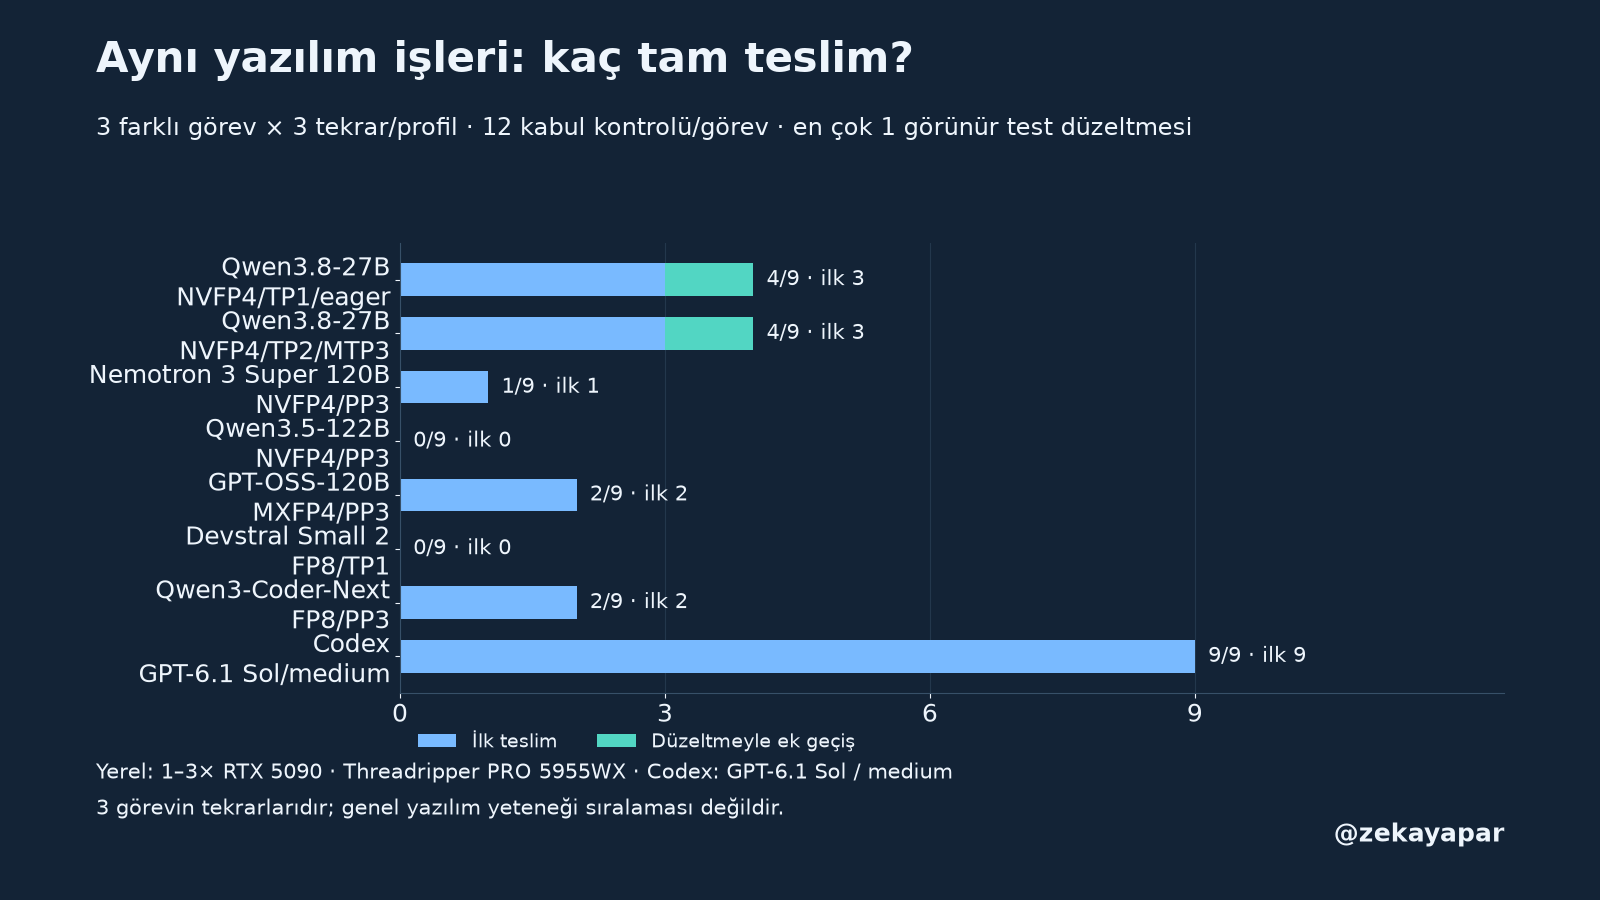
Bu çalışmada altı yerel model ve Codex’i, Qwen’in iki ayarıyla toplam sekiz profilde aynı üç yazılım görevinde karşılaştırdım. Her görev üç kez tekrarlandı. Tam geçen teslimler:
| Çalışan profil | İlk teslim | Görünür test düzeltmesi sonrası |
|---|---|---|
| Codex · GPT-6.1 Sol | 9/9 | 9/9 |
| Qwen3.8-27B · NVFP4/TP1/eager | 3/9 | 4/9 |
| Qwen3.8-27B · NVFP4/TP2/MTP3 | 3/9 | 4/9 |
| GPT-OSS-120B · MXFP4/PP3 | 2/9 | 2/9 |
| Qwen3-Coder-Next · FP8/PP3 | 2/9 | 2/9 |
| Nemotron 3 Super 120B · NVFP4/PP3 | 1/9 | 1/9 |
| Qwen3.5-122B · NVFP4/PP3 | 0/9 | 0/9 |
| Devstral Small 2 · FP8/TP1 | 0/9 | 0/9 |
Bu koşullarda Codex bütün işleri ilk seferde tamamladı; yerel profillerin hiçbiri ana turda 9/9’a ulaşmadı. Sıfır tam geçiş, hiçbir kontrolün geçilmediği anlamına gelmiyor; bazı teslimler iş kurallarında, bazıları çıktı sözleşmesinde kaldı. Kabul hatalarını da verdiğim sonraki geliştirme turu bu tablodan ayrı. Profillerin hassasiyeti, düşünme ve kart dağılımı farklı; bu sonuç üç küçük görev için geçerli, genel model sıralaması değil.
Benim için pratik seçim: zor ve değişken geliştirme işlerinde cloud, ölçüp güvenebildiğim tekrar işlerinde veya veri kontrolü gerektiğinde local; uygunsa ikisi birlikte. Abonelik, API ve yeni donanım maliyeti ayrı hesaplar. Bu test tek başına 20 dolarlık paketin ay boyunca yeterli olacağını göstermiyor.
Test bilgisayarı
- Threadripper PRO 5955WX
- 3× RTX 5090 · toplam 96 GB sınıfı VRAM
- Ubuntu 26.04.1 LTS · NVIDIA 595.99.02
Yerel çalışma ortamı
- vLLM 0.30.0 · PyTorch 2.13.0+cu132
- Python 3.12.15 · CUDA
- 6 model · Qwen için iki ayrı profil
Cloud ölçümü
- Codex CLI · GPT-6.1 Sol
- Medium reasoning · araçsız kod teslimi
- Mevcut ChatGPT aboneliği
Görevler ve değerlendirme
- Python standart kütüphane · SQLite · JSONL
- 3 farklı görev × 3 tekrar × 8 profil
- 72 birincil teslim · düzeltme turları ayrı
Hazırlıkta karşılaştığım sorunlar ve çözümleri → çalışma notu
Ayda 20 dolarlık bir abonelik yaptığım işleri bitiriyorsa, sırf daha az token ücreti ödemek için pahalı bir bilgisayar toplamak bana ne kazandırır? Bilgisayar zaten elimdeyse aynı hesabın sonucu değişir mi? Gün boyu çalışan bir otomasyonla, akşam birkaç hata düzelten bir geliştiricinin tercihi aynı mı olmalı?
Bu rehberde bu sorulara bakıyorum. Yerel tarafta Qwen3.8-27B ile başlayıp aynı yazılım görevlerini farklı modellere de veriyorum. Hız, çalışan sonuç, düzeltme ihtiyacı ve maliyeti birlikte değerlendiriyorum. Veri kontrolü ve şirket içi kullanım da kararın bir parçası.
Bir modeli sevdiğim için bütün işleri ona vermek zorunda değilim. İşe ve kullanım yoğunluğuna göre local, abonelik, API veya bunların birlikte kullanılması daha mantıklı olabilir.
Kullanılan teknolojiler ve ortam
- Test bilgisayarı: AMD Threadripper PRO 5955WX, 3× RTX 5090; her kartta 32 GB sınıfı VRAM, toplam 96 GB sınıfı.
- Yerel modeller: Qwen3.8-27B NVFP4, Nemotron 3 Super 120B NVFP4, Qwen3.5-122B NVFP4, GPT-OSS-120B MXFP4, Devstral Small 2 FP8 ve Qwen3-Coder-Next FP8.
- Yazılım: Ubuntu 26.04.1 LTS · NVIDIA 595.99.02 · vLLM 0.30.0 · PyTorch 2.13.0+cu132 · Python 3.12.15. Görevler standart kütüphane, SQLite ve JSON kullanıyor.
- Cloud ölçümü: mevcut ChatGPT oturumuyla Codex CLI, GPT-6.1 Sol, medium reasoning. Claude bu ortamda performans testine alınmadı; yazıda abonelik ve kullanım seçeneği olarak değerlendirilir.
96 GB üç kartın toplamı. Bu, tek kartta 96 GB olmasıyla aynı yerleşim ve iletişim koşullarını sağlamıyor. Bu rehberde dördüncü kart kullanılmıyor.
Modelleri nasıl çalıştırdım?
| Profil | Ağırlık formatı | Kullanılan RTX 5090 | Çalışma ayarı | Düşünme |
|---|---|---|---|---|
| Qwen3.8-27B · NVFP4/TP1/eager | NVFP4 | 1 | Tek GPU · eager · MTP kapalı · KV BF16 | kapalı |
| Qwen3.8-27B · NVFP4/TP2/MTP3 | NVFP4 | 2 | TP2 · MTP3 · CUDA graph · KV BF16 | kapalı |
| Nemotron 3 Super 120B · NVFP4/PP3 | NVFP4 | 3 | PP3 · CUDA graph · MTP kapalı · KV FP8 E4M3 | varsayılan; akışta gözlendi |
| Qwen3.5-122B · NVFP4/PP3 | NVFP4 | 3 | PP3 · CUDA graph · MTP kapalı · KV FP8 E4M3 | kapalı |
| GPT-OSS-120B · MXFP4/PP3 | MXFP4 | 3 | PP3 · CUDA graph · MTP kapalı · KV BF16 | varsayılan; akışta gözlendi |
| Devstral Small 2 · FP8/TP1 | FP8 | 1 | Tek GPU · CUDA graph · MTP kapalı · KV auto | non-thinking |
| Qwen3-Coder-Next · FP8/PP3 | FP8 | 3 | PP3 · CUDA graph · MTP kapalı · KV auto | non-thinking |
Tek GPUya sığan Qwen ve Devstral adaylarında kartlar arası iletişim eklemiyorum. Qwen için mevcut iki kartlı MTP profili de ayrı ölçüldü. Ön turda kullanılan yavaş iki kartlı eager denemesi ana ölçüm dışında saklanıyor. Bu profillerin her biri pratik çalışan bir seçenek; bütün adaylar için maksimum hız ayarı araması yapılmadı.
TP2, modeldeki hesapları iki karta tensor paralelliğiyle dağıtıyor; PP3 katmanları üç aşamaya bölüyor. MTP, Multi-Token Prediction: kullandığım MTP3 ayarı adım başına üç taslak token öneriyor, doğrulananlar kabul ediliyor. Her adımda kesin üç token kazancı anlamına gelmiyor. vLLM speculative decoding.
CUDA graph, tekrar eden GPU işlerini kaydedip yeniden çalıştırarak çağrı yükünü azaltan çalışma yolu. Graph kapalı eager kolunu ayrı kontrol olarak tutuyorum. Eager profili de CUDA üzerinde çalışıyor; bu profilde graph kaydı ve tekrarı kapalı. Yerel adayların tamamı GPU üzerinde çalıştırıldı. Bu çalışmada GPU sayısı, graph ve MTP birlikte değiştiği için hız farkını tek bir ayara bağlamıyorum. NVIDIA CUDA Graphs.
Aynı işi ne kadar iyi bitiriyorlar?
Üç farklı yazılım işi hazırladım:
- Hata düzeltme: Mevcut bir fatura hesabındaki float, yuvarlama ve tür kontrolü hatalarını giderme. Çok büyük tutarlar, bütün faturaya uygulanan indirim ve bool değerlerin yanlışlıkla sayı sayılması da sözleşmede var.
- Özellik ekleme: SQLite ticket projesine tenant yalıtımı, etiket, arama, sıralama ve sayfalama ekleme. Bir tenant başka tenant'ın kaydını görememeli veya kapatamamalı.
- Yeni araç: JSONL loglarını okuyan bir CLI geliştirme. Bozuk satırlar, tekrar eden kayıtlar, doğru p95 hesabı ve büyük tamsayıların korunması gerekiyor.
Her görev için 12 kabul kontrolü var. Bir kontrol birden fazla girdiyi sınayabiliyor; 12/12, on iki satır kodun kontrolü değil, o görev için yazılmış testlerin geçmesi anlamına geliyor. Örneğin fatura isteminde satırın tam olarak belirtilen alanlardan oluşması isteniyor; fazladan alanı sessizce kabul eden bir teslim 11/12’de kalabiliyor. Bu, kodun bütünüyle işe yaramadığı anlamına gelmiyor, fakat sözleşmeyi tam karşılayan teslim de değil. Her çalışma profiline, her görev için üç bağımsız teslim yaptırıyorum: profil başına 9 teslim, fakat 3 farklı görev. Altı yerel model, Qwen için iki ayar ve bir Codex koluyla toplam 8 profil / 72 birincil teslim var. Tekrarlar yeni birer problem gibi sayılmıyor. Referans uygulamalar toplam 36/36 kontrolü geçti; bilinçli olarak bozulan üç teslim de testler tarafından reddedildi.
Yerel çağrılarda 16K bağlam ve en çok 8.192 çıktı tokenı kullanıyorum. Düşünme varsa aynı çıktı bütçesinin içinde. Sınıra gelip kesilen teslim tam geçiş sayılmıyor. Codex CLI tarafında sağlayıcının kendi çıktı sınırı var; aynı 8.192 üst sınırını CLI’ye uygulamıyorum. Bu da çalışan profiller arasındaki farklardan biri.
İlk teslimi ve izin verilen düzeltmeden sonraki sonucu ayrı tutuyorum. Düzeltme için yalnız görünür başlangıç testi veya teslim biçimi hatası bildiriliyor. Birincil turda gizli kabul testlerinin hatalarını modele vermiyorum. Kodları ben düzeltmiyorum.
Bu, küçük ama gerçek iş kuralları olan yazılım teslimlerinin karşılaştırması. Büyük bir SaaS projesinin bütün geliştirme sürecini veya her tür kodlama işini temsil etmiyor. Modellerin dosya gezip terminalde kendi testlerini çalıştırdığı sınırsız ajan karşılaştırması da değil: bu turda hepsinden aynı başlangıç dosyalarından bir teslim alınıyor. Kaynak dosyalarını bir JSON nesnesinde döndürmelerini istedim; bu koşuda JSON schema ile biçimi zorlamadım. Dosya yazma araçları, constrained decoding veya farklı bir ajan düzeni kullanıldığında sonuçların nasıl değişeceği burada ölçülmedi.
Ölçümde ne çıktı?
Üç farklı görev, her biri üç bağımsız tekrar. Aşağıdaki tam geçiş, teslimin o görevdeki 12 kabul kontrolünün tamamını geçmesi demek.
| Profil | İlk teslim | Görünür test düzeltmesi sonrası | Son kabul puanı | Toplam çağrı | Teslim başına ortanca çağrı süresi | Uçtan uca çıktı token/sn |
|---|---|---|---|---|---|---|
| Qwen3.8-27B · NVFP4/TP1/eager | 3/9 | 4/9 | 103/108 | 11 | 147.3 sn | 10.0 |
| Qwen3.8-27B · NVFP4/TP2/MTP3 | 3/9 | 4/9 | 101/108 | 11 | 8.0 sn | 171.1 |
| Nemotron 3 Super 120B · NVFP4/PP3 | 1/9 | 1/9 | 56/108 | 14 | 219.9 sn | 63.1 |
| Qwen3.5-122B · NVFP4/PP3 | 0/9 | 0/9 | 85/108 | 10 | 22.2 sn | 90.9 |
| GPT-OSS-120B · MXFP4/PP3 | 2/9 | 2/9 | 100/108 | 11 | 17.0 sn | 204.8 |
| Devstral Small 2 · FP8/TP1 | 0/9 | 0/9 | 80/108 | 13 | 47.9 sn | 29.2 |
| Qwen3-Coder-Next · FP8/PP3 | 2/9 | 2/9 | 33/108 | 15 | 15.4 sn | 188.8 |
| Codex · GPT-6.1 Sol/medium | 9/9 | 9/9 | 108/108 | 9 | 21.4 sn | 46.6 |
Kullandığım Qwen TP2/MTP3 profilinde teslim başına ortanca çağrı süresi 8.0 sn, Codex kolunda 21.4 sn çıktı. Qwen ilk 3/9, görünür düzeltme sonrası 4/9 tam geçiş aldı; Codex ilk 9/9. Bu yüzden kısa yanıt süresini tek başına bitmiş iş saymıyorum. Kabul hatalarını sonradan verdiğim ayrı Qwen geliştirme turunda sonuç 8/9 oldu; o turun ek çağrıları ve süresi aşağıda ayrı.
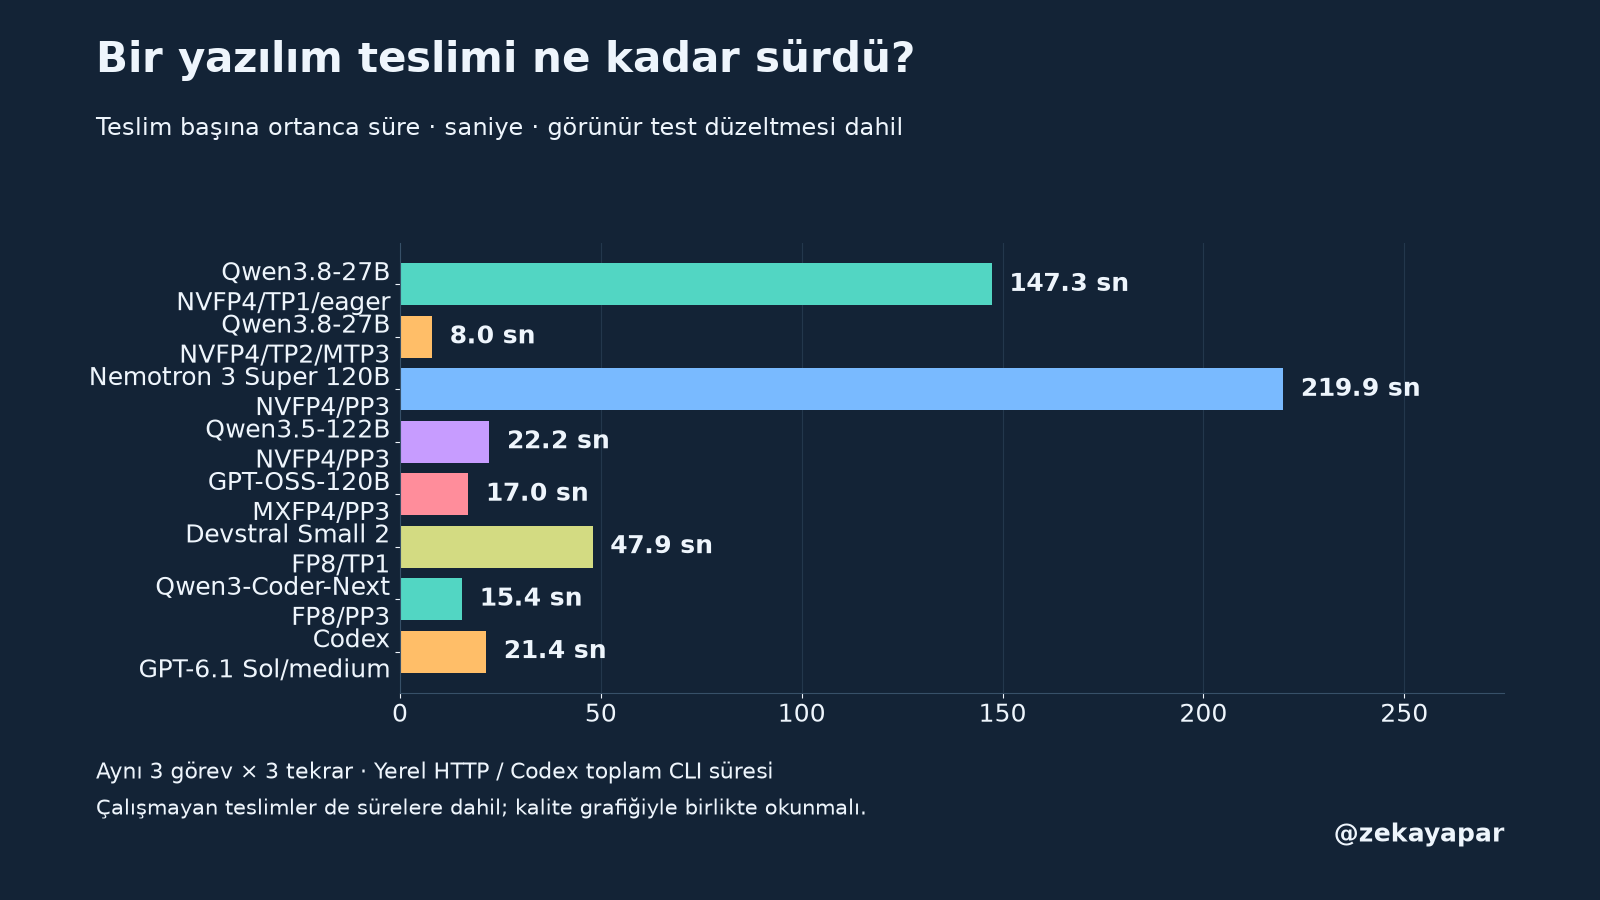
Bu süreler doğru ve yanlış teslimleri birlikte içeriyor. Hızlı ama kabul edilmeyen bir teslimi başarı saymıyorum. Yerelde HTTP, Codex tarafında CLI çağrısı ölçüldü; kurulum, insan incelemesi ve bütün proje geliştirme zamanı bu sütunlarda yok.
Hangi görevde tamamlandı?
Aşağıdaki sayılar, en çok bir görünür smoke düzeltmesinden sonraki tam geçişler. Her hücre üç tekrarı kapsıyor; gizli kabul hataları bu aşamada modele verilmedi.
| Profil | Fatura düzeltme | Ticket özelliği | Log CLI |
|---|---|---|---|
| Qwen3.8-27B · NVFP4/TP1/eager | 3/3 | 0/3 | 1/3 |
| Qwen3.8-27B · NVFP4/TP2/MTP3 | 3/3 | 0/3 | 1/3 |
| Nemotron 3 Super 120B · NVFP4/PP3 | 0/3 | 1/3 | 0/3 |
| Qwen3.5-122B · NVFP4/PP3 | 0/3 | 0/3 | 0/3 |
| GPT-OSS-120B · MXFP4/PP3 | 0/3 | 2/3 | 0/3 |
| Devstral Small 2 · FP8/TP1 | 0/3 | 0/3 | 0/3 |
| Qwen3-Coder-Next · FP8/PP3 | 0/3 | 0/3 | 2/3 |
| Codex · GPT-6.1 Sol/medium | 3/3 | 3/3 | 3/3 |
Bazı teslimler JSON/dosya haritası veya açık izinli import sözleşmesine uymadığı için kabul kodu çalıştırılmadan elendi. Görünür düzeltme sonrası bu gruptaki teslim sayısı: Nemotron 3 Super 120B · NVFP4/PP3: 4/9, Qwen3.5-122B · NVFP4/PP3: 1/9, Qwen3-Coder-Next · FP8/PP3: 6/9. Bu teslimlerde 0 puan, programın istenen koşullarda teste alınamadığını gösteriyor; bütün iş kurallarını çalıştırıp yanlış bulduğum anlamına gelmiyor. Tam geçiş grafiği teslimin bütün sözleşmesini ölçüyor.
| Profil | Teste alınabilen son teslim | Bu teslimlerde geçen kontrol |
|---|---|---|
| Qwen3.8-27B · NVFP4/TP1/eager | 9/9 | 103/108 |
| Qwen3.8-27B · NVFP4/TP2/MTP3 | 9/9 | 101/108 |
| Nemotron 3 Super 120B · NVFP4/PP3 | 5/9 | 56/60 |
| Qwen3.5-122B · NVFP4/PP3 | 8/9 | 85/96 |
| GPT-OSS-120B · MXFP4/PP3 | 9/9 | 100/108 |
| Devstral Small 2 · FP8/TP1 | 9/9 | 80/108 |
| Qwen3-Coder-Next · FP8/PP3 | 3/9 | 33/36 |
| Codex · GPT-6.1 Sol/medium | 9/9 | 108/108 |
Bu son oran yalnız teste alınabilen altkümeyi gösteriyor. Teslim biçimi veya bütçe yüzünden elenen işleri başarıya çevirmiyor; dokuz teslim üzerinden tam geçiş tablosu aynı kalıyor.
Ticket işindeki bir Qwen tesliminde önce SQL LIKE filtresi, ardından Python casefold() uygulanıyordu. STRASSE aramasıyla Straße kaydı ilk aşamada elenince ikinci aşama kaydı geri getiremedi. Aynı teslim tenant yalıtımı kontrollerini geçti; arama kontrolünde kaldı. Kabul geri bildirimiyle yapılan iki düzeltmeden sonra da bu örnekte sorun sürüyordu. Tek bir toplam puanın altında hangi iş kuralının kaçırıldığı bu yüzden ayrıca duruyor.
Devstral’ın ilk ticket tesliminde time.time() kullanılmış, fakat time import edilmemişti. CLI hata yakalayıcısı da ensure_ascii=False parametresini json.dumps() yerine print() fonksiyonuna veriyordu. Bu teslim 1/12 kabul kontrolü geçti. Test çalıştırılırken NameError ve TypeError hataları görüldü.
Test hatalarını verdikten sonraki geliştirme turu
Birincil karşılaştırma bittikten sonra, kalan hatalar için ayrıca en çok iki kabul testi geri bildirimiyle düzeltme çağrısı yaptım. Nemotron bütçeyi final koddan önce tükettiği için bu ayrı geliştirme aşamasında düşünmeyi kapattım. Diğer profillerin ayarı korundu. Bu bölüm, geri bildirim ve kaydedilen ayarlarla işi tamamlama denemesi; ilk teslim skorları ayrı kalıyor.
| Profil | Geliştirme sonunda tam geçiş | Ek çağrı | Ek çağrıların toplam süresi | Ek çağrı ayarı |
|---|---|---|---|---|
| Qwen3.8-27B · NVFP4/TP1/eager | 5/9 | 9 | 1220.5 sn | ana profil |
| Qwen3.8-27B · NVFP4/TP2/MTP3 | 8/9 | 7 | 49.0 sn | ana profil |
| Nemotron 3 Super 120B · NVFP4/PP3 | 2/9 | 16 | 386.9 sn | düşünme kapalı |
| Qwen3.5-122B · NVFP4/PP3 | 0/9 | 18 | 441.9 sn | ana profil |
| GPT-OSS-120B · MXFP4/PP3 | 6/9 | 11 | 284.0 sn | ana profil |
| Devstral Small 2 · FP8/TP1 | 0/9 | 18 | 820.7 sn | ana profil |
| Qwen3-Coder-Next · FP8/PP3 | 3/9 | 13 | 104.2 sn | ana profil |
| Codex · GPT-6.1 Sol/medium | 9/9 | 0 | 0.0 sn | ek çağrı yok |
Bu iş sepetinde kaç token kullanıldı?
Ana tur, görünür smoke düzeltmeleri dahil dokuz teslimin bütün çağrılarını kapsar. Ek geliştirme tokenları yalnız sonradan verilen kabul geri bildirimi aşamasına aittir. Giriş sütunu varsa cache girişini de içerir; Codex cache miktarı maliyet bölümünde ayrıca veriliyor. Çıktı tokenları düşünme tokenlarını da içerebilir.
| Profil | Ana giriş | Ana çıktı | Geliştirme ek giriş | Geliştirme ek çıktı |
|---|---|---|---|---|
| Qwen3.8-27B · NVFP4/TP1/eager | 10.964 | 11.827 | 22.147 | 12.210 |
| Qwen3.8-27B · NVFP4/TP2/MTP3 | 10.501 | 12.983 | 16.277 | 8.267 |
| Nemotron 3 Super 120B · NVFP4/PP3 | 11.930 | 97.805 | 38.498 | 24.244 |
| Qwen3.5-122B · NVFP4/PP3 | 9.380 | 18.043 | 54.081 | 39.996 |
| GPT-OSS-120B · MXFP4/PP3 | 13.221 | 34.196 | 28.140 | 57.298 |
| Devstral Small 2 · FP8/TP1 | 18.313 | 18.010 | 47.087 | 23.699 |
| Qwen3-Coder-Next · FP8/PP3 | 20.398 | 20.367 | 31.602 | 19.588 |
| Codex · GPT-6.1 Sol/medium | 136.638 | 10.189 | 0 | 0 |
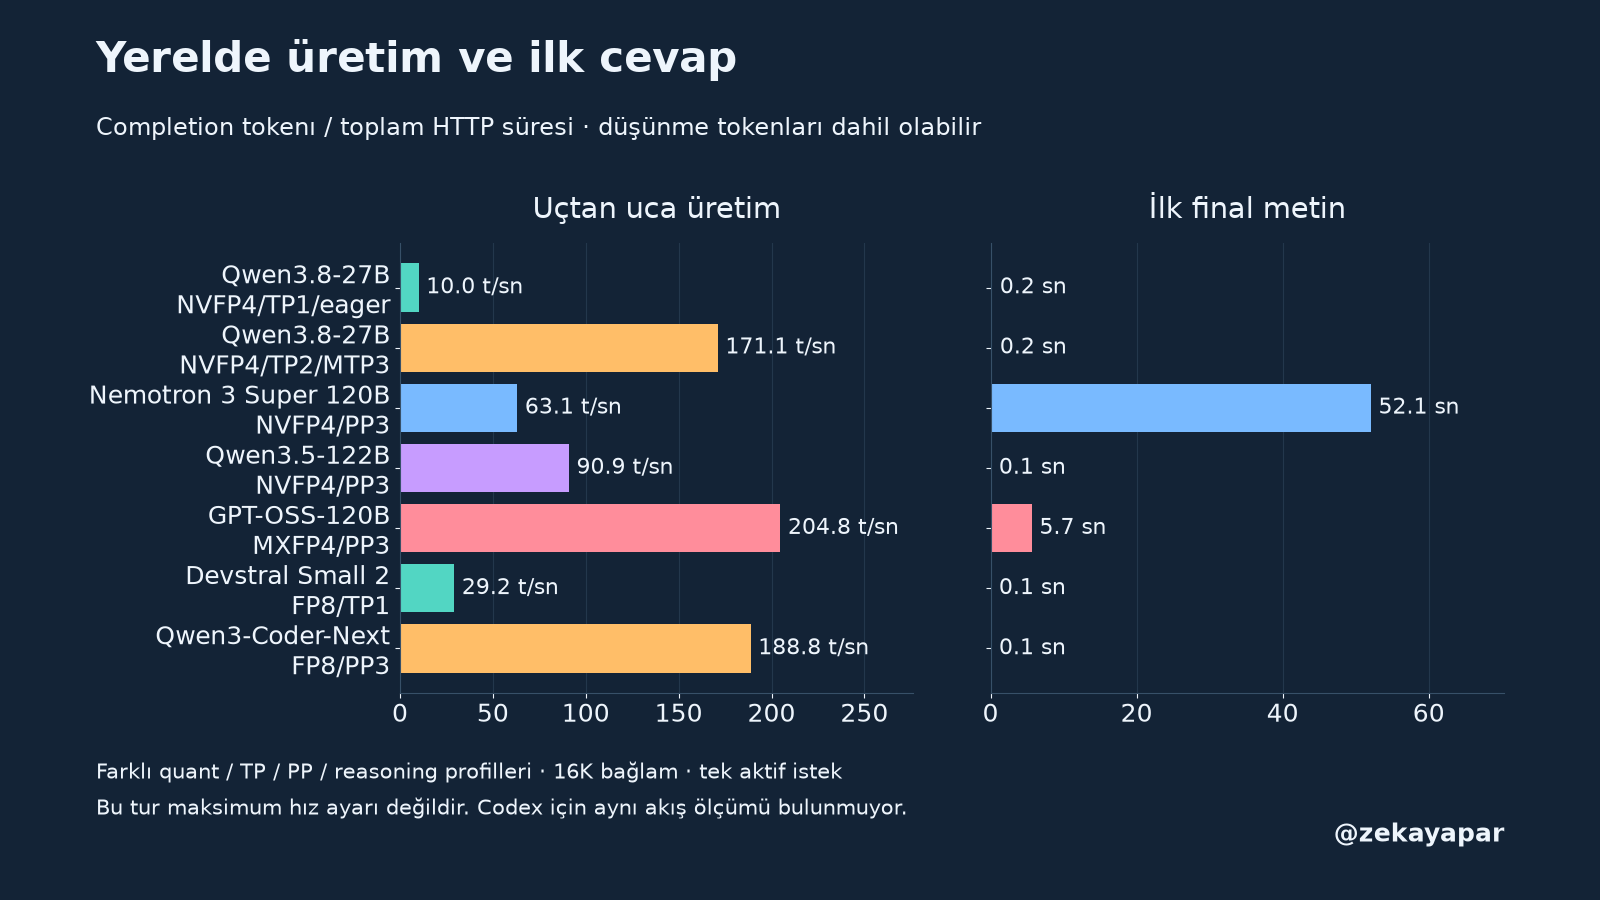
Qwen için hem mevcut üretim profili hem tek GPU eager profili ayrı ölçüldü. Bunlar iki ayrı model değil. Üretim profilinde graph, MTP, cache ve sequence ayarları birlikte farklı; aradaki fark yalnız MTP etkisi diye yorumlanmaz. Benchmark istemcisi çağrıları sırayla gönderdi; üretim profili sırasında dış istemciler için ayrı bir trafik kilidi kurulmadı. Diğer adaylarda kullanılan profiller maksimum hız ayarı olarak sunulmuyor. Model başına farklı quantization, reasoning ve kart dağılımı kullanıldı; sonuçlar bu çalışan profillere ait.
Final metin gelmeyen bir çağrı için ilk cevap süresi 0 kabul edilmedi. Grafikteki ortanca yalnız final metin gözlenen çağrılardan hesaplandı. Final metin gelmeyen çağrılar: Nemotron 3 Super 120B · NVFP4/PP3: 8/14. Kalite skorlarında bu teslimler de yer alıyor.
t/s değerini nasıl okuyorum?
Yerel model için cevap üretim hızı önemli; uzun kod yazarken beklemeyi doğrudan etkiliyor. Ama ilk kelimenin gelme süresi, düşünme süresi ve işin kaç denemede bittiği de önemli.
Bu nedenle iki ayrı şeye bakıyorum: model ne kadar hızlı üretiyor ve kabul edilebilir bir teslimi ne kadar sürede veriyor? İkinci sorunun içine ek çağrılar da giriyor. Çok hızlı yazılmış ama yanlış hesap yapan kodu başarılı iş saymıyorum.
Yerel ölçümlerde token sayısı sunucunun kullanım kaydından geliyor. Uçtan uca completion token/sn, düşünme tokenlarını da içerebilir; yalnız kullanıcının gördüğü kodun yazılma hızı değildir. Farklı modeller aynı metni farklı sayıda tokena bölebilir.
Yerel çağrılarda prefix cache salt her istekte farklı; önceki tekrarın önbelleğinden yararlanmayı engelliyorum. Codex CLI tarafında sağlayıcının raporladığı önbellek kullanımı korunuyor ve maliyet hesabında ayrı gösteriliyor. CLI’nin sistem bağlamı da daha büyük. Bu farklar nedeniyle aynı istemci ve aynı cache politikasıyla yapılmış saf motor testi olarak okumuyorum.
Codex CLI kolunda token akış zamanları yok; ilk token gecikmesini ve saf decode hızını ölçemiyorum. Raporlanan toplam çıktı tokenını toplam CLI süresine bölerek bir uçtan uca token/sn oranı hesaplayabiliyorum. Yerel tarafta da çıktı tokenı / toplam HTTP süresi kullanılıyor. Tablodaki oran bu iki ölçülmüş sayının hesabı; istemci, ağ, başlangıç ve düşünme süreleri de paydaya giriyor. Çağrı başına oranların ortancasını gösteriyorum.
Bu turda benchmark istemcisi tek seferde bir görev gönderiyor. Çok kullanıcılı kapasite ölçümü değil; bu sürelerden kaç müşteriye aynı anda hizmet verileceğini çıkarmıyorum.
Üç kartı kullanmak, her görevde üç kat hız demek değil. Modelin kartlara nasıl dağıtıldığı, her karta sığan bellek ve kartlar arası aktarım sonucu değiştiriyor. Buradaki profiller ve ayarlar açık; tek bir hız sayısı bütün local kullanımına genellenmiyor.
20 dolarlık paket yeter mi, 100 dolarlık paket mi gerekir?
Önce yaptığım işlerin alt pakette tamamlanıp tamamlanmadığına bakarım. Az sayıda kısa iş yapıyor, limit yüzünden çalışmam kesilmiyor ve sonuçları kullanabiliyorsam daha pahalı pakete geçmem için yalnız fiyat farkı bir gerekçe değil.
Gün içinde uzun oturumlar, büyük projeler ve peş peşe işler varsa kullanım sınırı işin bir parçası hâline geliyor. Burada soru, daha pahalı paketin kaç işimi kesintisiz tamamlamamı sağladığı. Beklerken kaybettiğim zaman, pakete ödediğim farktan daha değerli olabilir.
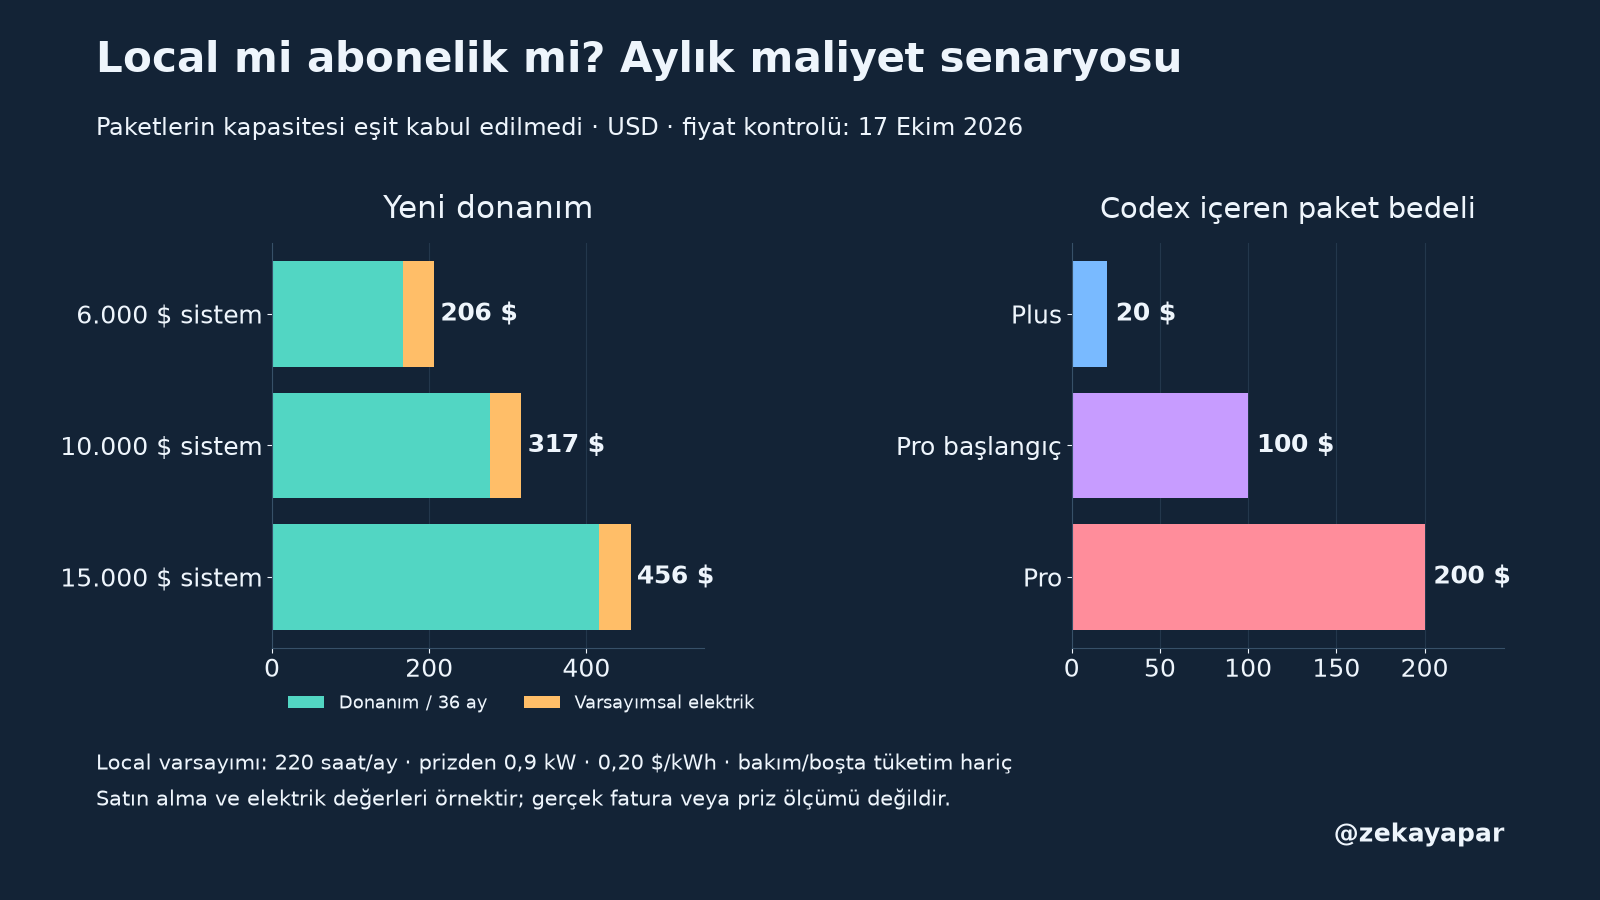
17 Ekim 2026 tarihinde resmî listede ChatGPT Plus aylık 20 USD; Pro seçenekleri 100, 200 ve 500 USD. Claude Pro aylık ödemede 20 USD, Max başlangıcı 100 USD. Vergi, bölge, ek kredi ve yıllık ödeme koşulları ayrıca değişebilir. Codex fiyatlandırması, Claude fiyatlandırması.
Bu fiyatları, bütün paketleri aynı iş yüküyle tüketmişim gibi sunmuyorum. Buradaki mevcut hesapla tamamlanan testler, tek başına 20 dolarlık paketin günlük veya haftalık kapasitesini kanıtlamaz. Aynı abonelik farklı işlerde de kullanıldığı için, kota yüzdesindeki değişimi yalnız bu teste bağlamıyorum.
Paket seçmek için pratik olarak şunları kaydederim: bir haftada kaç gerçek iş tamamlandı, kaç kez limite takıldım, ne kadar bekledim ve ek kullanım aldım mı? Sonra bunları ödediğim toplam tutarla birlikte değerlendiririm. Büyük paketin değeri, benim kullanımımda yarattığı fark olmalı.
Aynı modele aynı ayarlarla erişiyorsam daha yüksek ödeme tek başına daha doğru kod anlamına gelmez. Daha yüksek kota, farklı model erişimi veya hız seçeneği ayrı ayrı değerlendirilecek faydalar.
Abonelik ile API faturası ayrı hesaplar
Bir abonelik içinde çalıştırdığım görevin tokenlarını API fiyatıyla çarpabilirim. Çıkan sayı, aynı kullanımın seçilen API tarifesindeki tahmini karşılığı olur; ödediğim abonelik faturası olmaz.
API tarafında giriş, önbellekten okunan giriş, çıktı ve varsa diğer ücretli işlemler hesaplanır. Tekrar denemeler de toplamda kalır. Bu çalışmada GPT-6.1 Sol için kısa bağlam Standard tarifesindeki milyon token başına 2 USD giriş, 0,10 USD önbellek girişi ve 10 USD çıktı fiyatlarıyla ayrı bir senaryo hesaplanıyor. Resmî API tarifesi.
Bunu iki farklı iş için kullanabilirim. Kendi geliştirme işlerimde aylık aboneliğin yeterliliğini değerlendiririm. Ürünümün backend'inde sürekli model çağıracaksam gerçek API tüketimi, gecikme ve kapasite için ayrı bir bütçe çıkarırım. Bir kişinin aboneliğini değerlendiren hesap, ürünün bütün kullanıcılarına hizmet verme hesabının yerine geçmez.
Bilgisayar zaten elimdeyse
Donanım zaten satın alınmışsa, bugün bir görev daha çalıştırmanın ek maliyetiyle sıfırdan yatırım yapmanın maliyeti farklıdır.
Elimdeki kartları uygun saatlerde kullanabiliyorsam local cazip olabilir. Yine de elektrik, kurulum ve bakım zamanı, donanımın başka işte kullanılamaması ve gerektiğinde arızaya müdahale etme sorumluluğu var.
Aynı yaklaşımı cloud için de uygulamak gerekiyor. Aboneliği zaten başka işler için ödüyorsam ve bu görev kullanım sınırları içinde kalıyorsa, bir görev daha çalıştırmak ek fatura yaratmayabilir. Yerelde yalnız ek elektriği sayıp cloud tarafına aboneliğin bütün bedelini yüklemek dengeli bir karşılaştırma olmaz.
Bu yüzden ek maliyet ve toplam sahip olma maliyeti ayrı gösteriliyor.
Sırf local model için bilgisayar alacaksam
Burada ekran kartının fiyatıyla hesabı kapatamam. İşlemci, RAM, anakart, depolama, güç kaynağı ve uygun fiziksel kurulum da gerekiyor. Yatırımın kullanılacağı süre, aylık kullanım yoğunluğu ve bakım zamanı sonucu değiştiriyor.
Local model çalıştırmak her zaman bu üç kartlı sistem ölçeğini gerektirmiyor. Seçtiğim Qwen ve Devstral ağırlıkları tek karta sığıyor; daha küçük veya zaten eldeki bir cihaz için satın alma ve güç girdileri ayrıca değişmeli.
Örnek olarak bütün sistem için 10.000 USD satın alma bedeli ve 36 aylık dağıtım kabul edersem, elektrik ve bakım eklenmeden aylık yaklaşık 278 USD çıkar. Bu, benim sistemimin faturası değil; hesabın nasıl değiştiğini göstermek için seçilmiş bir senaryo.
Ayda 220 saat aktif kullanım, prizden ortalama 0,9 kW ve 0,20 USD/kWh varsayımında elektrik 39,60 USD ekler. Böylece basit toplam yaklaşık 317 USD/ay olur. Boşta çalışma, bakım, soğutmanın ek tüketimi, finansman ve insan zamanı bu basit örnekte ayrıca hesaplanmalıdır.
Aynı 10.000 USD / 36 ay, 0,9 kW ve 0,20 USD/kWh varsayımlarını farklı kullanım sürelerine uygulayınca tablo şöyle değişiyor:
| Aktif kullanım | Yalnız aktif elektrik | Donanım payı + aktif elektrik |
|---|---|---|
| 10 saat/ay | 1,80 USD/ay | 279,58 USD/ay |
| 100 saat/ay | 18,00 USD/ay | 295,78 USD/ay |
| 220 saat/ay | 39,60 USD/ay | 317,38 USD/ay |
Bu saatlerin kaç kabul edilen işe karşılık geldiği, modelin hızına ve işin kaç denemede tamamlandığına bağlı. Tablo abonelikle aynı kapasitenin sağlandığını söylemiyor; boşta tüketim ve bakım bu örnekte yok.
Aynı sistemi ayda birkaç saat kullanıyorsam satın alma maliyeti ortadan kalkmıyor. Bu yüzden tek kişinin az sayıdaki işi için yeni ve pahalı bir sistem almakla, çok sayıda işi düzenli işleyen mevcut altyapıyı kullanmak aynı karar değil.
Bu testteki tokenların API karşılığı
Codex kolunda toplam 136638 giriş tokenı (110592 önbellekten) ve 10189 çıktı tokenı raporlandı. Yukarıdaki Standard API tarifesiyle hesaplanan tahmini karşılık 0.1650 USD. Bu, abonelik üzerinden yapılan çalışmanın gerçek faturası değil; API ile aynı raporlanan token tüketiminin fiyatlandırma senaryosu. Ajanın sistem bağlamı da kullanım sayısına dahil. Hesap yalnız kontrollü Codex teslimlerini kapsıyor; görevlerin, testlerin, analiz ve grafiklerin hazırlanmasındaki bütün AI kullanımını ölçen bir toplam değil.
Ayda kaç kabul edilebilir iş yaptığım değişince iş başına maliyet de değişiyor. Örneğin 20 USD paketin o kullanım için gerçekten yeterli olması koşuluyla ayda 100 kabul edilen işe paket bedelini paylaştırmak 0,20 USD/iş eder. Aynı hesabı kapasiteyi doğrulamadan binlerce işe yayamam. Yerel sistemde de satın alma giderini az sayıda işe paylaştırırsam yalnız elektrik hesabından çok farklı bir sonuç çıkar.
Bu koşuda bütün görevleri geliştirme sonunda tamamlayan yerel profil bulunmadığı için, aynı iş kapsamını sağlıyormuş gibi donanım geri ödeme noktası hesaplamıyorum.
Elektrik ölçümünde GPU ile bütün bilgisayarı karıştırmıyorum
GPU'nun bildirdiği güç tüketimi işlemciyi, belleği, güç kaynağı kayıplarını ve ortam soğutmasını kapsamıyor. Bu çalışmadaki GPU örnekleri kartların tüketimini değerlendirmek için kullanılabilir; evin veya işyerinin elektrik faturası gibi sunulmaz.
Priz ölçümü yoksa bütün sistem için kullanılan güç değeri varsayım olarak kalır. Test süresi çok kısaysa örnekleme hatası da büyür. Elektrik maliyeti tablosu bu ayrımı korur.
Görev çağrıları sırasında örneklenen GPU enerjisi
Bu toplam, birincil turun bütün çağrıları boyunca bilgisayardaki üç kartın güç örneklerinden hesaplandı; iki kartla çalışan profilde boşta kalan kart ve ekran kullanımı da dahil. Kurulum, ilk derleme, model açılışı ve ayrı geliştirme turu dahil değil. Başlangıç/bitiş sınırları iki yandaki güç örnekleri arasında doğrusal ara değerle hesaplandı. Yeterli sınır örneği olmayan çağrılar toplama alınmadı; kapsanan çağrı sayısı ayrıca veriliyor. Saniyelik örnekleme kısa çağrılarda belirsizlik taşır; bu bir hassas enerji sayacı değil.
| Yerel profil | Örneklerden hesaplanan GPU enerjisi | Kapsanan çağrı |
|---|---|---|
| Qwen3.8-27B · NVFP4/TP1/eager | 56.9 Wh | 11/11 |
| Qwen3.8-27B · NVFP4/TP2/MTP3 | 11.5 Wh | 10/11 |
| Nemotron 3 Super 120B · NVFP4/PP3 | 250.5 Wh | 14/14 |
| Qwen3.5-122B · NVFP4/PP3 | 34.9 Wh | 10/10 |
| GPT-OSS-120B · MXFP4/PP3 | 28.2 Wh | 11/11 |
| Devstral Small 2 · FP8/TP1 | 67.4 Wh | 13/13 |
| Qwen3-Coder-Next · FP8/PP3 | 16.2 Wh | 15/15 |
Bu değerler bütün bilgisayarın tüketimi veya cloud tarafının enerjisi değildir. Abonelik bedeliyle elektrik faturası gibi doğrudan kıyaslanmaz.
Başarılı işin toplam maliyeti
Bir modelin çalıştırılması ucuz olabilir. Ama çıkan kodun yanlışını bulmak için sürekli zaman harcıyorsam bunun da karşılığı var.
Örneğin bir işte 20 dakika fazladan inceleme gerektiğini ve bu zamanın saatlik değerini 30 USD kabul edersem, fark 10 USD olur. Bu bir model sonucu değil; insan zamanının token giderinden nasıl daha büyük olabileceğini gösteren örnek.
Öte yandan iyi tanımlanmış bir görevde yerel model kabul kontrollerini düzenli geçiyorsa, aynı işi her seferinde daha pahalı bir çözüme göndermek gerekmeyebilir. Kararı yalnız modelin birim fiyatıyla değil, kullanılabilir bir işin toplam maliyetiyle veririm.
Otomatik testleri geçen kod da her zaman üretime hazır değildir. Güvenlik, bakım kolaylığı ve projenin geri kalanıyla uyumu ayrıca değerlendirilir. Bu çalışmada ölçmediğim insan inceleme süresini ölçülmüş gibi maliyete eklemiyorum; farklı değerlerle senaryo olarak gösteriyorum.
Veri kontrolü ne zaman belirleyici olur?
Kaynak kodun veya şirket verisinin dış bir servise gitmemesi gerekiyorsa, modelin kendi altyapımda çalışması önemli bir seçenek. Verinin nerede işlendiğini, kayıtların nerede tutulduğunu ve sisteme kimlerin eriştiğini daha doğrudan yönetebilirim. İnternetsiz çalışma ihtiyacı da local tarafını güçlendirir.
Ancak yerel model kullanmak, sisteme giren herkesin bütün verilere erişebileceği anlamına gelmemeli. Örneğin şirket kayıtlarını SQL'den okuyan bir API varsa, kullanıcının ve tenant'ın izinleri API tarafından uygulanmalı. Modelin kendisine 'başka şirketin verisini gösterme' demek tek başına erişim kontrolü yerine geçmez.
Cloud ürünlerinde de kullanılan hizmetin veri politikasına bakmak gerekiyor. OpenAI iş ürünleri ve API için varsayılan eğitim kullanımı olmadığını; Anthropic de ticari ürünleri için benzer bir ayrım yaptığını belirtiyor. Kişisel abonelik, ticari hesap ve API koşulları aynı kabul edilmemeli. OpenAI iş verileri, Anthropic ticari veri politikası.
Verinin eğitimde kullanılmaması, hiç saklanmaması veya yurt dışına aktarılmamasıyla aynı şey değil. KVKK açısından işleme ve varsa aktarım koşulları ayrıca değerlendirilir; modelin yerel olması tek başına bütün süreci uygun hâle getirmez. KVKK aktarım bilgileri.
Şirket verisi için ne zaman eğitim gerekir?
Güncel sipariş, bakiye veya çalışan kaydı soruluyorsa önce yetkili bir API sorgusuna bakarım. Belgelerden cevap bulmak gerekiyorsa belge arama ve RAG değerlendiririm. Belli bir görev davranışı veya çıktı biçimi gerekiyorsa prompt, örnekler ve gerektiğinde fine-tuning üzerinde çalışırım.
Değişen kayıtları modelin ağırlıklarına yerleştirmek; bilgiyi güncel tutma, silme ve kullanıcı bazında erişimi yönetme işini zorlaştırabilir. Local fine-tuning'in avantajı, kontrollü bir ortamda tanımlı göreve uyarlama yapabilmek. Bunun işe yarayıp yaramadığını da ayrı bir test kümesiyle ölçmek gerekir.
Bu rehberde fine-tuning yapılmadı. Eğitimin modelin başarısını veya maliyetini ne kadar değiştireceğine ilişkin bir ölçüm sonucu yok.
Hangi koşulda neyi seçerim?
| Kullanım | Önce değerlendireceğim seçenek | Tercihi değiştiren koşul |
|---|---|---|
| Ara sıra hata düzeltme ve küçük geliştirmeler | İhtiyacı karşılayan düşük abonelik | Kota, erişim veya sonuç kalitesi işimi engelliyorsa |
| Gün boyu uzun geliştirme oturumları | Daha yüksek cloud kapasitesi veya hibrit | Üst paketin sağladığı fayda ve local'in aynı işteki kabul seviyesi |
| Tekrarlanan, test edilebilir çok sayıda iş | Local veya ölçülmüş API | Hacim, başarı oranı, bakım ve toplam maliyet |
| Verisi kurum dışına çıkmaması gereken işler | Kurum içinde işletilen model | Gereken kalitenin sağlanması ve güvenli işletim |
| Ani ve düzensiz yoğunluk | Bütçesi ve limitleri belirlenmiş cloud/API | Sürekli donanım tutmanın karşılığı ve yerel kuyruklar |
| İnternetsiz çalışma | Local | Cihazın kabul edilebilir kalite ve hızı sağlayabilmesi |
| Güçlü donanım zaten mevcut | Uygun işleri local'de deneme | Ek tüketim, başka kullanım ihtiyacı ve müdahale yükü |
| Yalnız az sayıdaki iş için yeni pahalı sistem | Önce abonelik/API ile gerçek ihtiyaç ölçümü | Tekrarlanan hacim veya veri kontrolü yatırımın karşılığını oluşturuyorsa |
Bunlar test etmediğim her iş için kesin sonuçlar değil; ölçümleri kendi kullanımına taşımak isteyen biri için karar çerçevesi.
İkisini birlikte kullanmak
Yerel modelin düzenli başardığı işleri local'de tutup, daha zor görevlerde cloud kullanabilirim. Kritik veri içermeyen bir kod parçasını dış servise göndermekle, bütün şirket verisini göndermek aynı karar değil. Geçiş koşullarını önceden belirlerim; yerel model zorlandı diye hassas veriyi otomatik olarak dışarı taşımam.
Böyle bir kullanımda local'in kurulum ve işletim yükü devam eder. Cloud aboneliği de devam ediyorsa iki gideri birlikte sayarım. Hibrit kullanımın ekonomik olup olmadığı, hangi işi gerçekten hangi tarafa bıraktığıma bağlı.
Kendi kararımı nasıl veririm?
Kendi projelerimden küçük ama temsil edici bir iş sepeti seçerim. Her işin kabul koşulunu önceden yazarım. Aynı işleri birkaç kez yaptırıp ilk teslimi, düzeltmeleri, beklemeyi ve harcamayı kaydederim.
Sonra şu sorulara bakarım: İşlerim hangi çözümde yeterli doğrulukta bitiyor? Kullanımım hangi sınıra takılıyor? Donanım zaten var mı, yeni mi alınacak? Verinin gidebileceği yerler belli mi? Sistemi işletmek için ayıracağım zaman var mı?
Bu soruların cevabı local'i seçtirebilir, cloud'u seçtirebilir veya işi ikiye böldürebilir. Seçimin değişmesi de normal: kullanım hacmi, model kalitesi, paket fiyatları ve elimdeki donanım aynı kalmıyor.
Kurulum da işin bir parçası
Bu çalışmada büyük ağırlıkları indirmek ve doğrulamak, üç kartta bellek payı ayırmak ve ilk CUDA kodunu derlemek gerekti. Bir açılış bellek bütçesinde durdu; bütçeyi düzenledim. CUDA derlemesini tamamlamak için de kurulu kütüphanenin bağlayıcı adını kullanıcı klasöründe çözdüm. Çalışan sürücüyü ve sistem Python’unu değiştirmedim.
Bunlar modelin kod yazma süresine dahil değil. Hazır çalışan sistemi kullanmakla ilk kurulumu yapmak aynı emek değil. Cloud hesabı ve mevcut Qwen ortamı da önceden hazırdı; bütün kurulumların insan süresini ölçmüş gibi bir karşılaştırma yapmıyorum. Teknik denemeler ve çözümleri kaynak kaydında ayrı duruyor.
Bu adayları neden seçtim?
Qwen3.8-27B zaten kullandığım referans. Nemotron 120B, Qwen 122B ve GPT-OSS 120B, seçilen düşük hassasiyetli ağırlıklarıyla üç kart için değerlendirdiğim daha büyük seçenekler. Devstral Small 2 ve Qwen3-Coder-Next ise yazılım işi için bakmak istediğim adaylar. Boyut veya tanıtım tablosu nedeniyle daha iyi olduklarını varsaymıyorum; aynı teslimleri test ediyorum.
Kullanılan ağırlıkların resmî kaynakları: Qwen3.8 NVFP4, Nemotron 3 Super NVFP4, Qwen3.5-122B NVFP4, GPT-OSS-120B, Devstral Small 2, Qwen3-Coder-Next FP8. Sabit revision ve dosya hashleri teknik arşivde.
Teknik kaynak ve tekrar çalıştırma
İstemlerde standart kütüphaneden kullanılabilecek modüller ayrıca açık bir listeyle sınırlandı; aynı liste Codex koluna da verildi. Bu listenin dışına çıkan import bir teslim biçimi/çalıştırma sözleşmesi hatası sayılıyor. Örneğin uuid standart kütüphanede olsa da bu testin izinli listesinde yok.
Tam ortak görev istemlerini indir.
Ham istemler, teslimler, kullanım kayıtları, kabul sonuçları ve sabitlenen dosya hashleri çalışma arşivinde tutulur. Ön tur, canlı Qwen pilotu ve ana ölçüm ayrı dizinlerdedir. Model profilleri, ağırlık revisionları ve geri dönüş kontrolü kaynak kaydında bulunur.
Yazıda geçen donanım maliyetleri fatura değilse senaryo olarak etiketlenir. Paket fiyatları 17 Ekim 2026 kontrolüdür. Bu çalışma uzun süreli donanım kararlılığı, cloud hizmet seviyesi veya bütün yazılım görevleri için genel başarı garantisi vermez.