 zekayapar
Qwen’e belge arama uygulaması yazdırdım
Kaynaklı cevap veren TXT/PDF uygulaması ve iki modelin aynı GPU üzerinde sabit bütçeli teslim testi.
Kontrollü teslim testi
- Qwen3.8-27B · NVFP4
- Qwen2.5-Coder-7B · AWQ
- 1× RTX 5090 · kart başına 32 GB
- vLLM · CUDA · TP1
- 8K bağlam · BF16 KV
- MTP ve prefix cache kapalı
Belge uygulaması
- Python · pypdf 6.20.1
- HTML · CSS · JavaScript
- Qwen3-Embedding-0.6B
- TXT / PDF · kaynaklı RAG
- localhost HTTP API
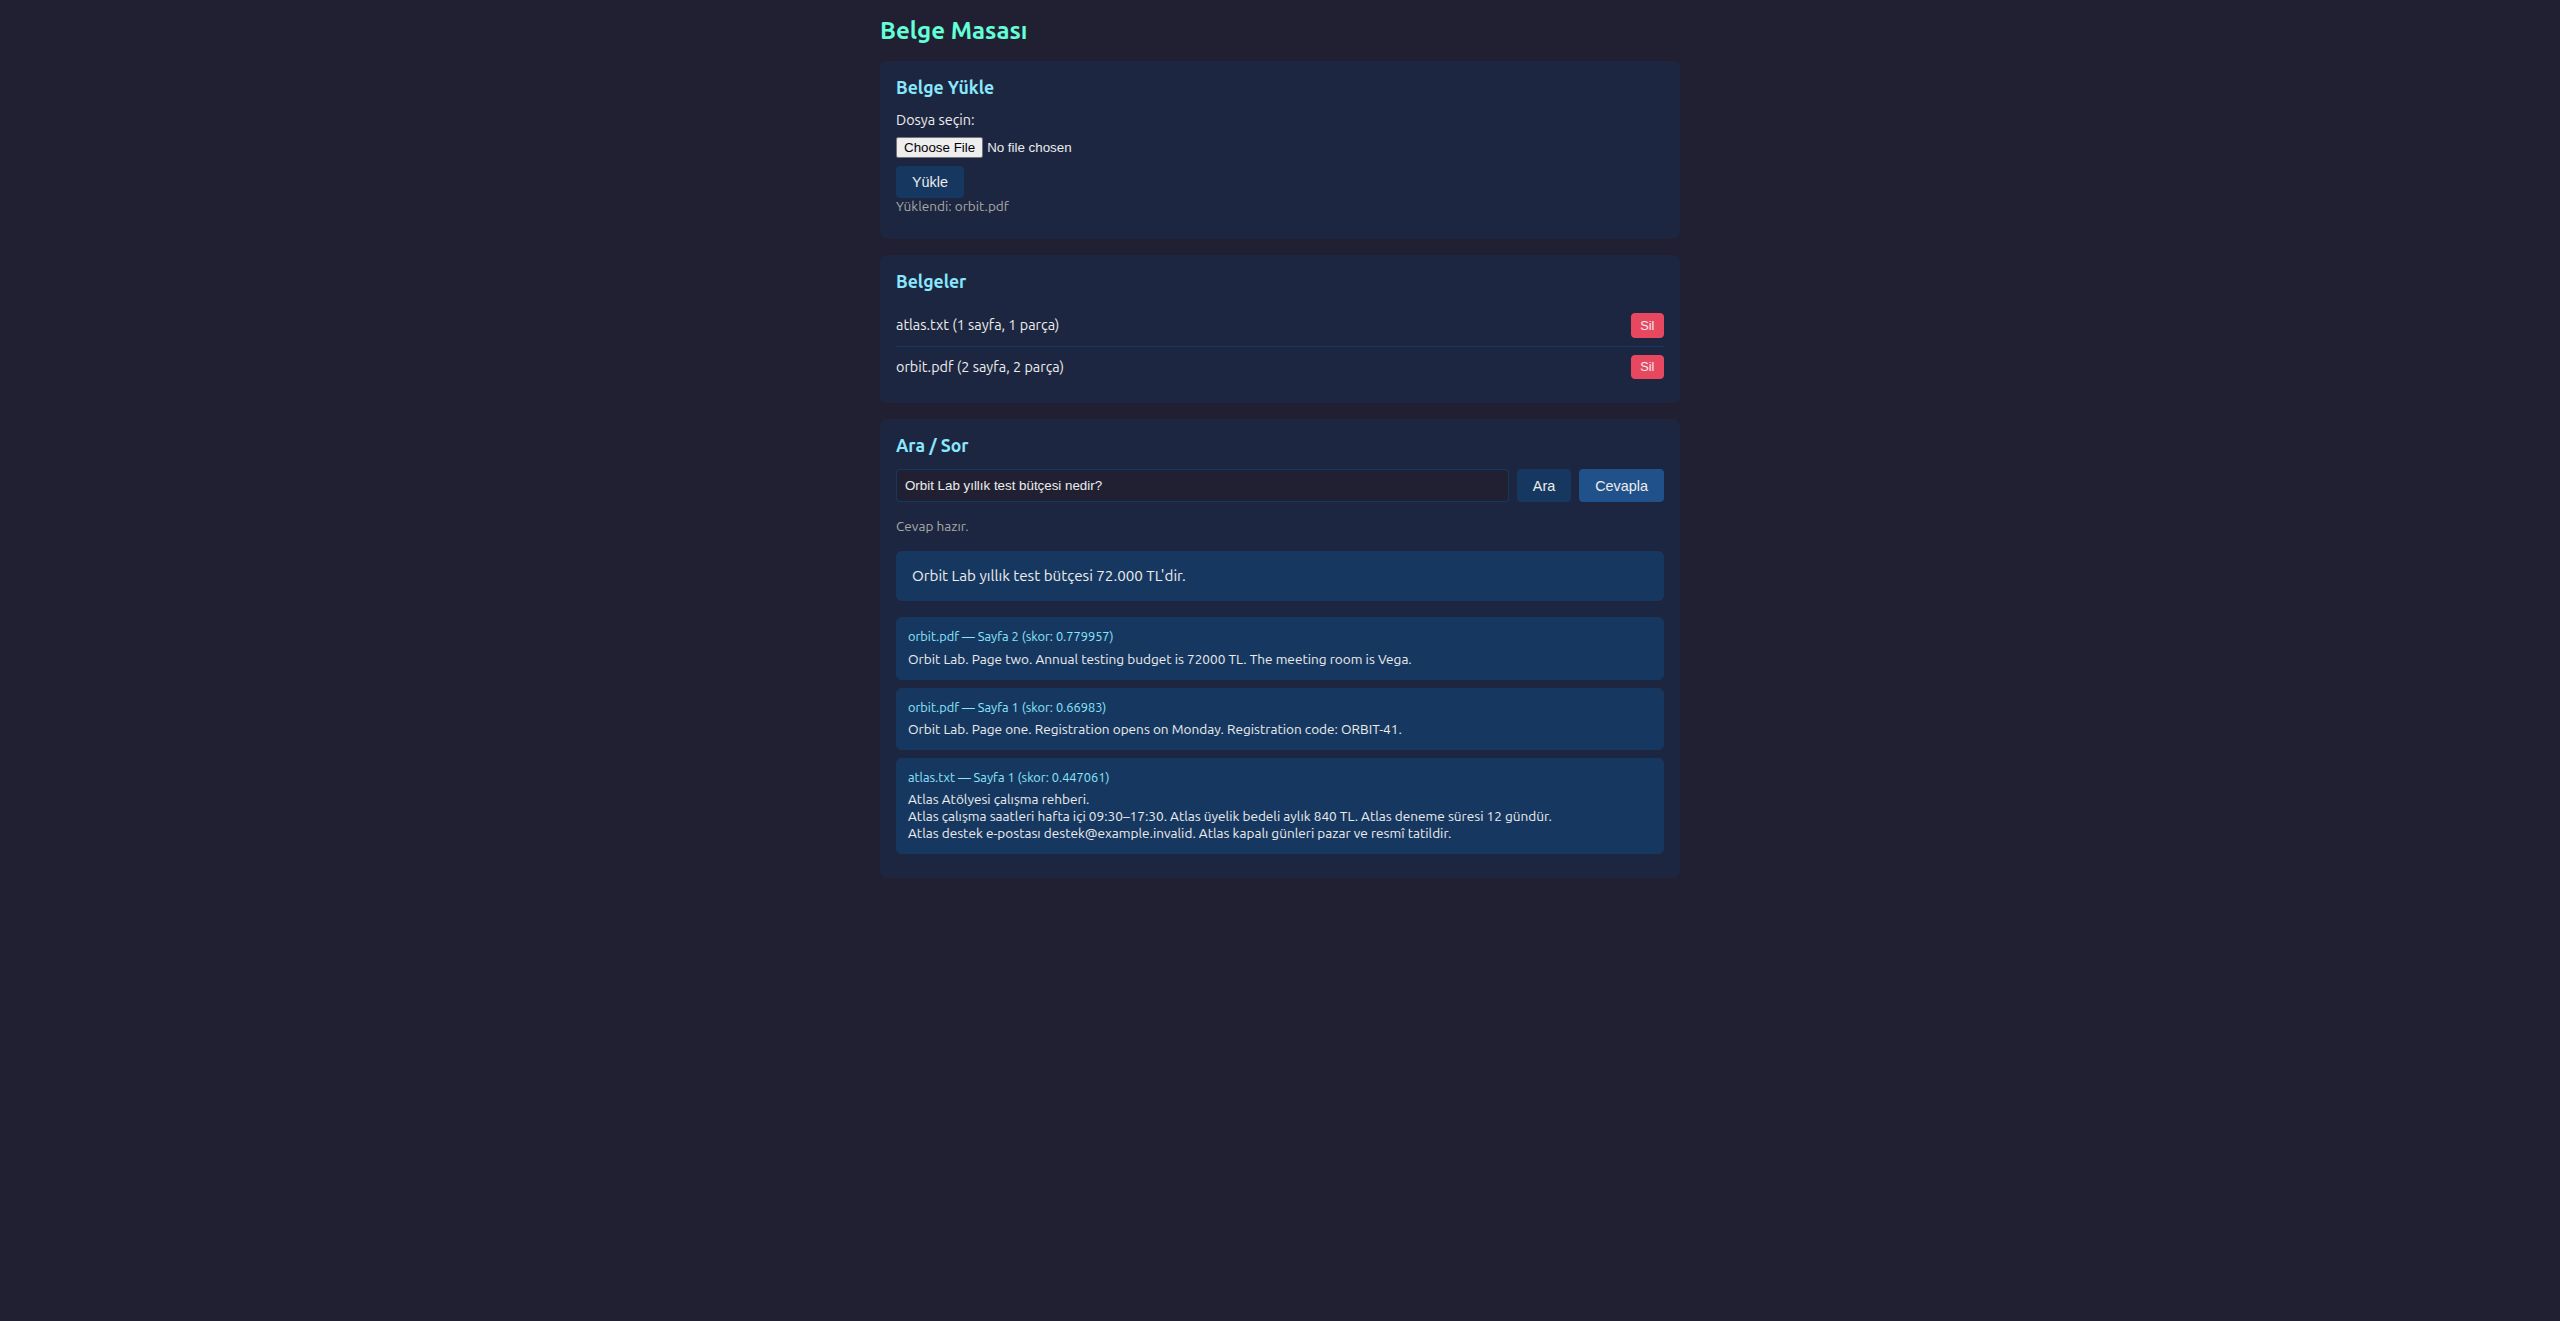
Qwen’e bu kez oyun yerine TXT ve PDF yükleyip kaynaklı cevap veren küçük bir uygulama yazdırdım. Adı Belge Masası. Belgeyi yükleyip soru sorunca, cevabın altında dosya adı, sayfa numarası ve alıntı görünüyor. Kurulum normal Python venv.
Aynı projeyi Qwen2.5-Coder7B-AWQ ve Qwen3.8-27B-NVFP4’e de verdim. Önce eşit donanım ve istek bütçesinde teslim testini tamamladım. İki model de bu sınırlar altında tam geçen uygulama çıkaramadı. Çalışan son uygulama, daha geniş bağlamda yapılan iki ayrı Qwen düzeltmesiyle tamamlandı. Bu iki sonucu birbirine karıştırmıyorum.
Kodu kim yazdı
Uygulamanın Python ve HTML/CSS/JavaScript dosyalarını Qwen yazdı. Codex görev metnini, yerel ortamı, sentetik belgeleri, HTTP kabul testlerini ve ölçüm araçlarını hazırladı; yanıtları kaydedip testleri çalıştırdı. Ürün dosyaları elle düzeltilmedi. Son dosyaların model çıktısıyla birebir aynı olduğunu SHA256 ile kontrol ettim.
Aramada Qwen3-Embedding 0.6B, cevap üretiminde Qwen3.8 kullanılıyor. Bunlar uygulamanın çalışma modelleri. Karşılaştırmadaki “kod yazarı” ise ayrı bir değişken: coder’ın yazdığı uygulama da aynı embedding ve cevap modeline bağlanacaktı.
İki modele verdiğim görev
TXT ve metin içeren PDF yüklemek, sayfa bilgisini koruyarak parçalamak, embeddingleri diske kaydetmek ve soruya en yakın üç kaynağı getirmek gerekiyordu. Cevap yalnız bu kaynaklardan üretilecek; olmayan bilgi için bulunamadığı söylenecekti. Belge silinince indeksten de çıkarılmalı, uygulama yeniden başlayınca belgeler ve arama korunmalıydı.
Yalnız Python standart kütüphanesi ve pypdf 6.20.1 kullanılmasına izin verdim. API, 127.0.0.1 üzerinde dinliyor. Dosya sınırı 2 MiB; taranmış PDF için OCR yok. İlk model çağrısından önce görev, dört sentetik belge, 12 bilinen ve 3 bilinmeyen soru, 22 kabul kontrolü ve çalıştırma profilleri sabitlendi.
Şartları nasıl eşitledim
Mevcut dağıtımda Qwen iki GPU’da, coder ayrı bir GPU’da çalışıyor. Bu profillerin sürelerini aynı donanım benchmarkı diye karşılaştıramazdım. Bu nedenle ana Qwen servisini kontrollü bakımda durdurup iki modeli sırayla aynı fiziksel RTX 5090 üzerinde çalıştırdım. GPU0, TP1, 8192 token bağlam, tek aktif istek, 2048 batch token, BF16 aktivasyon ve KV, aynı GPU bellek bütçesi; MTP ve prefix cache kapalıydı.
Aynı brief, temperature 0.2, top_p 1, top_k -1, 6000 çıktı tokenı ve üç seed kullandım. Her seed’de bir başlangıç ve en fazla iki test geri bildirimli yeniden üretim hakkı vardı. Geri bildirim yeni bağlamda brief ve ilk altı başarısız kontrolün kısa özetiydi; önceki tam kod isteme eklenmedi. Altı aşamanın sırası Qwen, coder, coder, Qwen, Qwen, coder olarak dengelendi. Her aşama yeni model süreci ve ayrı 128 token bütçeli ısınmayla başladı.
Modellerin mimarisi, boyutu ve ağırlık biçimi farklı: 27B NVFP4 ile 7B AWQ. Donanım ve runtime bütçesini eşitledim; bu test yalnız parametre boyutunun etkisini ölçmüyor. Isınma da her olası istem ve çıktı şeklini kapsamaz. Ek derleme varsa HTTP süresinden sonradan çıkarmadım.
Sabit bütçede ne çıktı
| Model | Seed | İlk kabul | Son kabul | En iyi ara deneme |
|---|---|---|---|---|
| Qwen3.8 | 42 | 0/22 | 0/22 | 0/22 |
| Qwen3.8 | 43 | 0/22 | 13/22 | 20/22 |
| Qwen3.8 | 44 | 0/22 | 0/22 | 0/22 |
| Qwen Coder | 42 | 0/22 | 0/22 | 0/22 |
| Qwen Coder | 43 | 0/22 | 0/22 | 0/22 |
| Qwen Coder | 44 | 0/22 | 0/22 | 0/22 |
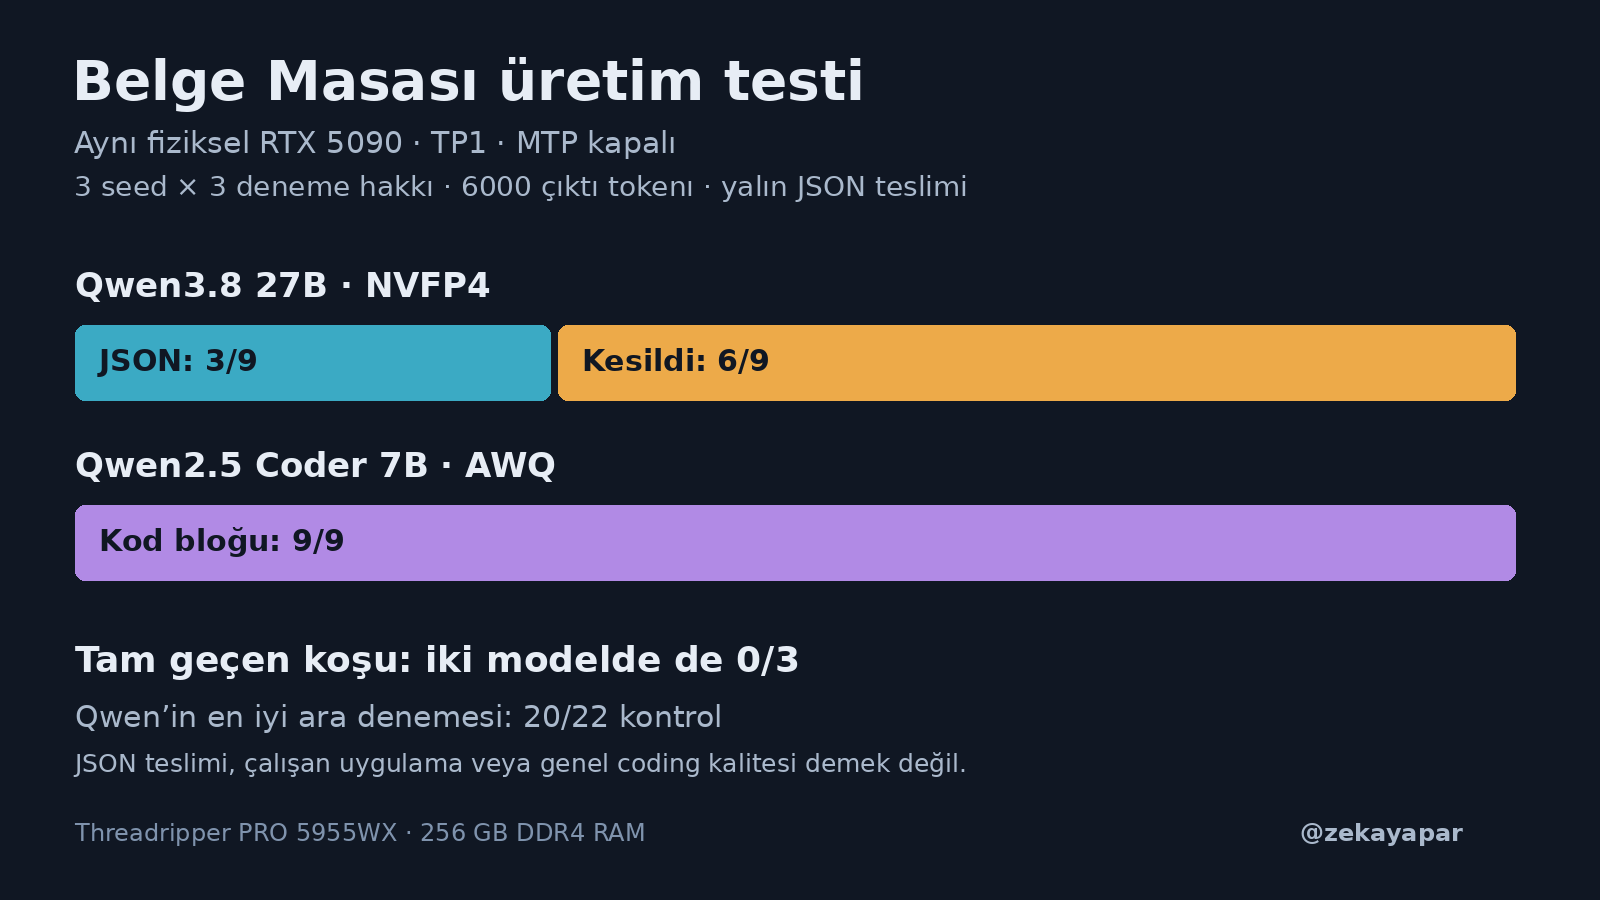
Qwen’in dokuz yanıtından altısı 6000 token sınırında kesildi. Üçü iki tam dosyalı JSON verdi; biri HTTP sunucusu başlangıcında hata verdi, diğer ikisi 20/22 ve 13/22 geçti. Son geri bildirim her zaman iyileştirmedi: 20/22 paketin yerine gelen 13/22 pakette TXT/PDF akışı bozuldu.
Coder dokuz yanıtın tamamında JSON’u Markdown kod bloğuna koydu. Görev açıkça yalın JSON istediği ve bu koşul önceden sabitlendiği için, kod bloğunu sonradan temizleyip başarılı teslim saymadım. Coder’ın uygulama testleri bu yüzden başlamadı. Bu sıfırlar “coder’ın arama veya cevap kalitesi sıfır” anlamına gelmiyor; teslim koşulu sağlanmadı. Aynı nedenle iki uygulamanın gerçek RAG kalitesini karşılaştırmış olmuyorum.
İki modelde de ilk denemede ve son geri bildirimden sonra tam geçen koşu sayısı 0/3. Tek uygulamanın üç seed ile üretimi, üç bağımsız proje veya genel coding model sıralaması değildir.
Süreleri nasıl okumak gerekiyor
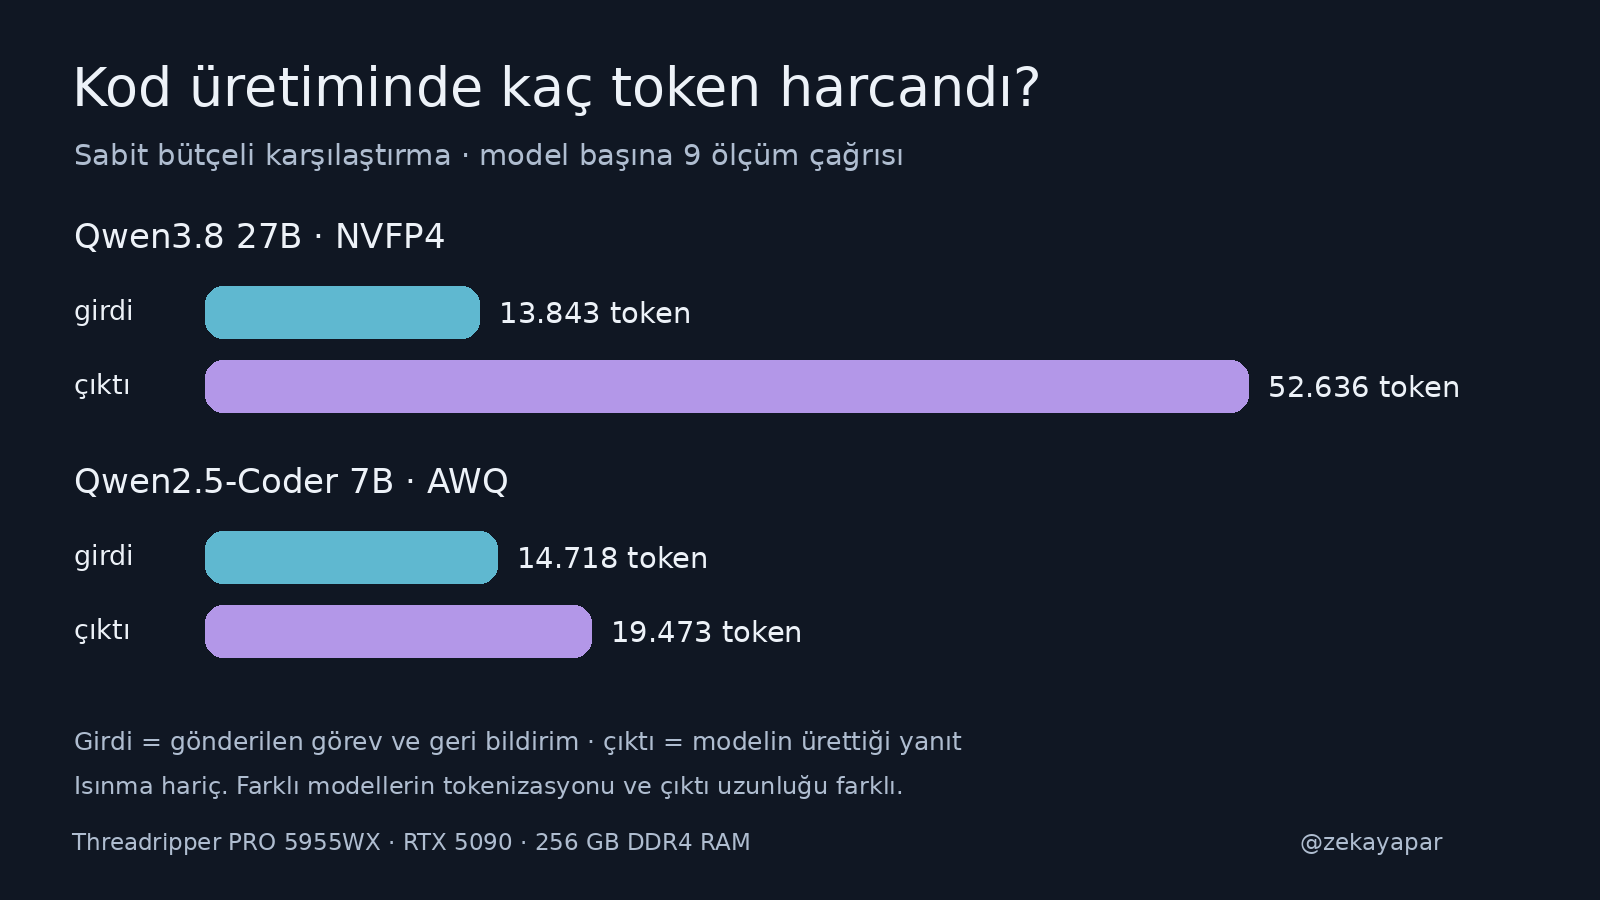
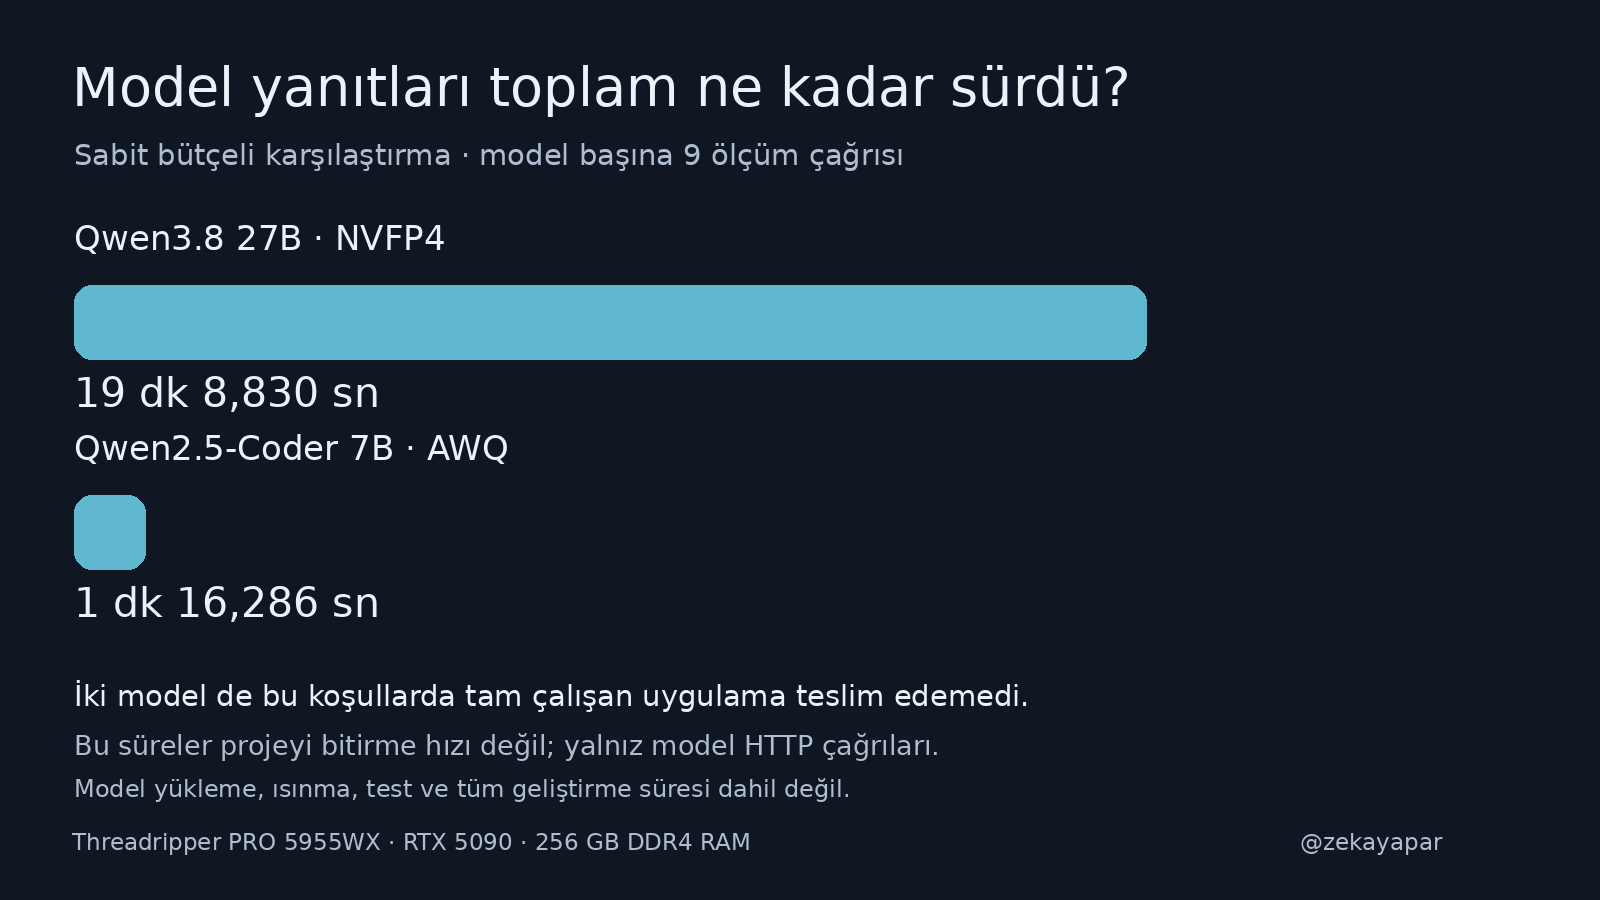
Qwen’in dokuz ölçüm çağrısında toplam 1148,830 sn model HTTP süresi ve 52.636 çıktı tokenı; coder’da 76,286 sn ve 19.473 çıktı tokenı kaydedildi. Çağrı başına medyan TTFT 157,25 ms ve 127,40 ms; stream’den hesaplanan medyan decode hızı 45,88 ve 259,14 token/sn oldu.
Coder daha az çıktı üretti ve çalışan teslim vermedi. Bu toplam süreleri “projeyi şu kadar kat hızlı bitirdi” diye yorumlayamam. Buradaki hız, bu üretim yanıtlarının hızıdır. Model yükleme, test, hata inceleme, üretim servisine geri dönüş ve tüm geliştirme süresi değildir. Farklı tokenizasyonlar ve model ağırlıkları da korunuyor.
Çalışan uygulamayı nasıl tamamladım
Kontrollü karşılaştırma bittikten sonra ana Qwen servisini geri açtım. Gerçek JSON inference doğrulandı; coder, embedding, router ve gateway süreçlerinin PID’leri aynı kaldı, ana Qwen servis dosyası değişmedi.
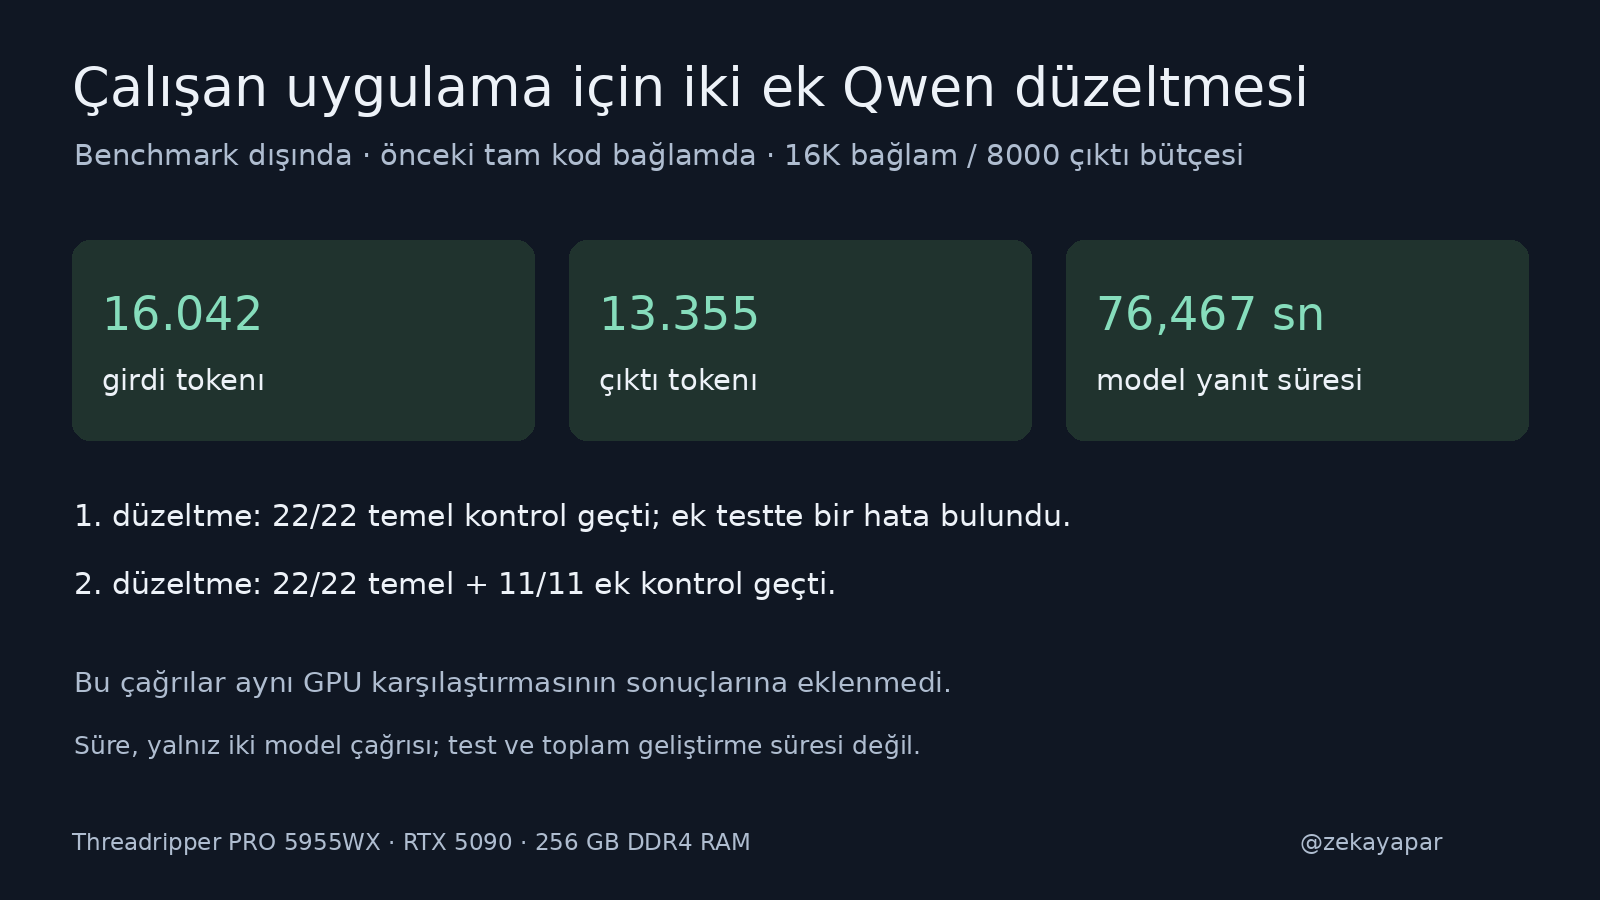
En iyi 20/22 paketi tam kaynak koduyla Qwen’e tekrar verdim. Bu kez önceki tam dosyalar bağlamdaydı, çıktı bütçesi 8000 token ve ana servisin 16K bağlamı kullanıldı. Ürün düzeltmeleri ayrıca kaydedildi. İlk düzeltme 22/22 geçti; ek hata testinde sorgu vektörü boyutu uyuşmazlığı bulundu. İkinci Qwen düzeltmesi 22/22 temel ve 11/11 ek kontrolü geçti. İki çağrıda toplam 13.355 çıktı tokenı ve 76,467 sn model HTTP süresi vardı. Bunlar benchmark sonuç tablosuna eklenmedi.
Tarayıcıdan TXT ve iki sayfalık PDF yükledim, arama ve kaynaklı cevabı kontrol ettim. PDF bütçe sorusu doğru ikinci sayfayı getirdi. Klavyeden soru gönderme, olmayan bilgi ve metinsiz PDF hata durumu çalıştı. 390 piksel görünümde yatay taşma yoktu; gözlenen tarayıcı hata/warning kaydı boştu.
Gerçek embedding ve cevap testi
Dört sentetik belgede 12 sorunun tamamında beklenen belge ve sayfa ilk üç kaynakta bulundu. Cevaplar 12/12 doğru bilgiyi verdi. Belgelerde olmayan ev adresi, parola ve maaş sorularında 3/3 kez “Bu bilgi belgelerde bulunamadı.” yanıtı alındı. Gerçek yanıt metinleri ayrıca okundu; yalnız sayısal parça eşlemesine dayanılmadı.
Benchmarktaki 20/22 aday da aynı küçük setin 12 bilinen sorusuna doğru cevap verdi; bilinmeyen üç soruda bilgi olmadığını söyledi. İlk otomatik regex “bulunmamaktadır” ifadesini kaçırdığı için 0/3 gösteriyordu; ham sonuç değiştirilmedi, elle okuma sonucu 3/3 ayrı kaydedildi. Final uygulamada otomatik ifade kontrolü de 3/3 geçti.
Kabul testlerinin ilk aşaması deterministik sahte embedding/chat backendleriyle HTTP davranışını ölçüyordu. Bu puanları gerçek retrieval ve cevap kalitesi saymadım. Gerçek model seti de küçük; genel RAG kalitesi, büyük belge koleksiyonu, çoklu kullanıcı kapasitesi veya üretim güvenliği sonucu çıkaramam.
Sonuç ve tekrar çalıştırma
Çalışan bir yerel belge masası çıktı, ama tek istemle ilk denemede tamamlanmadı. Sabit bütçeli coding teslim testi, token sınırı ve çıktı sözleşmesine uyum sorunlarını gösterdi. Sonraki tam kodlu Qwen düzeltmeleri ise çalışan ürünü tamamladı.
Görev metnini, test belgelerini, model çıktıları ve ham ölçüm kayıtlarını sakladım. Proje deposu şu an özel. Uygulama yalnız localhost üzerinde tek kullanıcılı prototip; OCR, kimlik doğrulama ve çoklu kullanıcı özellikleri bu projede yok.