 zekayapar
Qwen ve küçük coder’a aynı üç kod işini verdim
CSV, aralık birleştirme ve topolojik sıralama: hız ile testten geçme oranını birlikte ölçtüm.
Model ve yerleşim
- Qwen3.8-27B · NVFP4
- Qwen2.5-Coder-7B · AWQ
- RTX 5090 · kart başına 32 GB
- Threadripper PRO 5955WX
- Qwen: GPU0/1 · coder: GPU2
Yazılım ortamı
- vLLM 0.30.0
- PyTorch 2.13.0+cu132
- FlashInfer 0.6.18.post1
- Transformers 5.18.0
- Doğrudan localhost HTTP
Aynı makinede hem büyük Qwen hem de küçük coder çalışıyor. Bu kez ikisine aynı üç JavaScript işini verdim: CSV satırlarını ayrıştırma, kapalı aralıkları birleştirme ve deterministik topolojik sıralama. Üretilen fonksiyonları önceden yazılmış testlerle çalıştırdım.
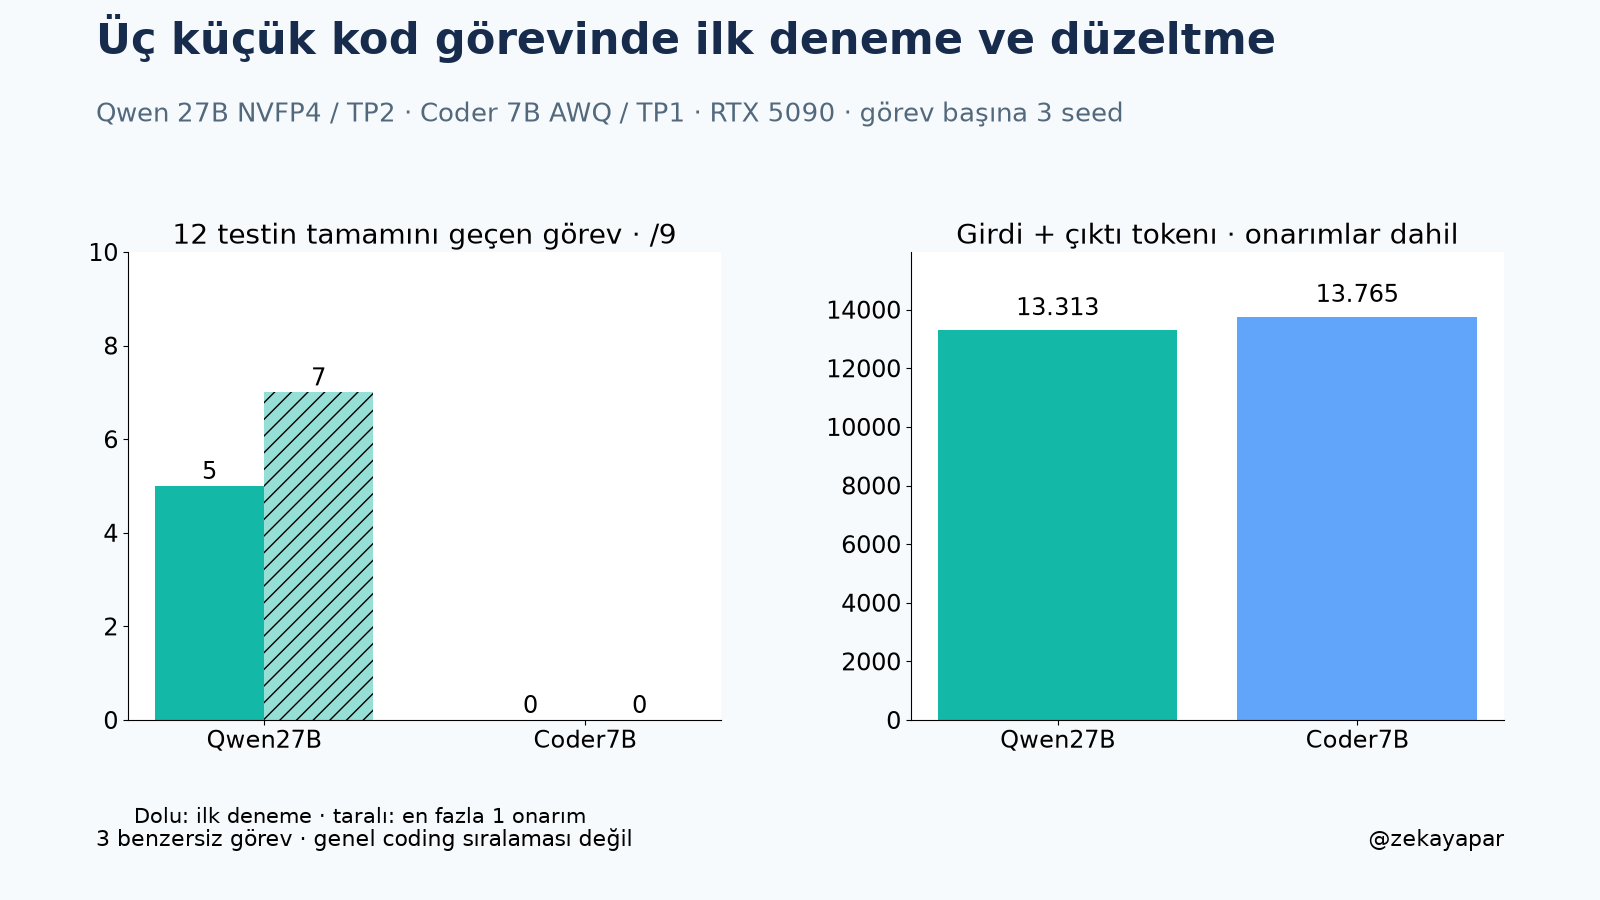
| Model | İlk tam geçiş | Bir onarım sonrası | İlk testler | Son testler |
|---|---|---|---|---|
| Qwen | 5/9 | 7/9 | 100/108 | 104/108 |
| Coder 7B | 0/9 | 0/9 | 72/108 | 72/108 |
Dokuz deneme, üç farklı iş
Her görev için üç seed kullandım: 42, 43 ve 44. Her çalıştırmada 12 sabit kontrol vardı. Çıktı bütçesi 2048 token, temperature 0,2. Başarısız ilk denemeye bir kez onarım hakkı verdim; başarısız test girdilerini ve beklenen sonuçları modele gösterdim.
Qwen ilk denemede beş çalıştırmanın bütün testlerini geçti; onarım sonrası bu sayı yediye çıktı. Coder hiçbir çalıştırmada bütün testleri geçemedi, ama bu bütün çıktılarının yanlış olduğu anlamına gelmiyor: 108 kontrolün 72’sini geçti.
Hız ve doğruluk ayrı
İlk denemeler ve onarımlar birlikte Qwen’de 49,617 saniye, coder’da 26,915 saniye model HTTP süresi tuttu. Onarım sayıları ve üretilen kodlar farklı olduğu için bu toplamları eşit iş başına hız gibi okumuyorum. Qwen dört, coder dokuz onarım aldı.
Girdi verisini değiştirmeme kontrolü promptta vardı; onarım geri bildiriminde ise bu hatanın nedeni açıkça gösterilmedi. Bu eksiklik onarım sonuçlarının yorumunu sınırlar. İlk deneme sonuçları bundan etkilenmiyor.
Bu sonuçla ne söylüyorum?
Bu üç işte Qwen daha fazla tam geçiş verdi. Dokuz tekrar, dokuz farklı problem değil. Model boyutu, quantization ve GPU paylaşımı da farklı; eşit donanımla genel coding sıralaması yapmadım. Testler fonksiyonların seçilmiş durumlarını kapsıyor.
Çalışan düzen
13 Ekim 2026 ölçümleri. Qwen3.8-27B NVFP4 iki RTX 5090 üzerinde TP2/MTP3 ile; Qwen2.5-Coder-7B AWQ ve Qwen3-Embedding-0.6B üçüncü RTX 5090 üzerinde birlikte çalışıyordu. Threadripper PRO 5955WX; kart başına 32 GB VRAM. vLLM 0.30.0, PyTorch 2.13.0+cu132, FlashInfer 0.6.18.post1 ve Transformers 5.18.0.
Servisleri veya model yerleşimini değiştirmedim. Doğrudan localhost HTTP üzerinden, tek aktif benchmark isteğiyle ölçtüm; gateway, HTTPS ve internet gecikmesi bu sayılara dahil değil. Her çağrı öncesinde backend kuyruğunu kontrol ettim, fakat sonradan başka trafik gelmesini engellemedim. Bunlar kısa deneyler; çoklu kullanıcı kapasitesi veya kesintisiz çalışma garantisi çıkarmıyorum.
Ayrıntılı sonuç raporu ↗ · Önceden sabitlenen yöntem ↗ · Değerlendirme sınırları ↗. Bu bağlantılar ölçüm raporlarının yayımlanan kopyaları; ham istek ve yanıt arşivi bu sayfada bulunmuyor.
Aynı geceki MTP açık/kapalı testi ↗ · Diğer benchmark yazıları