 zekayapar
MTP’yi doğruluk ve eşzamanlı isteklerle denedim
Aynı Qwen’de cevap doğruluğu, toplam hız, kişi başına hız ve ilk yanıt süresini ayrı ölçtüm.
Model ve donanım
- Qwen3.8-27B · NVFP4
- 2× RTX 5090 · kart başına 32 GB
- Threadripper PRO 5955WX
Çalıştırma ortamı
- vLLM 0.30.0 · PyTorch 2.13.0+cu132
- FlashInfer 0.6.18.post1
- TP2 · BF16 KV · 16K bağlam
- MTP kapalı / MTP3
- 10 sequence · batch 2.048
Önceki MTP testinde tek isteğin üretim hızına bakmıştım. Cevap doğruluğunu ve aynı anda birkaç istek geldiğinde ne olduğunu ölçmemiştim. Bu kez Qwen’i aynı iki RTX 5090 üzerinde, MTP3 açık ve kapalı çalıştırıp bu iki soruyu ayrı değerlendirdim.
Eski koşullarla yeniden ölçüm — 13 Ekim güncellemesi
İlk devam testinin istek ayarlarını önceki hız testinden farklı kurmuştum. Değişen tek şey cache kimliği değildi: kısa bir sistem mesajı eklemiş, top_p/top_k değerlerini de farklı göndermiştim. Bu yüzden eski ve yeni sayılar arasındaki farkı yalnız cache’e veya MTP’ye bağlayamazdım. Devam yazısında eski koşulu yeniden ölçmem gerekirdi.
Bu tekrarın üç istemi ve HTTP istek gövdesi eski hız testiyle birebir: yalnız user mesajı, temperature 0, presence penalty 0, seed 42, thinking kapalı, aynı cache_salt, 512 çıktı tokenı ve ignore_eos. top_p/top_k eski testteki gibi istekte gönderilmedi; sunucu varsayılanları korundu. Model revision’ı, üretim script hash’i ve dört kütüphane sürümü eski testle aynı. Açık/kapalı geçici servislerde yalnız MTP speculative-config değişti.
1, 5 ve 10 eşzamanlı isteği her istemde üç kez, her profilde iki blok ölçtüm. Sıra açık–kapalı–kapalı–açık. Her aşamada her istem ve eşzamanlılık şekli için 512 tokenlık ayrı ısınma yaptım. Eski testte yalnız tek istek ısınması ve açık→kapalı sırası vardı. Bu iyileştirmeleri saklamıyorum: ana kontrollü karşılaştırma yeni turun kendi açık/kapalı sonuçları; eski sayılar aynı istek ayarlarının farklı zamandaki tekrarı.
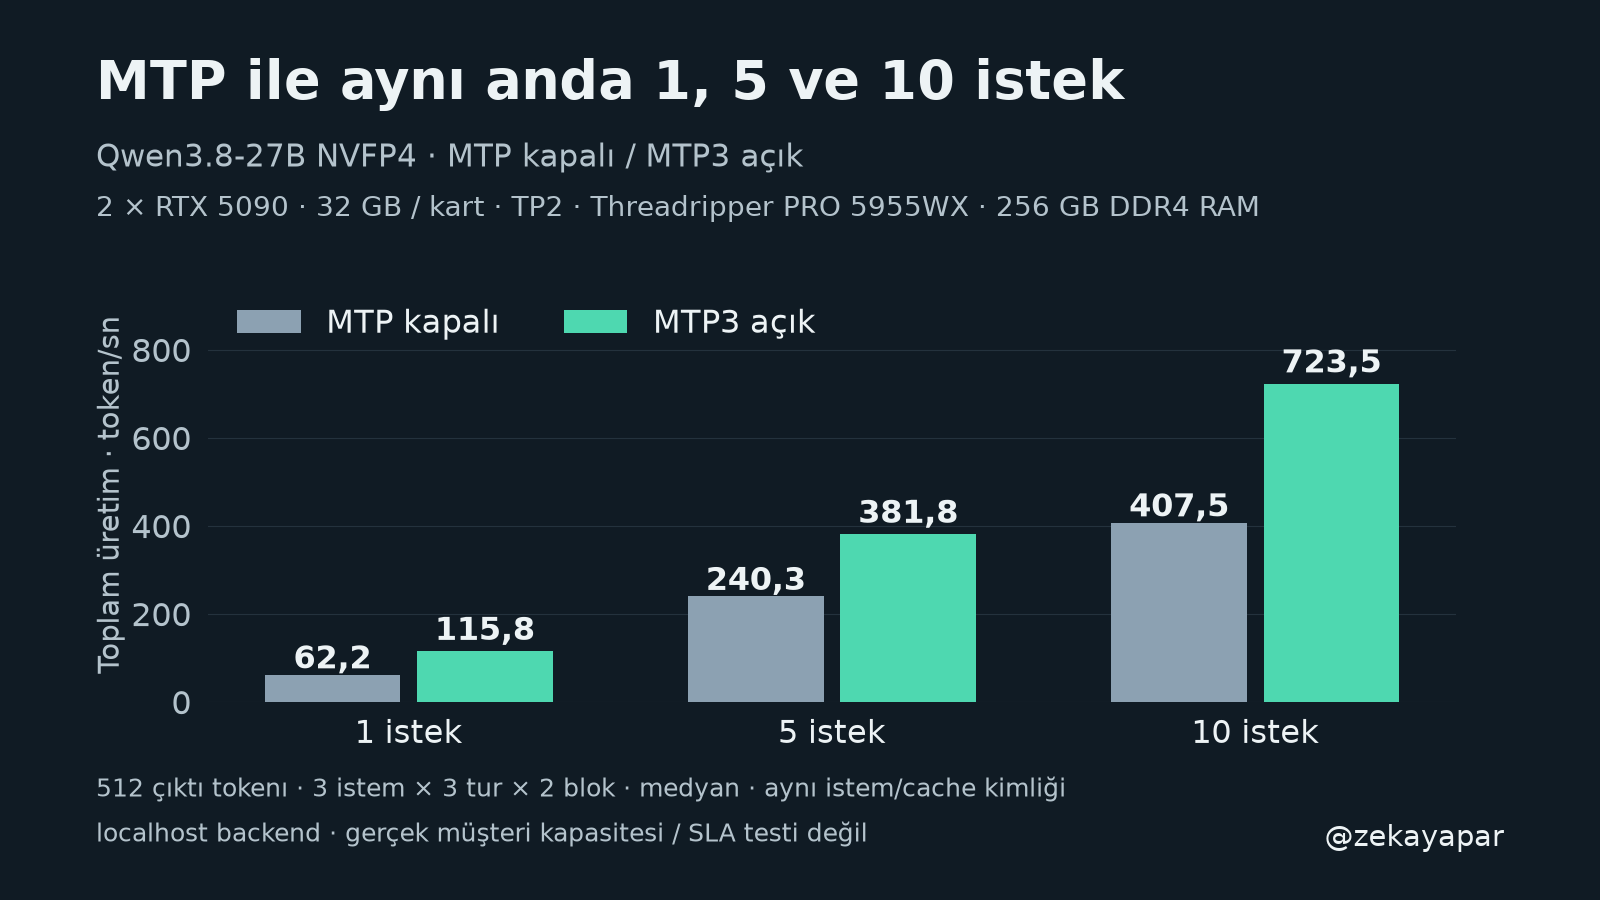
| İstek | Kapalı toplam token/sn | Açık toplam token/sn | Kapalı kişi başına | Açık kişi başına |
|---|---|---|---|---|
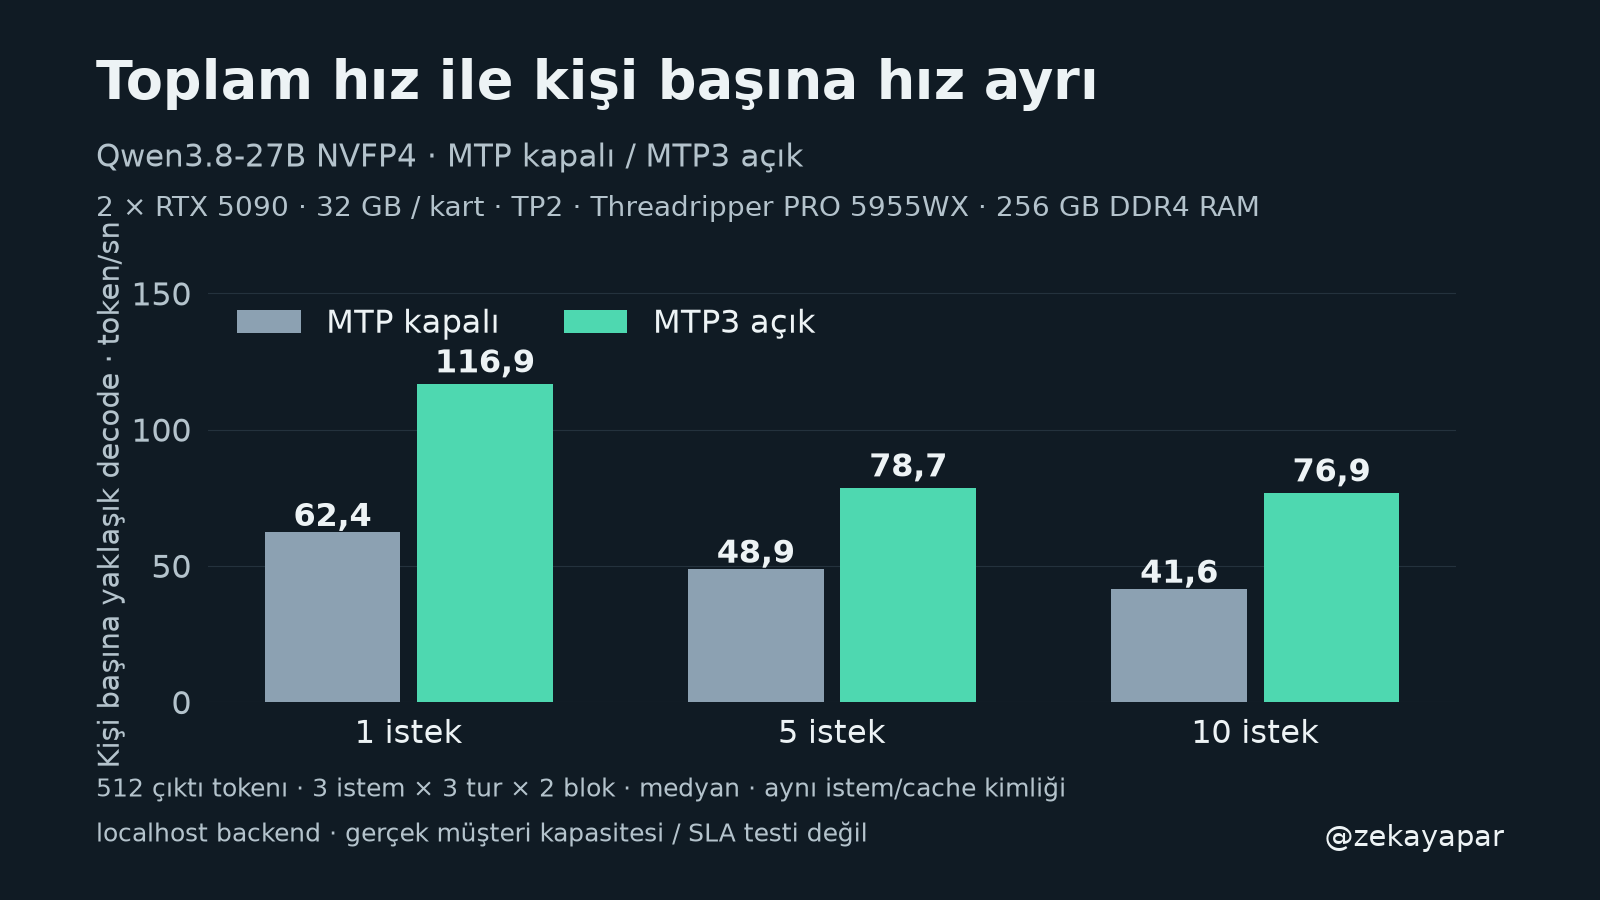
| 1 | 62,18 | 115,77 | 62,42 | 116,88 |
| 5 | 240,28 | 381,78 | 48,94 | 78,70 |
| 10 | 407,47 | 723,45 | 41,60 | 76,88 |
| İstek | Kapalı TTFT p50 / p95 | Açık TTFT p50 / p95 |
|---|---|---|
| 1 | 47,08 / 51,01 ms | 47,20 / 53,29 ms |
| 5 | 197,75 / 209,19 ms | 214,65 / 228,27 ms |
| 10 | 244,51 / 261,30 ms | 239,14 / 276,22 ms |
Önceki tek istek sayıları yeniden üretildi mi?
| Profil | İstem | Eski token/sn | Yeni token/sn |
|---|---|---|---|
| MTP3 açık | Açıklama | 115,86 | 116,88 |
| MTP3 açık | Kod | 147,29 | 148,18 |
| MTP3 açık | Hikâye | 93,97 | 94,75 |
| MTP kapalı | Açıklama | 65,00 | 62,43 |
| MTP kapalı | Kod | 64,94 | 62,42 |
| MTP kapalı | Hikâye | 65,07 | 62,36 |
Tablo kişi başına yaklaşık decode medyanlarını gösteriyor. Yeni tekrarda istem başına altı, eski testte üç ölçüm var. Farklı zamanda alınmış sonuçlar aynı anda yapılmış tek değişkenli deney değildir; yeni açık/kapalı bloklar bunun için var.
Aynı cache kimliği, cache isabeti demek değil
Eski testte aynı istemi aynı cache kimliğiyle tekrarladığım için yöntemi “sıcak prefix” diye adlandırmıştım. Bu tekrarda backend sayaçlarına da baktım: gözlenen en yüksek prefix cache isabeti 0. Girdiler kısa; sunucu MTP açıkken 800, kapalıyken 784 tokenlık cache blokları bildiriyor. Tekrar edilen kısa istemin gerçekten cache’den yararlandığını gösteremedim. Bu nedenle sonuçları prefix cache kazancı diye sunmuyorum. Uzun ortak öneklerde cache etkisi ayrıca ölçülmeli.
576 ana yük + 192 ısınma + 1 üretime dönüş isteği: 769 başarılı yanıt, sıfır hata. Örneklenmiş en yüksek sıcaklık 51°C. Bu tekrar doğruluğu yeniden ölçmedi; aşağıdaki 20 JSON ve üç kod görevindeki doğruluk sonuçları ilk deneyden geliyor. Kısa, aynı istemli localhost yükü gerçek müşteri kapasitesi veya SLA değildir. Toplam throughput, kişi başına hız ve ilk yanıt gecikmesi ayrı metriklerdir.
Tekrarın ayrıntılı raporu ↗ · İstem/blok bazlı sayılar ↗ · Sabit tekrar protokolü ↗ · Yöntem denetimi ↗
İlk devam deneyi: doğruluk ve ayrı istek ayarları
Aşağıdaki ilk deneyin ham verilerini ve sonuçlarını koruyorum. Bu deneyin kendi MTP açık/kapalı koşulları eşitti; önceki hız testine karşı eşit koşullu tekrar değildi. İki seri farkından yalnız cache etkisi sonucu çıkarılamaz.
Önce cevapların doğruluğu
20 farklı sentetik Türkçe sipariş ve üç JavaScript görevi kullandım: CSV parser, kapalı aralık birleştirme ve deterministik topolojik sıralama. JSON’da sipariş numarası, miktar ve hızlı kargo bilgisini kontrol ettim. Kodda her görev için önceden yazılmış 12 sabit test vardı.
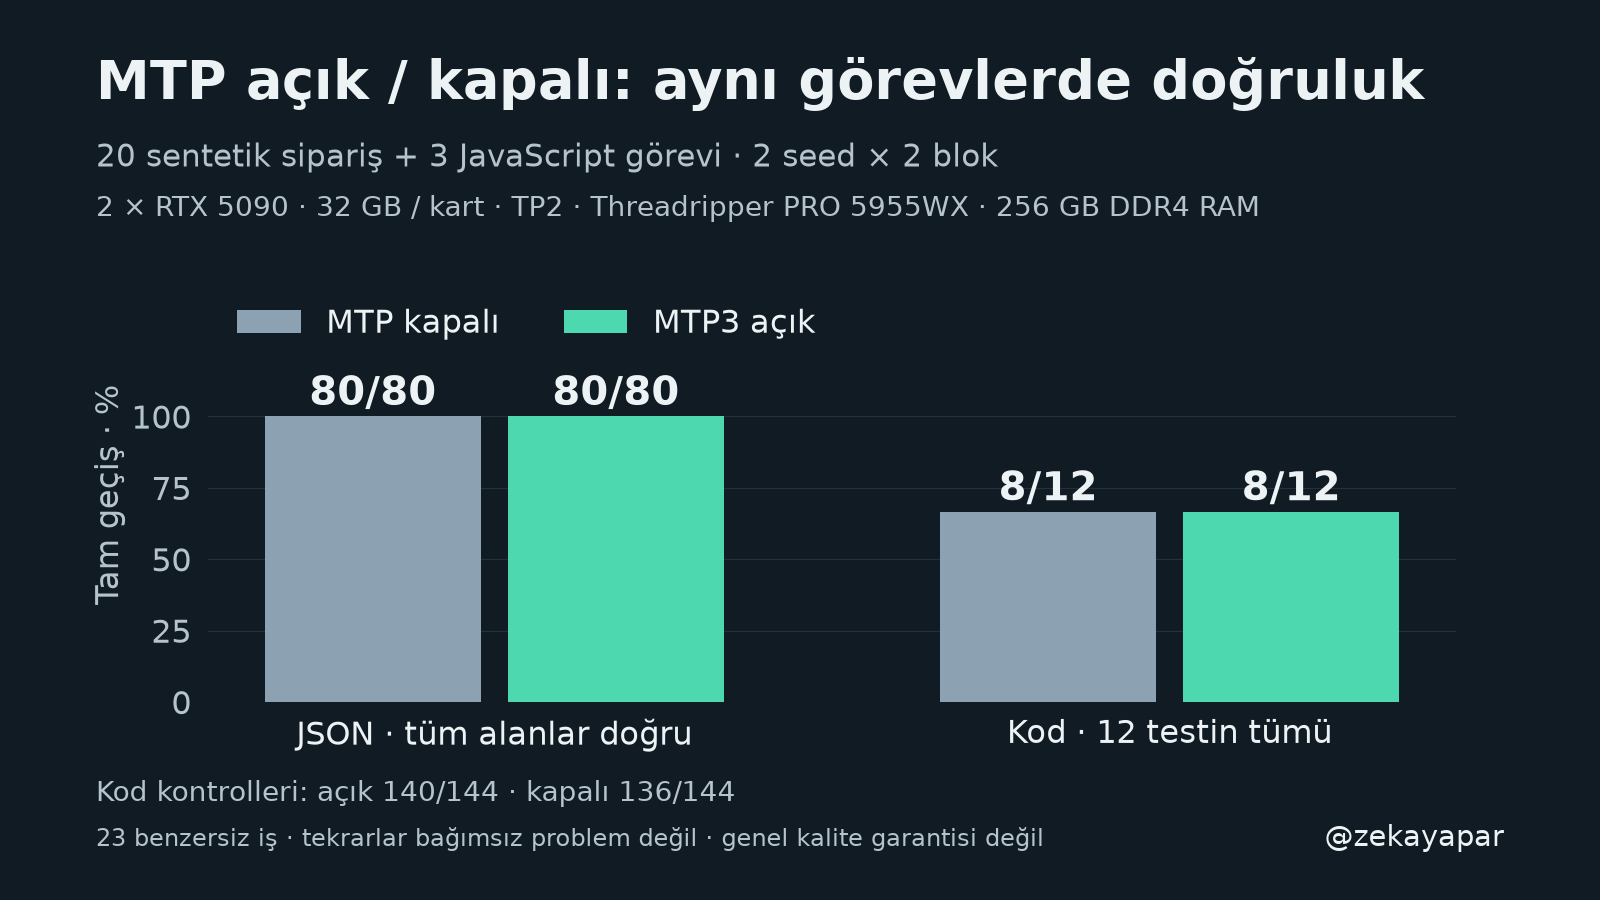
| Kontrol | MTP kapalı | MTP3 açık |
|---|---|---|
| JSON: bütün alanlar doğru | 80/80 | 80/80 |
| Kod: bütün testleri geçen çalıştırma | 8/12 | 8/12 |
| Kod: geçen tekil kontrol | 136/144 | 140/144 |
Her işi iki seed ve iki blokla tekrarladım. Her profil için 80 JSON ve 12 kod yanıtı var; bu, 92 bağımsız problem demek değil. Veri kümesi önceki geceki coding/JSON testinden geliyor. Temperature 0 ile greedy üretim kullandığım için seed değişimini yeni bağımsız rastgele örneklem gibi yorumlamıyorum.
Tam geçiş aynı, hata veren kontroller farklı
Aralık birleştirme ve topolojik sıralama iki profilde de bütün testleri geçti. CSV parser MTP kapalıyken 10/12, açıkken 11/12 kontrol geçti. Her iki durumda CSV çalıştırması tam geçiş alamadı; ama hata veren testler aynı değildi. Bu nedenle yalnız 8/12 tam geçiş sayısını göstermek, tekil kontrollerdeki farkı saklamış olurdu.
Eşleştirdiğim aynı blok/görev/seed yanıt çiftlerinin yalnız 40/92 tanesinde metin SHA256’sı aynıydı. Doğru JSON alanları veya eşit test geçiş oranı, aynı metnin ya da aynı kodun üretildiği anlamına gelmiyor.
Bu küçük kümede MTP’nin genel cevap kalitesini değiştirmediğini kanıtlamış değilim. Açık uçlu yazı kalitesini insan değerlendirmesiyle incelemedim; üç kod görevinden genel coding sıralaması da çıkarmıyorum. Buradaki sonuç, bu sabit işlerde ölçülen doğruluk.
İlk deneyin yük sonuçları: 1, 5 ve 10 istek
Yük kısmında açıklama, kod ve hikâye istemlerini kullandım. Her yanıtı 512 tokena sabitledim; doğal bitişi yok saydım. Her koşul iki tur, her profil iki blok: istek sayısı/profil başına 12 yük grubu, toplam 384 model isteği.
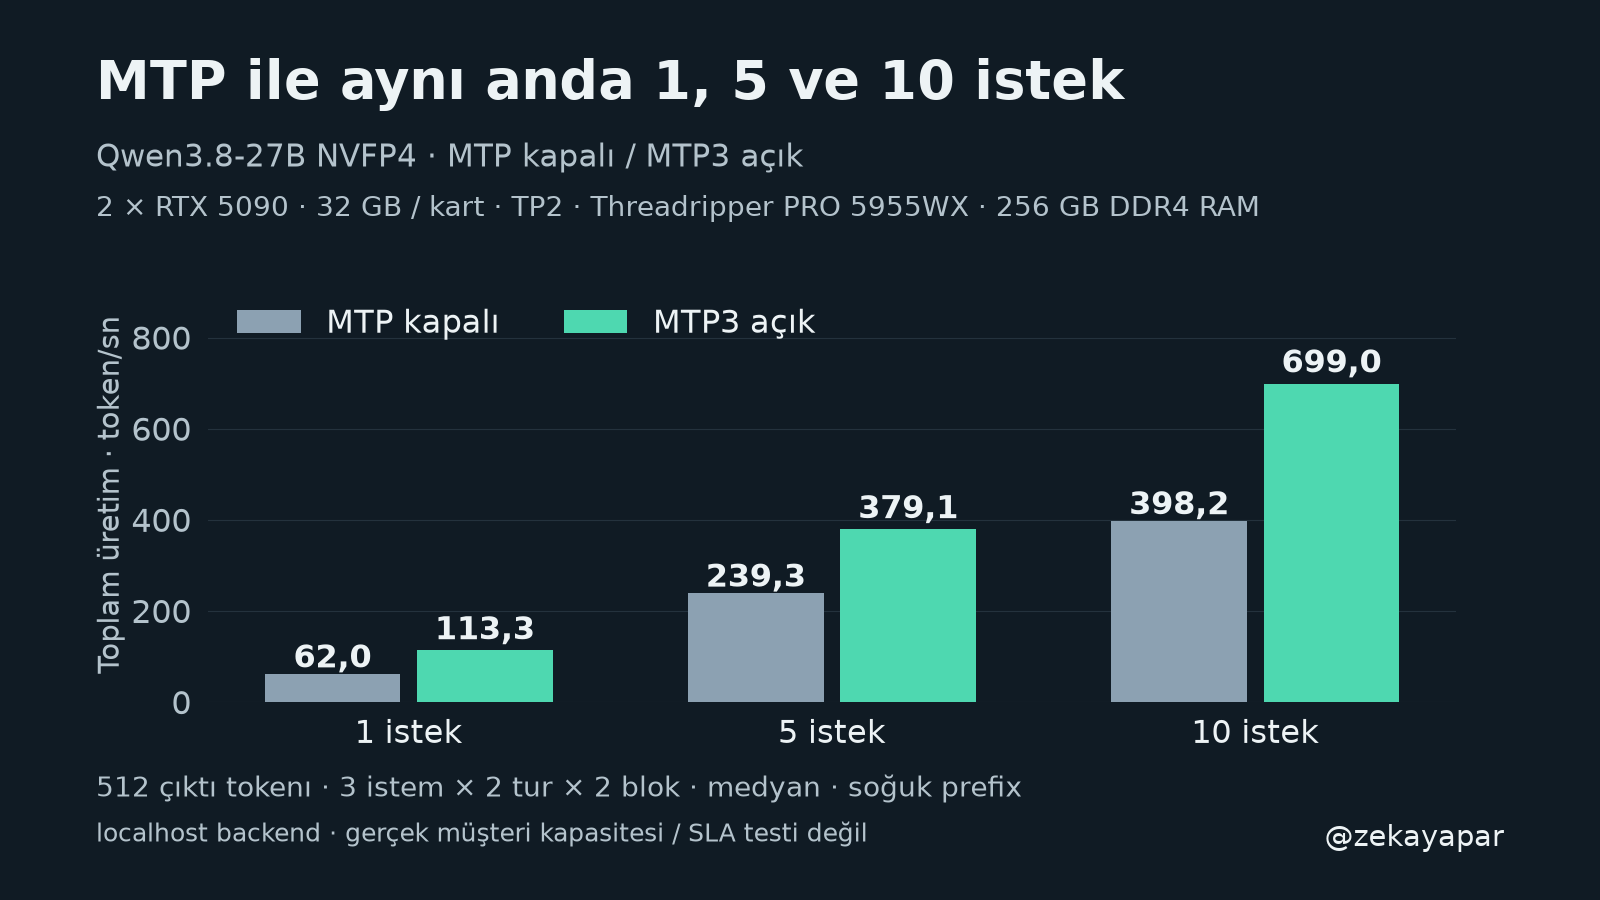
| Eşzamanlı istek | Kapalı toplam token/sn | Açık toplam token/sn |
|---|---|---|
| 1 | 62,02 | 113,31 |
| 5 | 239,34 | 379,07 |
| 10 | 398,24 | 698,96 |
Toplam hız, gruptaki bütün çıktı tokenlarının ilk istek başlangıcından son yanıtın bitişine kadar geçen süreye bölümü. İstemci hazırlığı, model başlangıcı ve ayrı kontroller bu hız hesabına dahil değil. Grup duvar saati ve isteklerin zaman aralığı ham kayıtlarda ayrı tutuluyor.
Toplam hız, kişi başına hız değil
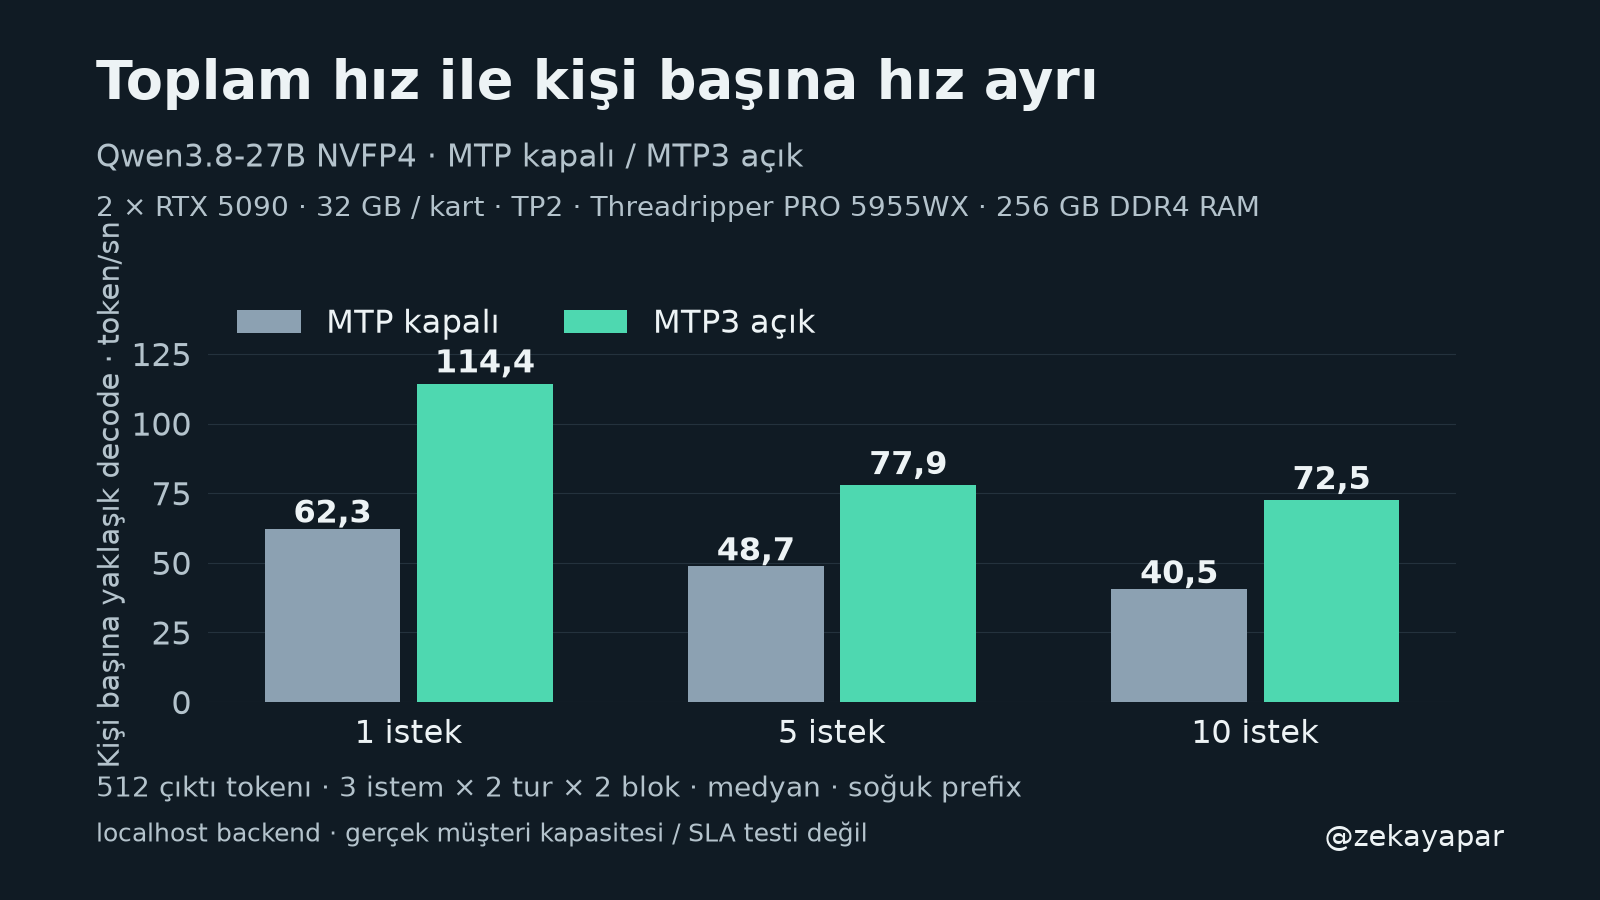
| Eşzamanlı istek | Kapalı kişi başına token/sn | Açık kişi başına token/sn |
|---|---|---|
| 1 | 62,25 | 114,37 |
| 5 | 48,71 | 77,85 |
| 10 | 40,48 | 72,47 |
MTP açıkken toplam hız 10 istekte yaklaşık 699 token/sn’ye çıkıyor; tek isteğin hızı yaklaşık 72 token/sn. 699’u her kullanıcıya verilmiş bir hız gibi okumamak gerekiyor. Buradaki kişi başına değer ilk ve son içerik parçası arasından hesaplanan yaklaşık decode medyanı. MTP bir SSE parçasında birden fazla token verebildiği için sunucunun token başına gecikmesi değil.
İlk yanıt daha erken gelmedi
| İstek | Kapalı TTFT medyan / p95 | Açık TTFT medyan / p95 |
|---|---|---|
| 1 | 50,13 / 54,68 ms | 49,95 / 55,77 ms |
| 5 | 200,45 / 207,18 ms | 216,00 / 223,53 ms |
| 10 | 266,20 / 288,30 ms | 286,40 / 315,26 ms |
TTFT, istemcinin ilk içerik parçasını aldığı ana kadar geçen süre. 10 istekte medyan 266,20 ms’den 286,40 ms’ye geldi. Üretim hızlandı; ilk içerik biraz daha geç geldi. Bu, kısa testteki gözlem. Küçük örnekten p95 hizmet garantisi çıkarmıyorum.
Sıranın etkisini nasıl azalttım?
Profilleri açık–kapalı–kapalı–açık, yani ABBA sırasıyla çalıştırdım. Böylece her profil hem önce hem sonra ölçüldü. 10 istek toplam medyanları ilk/ikinci blokta MTP açıkken 703,74 / 695,38; kapalıyken 390,10 / 406,86 token/sn oldu. Koşulların blok içindeki sırası önceden sabit seed ile karıştırıldı; her profil aynı blok sırasını kullandı. ABBA zamansal kaymayı azaltır ama tam randomize bağımsız bir donanım deneyi değildir.
Her aşamada üç tek istekli, 128 tokenlık ısınma yaptım. Bu, 512 çıktılı ve her eşzamanlılık şeklini ısıttığım anlamına gelmiyor. İlk aşamanın loglarında ek kernel/JIT derlemeleri görüldü; bazı ilk gecikmelere girmiş olabilir. Bu ölçümleri sonradan elemedim.
Çalışan model ve ayarlar
GPU0/1: Qwen3.8-27B NVFP4, iki RTX 5090 / kart başına 32 GB VRAM, TP2. GPU2’de hafif coder ve embedding açık kaldı. Threadripper PRO 5955WX kullanıldı. Ağırlık revision’ı 482ca0f3832238542f8f5295dde86b5f22711d80. vLLM 0.30.0, PyTorch 2.13.0+cu132, FlashInfer 0.6.18.post1, Transformers 5.18.0.
16K bağlam, 10 sequence, batch 2048, graph 128, BF16 KV ve FlashInfer profili korundu. Yalnız MTP3 speculative-config kaldırılıp eklendi. Ölçüm için geçici servis localhost 18001’de çalıştı; üretim scripti değiştirilmedi.
İsteklerde temperature 0, top_p 1, top_k 1, presence penalty 0 ve thinking kapalı. JSON 256, kod 2048 token bütçesiyle doğal bitiş kullandı; yük isteklerinde 512 token ve ignore_eos vardı. JSON şeması promptta anlatıldı, üretime şema zorlama uygulanmadı. Kodlar ağsız bwrap/Node VM ortamında 500 ms sınırla kontrol edildi; başarısız koda onarım verilmedi.
İlk deneyin istek ayarları neden farklıydı?
İlk devam deneyinde her isteğin cache_salt’ı ayrıydı; kısa sistem mesajı ve top_p 1 / top_k 1 de vardı. Önceki hız testinde yalnız user mesajı, ortak cache kimliği ve sunucu top_p/top_k varsayılanları kullanılmıştı. Bu nedenle iki deneyin mutlak hızlarını tek değişkenli karşılaştırma olarak sunmuyorum. Eski koşulu tekrarlayan yeni ölçüm ve cache isabeti denetimi bu yazının başında. Aynı salt ile tekrarın gerçek cache reuse anlamına geldiği doğrulanmadı. Ölçümler localhost model sunucusuna doğrudan; gateway/HTTPS/internet/şirket kotası/adil tenant kuyruğu ölçülmedi.
Burada 10 eşzamanlı HTTP isteği var. Gerçek on müşterinin uzun bağlamlı kullanımını veya sürdürülebilir hizmet kapasitesini test etmiş değilim. Her çağrı/grup öncesi diğer backendlerin kuyruğu kontrol edildi; sonradan başka trafik gelmesini engellemedim.
Kaç çağrı, kaç token?
184 doğruluk + 384 yük = 568 ana çağrı. 12 ısınma ve 1 geri dönüş yanıtı ayrı. Toplam 581 kullanım bildiren yanıt, sıfır hata: 64.631 girdi + 217.823 çıktı = 282.454 token. Bunlar model kullanım kayıtları; Codex tokenları veya bütün proje geliştirme süresi değil. Yük telemetrisinde görülen en yüksek sıcaklık 51°C; uzun donanım kararlılığı testi değil.
Üretim Qwen geri açıldı ve gerçek JSON yanıtı verdi. Coder, embedding, router ve gateway süreçleri korundu; üretim script SHA256’sı değişmedi. Bağımsız kurtarma zamanlayıcısı başarılı dönüşten sonra kaldırıldı. Makine yeniden başlatılmadı; public HTTPS üzerinden firma kabul testi yapılmadı.
Veri ve yöntem
Veri, değerlendirici, çalıştırıcı ve raporlama kodu ilk çağrı öncesi SHA256 ile sabitlendi. Ham istekler, yanıtlar, SSE olayları, usage ve GPU/backend telemetrisi saklandı. Bu sayfadan sonuç ve yöntemin yayımlanan kopyalarını indirebilirsin; büyük ham arşiv burada sunulmuyor.
Ayrıntılı sonuç raporu ↗ · Sayısal sonuç özeti ↗ · Önceden sabit protokol ↗ · Sentetik görevler ve sabit testler ↗ · Değerlendirme sınırları ↗
Önceki MTP açık/kapalı hız testi ↗ · Diğer ölçümler