 zekayapar
Aynı uzun girdiyi tekrar gönderince ne değişti?
1K, 4K ve 8K token girdilerde Qwen’in ilk yanıt süresini ve prefix cache kullanımını ölçtüm.
Model ve yerleşim
- Qwen3.8-27B · NVFP4
- RTX 5090 · kart başına 32 GB
- Threadripper PRO 5955WX
- Qwen: GPU0/1 · TP2/MTP3
Yazılım ortamı
- vLLM 0.30.0
- PyTorch 2.13.0+cu132
- FlashInfer 0.6.18.post1
- Transformers 5.18.0
- Doğrudan localhost HTTP
Aynı uzun metni Qwen’e tekrar gönderdiğimde ilk yanıtın ne kadar erken geldiğini ölçtüm. Yaklaşık 1K, 4K ve 8K token girdiler kullandım; metnin içindeki bir kodu bulup JSON olarak döndürmesini istedim.
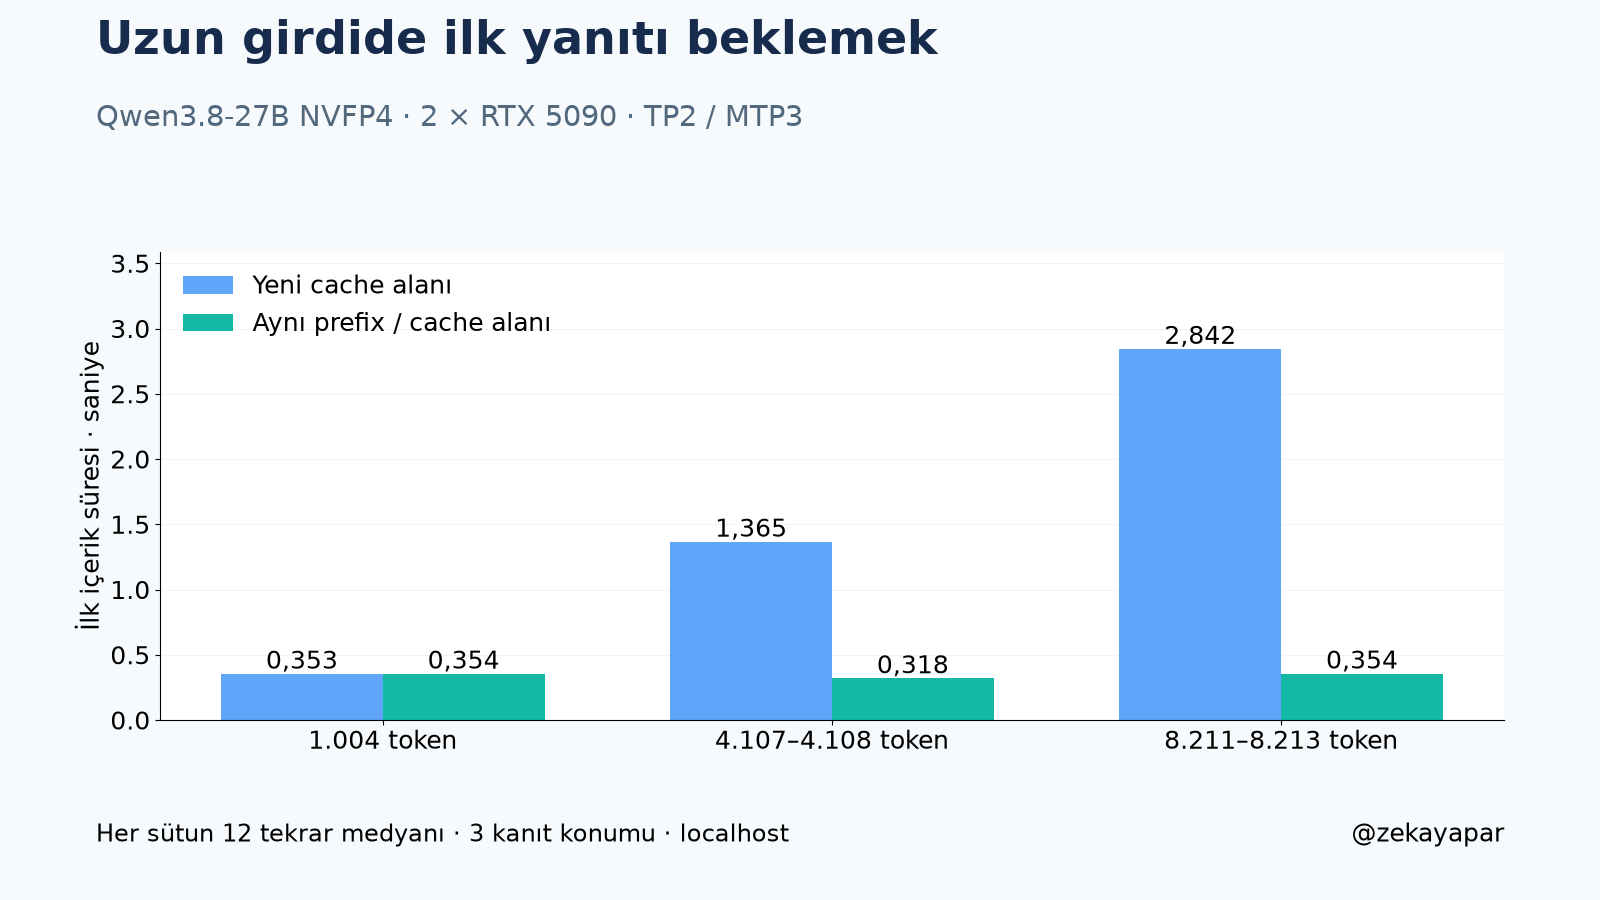
| Hedef girdi | Soğuk prefix medyanı | Sıcak prefix medyanı | Medyan cache hit tokenı |
|---|---|---|---|
| 1K | 353,08 ms | 353,52 ms | 0 |
| 4K | 1364,81 ms | 318,01 ms | 3200 |
| 8K | 2842,14 ms | 353,98 ms | 7200 |
Tekrar göndermek her uzunlukta hız kazandırmadı
4K girdide ilk içerik yaklaşık 1,36 saniyeden 0,32 saniyeye, 8K girdide 2,84 saniyeden 0,35 saniyeye indi. 1K’da ise ölçülen cache hit sıfırdı ve belirgin fark oluşmadı. Aynı metni göndermiş olmaktan cache’in mutlaka kullanıldığı sonucunu çıkarmadım; backend sayaçlarını da kaydettim.
Sıcak ve soğuk ne demek?
İlk doldurma ve sıcak tekrarlar aynı benchmark cache namespace’ini kullandı. Soğuk prefix denemelerinin her birinde farklı salt vardı. Üretim tenant cache’leriyle paylaşım yapılmadı; cache temizlenmedi. Buradaki soğuk, CUDA kernel veya modelin yeniden başlatılmış olması anlamına gelmiyor.
Üç uzunlukta kanıt satırını metnin yüzde 10, 50 ve 90 konumlarına koydum. Her koşulda bir doldurma, dört sıcak ve dört soğuk istek vardı: toplam 81. Her uzunluk/sıcaklık grubundaki 12 ölçüm yalnız üç farklı istemin tekrarı.
Uzun metinde bilgi bulma
Kod 81 isteğin tamamında doğru bulundu. Gerçek girdi sayıları chat şablonu dahil 1004, 4107–4108 ve 8211–8213 tokendi. Temperature 0,2, seed 42, çıktı bütçesi 64 token; doğal bitiş kullanıldı. İlk doldurma istekleri sıcak/soğuk karşılaştırmadan ayrı tutuldu.
Bu kolay bir bilgi bulma görevi. Uzun belgede kapsamlı soru cevaplama, akıl yürütme veya 16K üzerindeki bağlam başarısını ölçmedim. İlk yanıt süresi, istemcinin ilk içerik parçasını aldığı ana kadar geçen süre. Cache sayaçları global olduğundan başka trafik deltalara girebilir; sonuçları bu sınırla yorumluyorum.
Çalışan düzen
13 Ekim 2026 ölçümleri. Qwen3.8-27B NVFP4 iki RTX 5090 üzerinde TP2/MTP3 ile; Qwen2.5-Coder-7B AWQ ve Qwen3-Embedding-0.6B üçüncü RTX 5090 üzerinde birlikte çalışıyordu. Threadripper PRO 5955WX; kart başına 32 GB VRAM. vLLM 0.30.0, PyTorch 2.13.0+cu132, FlashInfer 0.6.18.post1 ve Transformers 5.18.0.
Servisleri veya model yerleşimini değiştirmedim. Doğrudan localhost HTTP üzerinden, tek aktif benchmark isteğiyle ölçtüm; gateway, HTTPS ve internet gecikmesi bu sayılara dahil değil. Her çağrı öncesinde backend kuyruğunu kontrol ettim, fakat sonradan başka trafik gelmesini engellemedim. Bunlar kısa deneyler; çoklu kullanıcı kapasitesi veya kesintisiz çalışma garantisi çıkarmıyorum.
Ayrıntılı sonuç raporu ↗ · Önceden sabitlenen yöntem ↗ · Değerlendirme sınırları ↗. Bu bağlantılar ölçüm raporlarının yayımlanan kopyaları; ham istek ve yanıt arşivi bu sayfada bulunmuyor.
Aynı geceki MTP açık/kapalı testi ↗ · Diğer benchmark yazıları