 zekayapar
HyperQwen ile tek RTX 5090’da Qwen3.8-27B: saniyede 225 token, ama Türkçede %23 yavaş
HyperQwen’i tek RTX 5090’da 450 W’ta denedim: tek kişide 225, 64 kişide 2.696 token/sn. Türkçe istemlerde tahminler daha az tutuyor, hız %23 düşüyor.
Donanım ve çalıştırıcı
- Tek RTX 5090 · güç sınırı 450 W
- HyperQwen · vLLM 0.31.0 + 52 yama
- Kıyas: iki RTX 5090, NVFP4, vLLM 0.30
Model ve ölçüm
- Qwen3.8-27B · 4-bit (W4A16) · DFlash2 tahmini
- Projenin ölçüm betiği + 8 istem, İngilizce ve Türkçe
- GSM8K 200 soru · nvidia-smi enerji
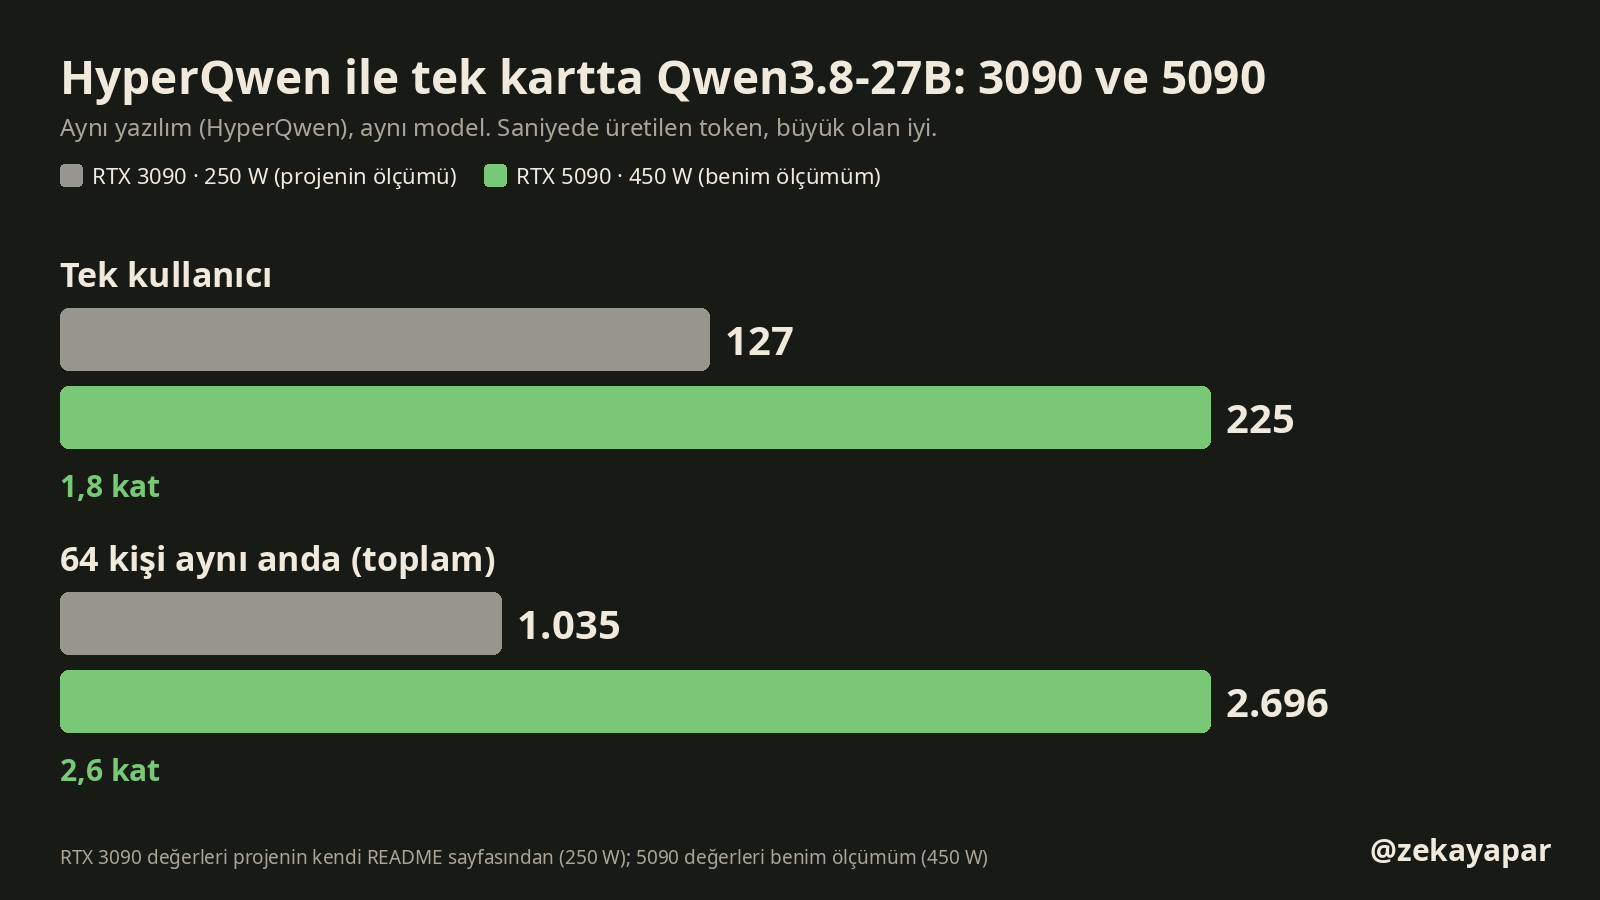
Soru: Bir 3090’da Qwen3.8-27B’yi saniyede 127 token’la çalıştıran açık kaynak bir proje gördüm. Aynısı bir RTX 5090’da, güç sınırı 450 W’ta ne yapıyor, Türkçe sorunca da aynı hızda mı? Kısa cevap: tek kullanıcıda saniyede 225 token, 64 kişi aynı anda sorduğunda toplam 2.696 token çıktı; projenin 3090 rakamlarının 1,8 ve 2,6 katı. Ama aynı soruları Türkçe sorunca tek kullanıcı hızı %23 düştü. Her gün kullandığım iki kartlık kurulumda bu düşüş yalnız %5.
Gönderiyi X’te gördüm: tek bir 24 GB’lık karta 27 milyar parametreli modeli sığdıran, vLLM’e bir dizi yama ve modelin bazı katmanlarını yeniden sıkıştıran bir proje (HyperQwen). Benim masamda dört tane RTX 5090 var ve üçü zaten başka modellerle meşgul. Boştaki kartta aynı kurulumu denedim; diğer servislere dokunmadım, güç sınırını da değiştirmedim.
Nasıl ölçtüm
- Kart: tek RTX 5090, güç sınırı 450 W. Kart ekranın da bağlı olduğu kart; ekrana yer kalsın diye vLLM’e belleğin %84’ünü verdim.
- Yazılım: projenin kendi talimatıyla, Docker olmadan: vLLM 0.31.0 + projenin 52 yaması, Qwen3.8-27B’nin 4-bit (W4A16) sürümü ve projenin yerel hazırlık adımları. İndirme dahil kurulum 11 dakika sürdü.
- Hız: projenin kendi ölçüm betiği (
bench/run_benchmarks.sh). Her modu iki kez çalıştırdım, ilk tur ısınma sayılıyor, ikinci turu yazdım. - Türkçe: projenin kullandığı 8 gerçek istemi (kod yazma, SSD anlatımı, makale, özet…) Türkçeye çevirttim. İki dili sohbet uç noktasından, düşünme kapalı, 1.024 token’a kadar cevapla, iki tekrar ölçtüm.
- Doğruluk: hızlanırken cevapların bozulmadığını görmek için GSM8K’dan 200 matematik sorusu.
- Elektrik: nvidia-smi ile yarım saniyede bir kartın çektiği güç.
Sonuç: 3090’a göre ne kadar hızlı?
Tek kullanıcıda projenin varsayılan “tek kişilik” modu (DFlash2 adlı tahminli üretim) saniyede 225 token üretti; projenin 3090’daki ölçümü 127. 64 isteği aynı anda gönderdiğim “toplu” modda kararlı hız saniyede 2.696 token (başlangıç ve bitişler dahil ortalama 2.496). 3090’da bu sayı yaklaşık 1.035. 64 isteğin her biri yine de ortalama 0,92 saniyede ilk kelimesini aldı.
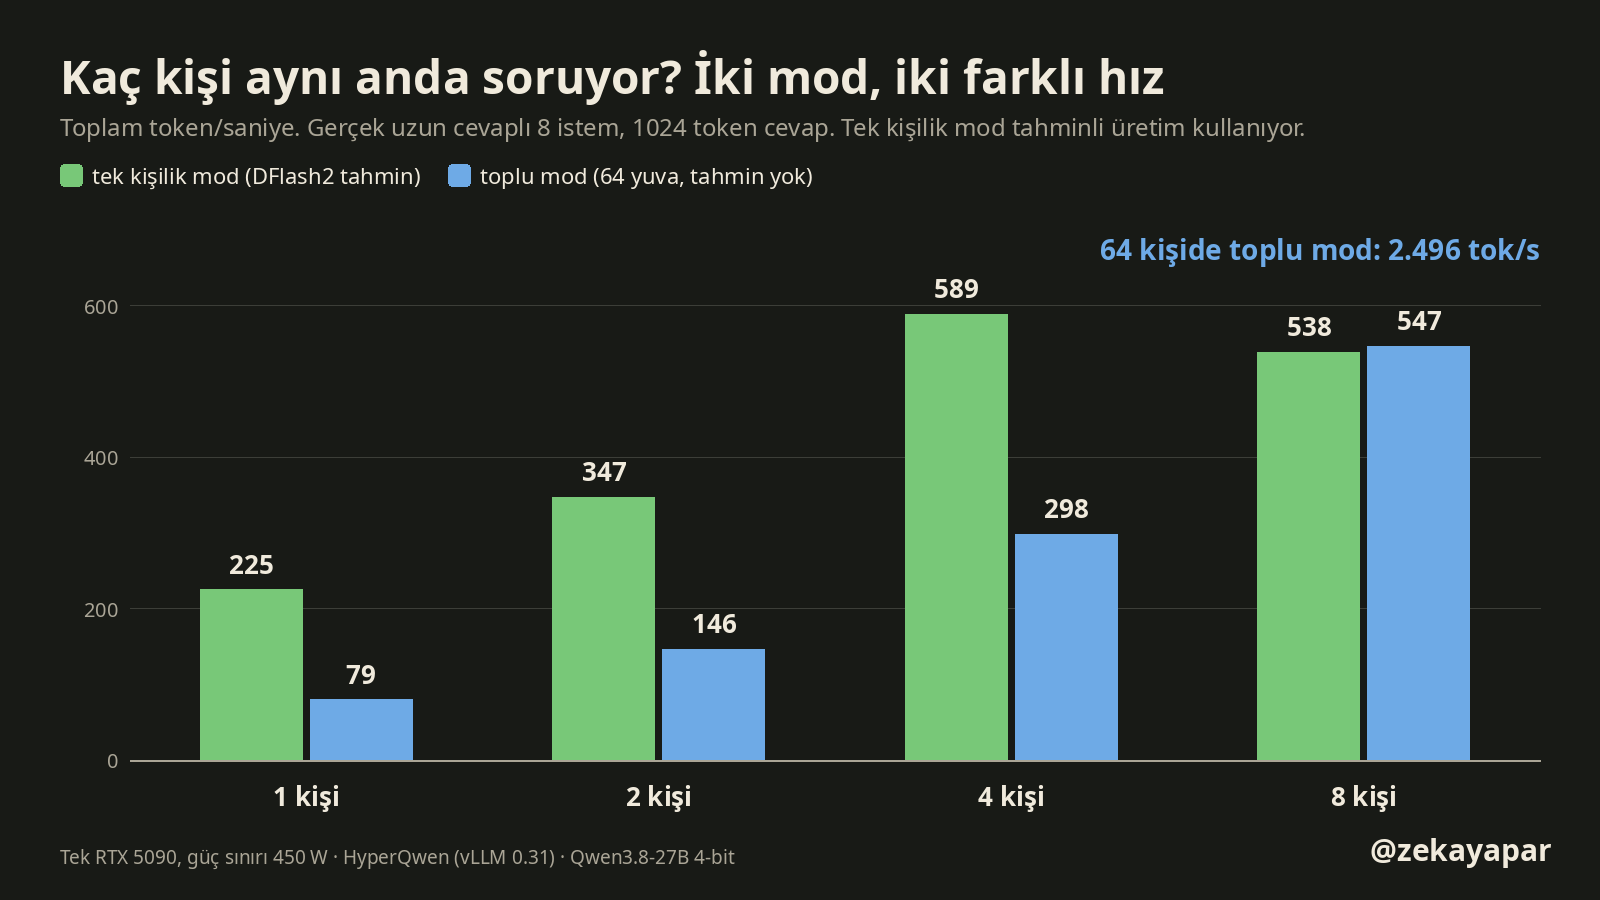
İki mod farklı işler için. Tek kişilik modda küçük bir taslak modeli her adımda birkaç token tahmin ediyor, büyük model bunları tek seferde doğruluyor; doğru çıkanlar bedavaya geliyor. Bu, 1–4 kişide toplu moddan 2–3 kat hızlı. 8 kişide iki mod başa baş (538 ve 547); daha fazla kişi varsa toplu mod öne geçiyor çünkü tek kişilik mod en fazla 8 isteği aynı anda tutuyor.
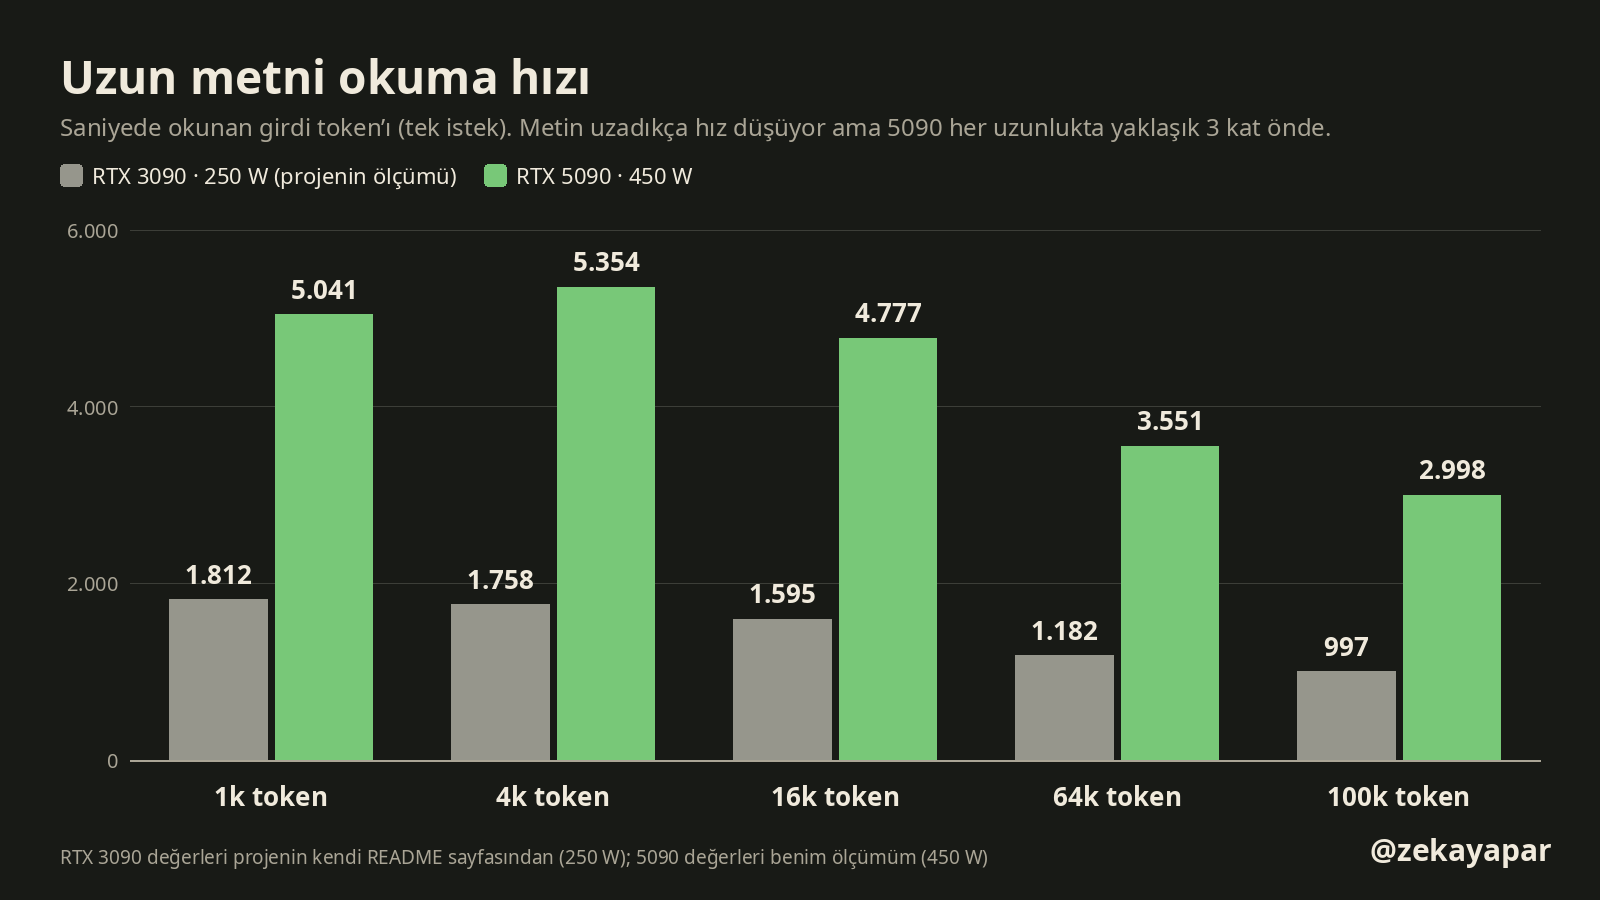
Uzun metin okumada fark daha da büyük: 1k token’lık metni 5090 saniyede 5.041 token hızla okudu, 3090’da 1.812. 100k token’da hız 2.998’e iniyor ama yine 3090’ın 3 katı.
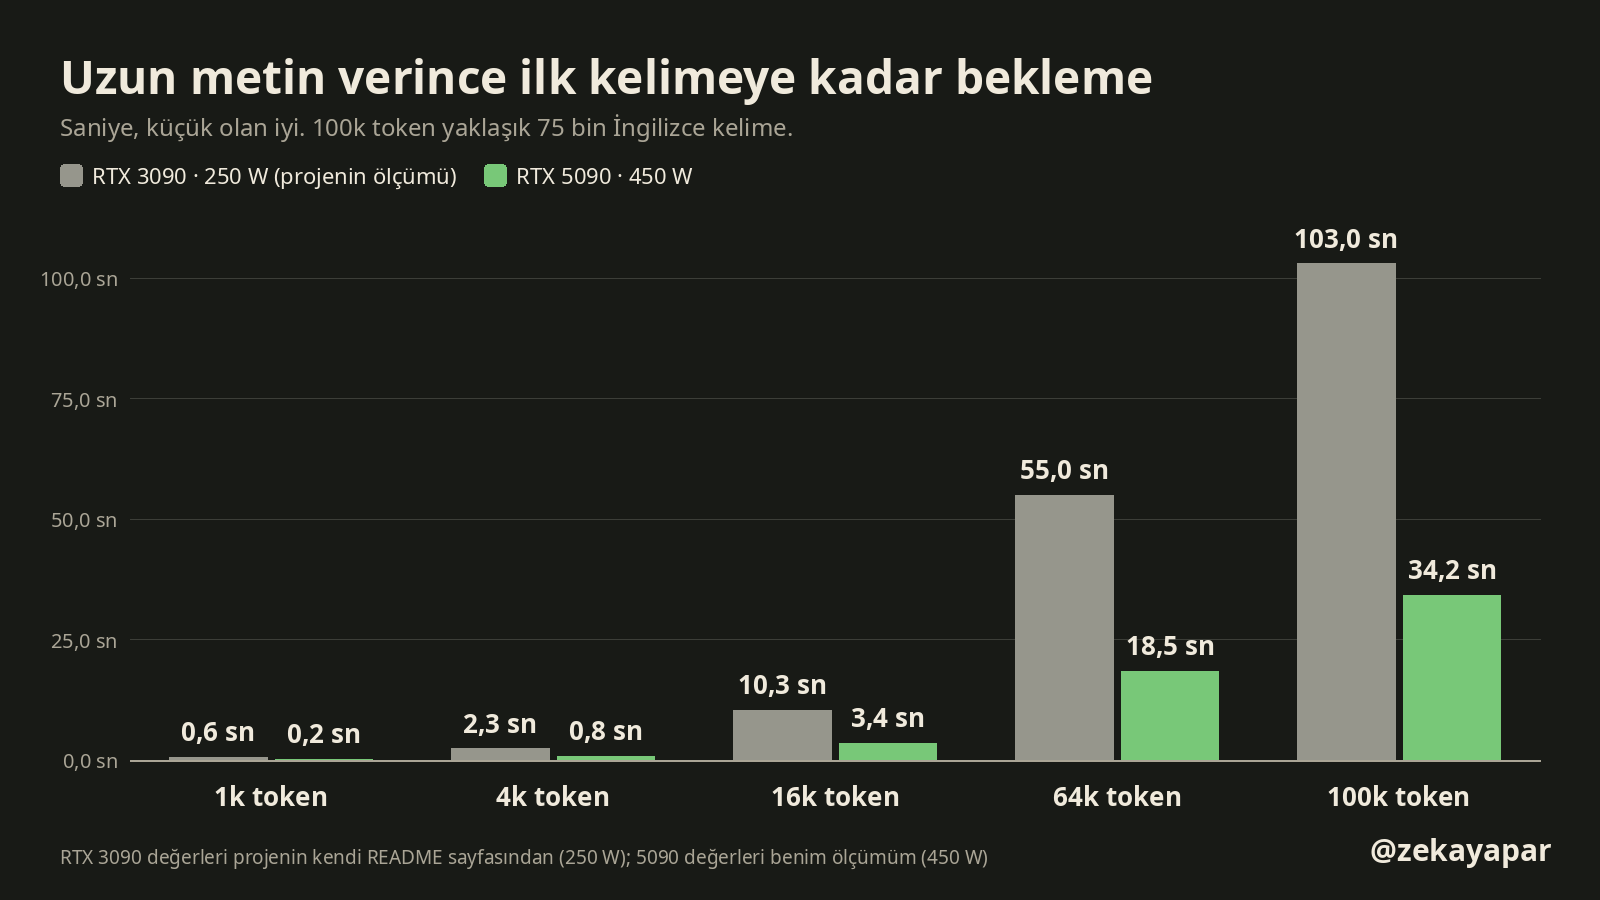
Bunu bekleme süresi olarak düşününce: 100k token’lık (yaklaşık 75 bin İngilizce kelime) bir metni verdiğimde ilk kelime 34,2 saniyede geliyor; 3090’da bu 103 saniye. Böyle uzun bir metinden sonra cevap saniyede yaklaşık 70 token hızla akıyor.
Türkçe sorunca ne oluyor?
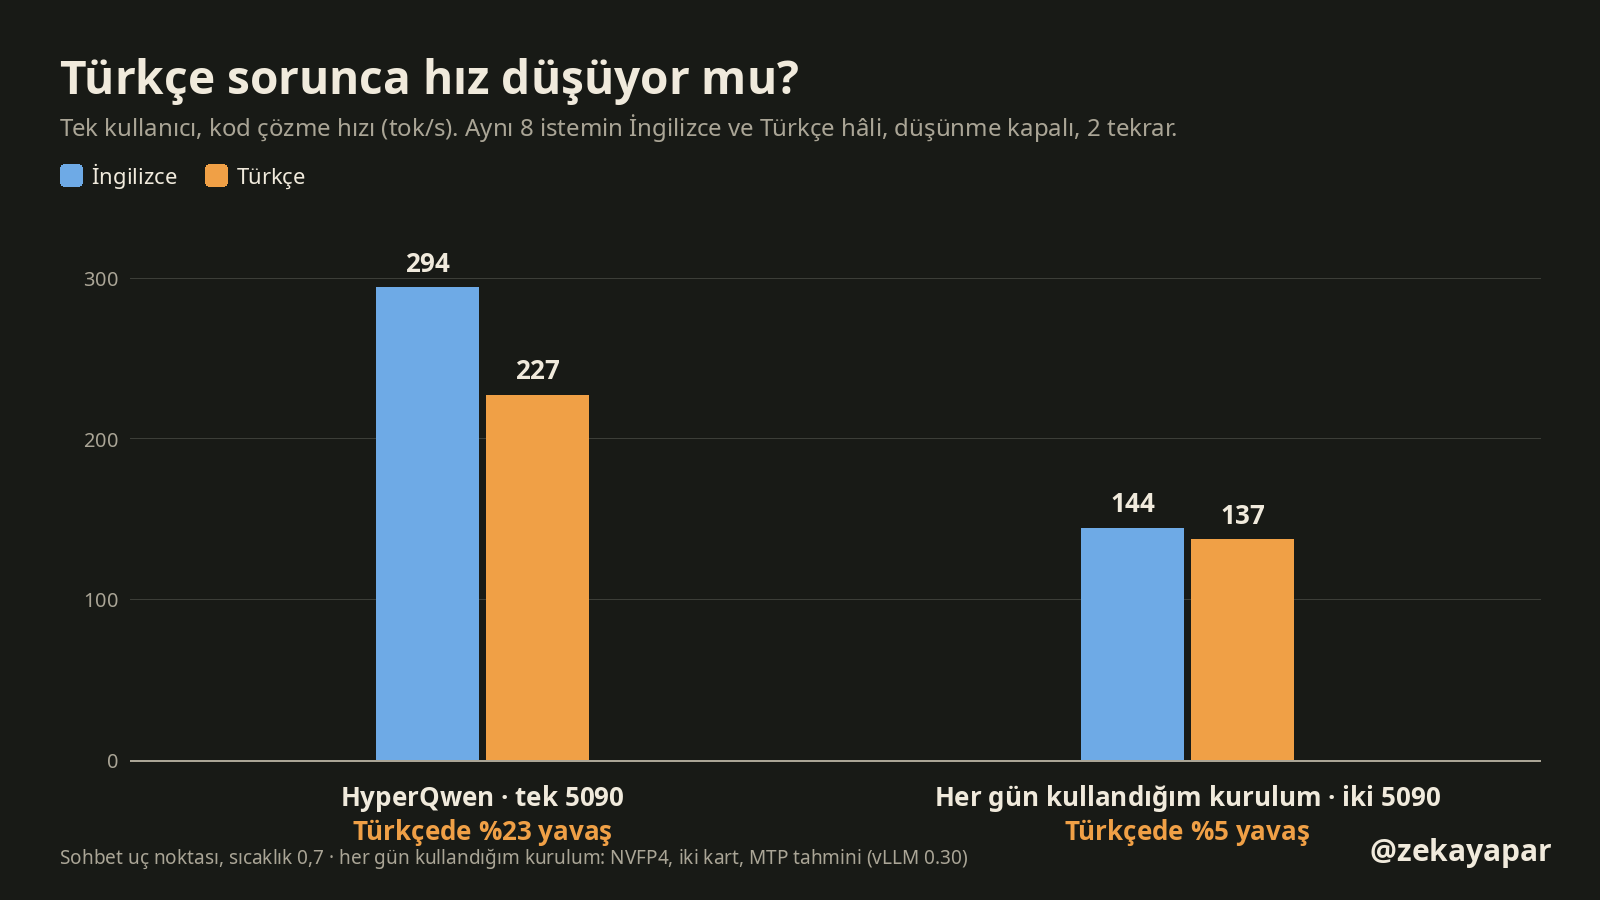
Asıl merak ettiğim buydu. Aynı 8 istemi İngilizce sorunca HyperQwen tek kullanıcıda saniyede 294 token yazdı, Türkçe sorunca 227: %23 daha yavaş. Her gün kullandığım kurulumda (aynı modelin NVFP4 sürümü, iki 5090, vLLM’in kendi MTP tahmini) fark 144’e karşı 137, yani yalnız %5.
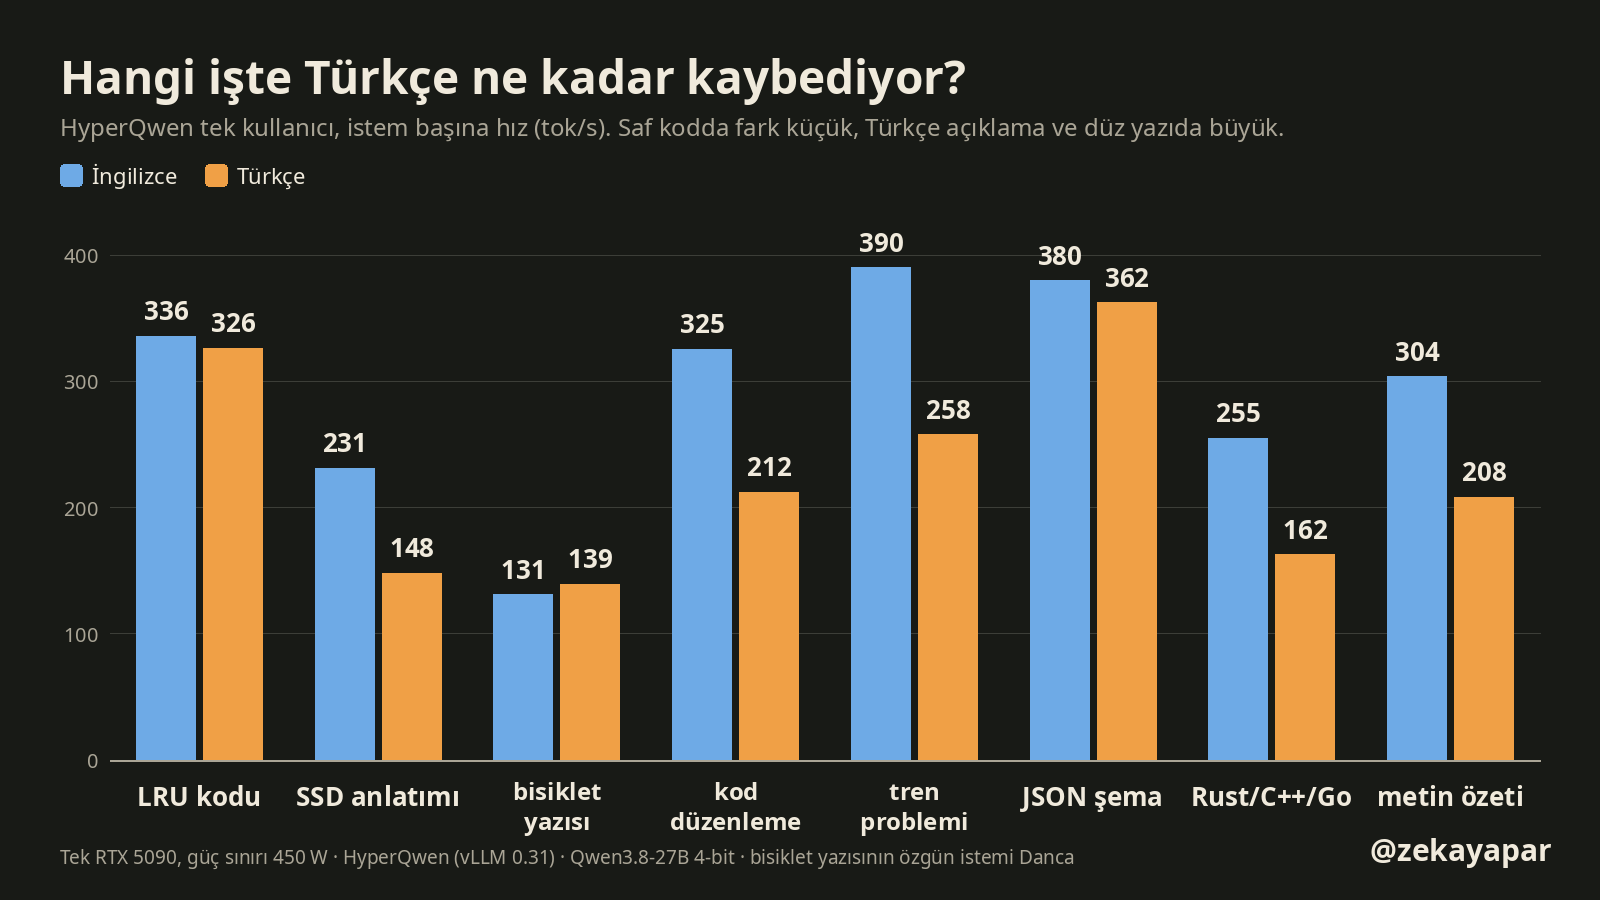
İstem istem bakınca fark işin türüne göre değişiyor. Saf kod üretiminde (LRU önbellek modülü 336’a 326, JSON şema 380’e 362) Türkçe neredeyse aynı hızda, çünkü cevap zaten İngilizce kod. Türkçe açıklama ağırlıklı işlerde düşüş büyük: SSD anlatımı 231’den 148’e, Rust/C++/Go yazısı 255’ten 162’ye indi. İlginç bir yan bulgu: bisiklet makalesinin özgün istemi Danca, yani “İngilizce” turda model Danca yazdı ve orada da hız 131’de kaldı; Türkçesi 139.
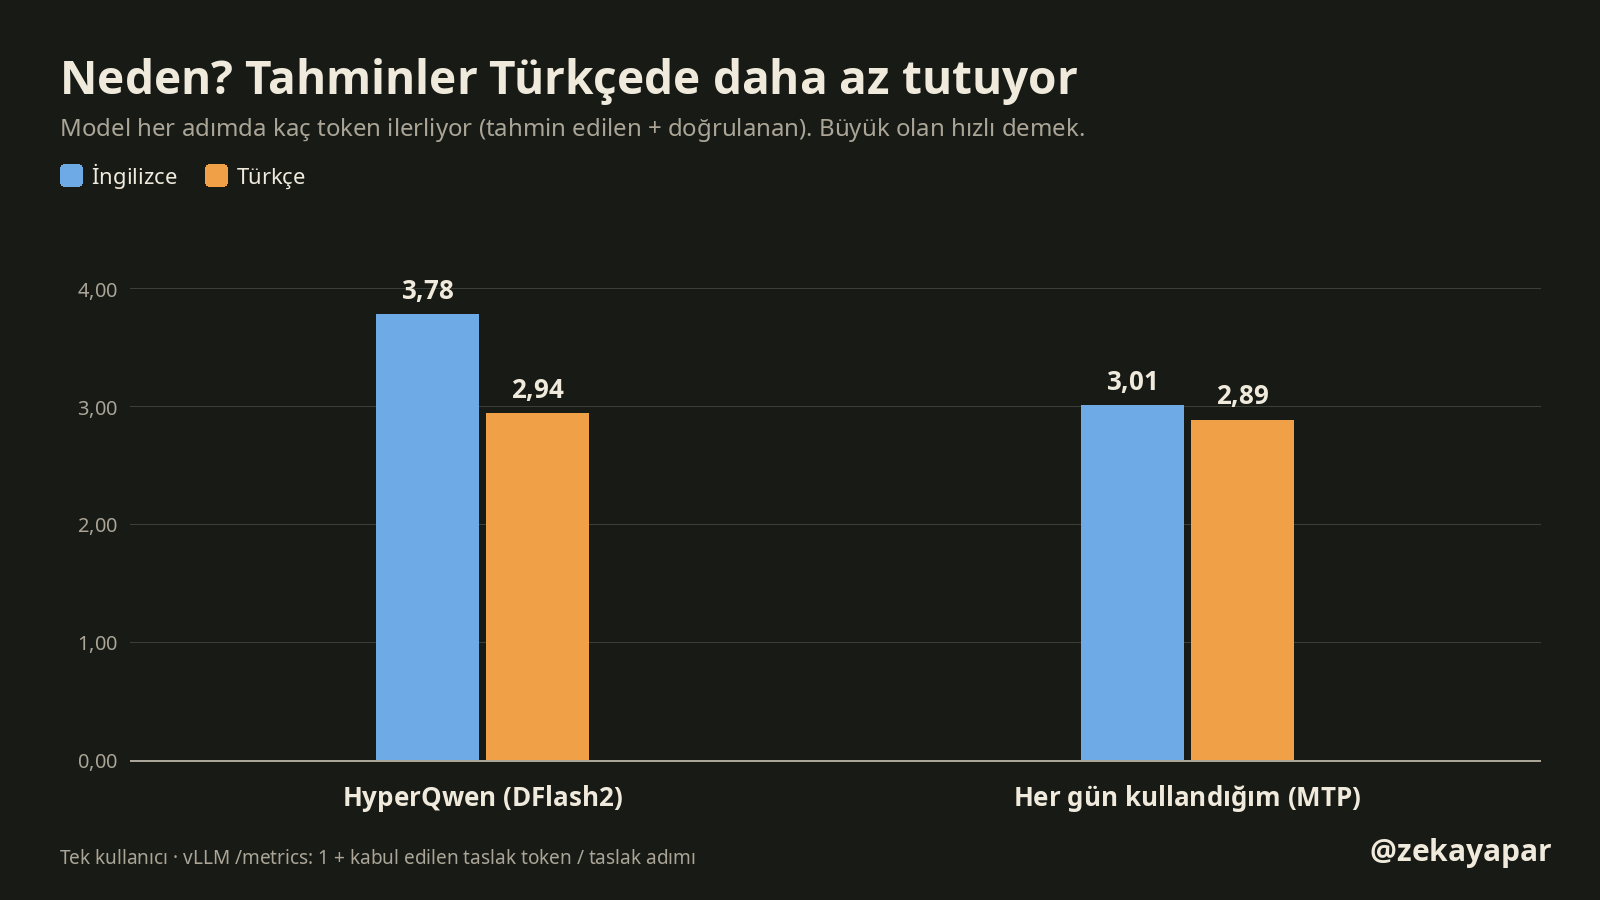
Nedeni tahminlerin tutma oranında görünüyor. İngilizcede HyperQwen her adımda ortalama 3,78 token ilerliyor, Türkçede 2,94. Taslak model Türkçede daha sık yanılıyor, büyük model de tahminleri daha sık reddediyor. Tahmin tarafındaki parçalar (DFlash2 taslak modeli, 40 bin token’lık taslak sözlüğü) proje için ayrıca hazırlanmış. Benim tahminim, bunların İngilizce ve kod ağırlıklı verilerle ayarlanmış olması; Danca’daki yavaşlık da bunu destekliyor. Bunu ayrıca test etmedim. vLLM’in MTP tahmininde fark çok küçük (3,01’e karşı 2,89).
Tek kart, iki kartlık kurulumumu geçiyor mu?
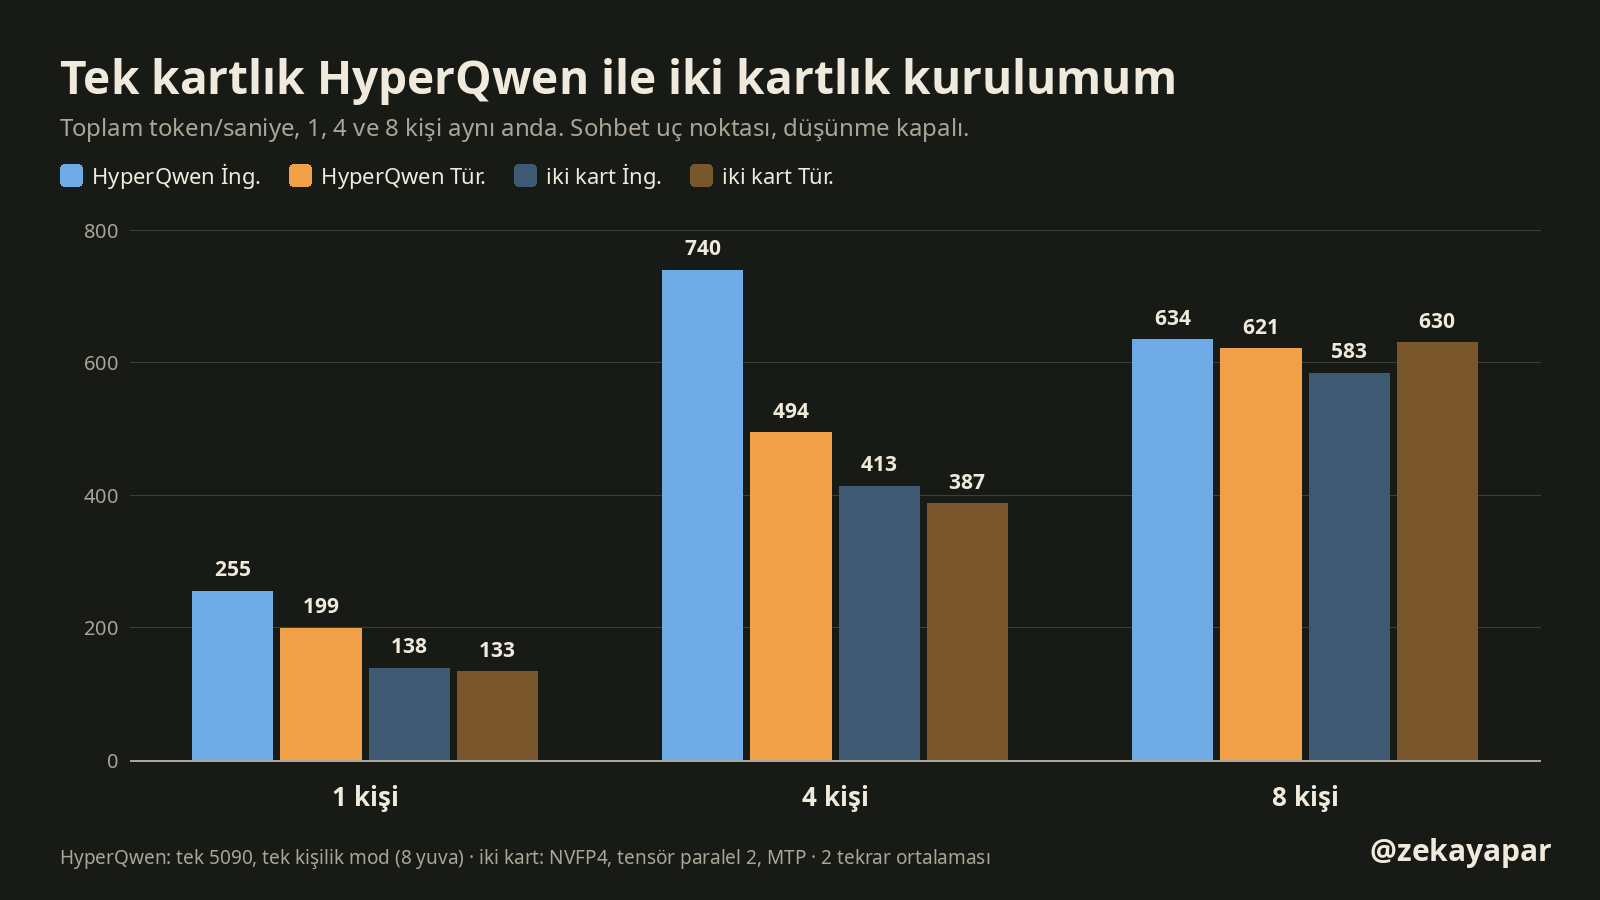
Tek kişide evet, açık ara: İngilizcede 255’e 138, Türkçede 199’a 133 (toplam süre üzerinden, ilk kelime beklemesi dahil). 4 kişide de HyperQwen önde (Türkçe 494’e 387). 8 kişide ise ikisi başa baş: Türkçe 621 ve 630. Benim kurulumum iki kart ve daha az sıkıştırılmış bir model (NVFP4) kullanıyor; HyperQwen aynı modelin 4-bit sürümünü tek kartta, yamalı bir vLLM’le çalıştırıyor. Yani kıyas “aynı model, farklı tercih” kıyası, birebir aynı ayar değil.
Elektrik ve doğruluk
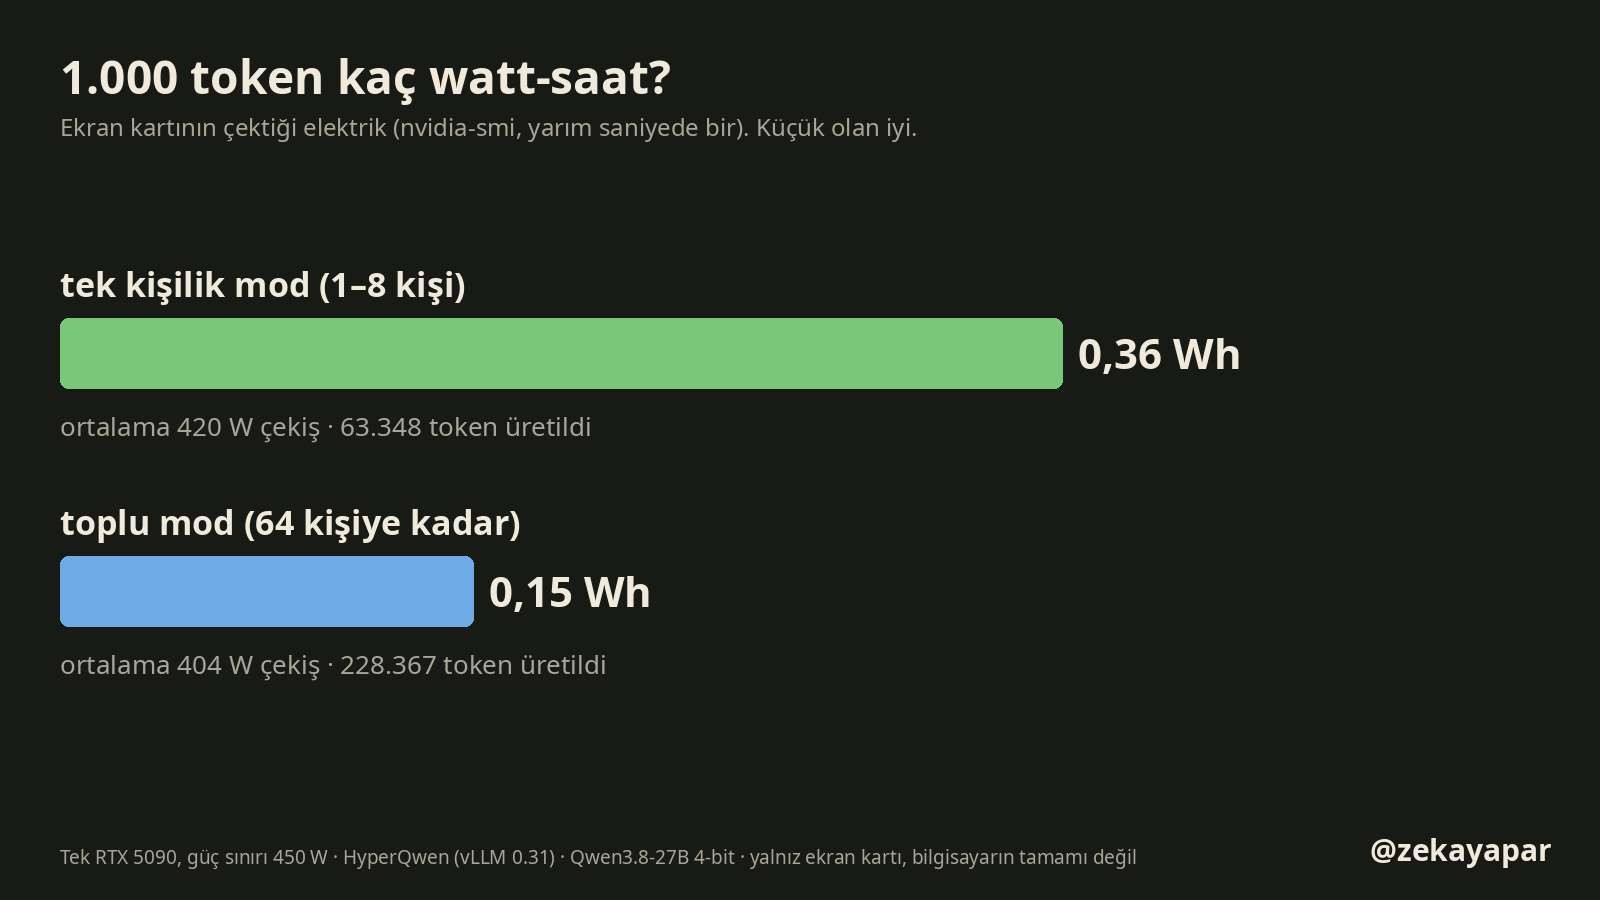
Kart yük altında ortalama 420 W çekti; 450 W sınırının üstüne yalnız anlık sıçramalarla çıktı. Tek kişilik modda 1.000 token 0,36 Wh, 64 kişilik toplu modda 0,15 Wh tuttu. Çok kişiye aynı anda hizmet ederken token başına elektrik iki kattan fazla düşüyor. Bu yalnız ekran kartının elektriği; bilgisayarın geri kalanı dahil değil.
Hız tek başına bir şey söylemiyor; bozuk cevap üreten hızlı bir sunucu işe yaramaz. GSM8K’dan 200 matematik sorusunda tek kişilik mod %95,0, toplu mod %94,5 doğru yaptı (düşünme kapalı, sıcaklık 0). Elle sorduğum Türkçe bir hesap sorusu ve küçük bir kod isteği de doğru geldi.
Kurarken takıldığım yerler
- Bilgisayarda Docker yok; projenin Docker’sız yolunu izledim. Sistem Python’u 3.14 ve geliştirme başlıkları eksik olduğu için ayrı bir Python 3.12 ortamı kurdum.
- İlk açılışta FlashInfer’in derleme adımı
-lcudartbulamadı: pip’le gelen CUDA 13 kütüphanesindelib64klasörü velibcudart.sobağlantısı yoktu. İki sembolik bağlantıyla düzeldi. - Tek kişilik modu ilk açtığımda betik, Docker ayar dosyasındaki varsayılanı (DFlash2) değil eski MTP yolunu seçti ve 199 token/sn ölçtüm. Docker’daki ayarı elle verince 225 oldu. Yazıdaki rakamlar ikincisi.
- İlk Türkçe/İngilizce denememde ölçüm betiği istemi sohbet şablonu olmadan gönderiyordu ve model cevabın başında uzun bir İngilizce “düşünme” yazıyordu. Türkçe hızı ölçmüş olmuyordum; sohbet uç noktasıyla, düşünme kapalı yeniden ölçtüm.
Benim için sonuç
Tek bir 5090’da 27B’lik bir modeli tek kişi için saniyede 225 token’la çalıştırmak, iki kartlık kurulumumun neredeyse iki katı hız demek. Kodlama ajanı gibi tek kişinin uzun cevap beklediği işler için iyi bir seçenek. Ama Türkçe metin yazdırırken avantajın bir kısmı gidiyor (%23) ve 8 kişiden sonra iki kurulum arasında fark kalmıyor. Ana servisimi şimdilik değiştirmiyorum; HyperQwen’i ikinci bir seçenek olarak tutacağım.
Sınırlar
- 3090 rakamları projenin kendi README sayfasından; iki kartı aynı bilgisayarda ölçmedim. Projenin sayılarının bir kısmı eski vLLM sürümünde alınmış.
- Kart ekranı da süren kart ve belleğin %84’ünü kullandı; tam belleği kullanan bir kartta toplu mod biraz daha fazla isteği aynı anda tutabilir.
- Türkçe istemleri bir yapay zekâ çevirdi; 8 istem ve 2 tekrar küçük bir örnek. Tekrarlar arasındaki fark tek kişide en çok %5,5, 8 kişide en çok %12,2.
- Türkçedeki yavaşlığın nedeni için tahmin kabul oranını ölçtüm; taslak sözlüğünün dil dağılımını ayrıca incelemedim.
- Elektrik yalnız ekran kartı için, duvardan ölçülmedi.
Tam tablo ve yöntem
Projenin betiğiyle (tamamlama uç noktası, 1.024 token cevap)
| Kişi | Tek kişilik, DFlash2 | Tek kişilik, MTP | Toplu mod | 3090 toplu (README) |
|---|---|---|---|---|
| 1 | 225 | 199 | 79 | 45 |
| 2 | 347 | 365 | 146 | 82 |
| 4 | 589 | 557 | 298 | 154 |
| 8 | 538 | 473 | 547 | 298 |
64 eşzamanlı, 128 girdi / 512 çıktı: kararlı 2.696 tok/s, uçtan uca 2.496 tok/s; 256/256: uçtan uca 1.832 tok/s.
Okuma (prefill), toplu mod
| Uzunluk | Eşzamanlı | Okuma (tok/s) | İlk kelime (sn) |
|---|---|---|---|
| 1k | 1 | 5.041 | 0,20 |
| 1k | 4 | 5.498 | 0,74 |
| 1k | 16 | 5.739 | 2,64 |
| 4k | 1 | 5.354 | 0,77 |
| 4k | 4 | 5.507 | 2,79 |
| 4k | 16 | 5.503 | 9,36 |
| 16k | 1 | 4.777 | 3,43 |
| 16k | 4 | 4.838 | 11,16 |
| 16k | 8 | 4.848 | 21,30 |
| 64k | 1 | 3.551 | 18,45 |
| 64k | 2 | 3.593 | 32,01 |
| 100k | 1 | 2.998 | 34,15 |
Sohbet uç noktası, düşünme kapalı, sıcaklık 0,7 (2 tekrar ortalaması)
| Kurulum | Dil | Kişi | Toplam (tok/s) | Kişi başı yazma (tok/s) | Token/adım | İlk kelime (sn) |
|---|---|---|---|---|---|---|
| HyperQwen (tek 5090) | EN | 1 | 255 | 294 | 3,78 | 0,07 |
| HyperQwen (tek 5090) | EN | 4 | 740 | 238 | 3,87 | 0,13 |
| HyperQwen (tek 5090) | EN | 8 | 634 | 158 | 3,75 | 0,93 |
| HyperQwen (tek 5090) | TR | 1 | 199 | 227 | 2,94 | 0,08 |
| HyperQwen (tek 5090) | TR | 4 | 494 | 177 | 2,83 | 0,14 |
| HyperQwen (tek 5090) | TR | 8 | 621 | 124 | 2,96 | 0,98 |
| NVFP4 (iki 5090) | EN | 1 | 138 | 144 | 3,01 | 0,09 |
| NVFP4 (iki 5090) | EN | 4 | 413 | 121 | 2,98 | 0,16 |
| NVFP4 (iki 5090) | EN | 8 | 583 | 106 | 3,00 | 0,27 |
| NVFP4 (iki 5090) | TR | 1 | 133 | 137 | 2,89 | 0,09 |
| NVFP4 (iki 5090) | TR | 4 | 387 | 116 | 2,89 | 0,18 |
| NVFP4 (iki 5090) | TR | 8 | 630 | 100 | 2,88 | 0,34 |
Donanım ve yazılım: RTX 5090 (32 GB), sürücü 595.99, güç sınırı 450 W, Ubuntu (çekirdek 7.0). HyperQwen @ce9615c (21 Ekim 2026), vLLM 0.31.0 + 52 yama, Python 3.12. Model: dbirks/Qwen3.8-27B-W4A16-AutoRound + projenin lm_head/gömme/MTP yeniden sıkıştırması, DFlash2 taslak modeli. Ayarlar: GPU_UTIL=0.84; tek kişilik mod SPEC=dflash2 PREFIX_CACHE=1 (Docker ayar dosyasının varsayılanı); toplu mod varsayılan (64 yuva, int8 MLP aktivasyonları).
Kıyas kurulumu: nvidia/Qwen3.8-27B-NVFP4, vLLM 0.30, iki RTX 5090 tensör paralel, MTP 3 token, BF16 KV önbelleği. Ölçüm sırasında bu servise başka istek gelmiyordu (vLLM metrikleri, öncesi ve sonrası).
3090 rakamları: github.com/syv-ai/HyperQwen README.md ve batch/README.md (RTX 3090, 250 W).
İndir: betikler, istemler ve ham sonuçlar (ZIP) · özet (JSON).