 zekayapar
Türkçe belge aramada sorgunun başına ne yazdım?
Qwen3-Embedding ile sorgu talimatını ve metinleri toplu işlemenin hızını denedim.
Model ve yerleşim
- Qwen3-Embedding-0.6B
- RTX 5090 · kart başına 32 GB
- Threadripper PRO 5955WX
- Embedding: GPU2
Yazılım ortamı
- vLLM 0.30.0
- PyTorch 2.13.0+cu132
- FlashInfer 0.6.18.post1
- Transformers 5.18.0
- Doğrudan localhost HTTP
Türkçe bir soru için ilgili belgeyi bulmayı denedim. 50 sentetik belge ve 20 soru hazırladım; ilgili belgeleri ölçümden önce belirledim. Aynı soruyu embedding modeline hem tek başına hem de başına İngilizce bir görev açıklaması ekleyerek gönderdim.
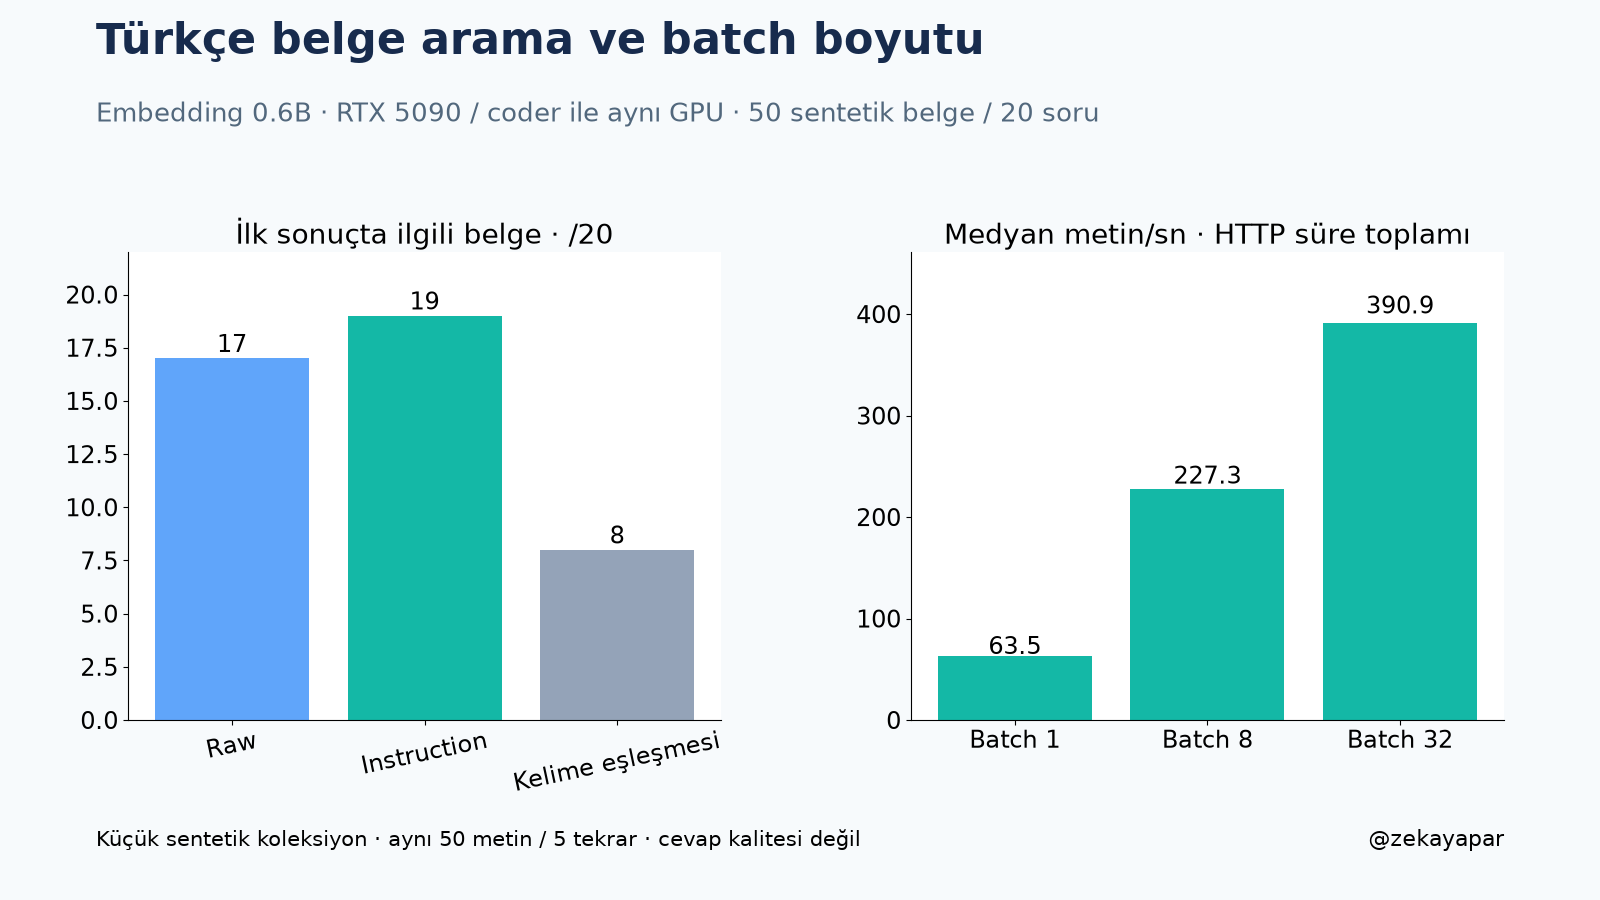
| Yöntem | İlk sırada doğru | İlk 5 içinde doğru | MRR |
|---|---|---|---|
| Yalnız soru | 17/20 | 19/20 | 0,8863 |
| Görev açıklaması + soru | 19/20 | 20/20 | 0,9600 |
| Kelime kesişimi | 8/20 | 14/20 | 0,5057 |
Sorguya görev açıklaması eklemek
1024 boyutlu vektörleri L2 ile normalize edip kosinüs benzerliğiyle sıraladım. Görev açıklaması eklediğimde doğru belgeyi ilk sırada bulma 17’den 19’a çıktı. MRR, ilgili ilk sonucun sırasını özetliyor; 1’e yaklaştıkça ilgili belge daha üstte.
Karşılaştırma için basit kelime kümesi kesişimi kullandım. Bu BM25 değil. Veri kümesi küçük ve kolay: 10 konu var, her sorunun iki ilgili belgesi aynı konuyu benzer biçimde anlatıyor. Gerçek şirket belgelerinde aynı başarıyı ölçmüş değilim; getirilen belgelerden cevap üretimini de test etmedim.
Metinleri birlikte göndermek
| Batch | Medyan metin/sn | Tekrar |
|---|---|---|
| 1 | 63,45 | 5 |
| 8 | 227,30 | 5 |
| 32 | 390,86 | 5 |
Aynı 50 metni her batch koşulunda beş kez işledim. Batch 8’de son istek iki metin, batch 32’de son istek 18 metin içeriyordu. Metin/sn değeri, 50 metnin HTTP süreleri toplamından hesaplandı; çağrılar arasındaki beklemeler ve istemci kontrolleri hariç. Kişi başına arama hızı veya HTTPS kapasitesi değil.
Değerlendirme betiğinde ilk matris çarpımında transpoz eksikti. Süreci durdurup hesabı düzelttim; daha önce üretilen vektörleri yeniden değerlendirdim. Sonuç almak için veri kümesini veya model yanıtlarını değiştirmedim.
Çalışan düzen
13 Ekim 2026 ölçümleri. Qwen3.8-27B NVFP4 iki RTX 5090 üzerinde TP2/MTP3 ile; Qwen2.5-Coder-7B AWQ ve Qwen3-Embedding-0.6B üçüncü RTX 5090 üzerinde birlikte çalışıyordu. Threadripper PRO 5955WX; kart başına 32 GB VRAM. vLLM 0.30.0, PyTorch 2.13.0+cu132, FlashInfer 0.6.18.post1 ve Transformers 5.18.0.
Servisleri veya model yerleşimini değiştirmedim. Doğrudan localhost HTTP üzerinden, tek aktif benchmark isteğiyle ölçtüm; gateway, HTTPS ve internet gecikmesi bu sayılara dahil değil. Her çağrı öncesinde backend kuyruğunu kontrol ettim, fakat sonradan başka trafik gelmesini engellemedim. Bunlar kısa deneyler; çoklu kullanıcı kapasitesi veya kesintisiz çalışma garantisi çıkarmıyorum.
Ayrıntılı sonuç raporu ↗ · Önceden sabitlenen yöntem ↗ · Değerlendirme sınırları ↗. Bu bağlantılar ölçüm raporlarının yayımlanan kopyaları; ham istek ve yanıt arşivi bu sayfada bulunmuyor.
Aynı geceki MTP açık/kapalı testi ↗ · Diğer benchmark yazıları