 zekayapar
Türkçe modelimi nöron diline çevirdim: yapay zekâ beyinde çalışabilir mi?
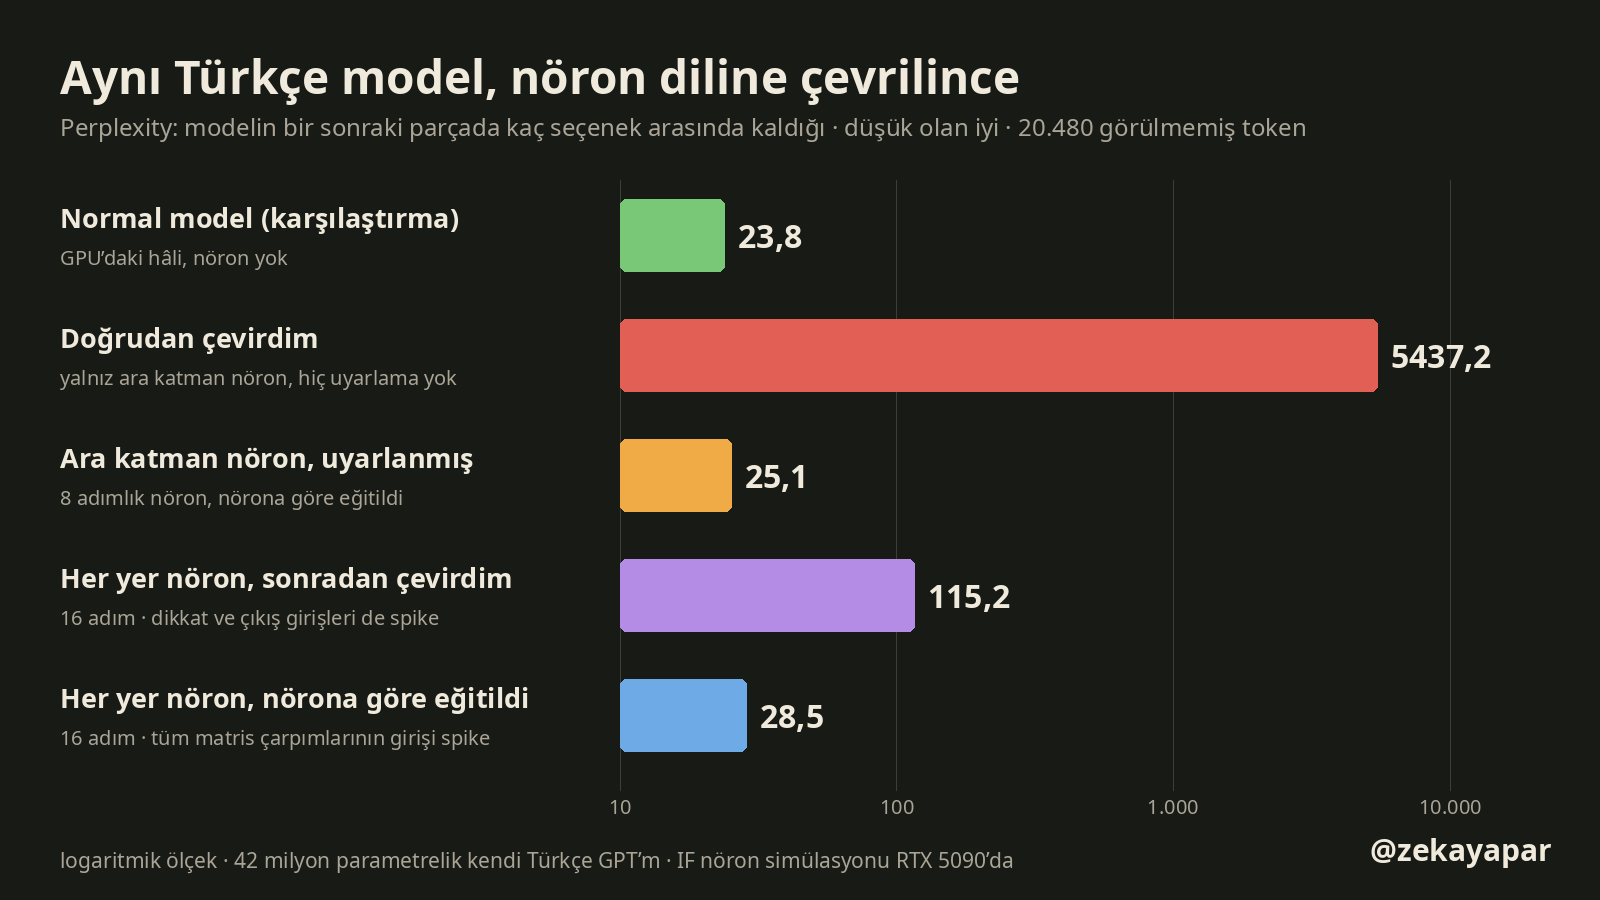
42M parametrelik Türkçe GPT’mi spike atan sanal nöronlarla çalıştırdım: doğrudan çevirince çöktü, nörona göre eğitince perplexity 23,8’ten 28,5’e çıktı.
Model
- Kendi Türkçe GPT’m · 42,2M parametre, 8 katman · 32k Türkçe sözlük
- Wikipedia 20231101 Türkçe · görülmemiş 20.480 token üzerinde ölçüm
- Ek eğitimler: 15’er dakika · PyTorch 2.14.1 · bfloat16
Nöron simülasyonu
- Integrate-and-fire nöron · T = 1…64 adım · spike sayısıyla kodlama
- Token başına 41.984 sanal nöron · işaretli sinyal için artı/eksi grup
- Tek RTX 5090 (450 W) · diğer servislerin yanında boş bellekte
Masamda çalışan modeller ekran kartında koşuyor; kartlar da anakarta riser kablosuyla bağlı. Beyin-bilgisayar arayüzleri bugün aynı mantıkla çalışıyor: beyne takılan çip sinyali okuyor, asıl model dışarıdaki bilgisayarda çalışıyor. Benim merak ettiğim bir adım ötesiydi: model beynin kendi nöronlarının üstünde çalışabilir mi? Nöronların da bir işlem kapasitesi var, sonuçta.
Kısa cevap: bugün hiçbir yerde böyle bir şey yok. Ama yolun bir parçası bilgisayarda denenebiliyor. Önceki yazıda sıfırdan eğittiğim 42 milyon parametrelik Türkçe modeli, spike atan sanal nöronlarla çalışacak hâle getirdim. Matris çarpımlarının yaklaşık %95’i artık sayılarla değil spike sayılarıyla yapılıyor. Modelin tahmin zorluğu (perplexity) 23,8’ten 28,5’e çıktı; yani biraz kötüleşti ama Türkçe yazmayı sürdürdü. Doğrudan, hiç uyarlamadan çevirdiğimde ise 5.437’e fırladı ve anlamsız harf dizileri üretti.
Deneyi ve arka planını 9 dakikalık bir videoda da anlattım:
Bugün beyinle çalışan yapay zekâ nerede duruyor?
Önce internette ne yapıldığına baktım. Beyin-bilgisayar arayüzlerinin hepsinde model beynin dışında çalışıyor:
- Stanford’da felçli hastaların “içinden söylediği” kelimeler motor korteksten çözüldü; mahremiyet için parolayla açılan bir çözücü fikri de çalışmanın içinde (Cell, Ağustos 2025).
- UCSF ve Berkeley ekibi, 18 yıl önce felç geçiren Ann Johnson’ın beyin sinyalinden kendi sesine yakın bir ses ve konuşan bir avatar üretti (Berkeley).
- Synchron, implant kullanıcılarına ChatGPT ile cevap önerisi sundu (Temmuz 2024). Neuralink kullanan ALS hastası Bradford Smith’e Grok cevap taslağı yazıyor; MIT Technology Review burada “konuşan kim?” sorusunu soruyor (MIT TR).
Model neden içeride değil? Beyne takılan çip dokuyu 1–2 °C’den fazla ısıtmamalı (Columbia, MICRO 2025); bu yüzden çip sinyali toplayıp sıkıştırıyor, gerisini dışarı yolluyor. Benim kartlarımın her biri 450 W’ta çalışıyor; bu ikisini aynı yere koymak mümkün değil.
Ters yön, yani dışarıdaki modelin beyne bilgi yazması da kısmen denenmiş. Hampson ve ekibi epilepsi hastalarında hipokampus sinyalinden bir model kurdu, modelin ürettiği “bellek kodunu” elektrikle geri yazdı ve kısa süreli bellekte %37, akılda tutmada %35 iyileşme ölçtü. Rastgele uyarım ise işe yaramadı; yani fark yazılan bilginin kendisinden geliyordu (J Neural Eng 2018).
Modelin nöronların kendisinde çalışmasına giden yolu beş basamak olarak düşündüm. Her basamakta gerçek bir çalışma var, sonuncusu hariç:
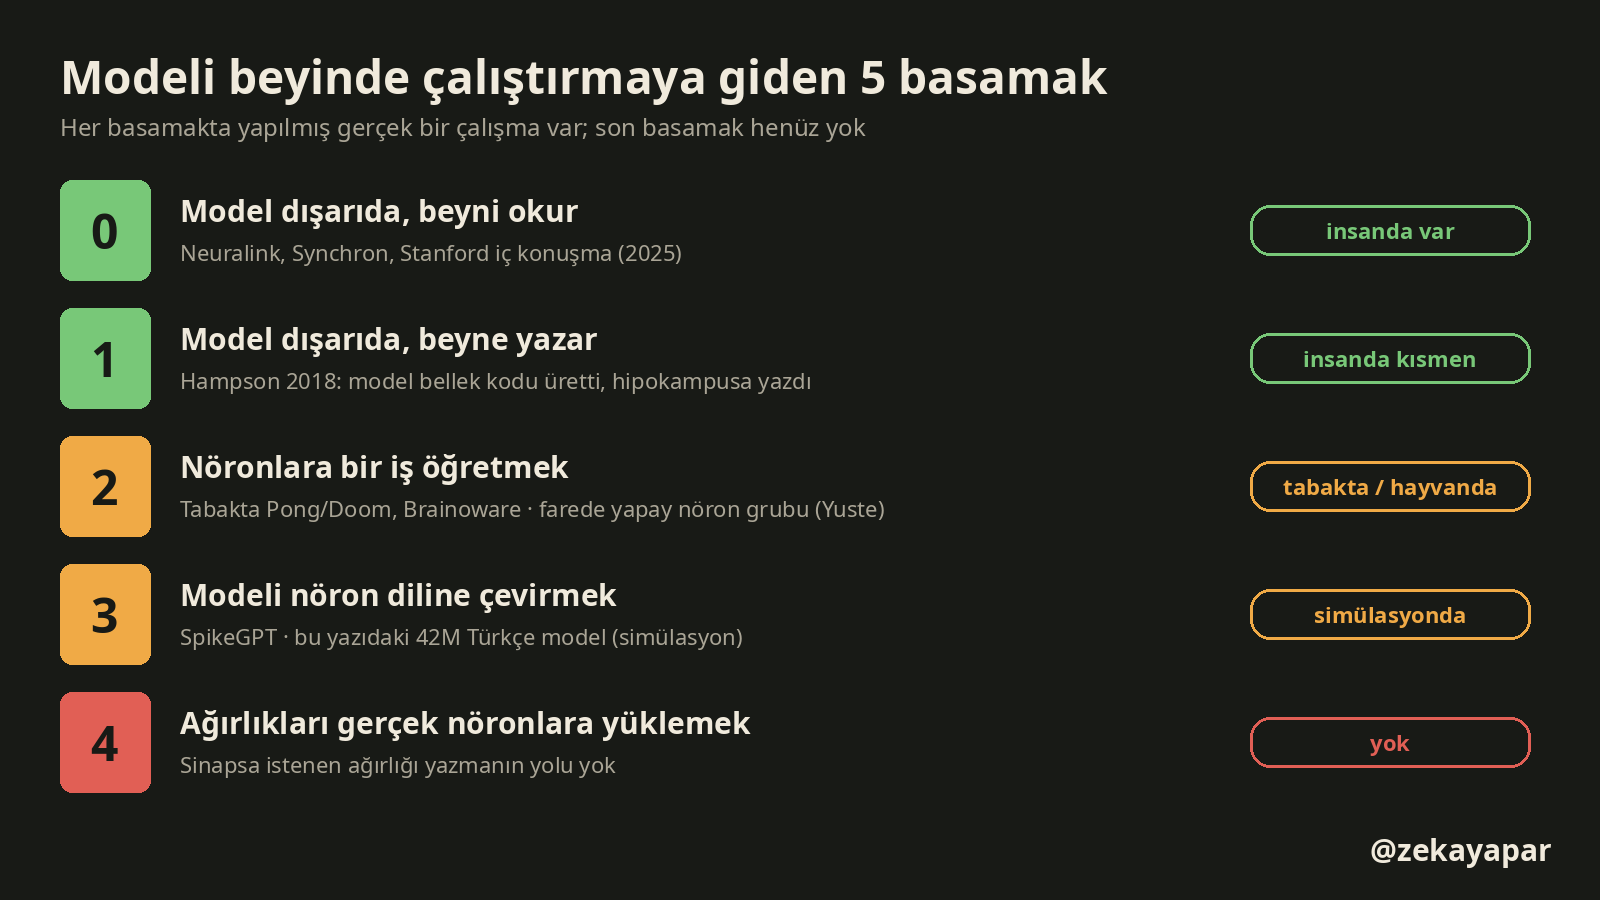
2. basamak tabakta büyütülen nöronlar: Cortical Labs’ın yaklaşık 800 bin nöronu Pong oynamayı öğrendi (Neuron, 2022), 2026’da yaklaşık 200 bin insan nöronu Doom’da düşmana nişan almaya başladı (The Register). Canlı farede de Yuste ekibi ışıkla birkaç nöronu birlikte uyararak yapay bir nöron grubu oluşturdu ve bu grubu tetikleyerek farenin davranışını yönlendirdi (Carrillo-Reid ve ark., Cell 2019). Bu yazıdaki deney 3. basamakta duruyor.
Bir nöron sayıyı nasıl taşır?
Dil modelinin içindeki her birim bir sayı üretir, sonraki katman bu sayılarla çarpma yapar. Nöronun elinde ise sayı yok, yalnız “spike” var: zarı dolar, eşiği geçince kısa bir elektrik atımı yollar ve boşalır. Ben en basit nöron modelini kullandım (integrate-and-fire, yani “topla ve ateşle”). Modeldeki sayı nörona sabit bir akım olarak veriliyor, nöron T adım boyunca bu akımı topluyor ve attığı spike sayısı o sayıyı temsil ediyor. Grafikte modelin 4. katmanından alınmış üç gerçek akım var: 1,44 akım 16 adımda 11 spike, 0,12 akım yalnız 1 spike attırıyor.
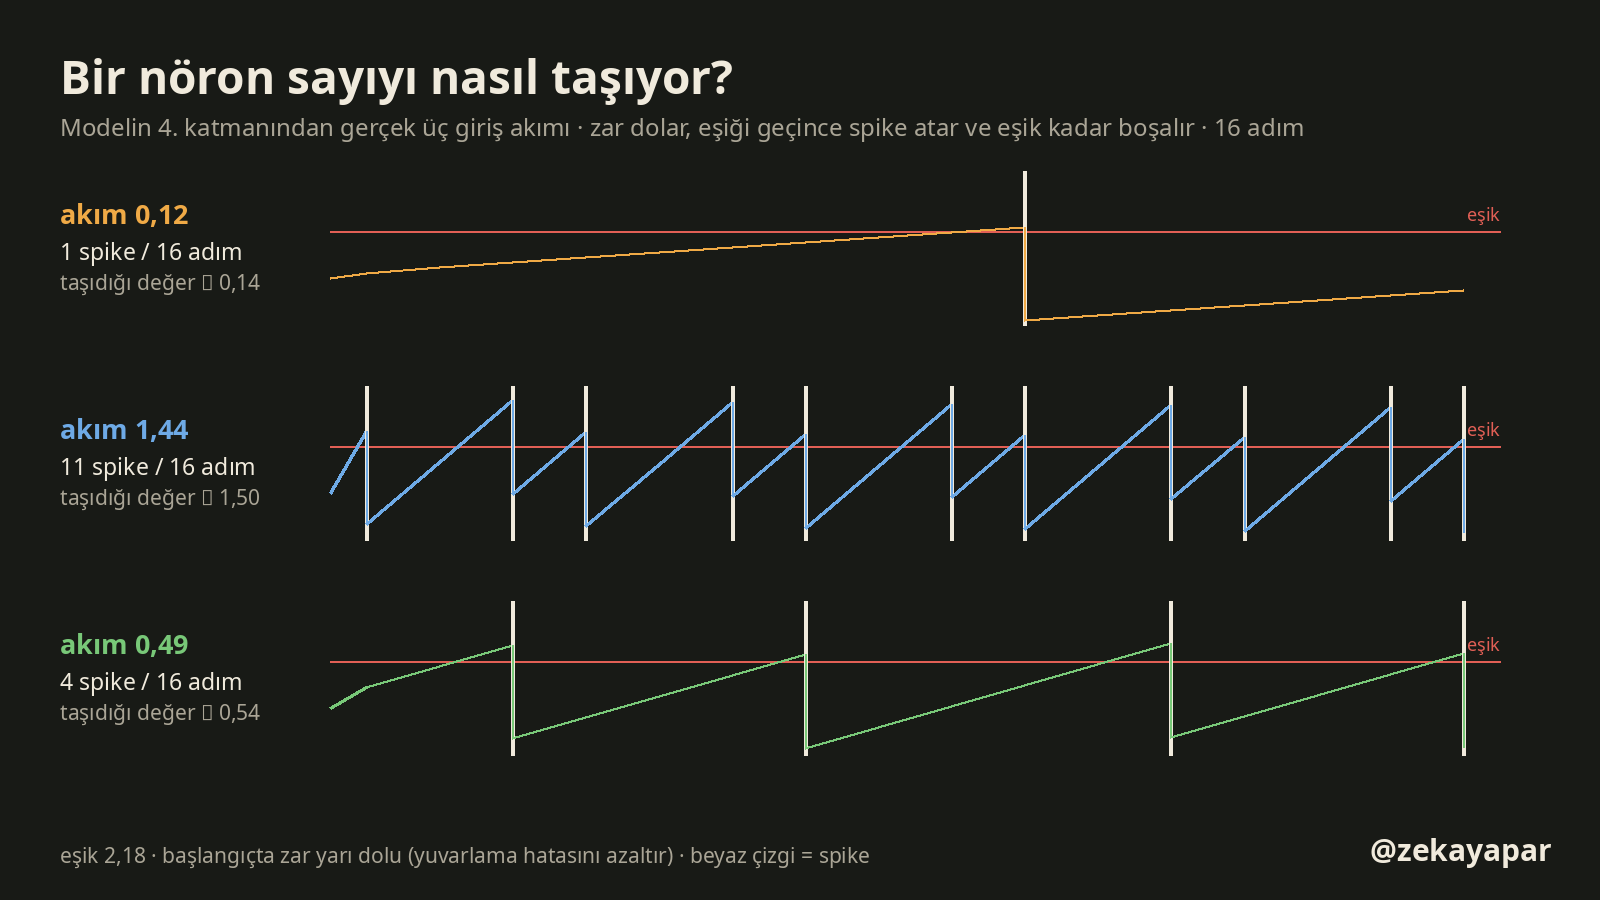
Bunun iki sonucu var. Nöron negatif sayı taşıyamıyor, bu yüzden işaretli sinyaller için artı ve eksi taraf iki ayrı nöron grubuyla taşınıyor. Bir de T adımda en çok T spike atılabildiği için her değer T basamağa yuvarlanmış oluyor; çok büyük değerler de bir eşikte kesiliyor.
Nasıl denedim?
Model, sıfırdan Türkçe GPT eğittiğim yazıdaki 42,2 milyon parametrelik, 8 katmanlı model. Üç yol denedim:
- Doğrudan çevirmek: hiçbir şeyi değiştirmeden ara katmandaki (FFN) birimleri nörona çevirdim.
- Ara katmanı nörona göre uyarlamak: modele 15 dakika ek eğitim verdim; bu sırada ara katman çıktıları nöronun üretebileceği gibi sıfırın altına inemedi, 8 basamağa yuvarlandı ve kesme eşiğini model kendisi öğrendi.
- Her yeri nörona göre eğitmek: bunun üstüne 15 dakika daha eğittim; bu kez dikkat katmanına, ara katmana ve son katmana giren bütün sinyaller 16 basamaklı, işaretli nöron çıktısına yuvarlandı.
Adil olsun diye karşılaştırma modeline de aynı 15 dakikalık ek eğitimi verdim (nöron kısıtı olmadan). Hepsini modelin hiç görmediği 20.480 parçalık Türkçe Wikipedia metninde ölçtüm. Simülasyonu RTX 5090’da, diğer servislerin yanındaki boş bellekte çalıştırdım. Gerçek nöron yok; bu bir bilgisayar simülasyonu.
Sonuç: nörona göre eğitince çalışıyor
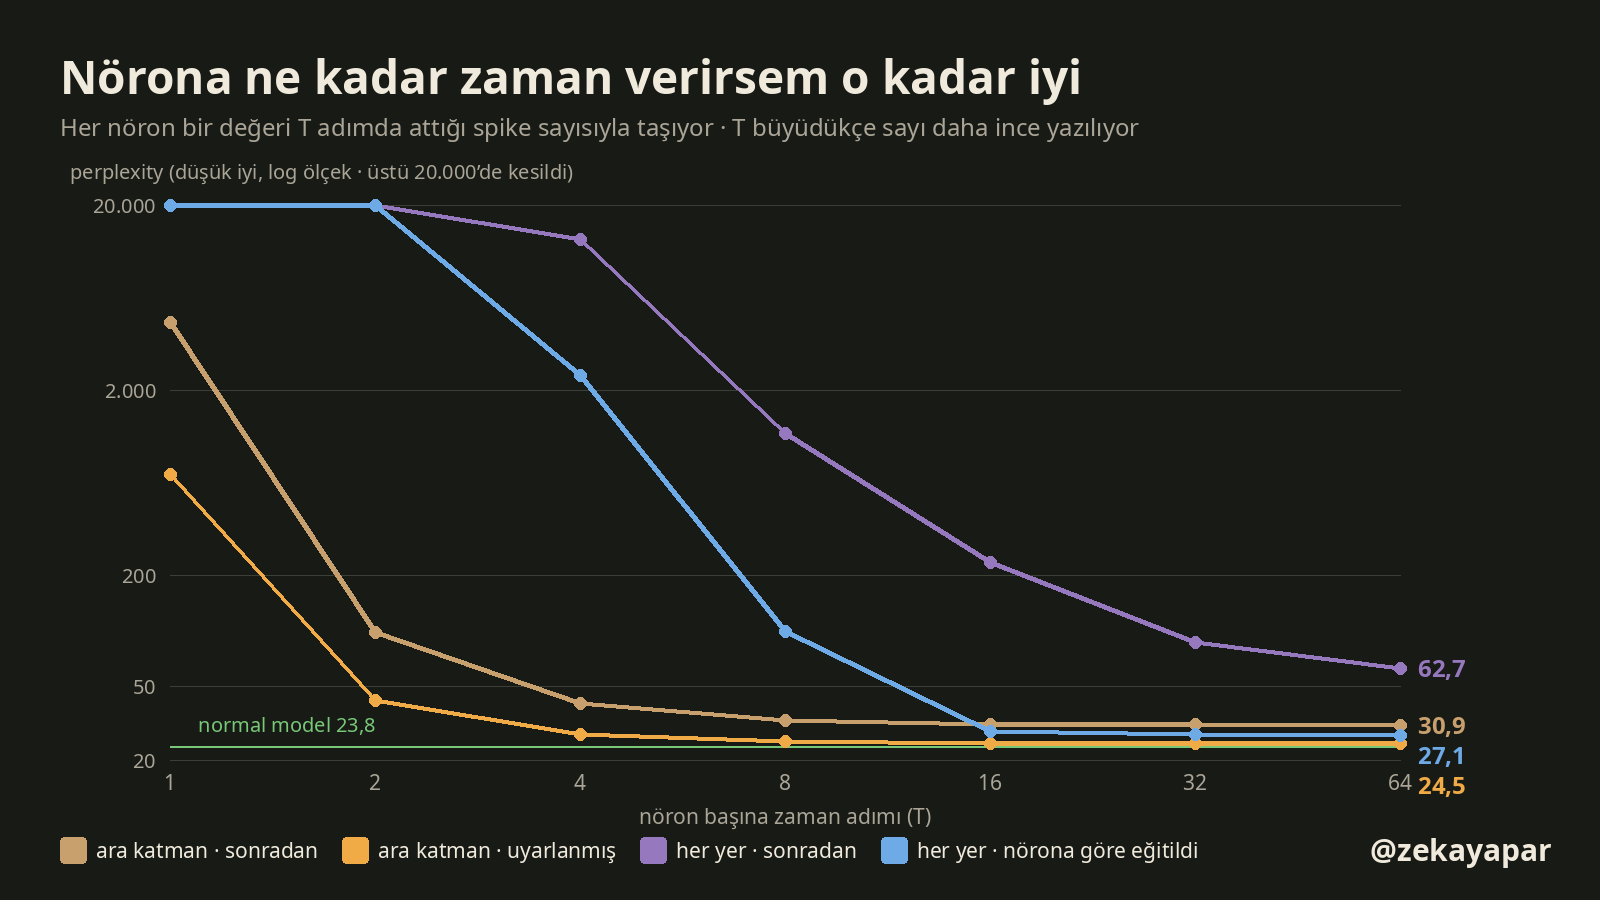
Ara katmanı nörona göre eğittiğim modelde 8 adım yeterli oldu: 25,1, nöronsuz hâliyle aynı (25,1). Bu beklenen bir eşitlik; çünkü eğitimde zaten 8 basamağa yuvarlıyordum. Ayrı bir kontrolle de doğruladım: bütün model için spike simülasyonu ile “değeri T basamağa yuvarla” hesabı aynı sonucu verdi (T=16’da 3,3495 ve 3,3512 kayıp). Yani sabit akımla, spike sayısıyla kodlama aslında bir yuvarlama işlemi.
Her yeri nöron yapınca iş zorlaşıyor. Sonradan çevirdiğim modelde 16 adımda perplexity 115,2; nörona göre eğittiğimde 28,5. 64 adıma çıkınca 27,1’e iniyor. 4 adım ise (2401,2) okunabilir metin için yetmiyor.
Aynı başlangıç cümlesiyle, aynı rastgelelik tohumuyla ürettirdiğim metinler (değiştirmeden):
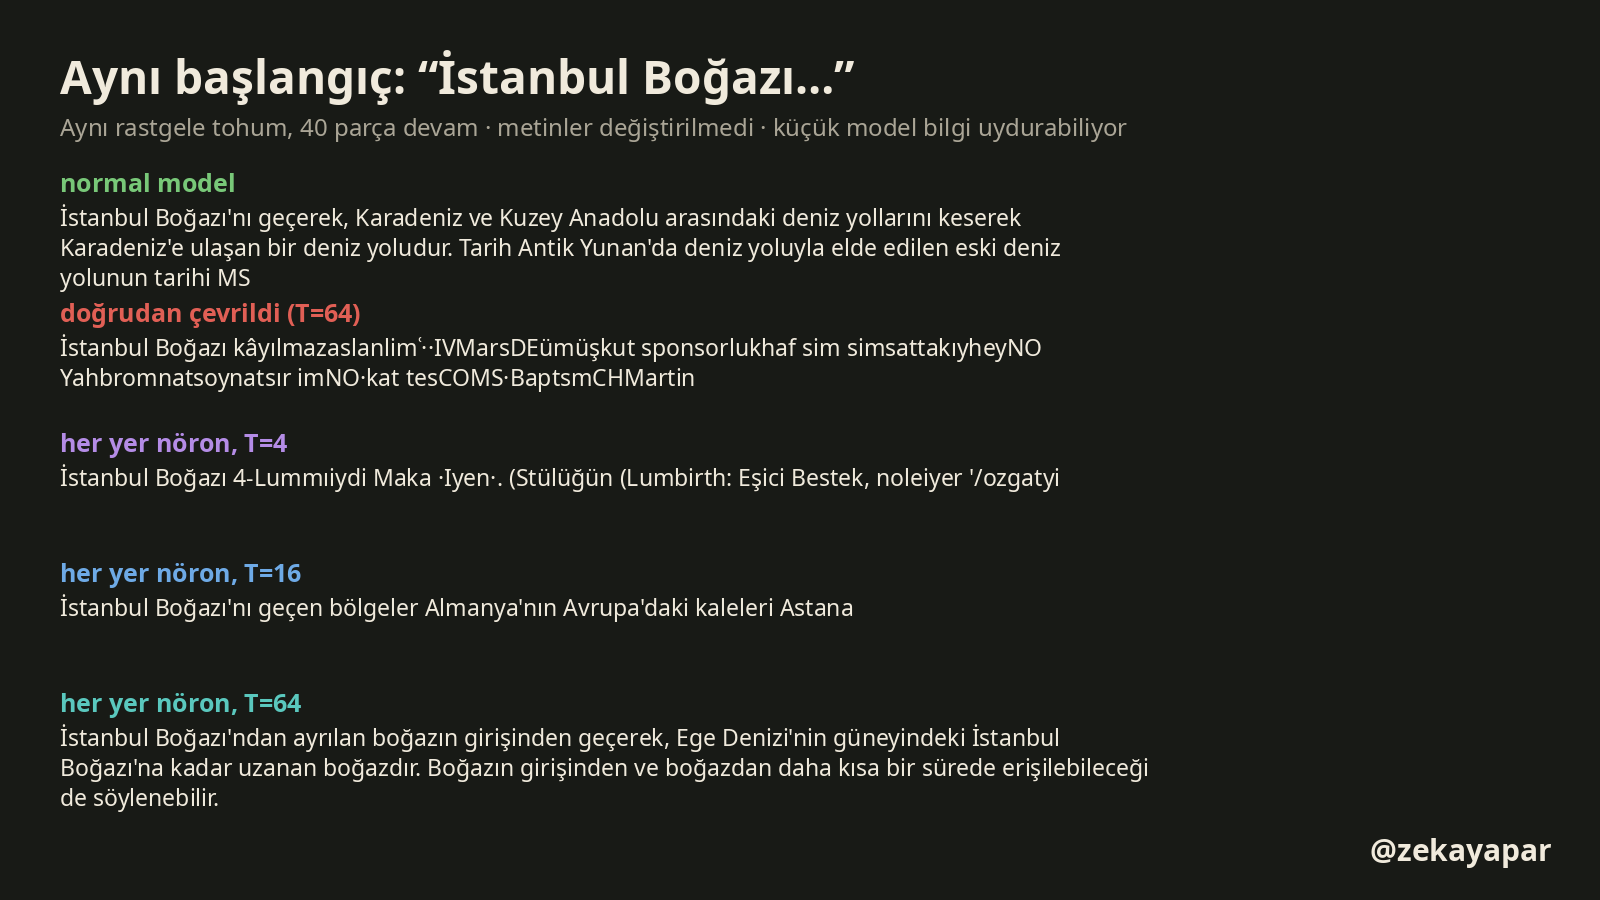
| Model | “İstanbul Boğazı…” devamı |
|---|---|
| Normal model | İstanbul Boğazı'nı geçerek, Karadeniz ve Kuzey Anadolu arasındaki deniz yollarını keserek Karadeniz'e ulaşan bir deniz yoludur. Tarih Antik Yunan'da deniz yoluyla elde edilen eski deniz yolunun tarihi MS |
| Doğrudan çevrildi (T=64) | İstanbul Boğazı kâyılmazaslanlimʿ··IVMarsDEümüşkut sponsorlukhaf sim simsattakıyheyNO Yahbromnatsoynatsır imNO·kat tesCOMS·BaptsmCHMartin |
| Her yer nöron, T=4 | İstanbul Boğazı 4-Lummıiydi Maka ·Iyen·. (Stülüğün (Lumbirth: Eşici Bestek, noleiyer '/ozgatyi |
| Her yer nöron, T=16 | İstanbul Boğazı'nı geçen bölgeler Almanya'nın Avrupa'daki kaleleri Astana |
| Her yer nöron, T=64 | İstanbul Boğazı'ndan ayrılan boğazın girişinden geçerek, Ege Denizi'nin güneyindeki İstanbul Boğazı'na kadar uzanan boğazdır. Boğazın girişinden ve boğazdan daha kısa bir sürede erişilebileceği de söylenebilir. |
Küçük model zaten bilgi uyduruyor (başka bir örnekte “Türkiye’nin başkenti Moskova…” diye başladı); burada bilgi doğruluğuna değil, Türkçenin ayakta kalıp kalmadığına bakıyorum.
Doğrudan çevirmenin neden çöktüğünü de gördüm. Orijinal model GELU adlı bir etkinleştirme kullanıyor, bu da küçük negatif değerlere izin veriyor; nöron ise negatif değer taşıyamıyor. ReLU’ya geçip eğitince doğrudan çevirme 30,9’e kadar indi, ama nöronsuz hâlinin (24,3) gerisinde kaldı: nadiren görülen büyük değerler eşikte kesiliyor. Kesme eşiğini eğitimde modelin kendisine öğrettiğimde bu fark kapandı.
Nöronlar ne kadar meşgul?
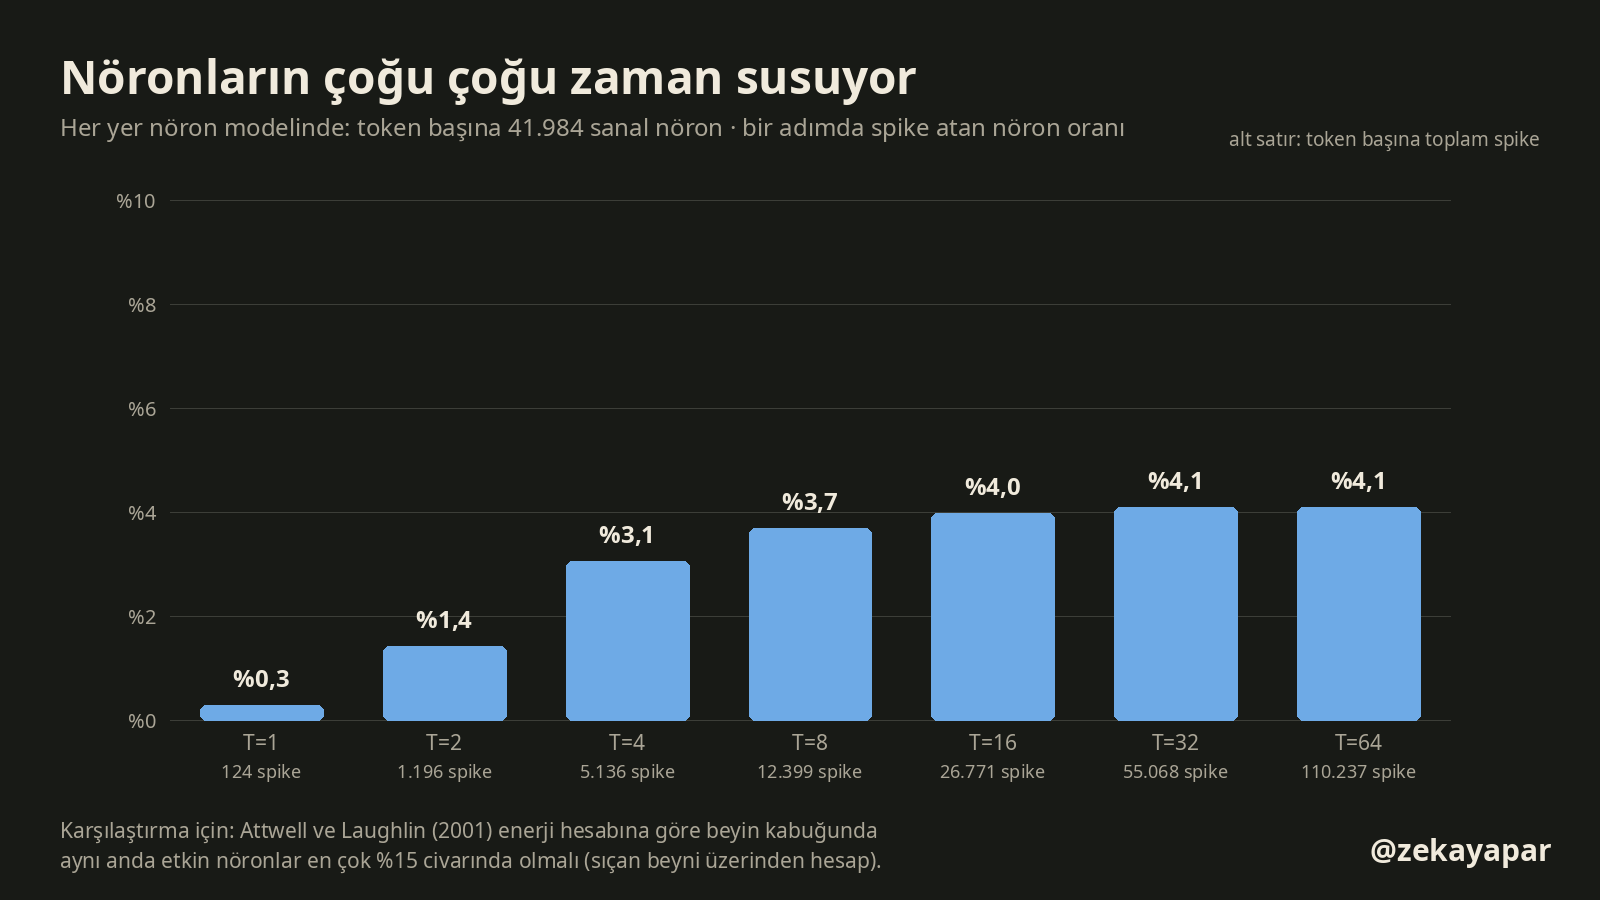
Her yer nöron modelinde her kelime parçası için 41.984 sanal nöron çalışıyor. 16 adımlık sürümde token başına toplam 26.771 spike düşüyor; bir adımda nöronların yalnız %4,0’i spike atıyor. Bu, beynin enerji tasarrufu için seyrek çalıştığı fikrine benziyor: Attwell ve Laughlin’in (2001) sıçan beyni üzerinden yaptığı enerji hesabına göre beyin kabuğunda aynı anda etkin nöronlar en çok %15 civarında olmalı. Benzetme bu kadar; iki sayı aynı şeyi ölçmüyor.
Daha mı az enerji harcar?
Nöromorfik çiplerin savunduğu fikir şu: spike geldiğinde yalnız toplama yapılıyor, çarpma yok. Horowitz’in 45 nm çip değerleriyle (çarp-topla 4,6 pJ, toplama 0,9 pJ) kaba bir hesap yaptım. Normal ağ token başına yaklaşık 193 µJ aritmetik harcıyor; 16 adımlık nöron sürümü 47 µJ, 64 adımlık sürüm 192 µJ. Yani avantaj spike sayısına bağlı: adımı artırınca kalite artıyor ama enerji avantajı kayboluyor. Olayların %39’i son katmandan geliyor, çünkü oradaki her spike 32.768 kelime parçasının hepsine dağılıyor.
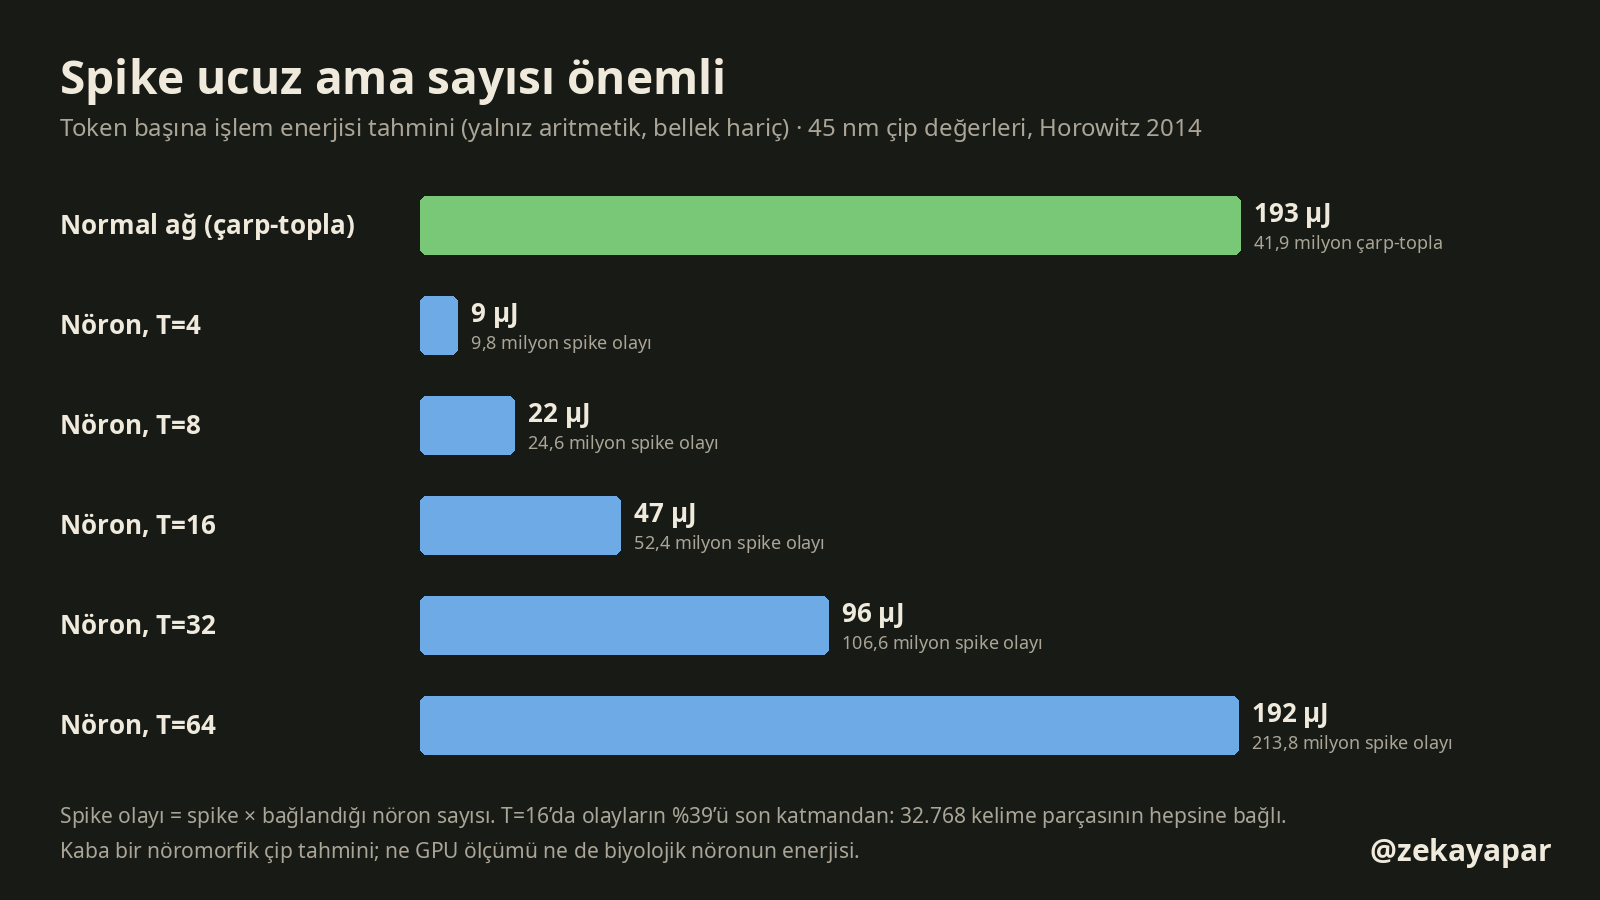
Bu tahmin bellek erişimini saymıyor, GPU’da ölçülmüş bir değer değil ve biyolojik nöronun enerjisiyle ilgisi yok. Simülasyonun kendisi GPU’da normal modelden çok daha yavaş çalışıyor; GPU spike için tasarlanmadı.
Her şey nöron oldu mu?
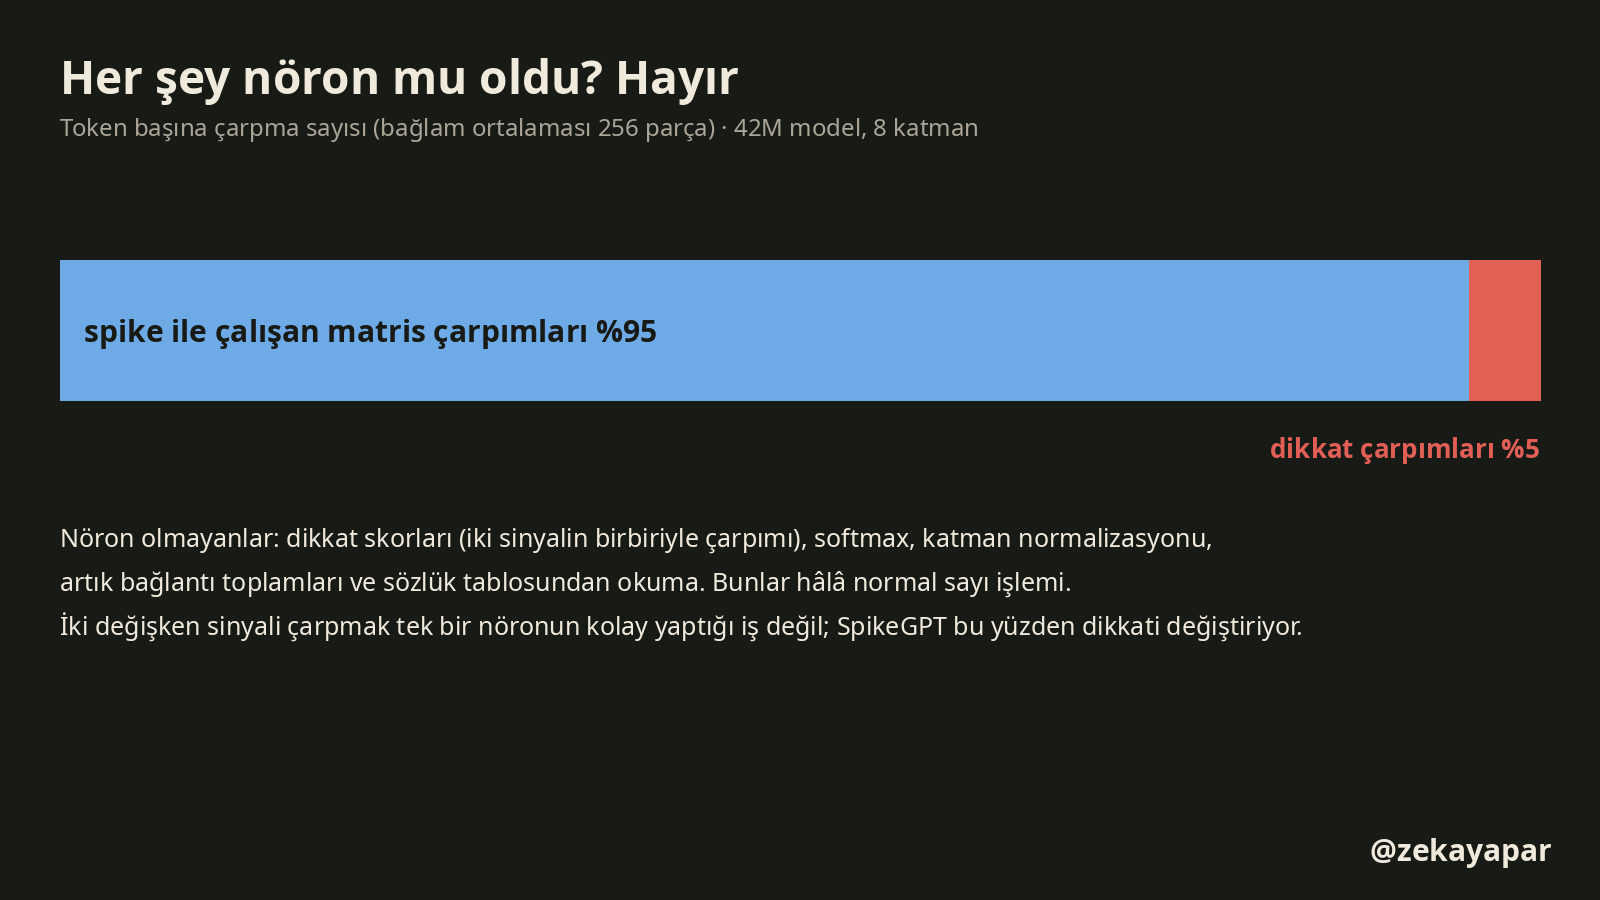
Hayır. Matris çarpımlarının yaklaşık %95’i spike ile yapılıyor; kalan kısım dikkat (attention) mekanizmasında iki değişken sinyalin birbiriyle çarpılması. Softmax, katman normalizasyonu ve artık bağlantı toplamları da hâlâ normal sayı işlemi. İki değişken sinyali çarpmak tek bir nöronun kolay yaptığı bir iş değil; 46 ve 216 milyon parametrelik SpikeGPT bu yüzden dikkat yerine RWKV tarzı bir yapı kullanıyor.
Yer var mı? Var, yazamıyoruz
İnsan beyin kabuğunda yaklaşık 150 trilyon sinaps var (Pakkenberg ve ark., 2003). Her ağırlığı bir sinaps sayarsam masamda çalışan 27 milyar parametrelik Qwen bunların yaklaşık %0,02’ine denk geliyor. Kâğıt üstünde yer var.
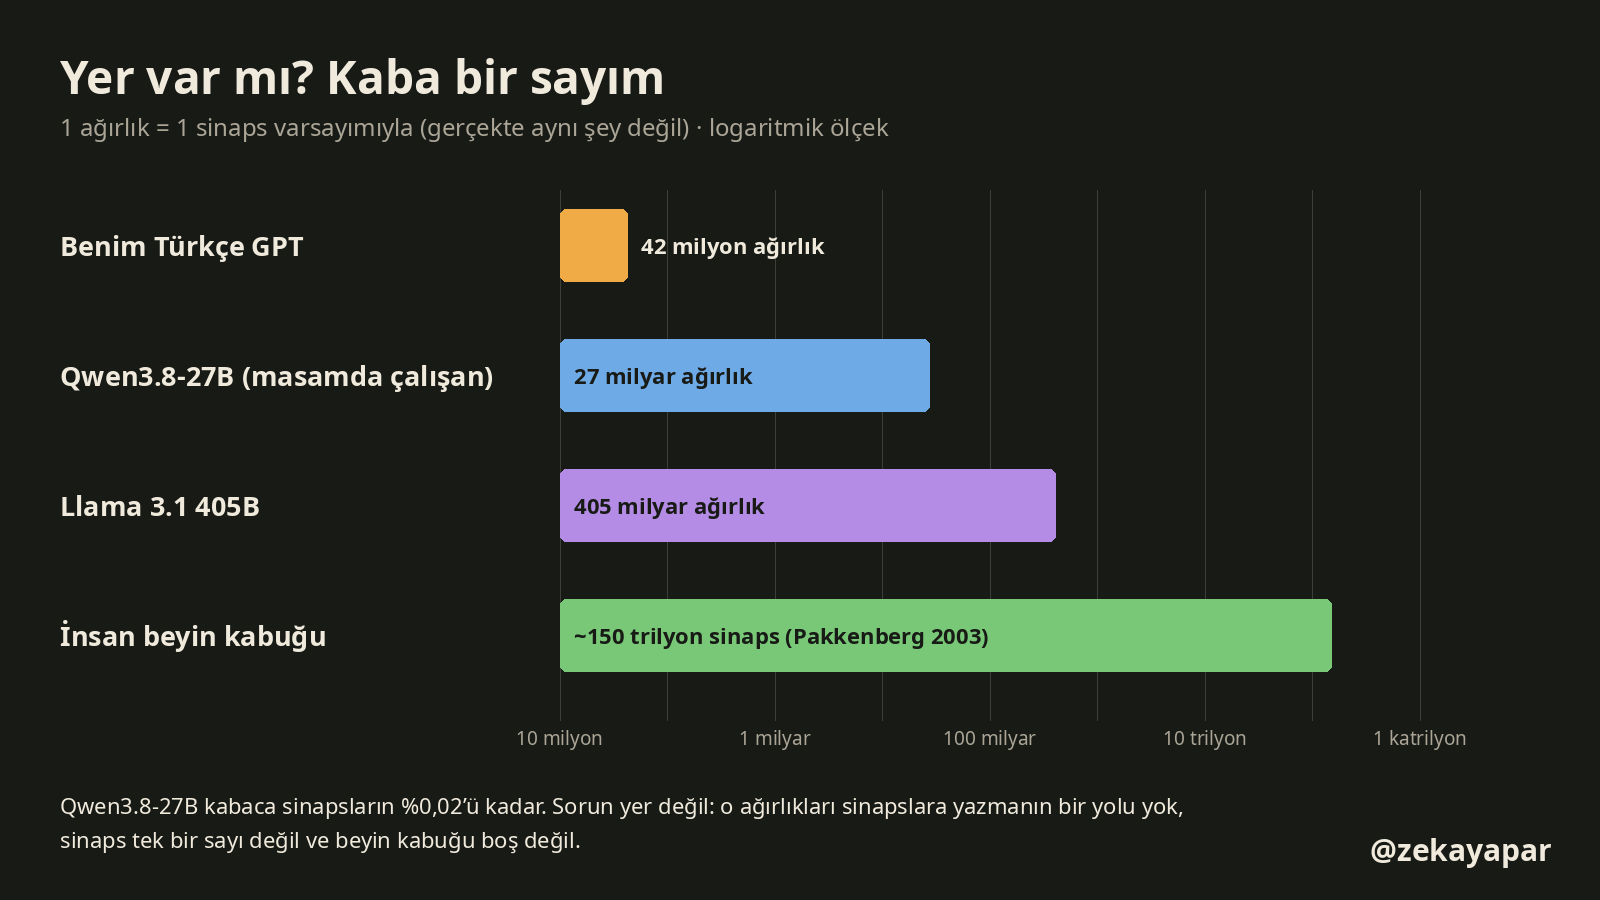
Ama bu hesap üç yerden aksıyor. Birincisi, tek bir korteks nöronunun giriş-çıkış davranışını taklit etmek için 5–8 katmanlı bir yapay ağ gerekiyor (Beniaguev ve ark., Neuron 2021); yani gerçek nöron benim simüle ettiğim basit nörondan çok daha karmaşık, “1 birim = 1 nöron” eşlemesi kaba kalıyor. İkincisi, beyin kabuğu boş değil; o sinapslar zaten kullanılıyor. Üçüncüsü ve en önemlisi: sinapsa istenen ağırlığı yazmanın bir yolu yok. Bugün yapılabilen kaba izler bırakmak. Maymunlarla yapılan bir beyin-bilgisayar arayüzü deneyi de beynin her deseni öğrenemediğini, yeni desenleri kendi alışık olduğu sinyal yapısı içinden kolay öğrendiğini gösteriyor (Sadtler ve ark., Nature 2014).
Benim için sonuç
Kapasite var. Modeli nöron diline çevirmek de yarı yarıya mümkün: benim küçük deneyimde model çevrilebiliyor ama ancak baştan nörona göre eğitilirse. Eksik olan ağırlıkları gerçek nöronlara yükleme kısmı. Gördüğüm kadarıyla bu yolu açabilecek üç şey var:
- Spike’a uygun model mimarileri: dikkat gibi iki sinyali çarpan işlemleri azaltan yapılar.
- Modeli dışarıda eğitip içeri kopyalamak yerine, nöronların kendi öğrenme kurallarıyla yerinde öğretmek. Tabaktaki Pong ve Doom deneyleri bu yönde.
- Tek nöron ve tek sinaps çözünürlüğünde okuyup yazabilen arayüzler. En yoğun deneysel implantlar on binlerce elektroda çıktı (Columbia’nın BISC çipinde 65.536); trilyonlarca sinapsın yanında bu çok küçük.
Bunlar benim çıkarımım, ölçülmüş sonuç değil. Etik tarafı da ayrıca büyük: implantlı hastaya cevap öneren modelde “kim konuşuyor?” sorusu şimdiden soruluyor; modelin beynin kendisinde çalıştığı bir senaryoda bu soru çok daha zor hâle gelir.
Sınırlar
- Gerçek nöron yok, beyin verisi yok. En basit nöron modeli (integrate-and-fire, sabit akım, yumuşak sıfırlama) bir GPU’da simüle edildi; gerçek nöronların zamanlaması, gürültüsü ve dendritleri yok.
- Nörona göre eğitilen modeller ek eğitim aldı: ara katman modeli 15 dakika, her yer modeli 15 + 15 dakika. Karşılaştırma modeline 15 dakika ek eğitim verildi; her yer modeli onun iki katı süre eğitildi.
- Katmanlar sırayla, her biri kendi T adımında hesaplandı. Spike’ların katmanlar arasında zaman içinde akması simüle edilmedi.
- Enerji, 45 nm çip değerleriyle yapılmış kaba bir aritmetik tahmini; bellek ve iletişim maliyeti yok.
- Sinaps ve ağırlık karşılaştırması bir büyüklük fikri vermek için; ikisi aynı şey değil.
Tam tablo ve yöntem
- Model: 42,2 milyon parametre, 8 katman, iç boyut 512, 8 kafa, bağlam 512, kendi 32k Türkçe BPE sözlüğüm. Veri: wikimedia/wikipedia 20231101.tr (eğitimde kullanılmayan %0,5 doğrulama kısmı).
- Ek eğitimler: AdamW, öğrenme hızı 1e-4, 200 adım ısınma, kosinüs, yığın 4 × 8 biriktirme × 512 token, bfloat16, her biri 15 dakika. ReLU modeli GELU→ReLU; “uyarlanmış” model ara katmanda [0, θ] kırpma + 8 basamak, θ katman başına öğrenilir (düz geçişli gradyan, başlangıç %99,9 yüzdelik); “her yer” modeli bunun üstüne dikkat, ara katman ve son katman girişlerinde işaretli [−θ, θ] kırpma + 16 basamak, θ öğrenilir.
- Nöron: integrate-and-fire, sabit giriş akımı, zar yarı eşikten başlar, eşiği geçince spike ve eşik kadar düşüş (yumuşak sıfırlama). Çıktı = spike sayısı / T × eşik. İşaretli sinyal = artı ve eksi iki nöron grubu. Eşikler eğitim verisinden (%99,9 yüzdelik) ya da eğitimde öğrenilmiş değerlerden; doğrulama verisi eşik için kullanılmadı.
- Nöron noktaları: her katmanda dikkat girişi (2×512), dikkat çıktısı (2×512), ara katman girişi (2×512), ara katman (2048) ve son katman girişi (2×512): token başına 41.984 nöron.
- Değerlendirme: 10 × 4 × 512 = 20.480 doğrulama tokenı, float32. Örnekler: sıcaklık 0,8, en olası 50 parça, 40 yeni parça, tohum 2026.
- Enerji tahmini: Horowitz (ISSCC 2014), 45 nm, 32 bit kayan nokta çarpma 3,7 pJ + toplama 0,9 pJ; spike olayı = spike × bağlandığı çıkış sayısı, her biri bir toplama.
| Yapılandırma | T | Kayıp | Perplexity | Spike / token | Spike olayı / token (milyon) |
|---|---|---|---|---|---|
| orijinal-gelu | – | 3,2174 | 25,0 | – | – |
| gelu-ft | – | 3,1696 | 23,8 | – | – |
| gelu-ft-naif-ffn-spike-T8 | 8 | 8,6971 | 5985,7 | 1.566 | 0,8 |
| gelu-ft-naif-ffn-spike-T64 | 64 | 8,6010 | 5437,2 | 12.629 | 6,5 |
| relu | – | 3,1887 | 24,3 | – | – |
| relu-ffn-spike-T1 | 1 | 8,4417 | 4636,2 | 71 | 0,0 |
| relu-ffn-spike-T2 | 2 | 4,5840 | 97,9 | 398 | 0,2 |
| relu-ffn-spike-T4 | 4 | 3,7004 | 40,5 | 1.024 | 0,5 |
| relu-ffn-spike-T8 | 8 | 3,4901 | 32,8 | 2.173 | 1,1 |
| relu-ffn-spike-T16 | 16 | 3,4419 | 31,2 | 4.411 | 2,3 |
| relu-ffn-spike-T32 | 32 | 3,4326 | 31,0 | 8.853 | 4,5 |
| relu-ffn-spike-T64 | 64 | 3,4292 | 30,9 | 17.722 | 9,1 |
| relu-tum-spike-T1 | 1 | 12,1052 | 180804,0 | 193 | 0,2 |
| relu-tum-spike-T2 | 2 | 11,3952 | 88898,4 | 1.046 | 1,7 |
| relu-tum-spike-T4 | 4 | 9,4708 | 12975,7 | 4.972 | 9,3 |
| relu-tum-spike-T8 | 8 | 7,0569 | 1160,8 | 11.841 | 23,8 |
| relu-tum-spike-T16 | 16 | 5,4552 | 234,0 | 24.536 | 49,3 |
| relu-tum-spike-T32 | 32 | 4,4606 | 86,5 | 48.952 | 99,2 |
| relu-tum-spike-T64 | 64 | 4,1391 | 62,7 | 98.087 | 199,4 |
| qrelu8 | – | 3,2237 | 25,1 | – | – |
| qrelu8-ffn-spike-T1 | 1 | 6,5450 | 695,7 | 113 | 0,1 |
| qrelu8-ffn-spike-T2 | 2 | 3,7307 | 41,7 | 534 | 0,3 |
| qrelu8-ffn-spike-T4 | 4 | 3,3121 | 27,4 | 1.280 | 0,7 |
| qrelu8-ffn-spike-T8 | 8 | 3,2237 | 25,1 | 2.673 | 1,4 |
| qrelu8-ffn-spike-T16 | 16 | 3,2040 | 24,6 | 5.405 | 2,8 |
| qrelu8-ffn-spike-T32 | 32 | 3,1976 | 24,5 | 10.838 | 5,5 |
| qrelu8-ffn-spike-T64 | 64 | 3,1968 | 24,5 | 21.689 | 11,1 |
| qrelu8-tum-spike-T1 | 1 | 12,2659 | 212333,1 | 112 | 0,2 |
| qrelu8-tum-spike-T2 | 2 | 11,3440 | 84460,5 | 1.101 | 1,8 |
| qrelu8-tum-spike-T4 | 4 | 9,0649 | 8646,8 | 5.116 | 9,3 |
| qrelu8-tum-spike-T8 | 8 | 6,3448 | 569,5 | 12.460 | 24,0 |
| qrelu8-tum-spike-T16 | 16 | 4,7466 | 115,2 | 25.634 | 49,8 |
| qrelu8-tum-spike-T32 | 32 | 3,8822 | 48,5 | 50.963 | 100,3 |
| qrelu8-tum-spike-T64 | 64 | 3,6277 | 37,6 | 102.075 | 201,4 |
| qall16 | – | 3,3262 | 27,8 | – | – |
| qall16-tum-spike-T1 | 1 | 10,8980 | 54068,3 | 124 | 0,2 |
| qall16-tum-spike-T2 | 2 | 10,5979 | 40052,0 | 1.196 | 1,9 |
| qall16-tum-spike-T4 | 4 | 7,7837 | 2401,2 | 5.136 | 9,8 |
| qall16-tum-spike-T8 | 8 | 4,5992 | 99,4 | 12.399 | 24,6 |
| qall16-tum-spike-T16 | 16 | 3,3495 | 28,5 | 26.771 | 52,4 |
| qall16-tum-spike-T32 | 32 | 3,3193 | 27,6 | 55.068 | 106,6 |
| qall16-tum-spike-T64 | 64 | 3,3007 | 27,1 | 110.237 | 213,8 |
İndir: betikler, tüm sonuçlar ve örnek metinler (ZIP) · snn.json · model.py