 zekayapar
Sayı, tarih ve kodda Türkçe kaç token tutuyor?
1000 tutar, 365 tarih ve 22 kod dosyasını 14 tokenizer’dan geçirdim: TL ile dolar aynı, Türkçe tarih daha ucuz; fark kod yorumlarında, GPT-4o’da yüzde 32.
Ölçüm
- 1000 tutar × 6 yazım · 365 tarih × 6 yazım · 1–12 basamak · 500 yüzde
- FLORES-200 · 2009 paralel cümle (413 rakamlı)
- 14 tokenizer · Hugging Face tokenizers 0.23.3 · tiktoken 0.14.0 · CPU
Kod
- CPython 3.14.0 (10 dosya) · lodash-es 4.17.21 (12 dosya)
- Yorum çevirisi: Qwen3.8-27B NVFP4 · vLLM · RTX 5090 · 307/328 parça
- usage.prompt_tokens = yerel sayım (4/4 metin)
Önceki yazıda aynı metnin Türkçesinin çoğu modelde daha fazla token tuttuğunu ölçmüştüm; GPT-4o ailesinde fark 1,43 kattı. O ölçüm düz cümlelerle yapılmıştı. Gündelik işte ise modele bolca fatura tutarı, tarih, büyük sayı ve kod veriyorum. Merak ettiğim şuydu: Türkçe yazım alışkanlıkları, yani 1.234,56 TL, 21 Ekim 2026 ya da Türkçe kod yorumu, faturayı ne kadar etkiliyor?
Kısa cevap: sayı ve tarihte Türkçe yazım pahalı değil. 1000 tutarda 1.234,56 TL ile $1,234.56 14 tokenizer’ın 13’ünde birebir aynı sayıda token tuttu. 21 Ekim 2026 ise 14’ünün hepsinde October 21, 2026’dan ucuz çıktı. Fark yazıda çıkıyor: Aynı kodun yorumlarını Türkçeye çevirince yorum kısmı GPT-4o’da yüzde 32 büyüdü, dosyanın tamamı ise yüzde 12,5.
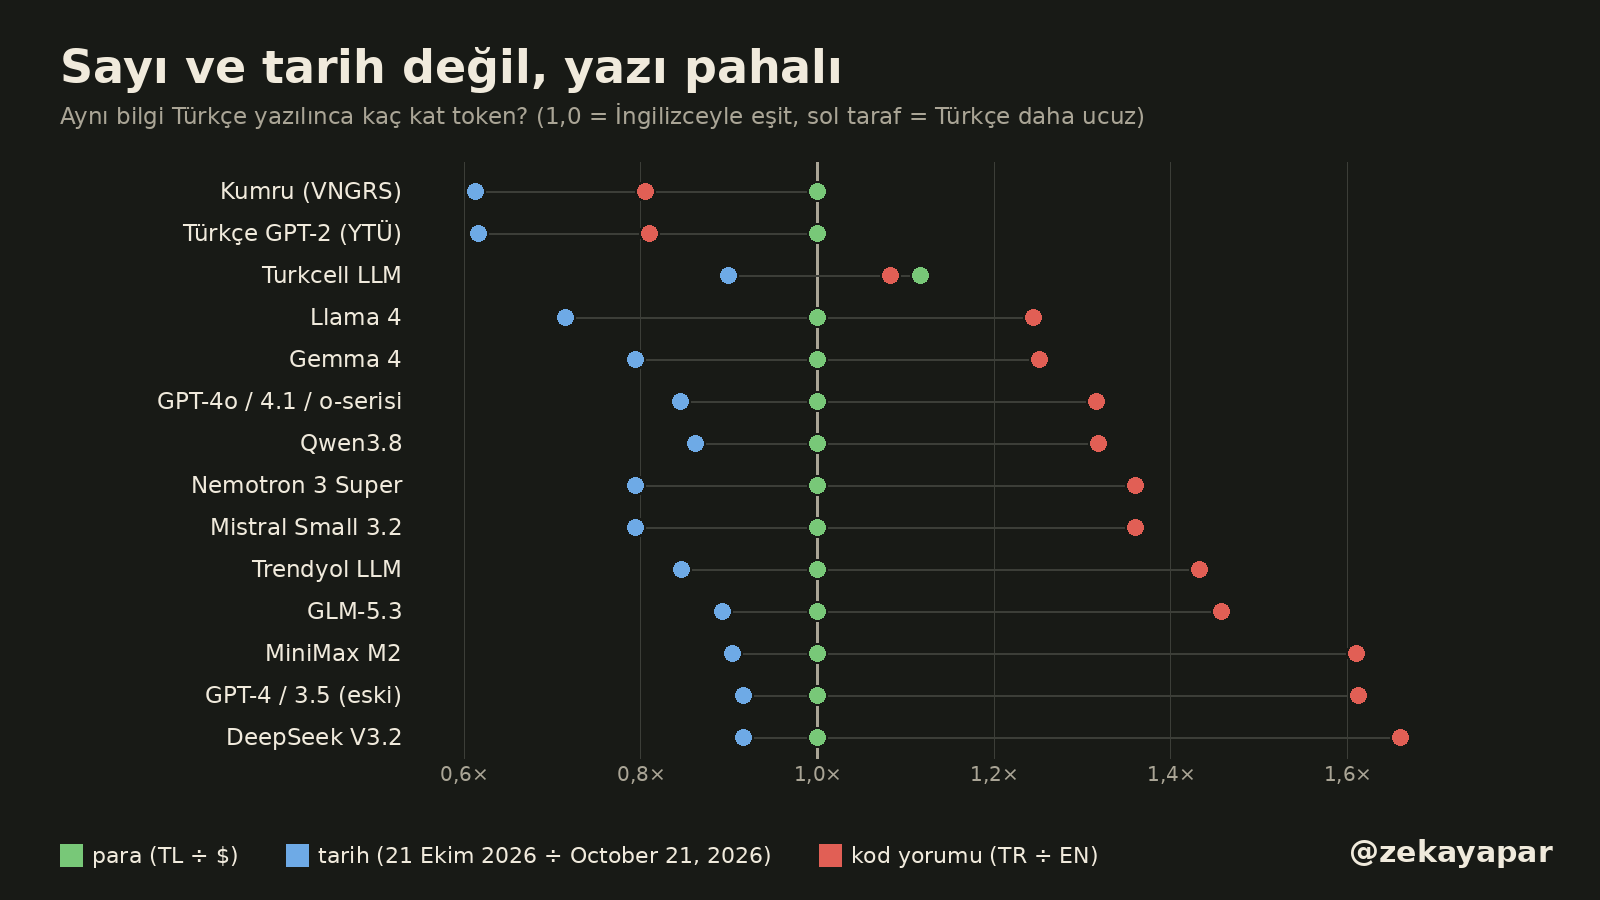
Bu grafik yazının özeti. Her satır bir tokenizer. Yeşil nokta para tutarını, mavi tarihi, kırmızı kod yorumunu gösteriyor. 1,0 çizgisi “İngilizceyle aynı” demek. Yeşiller neredeyse hep tam çizginin üstünde, maviler hep solunda yani Türkçe daha ucuz. Kırmızılar ise Türkçe için eğitilmiş iki küçük model dışında hep sağda.
Nasıl ölçtüm
Dört ayrı set hazırladım. Hepsi sabit bir tohumla (20261022) üretildiği için aynı betik aynı sayıları yeniden veriyor:
- Para: 1 TL ile 10 milyon TL arasında, kuruşlu 1000 rastgele tutar. Her tutar altı yazımda:
1.234,56 TL,₺1.234,56,1.234,56 lira,$1,234.56,1,234.56 USDve ayraçsız1234.56. - Tarih: 2026’nın 365 günü altı yazımda:
21 Ekim 2026,21 Ekim 2026 Çarşamba,21.10.2026,October 21, 2026,Wednesday, October 21, 2026,2026-10-21. - Büyük sayılar: 1’den 12 basamağa kadar her uzunlukta 200 tamsayı; ayraçsız, Türkçe usulü noktalı (
1.234.567) ve İngilizce usulü virgüllü (1,234,567). Ayrıca 500 yüzde değeri:%12,5ve12.5%. - Kod: Kendi yazdığım örnekler yerine herkesin erişebildiği gerçek kodu kullandım: Python’un kendi standart kütüphanesinden 10 dosya (CPython 3.14.0,
bisect,heapq,textwrap,shlexgibi) ve JavaScript’te lodash’tan 12 dosya (lodash-es 4.17.21). Bu dosyalardaki 328 yorum ve docstring parçasını bu bilgisayarda çalışan Qwen3.8-27B’ye Türkçeye çevirttim. Kodun kendisine dokunmadım.
Hepsini önceki yazıdaki 14 tokenizer’dan geçirdim: GPT-4o ailesi ve eski GPT-4, Qwen3.8, GLM-5.3, DeepSeek V3.2, Gemma 4, Llama 4, Mistral, MiniMax, Nemotron ve Türkçe için eğitilmiş dört model (Kumru, Turkcell, Trendyol, YTÜ GPT-2). gpt-oss GPT-4o ile aynı sözlüğü kullandığı için grafiklerde ayrıca göstermedim. Claude ve Gemini’nin tokenizer’ı açık olmadığı için onları ölçemedim.
Bir de gerçek sistemle kontrol yaptım. Yerelde çalışan Qwen3.8 sunucusuna aynı metinleri gönderdim ve sunucunun saydığı girdi tokenını kendi sayımımla karşılaştırdım. Dört metnin dördünde de sayılar birebir tuttu (ör. Türkçe yorumlu textwrap.py: sunucu 5.345, yerel sayım 5.345). Tek ayrıntı şu: sohbet şablonu metnin başındaki ve sonundaki boşluğu kırpıyor, bu yüzden yerel sayımı da kırpılmış metinle yaptım.
Tokenizer sayıları nasıl bölüyor
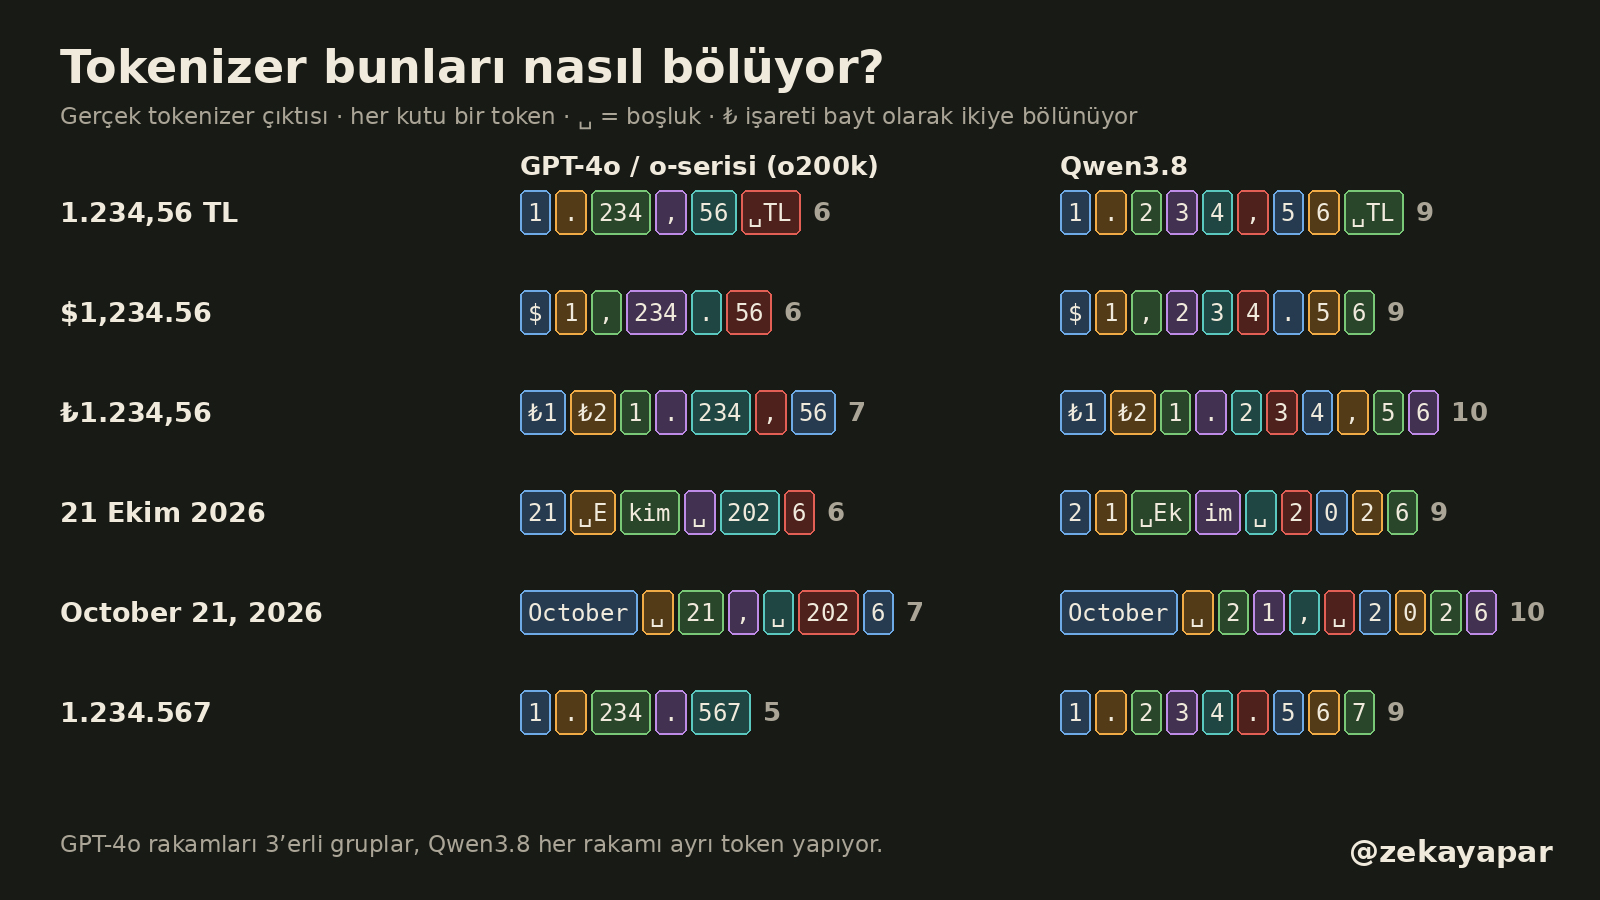
Sonuçları anlamak için önce bölünmeye bakmak gerekiyor. Kutuların hepsi gerçek tokenizer çıktısı. GPT-4o rakamları soldan üçerli gruplara ayırıyor: 1.234,56 TL → 1 . 234 , 56 ␣TL, toplam 6 token. $1,234.56 de aynı şekilde 6 token; nokta ile virgülün yer değiştirmesi bir şey değiştirmiyor. Qwen3.8 ise her rakamı ayrı token yapıyor, bu yüzden aynı tutar onda 9 token. Yine de Türkçe ve İngilizce yazımlar arasında fark yok.
Farkı yaratan iki şey var. Birincisi ₺ işareti: Sözlüklerde tek parça olarak bulunmadığı için iki bayta bölünüyor ve TL yazmaya göre bir token fazla tutuyor. İkincisi ay adı: Ekim GPT-4o’da ␣E + kim diye iki parça, October ise tek parça. Buna rağmen İngilizce tarih kaybediyor, çünkü October 21, 2026 yazımında fazladan virgül ve boşluk var.
Para: TL ile dolar aynı, ₺ işareti pahalı
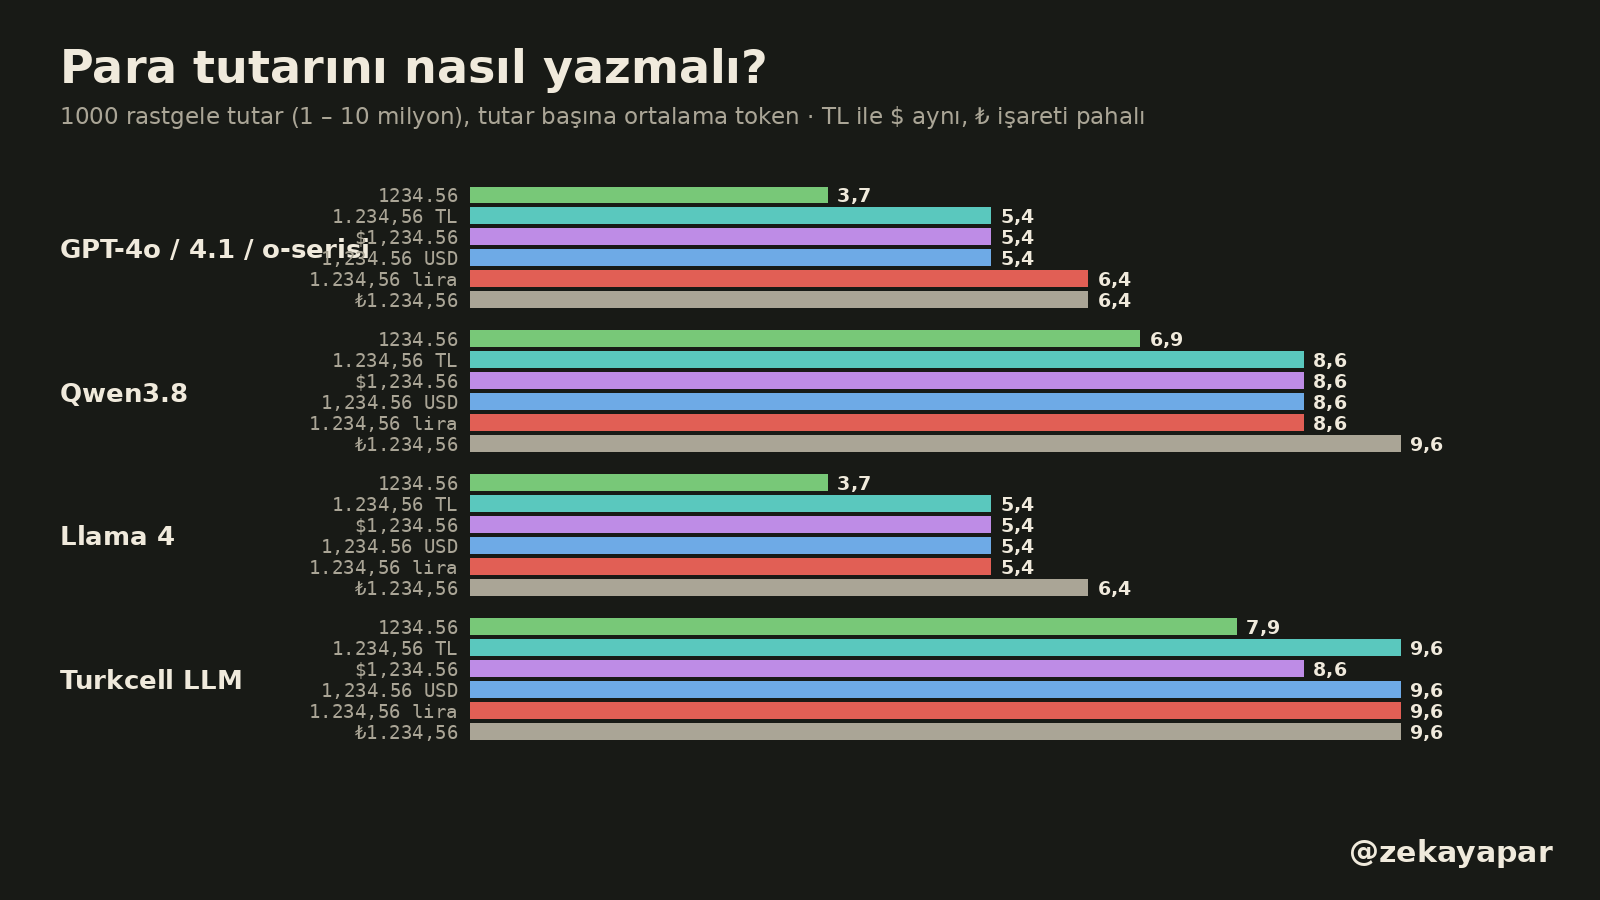
1000 tutarın ortalamasında GPT-4o’da 1.234,56 TL ve $1,234.56 ikisi de tutar başına 5,4 token. ₺ işaretli yazım 6,4’e çıkıyor, ayraçsız 1234.56 ise 3,7’ye iniyor. ₺ işareti 14 tokenizer’ın 10’unda pahalı çıktı. Gemma 4, Trendyol ve YTÜ GPT-2’de ₺ ile TL eşit. Turkcell’de ise TL ile ₺ eşit, ikisi de dolardan 1 token pahalı. 14 tokenizer içinde TL’nin dolardan pahalı olduğu tek yer burası.
lira kelimesi de modele göre değişiyor: Llama 4 ve Qwen3.8 onu tek token sayıyor, GPT-4o ise ␣l + ira diye ikiye bölüyor.
Tarih: Türkçe yazım daha kısa
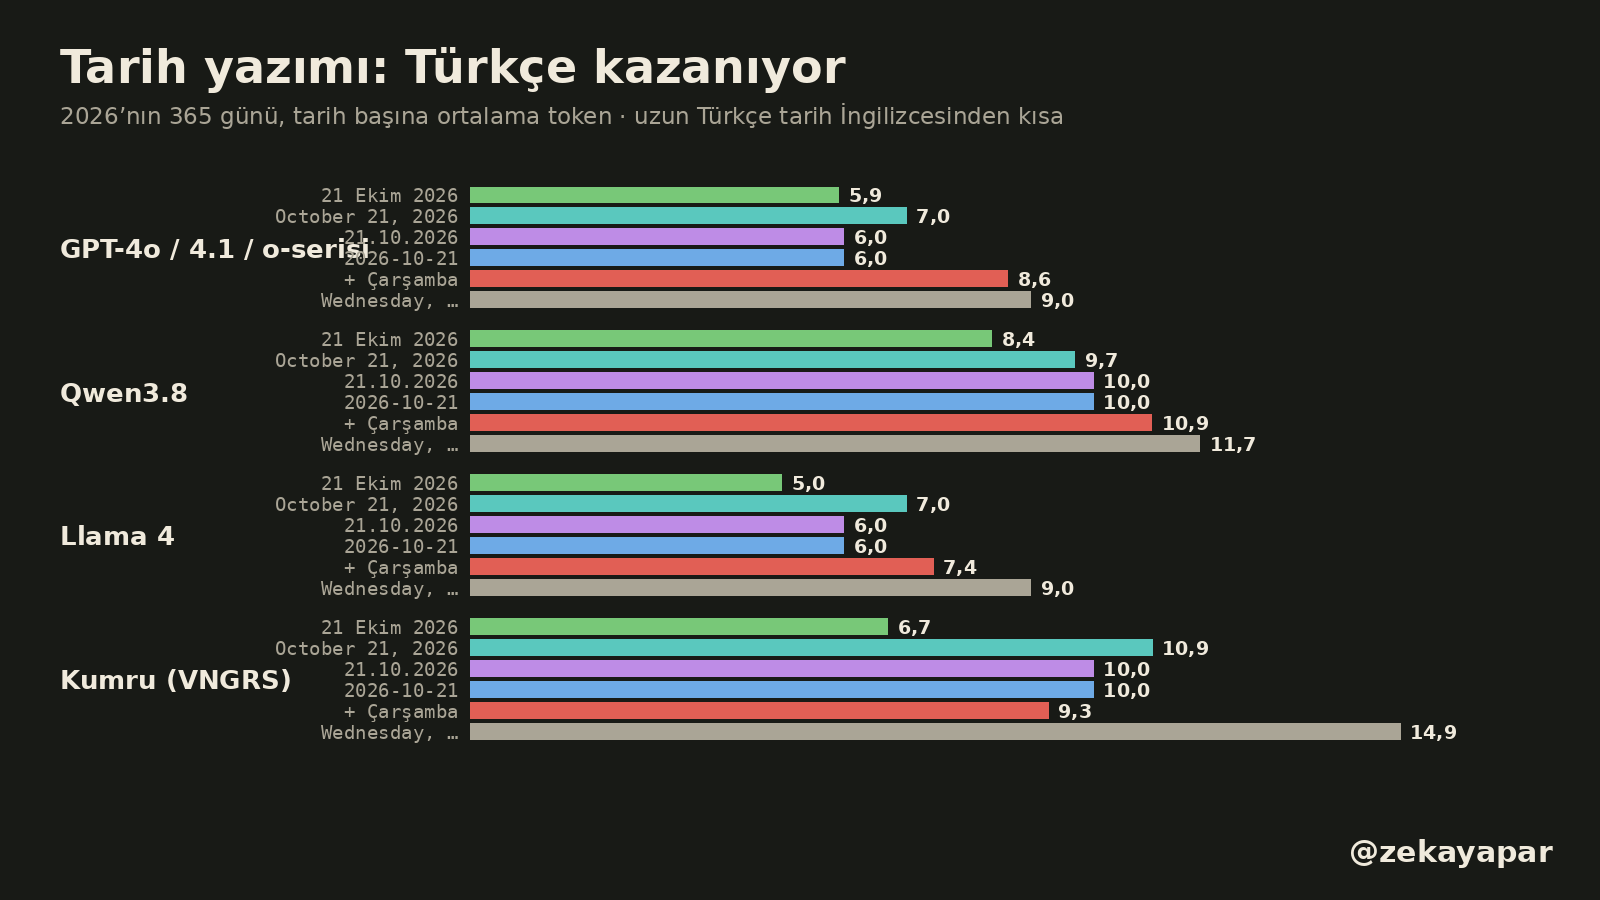
365 günün ortalamasında GPT-4o 21 Ekim 2026 biçimine 5,9, October 21, 2026 biçimine 7,0 token harcıyor. Türkçe tarih 14 tokenizer’ın hepsinde daha ucuz. Oran Llama 4’te 0,71, Kumru’da 0,61; en yakın olduğu DeepSeek ve eski GPT-4’te bile 0,92. Noktalı 21.10.2026 ile ISO 2026-10-21 biçimi 14 tokenizer’ın hepsinde birebir eşit.
Gün adında durum tersine dönüyor. GPT-4o’da Çarşamba eklemek ortalama 2,7 token, Wednesday eklemek 2 token tutuyor. İngilizce gün adlarının hepsi tek parça, Türkçelerde ise Ç, ş gibi harfler bölünmeye yol açıyor. Gün adıyla birlikte bile toplamda Türkçe tarih öndeydi: GPT-4o’da 8,6’ya karşı 9,0.
Büyük sayılarda asıl maliyet ayraç
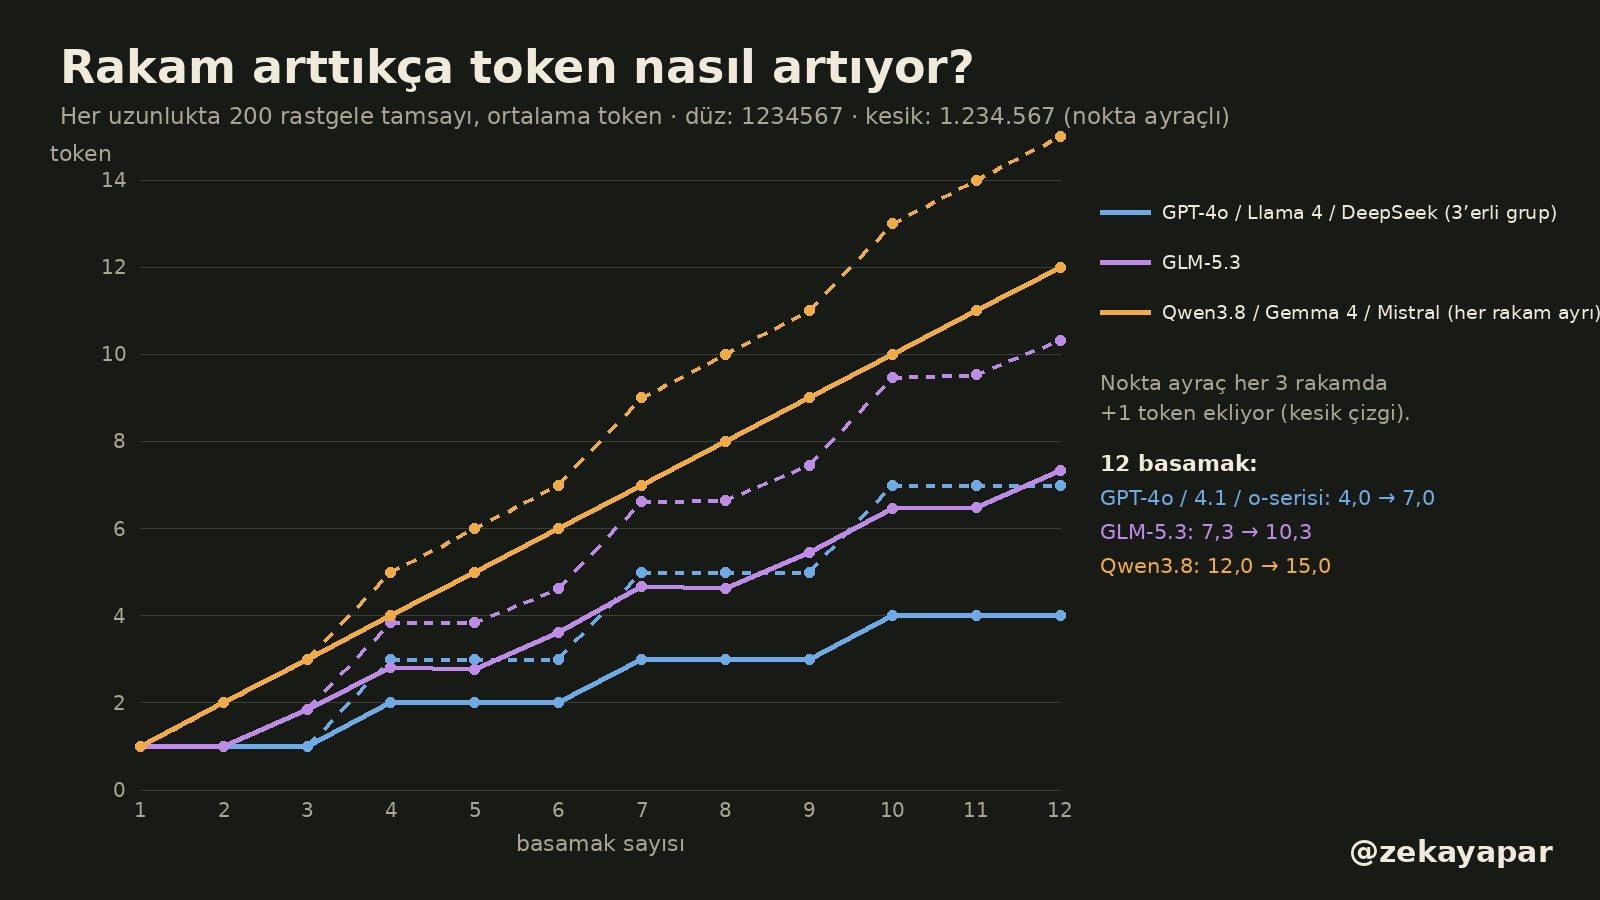
Bu grafikte iki ayrı sözlük mantığı görünüyor. GPT-4o, Llama 4 ve DeepSeek rakamları üçerli grupluyor; 10 basamaklı bir sayı ayraçsız 4 token. Qwen3.8, Gemma 4 ve Mistral her rakama bir token veriyor; aynı sayı onlarda 10 token. GLM-5.3 ikisinin arasında kalıyor.
Ayraç kullanmak her üç rakamda bir token ekliyor: 10 basamaklı sayı GPT-4o’da noktalı yazılınca 4’ten 7 tokena çıkıyor. Ayracın nokta ya da virgül olması fark etmiyor; Türkçe 1.234.567 ile İngilizce 1,234,567 14 tokenizer’ın hepsinde aynı sayıda token tutuyor. Yüzdelerde de durum benzer: %12,5 ile 12.5% 13 tokenizer’da eşit. Turkcell’de Türkçe yazım tek başına daha ucuz.
Gerçek metinde sayılar farkı küçültüyor
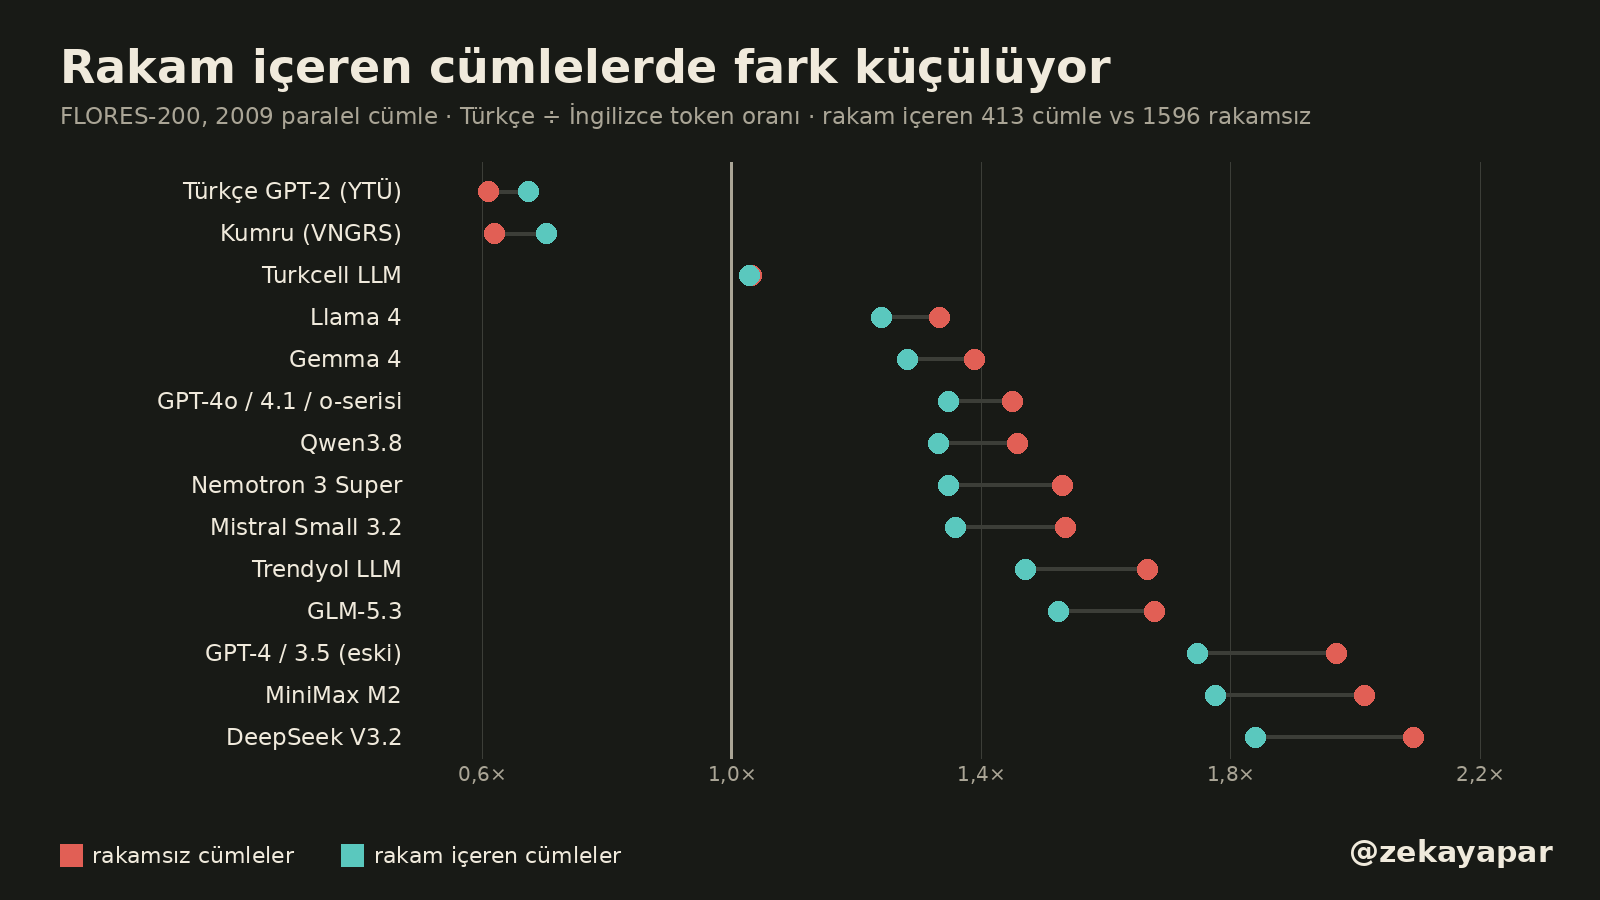
Aynı etkiyi yapay listelerin dışında da görmek istedim. Önceki yazıdaki 2009 paralel FLORES-200 cümlesini ikiye ayırdım: iki dilde de rakam içeren 413 cümle ve kalan 1596 cümle. GPT-4o’da rakamsız cümlelerde Türkçe/İngilizce oranı 1,45; rakam içerenlerde 1,35. 14 tokenizer’ın 12’sinde rakamlı cümlelerde fark daha küçük. Bunun sebebi rakamların iki dilde aynı yazılıp aynı tokena dönüşmesi: Metinde sayı ne kadar çoksa Türkçe ile İngilizce arasındaki fark o kadar sulanıyor.
Kod yorumları: farkın asıl çıktığı yer
Çeviriyi Qwen3.8-27B’ye yaptırdım: sıcaklık 0, düşünme kapalı, her yorum parçası ayrı bir istek. Modele verdiğim talimat tam olarak şuydu:
You translate source-code comments from English to Turkish. Translate only the natural-language English text into natural, fluent Turkish. Keep EXACTLY unchanged: comment markers (#, //, /*, *, */), line breaks and leading indentation/asterisks, JSDoc tags (@param, @returns, @example, @since, @memberOf, @category, @see, @static), types in braces, identifiers, parameter and function names, code inside backticks, doctest lines starting with >>> or ... and their expected-output lines, URLs and numbers. If the text has no English prose, return it unchanged. Output only the translated text, nothing else.
Kullanıcı mesajı olarak da yorumun kendisini gönderdim. bisect.py’deki bir docstring’in gerçek girdi ve çıktısı:
Insert item x in list a, and keep it sorted assuming a is sorted.

    If x is already in a, insert it to the right of the rightmost x.

    Optional args lo (default 0) and hi (default len(a)) bound the
    slice of a to be searched.

    A custom key function can be supplied to customize the sort order.
Liste a'ya x öğesini ekler ve a'nın sıralı olduğu varsayımıyla sıralı kalmasını sağlar.

    Eğer x zaten a'da varsa, en sağdaki x'in sağına eklenir.

    İsteğe bağlı lo (varsayılan 0) ve hi (varsayılan len(a)) argümanları,
    aranacak a dilimini sınırlar.

    Sıralama sırasını özelleştirmek için özel bir anahtar (key) fonksiyonu sağlanabilir.
Bu parça GPT-4o’da İngilizce 77 token, Türkçe 118 token. Tek satırlık bir yorum da şöyle: # Overwrite above definitions with a fast C implementation 10 token, çevirisi # Yukarıdaki tanımları hızlı bir C uygulamasıyla değiştir 15 token.
Çeviriler kusursuz değil. Model bir yerde “yığına” yerine “yığana” yazmış, bir JSDoc’ta @param etiketini @param- diye bozmuş. bisect_left’in uzun docstring’inde ise metnin büyük kısmını atlayıp tek cümle döndürmüş. Eksik çeviri sonucu Türkçe lehine çarpıtacağı için şöyle bir kural koydum: Türkçe metin İngilizcenin yüzde 60’ından kısaysa ya da yorum işaretlerini bozuyorsa o parça İngilizce kalıyor ve hesaba katılmıyor. Böylece 328 parçanın 307’si Türkçeye çevrilmiş olarak sayıldı. 16 parça bu kurala takıldı, 5 parçada da çevrilecek metin yoktu, model onları aynen geri verdi. Çevrilmiş dosyaların hepsi hâlâ çalışıyor: Python dosyaları ayrıştırıcıdan, JavaScript dosyaları node --check kontrolünden geçti.
Bir de düzeltme yapmam gerekti. Model docstring satırlarını birleştirince girinti boşlukları kayboluyordu, bu da Türkçe sürümü haksız yere ucuzlatıyordu. Orijinal girintiyi ve satır sonlarını geri koydum, uzun satırları 79 karakterde böldüm; kelimelere dokunmadım. Ham çeviriler ve düzeltilmiş hâlleri indirilebilir dosyalarda ayrı ayrı duruyor.
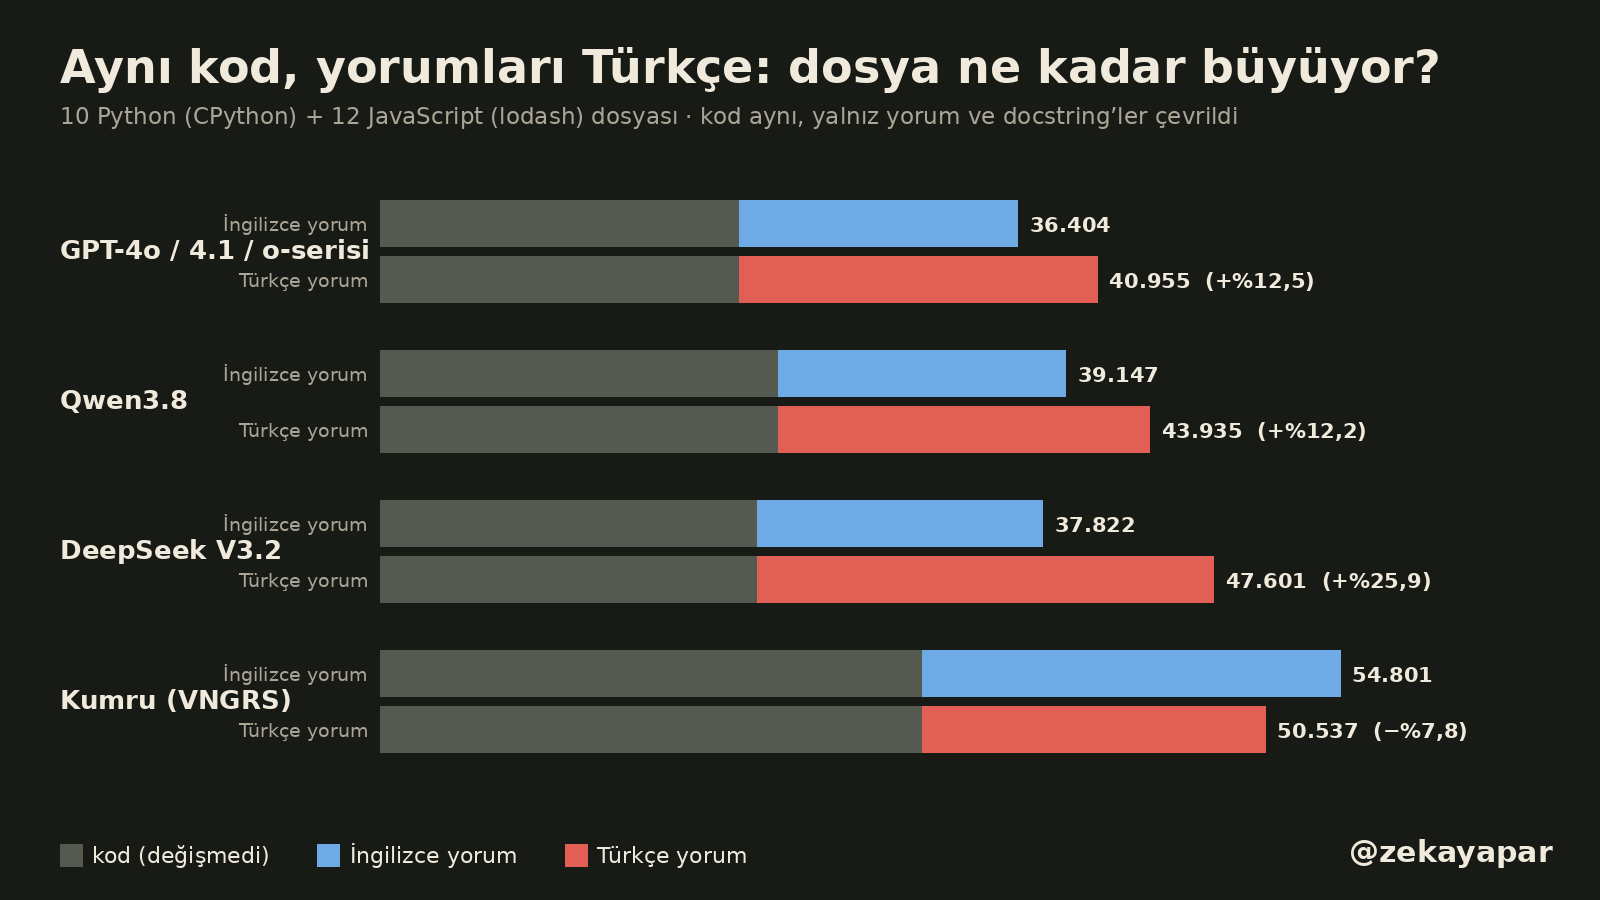
Dosyaların toplamında GPT-4o İngilizce yorumlu sürüme 36.404 token, Türkçe yorumlu sürüme 40.955 token harcıyor (+%12,5). Qwen3.8’de artış %12,2, DeepSeek V3.2’de %25,9. Kumru’da ise ters yönde: Türkçe yorumlu sürüm %7,8 daha ucuz. Gri kısım, yani kodun kendisi, iki sürümde de aynı; değişen yalnız renkli kısım. Bu dosyalarda yorumlar GPT-4o token sayısının yüzde 44’ü kadar. Az yorumlu bir projede fark daha küçük, bol açıklamalı bir projede daha büyük olur.
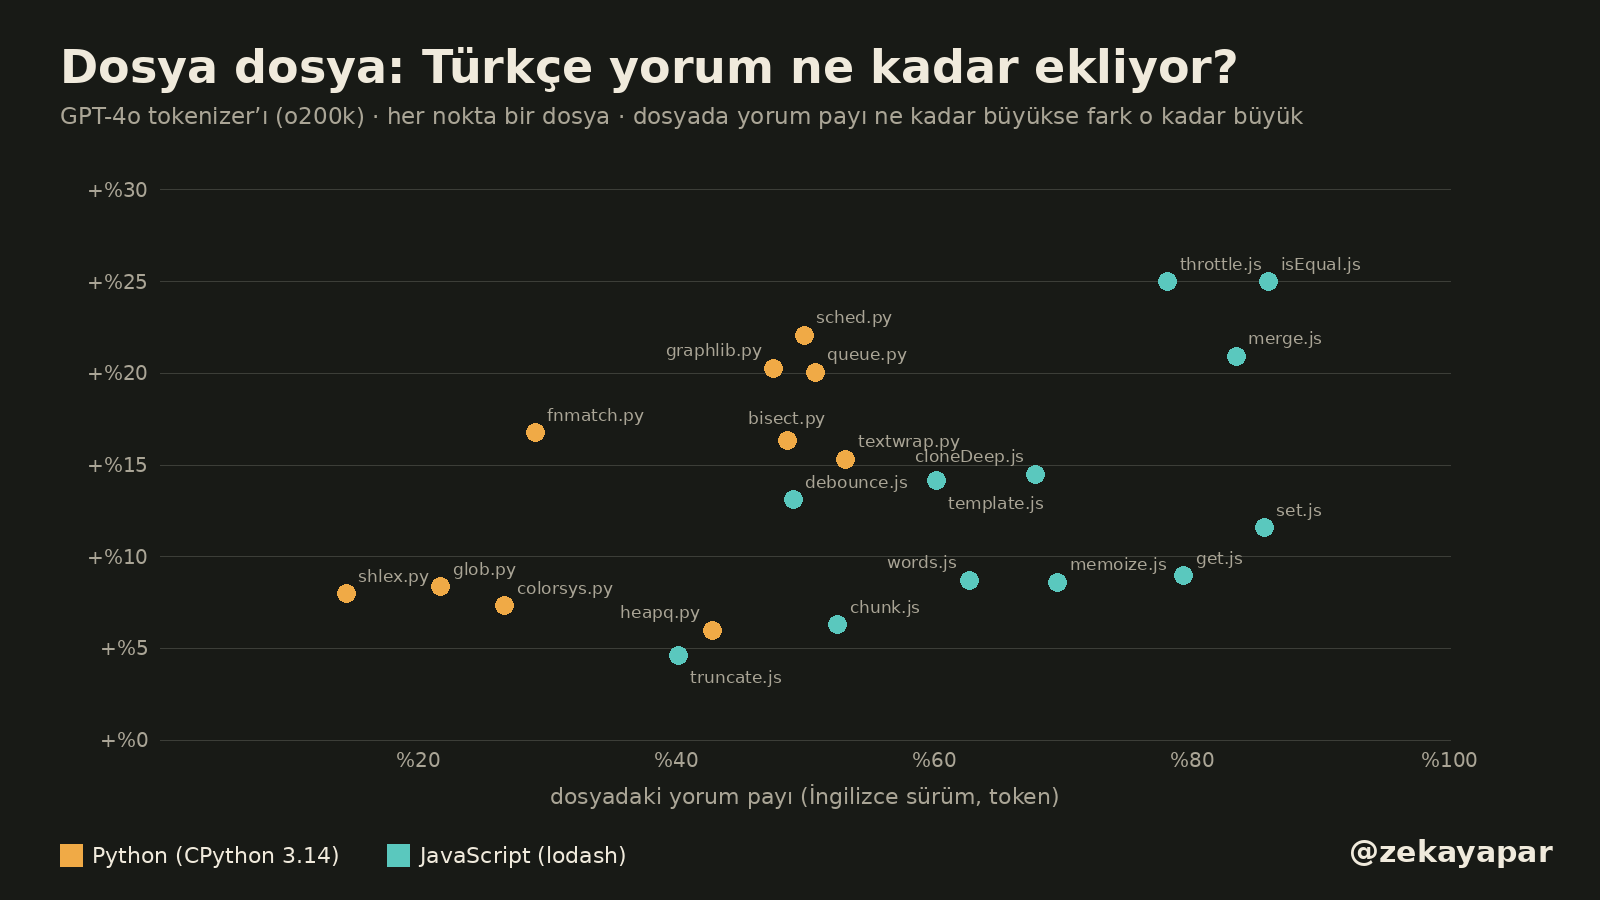
Dosya dosya bakınca eğilim görülüyor ama düzgün bir çizgi oluşmuyor. Yatay eksen dosyadaki yorum payı, dikey eksen Türkçe yorumun dosyayı ne kadar büyüttüğü. Yorumların payı yüzde 14 olan shlex.py’de artış %8, payın %78–86 olduğu throttle.js ve isEqual.js’de %25. Ama yorum payı %79 olan get.js’de artış yalnız %9. Bunun sebebi, lodash yorumlarının büyük kısmının @param etiketleri, tip adları ve kod örneklerinden oluşması; bunlar çevrilmeden aynen kalıyor. heapq.py’de ise 4 parça çeviri kontrolüne takılıp İngilizce kaldığı için artış %6’da kaldı.
Neden: daha az kelime, daha çok parça
Çevrilen 307 parçada Türkçe metin İngilizceden yüzde 14 daha az kelimeyle yazıldı (9.361 kelimeye karşı 8.077), karakter sayısı da sadece yüzde 5 arttı. Yani metin uzamadı, sadece parçalandı. Türkçede ekler kelimeye yapışıyor: uygulamasıyla, argümanları, varsayımıyla. Çok dilli sözlüklerde bu kelimeler hazır bulunmadığı için üç dört parçaya bölünüyor. Önceki yazıdaki sebep burada da geçerli. Sayılarda ise bu sorun ortaya çıkmıyor, çünkü rakamlar her dilde aynı.
Kestirme deneme: Türkçe karakterleri kullanmasam?
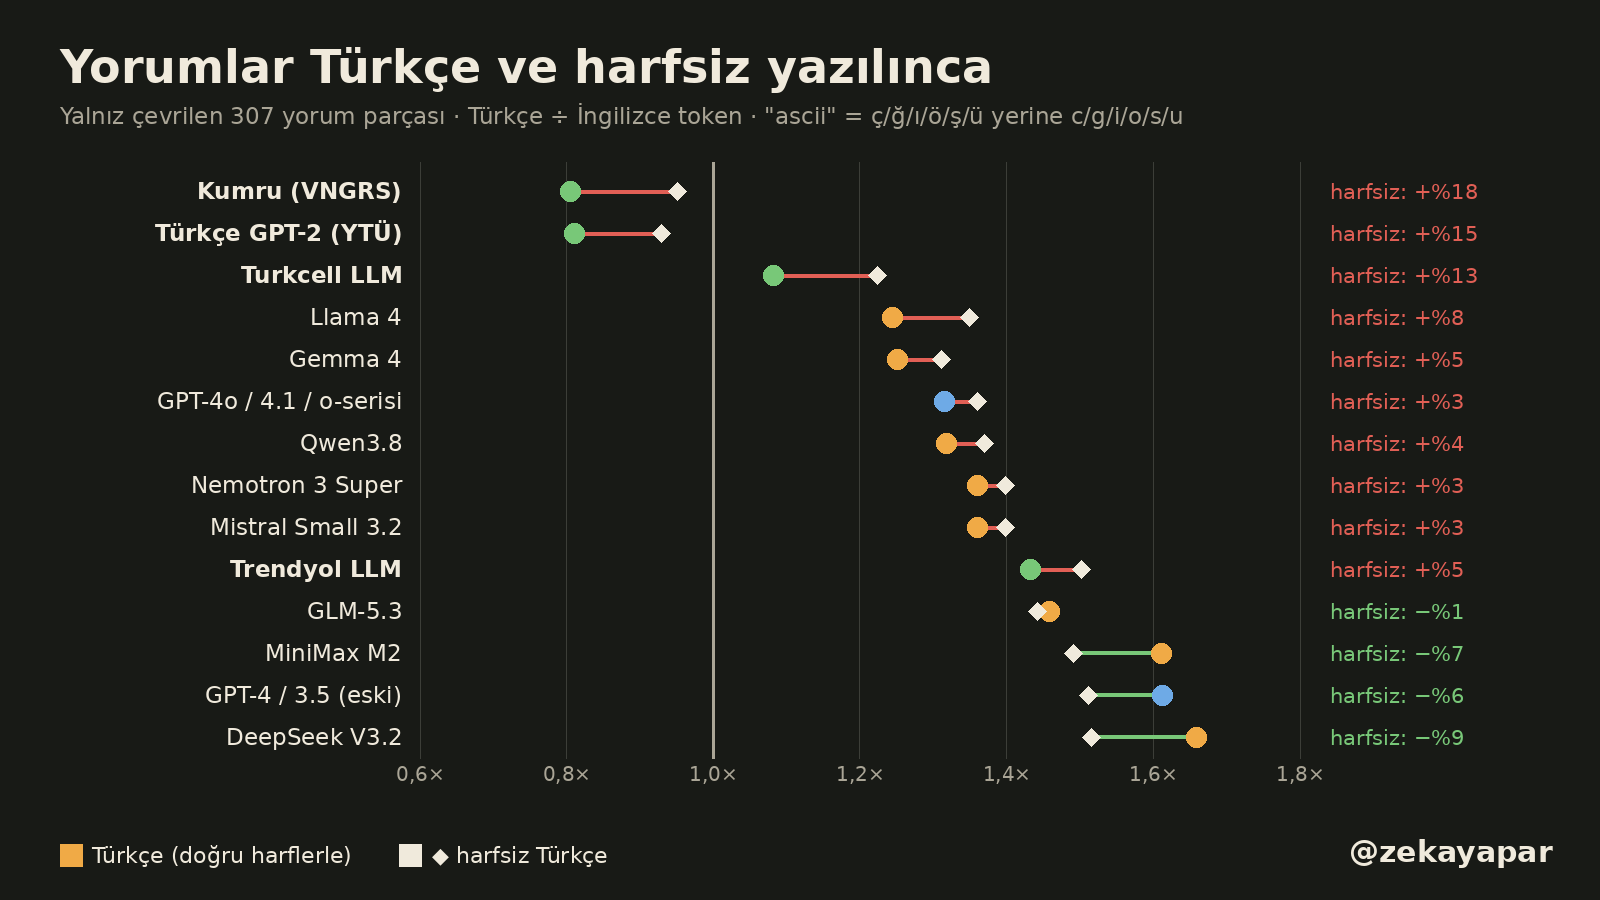
Birçok geliştirici koda Türkçe yorum yazarken ç, ğ, ı, ö, ş, ü harflerini kullanmıyor. Bunun token açısından işe yarayıp yaramadığını denedim: Aynı çevirilerde bu harfleri c, g, i, o, s, u’ya çevirip yeniden saydım. Sonuç modele göre değişti. GPT-4o’da harfsiz yazım daha pahalı çıktı: oran 1,32’den 1,36’ya çıktı. Qwen3.8, Llama 4, Gemma 4 ve Türkçe modellerin hepsinde de durum aynı. Bu sözlükler Türkçe kelimeleri doğru yazılışlarıyla öğrenmiş, “uygulamasiyla” onlara yabancı geliyor. Harfsiz yazımın kazandırdığı yerler eski GPT-4, DeepSeek, MiniMax ve GLM-5.3: Bunlarda Türkçe harfler zaten baytlara bölündüğü için harfleri düşürmek %1 ile %9 arası tasarruf sağlıyor.
Günlük kullanımda ne demek
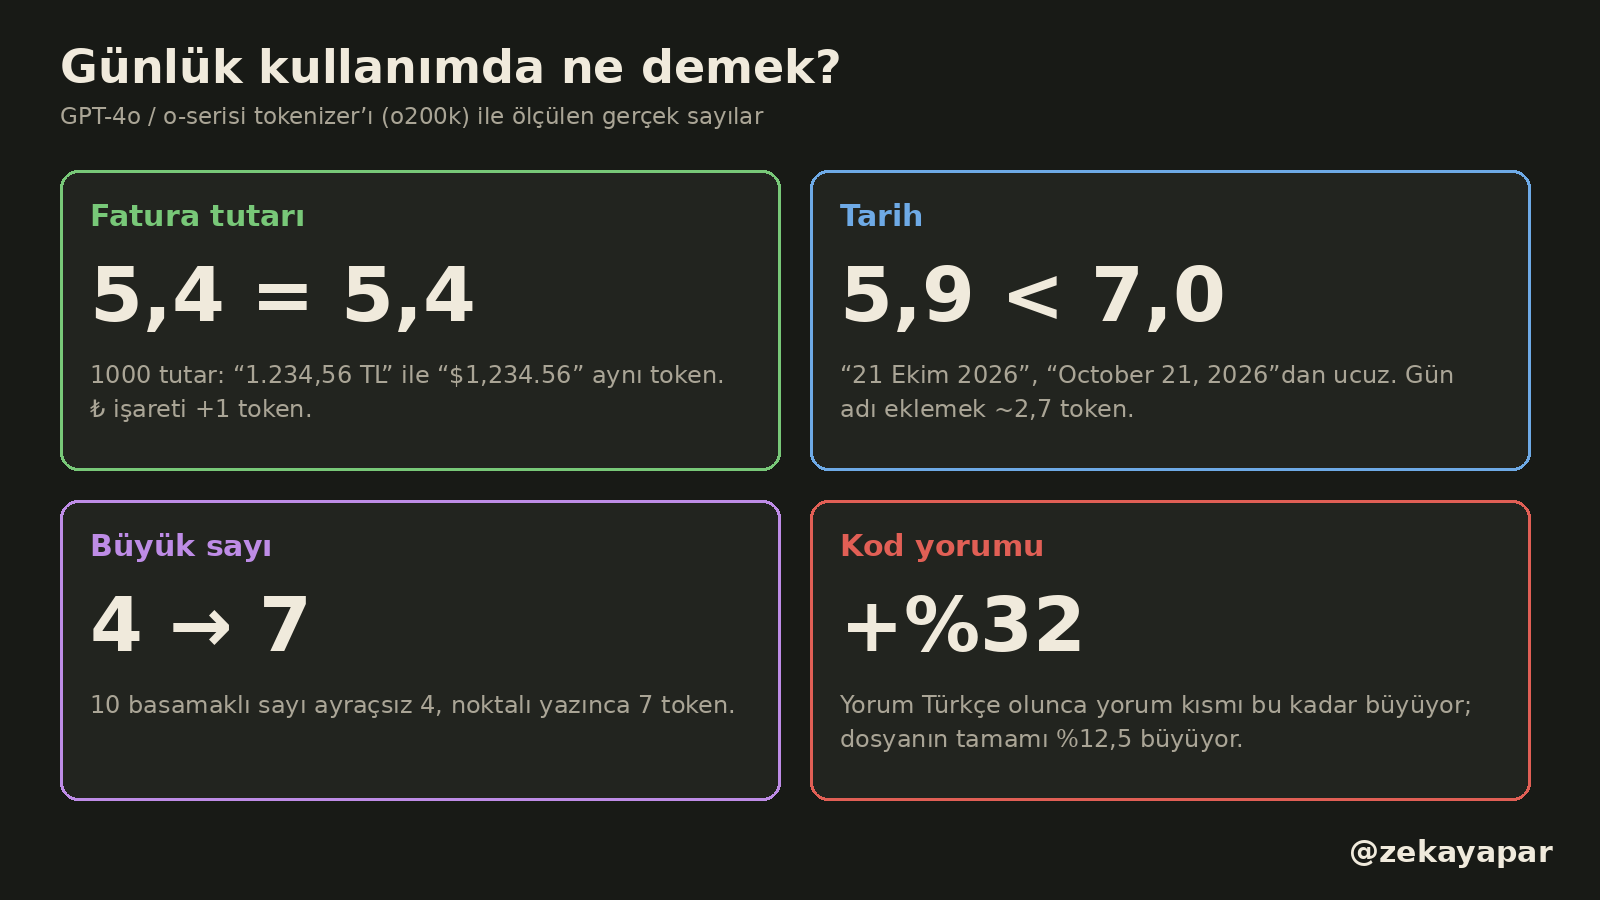
- Fatura, tablo, muhasebe verisi: Tutarları Türkçe biçimde vermenin bir maliyeti yok. Yalnız ₺ işareti her tutarda bir token ekliyor; binlerce satırlık bir tabloda
TLyazmak ya da para birimini sütun başlığına taşımak daha ucuz. - Tarihler:
21 Ekim 2026biçimi İngilizce uzun yazımdan ucuz. Gün adı gerekmiyorsa yazmamak her tarihte 2–3 token kazandırıyor. - Büyük sayılar: Modele ham veri veriyorsanız ayraçsız yazmak (
1234567) ayraçlı yazımdan belirgin şekilde daha az token tutuyor. Okunacak bir metinde ise bu fark önemsiz. - Kod: Faturayı Türkçe sayılar değil, Türkçe açıklamalar büyütüyor. Bol yorumlu bir kod tabanını modele verirken GPT-4o ailesinde yaklaşık %12, DeepSeek’te %26 fazla token beklemek gerekiyor.
Benim için sonuç
Önceki yazıdan sonra “Türkçe her yerde pahalı” diye düşünmeye başlamıştım. Bu ölçüm o düşünceyi daralttı: Sayı, tarih ve para tutarında Türkçe yazımın bedeli yok, tarihte avantajı bile var. Bedel kelimelerde ve onların ekli yapısında. Kendi kodumda yorumları Türkçe yazmaya devam edeceğim, çünkü fark kodu okuyacak kişi için harcanan birkaç bin token. Ama modele binlerce satırlık veri verirken ₺ işaretini ve sayı ayraçlarını kaldırmak denenmeye değer bir kestirme. Harfsiz Türkçe yazmak ise hangi modeli kullandığınıza bağlı: GPT-4o ve Qwen’de işe yaramıyor, tersine pahalandırıyor.
Sınırlar
- Kod çevirisini bir model yaptı, bir insan değil. Çeviriler akıcı ama birebir değil; bir insan çevirmen biraz daha kısa ya da uzun yazabilirdi. Ölçülen fark “bu modelin çevirisi” için geçerli.
- Kod örnekleri iki projeden geliyor (CPython ve lodash). Değişken adlarının Türkçe olduğu bir kod tabanını ölçmedim.
- Para, tarih ve sayı setleri gerçek belgelerden değil, biçimleri tek tek denemek için üretildi. Gerçek metindeki etki için FLORES karşılaştırmasına bakılabilir.
- Claude ve Gemini’nin tokenizer’ı açık değil, onlar için sayım yok. Sayımlar özel tokenlar olmadan yapıldı.
Tam tablo ve yöntem
| Tokenizer | TL / $ (tutar başına) | ₺ | 21 Ekim 2026 / October 21, 2026 | FLORES rakamsız / rakamlı | Kod dosyası TR/EN | Yorum TR/EN | Harfsiz yorum TR/EN |
|---|---|---|---|---|---|---|---|
| GPT-4o / 4.1 / o-serisi (o200k) | 5,38 / 5,38 | 6,38 | 5,92 / 7,00 | 1,45 / 1,35 | 1,125 | 1,316 | 1,361 |
| GPT-4 / 3.5 (cl100k) | 5,38 / 5,38 | 6,38 | 6,41 / 7,00 | 1,97 / 1,75 | 1,243 | 1,612 | 1,511 |
| gpt-oss | 5,38 / 5,38 | 6,38 | 5,92 / 7,00 | 1,45 / 1,35 | 1,125 | 1,316 | 1,361 |
| Qwen3.8 | 8,60 / 8,60 | 9,60 | 8,37 / 9,70 | 1,46 / 1,33 | 1,122 | 1,318 | 1,370 |
| GLM-5.3 Flash | 6,07 / 6,07 | 7,07 | 6,24 / 7,00 | 1,68 / 1,52 | 1,182 | 1,458 | 1,443 |
| DeepSeek V3.2 | 5,38 / 5,38 | 6,38 | 6,41 / 7,00 | 2,09 / 1,84 | 1,259 | 1,659 | 1,515 |
| Gemma 4 | 8,60 / 8,60 | 8,60 | 7,70 / 9,70 | 1,39 / 1,28 | 1,093 | 1,252 | 1,311 |
| Llama 4 | 5,38 / 5,38 | 6,38 | 5,00 / 7,00 | 1,33 / 1,24 | 1,097 | 1,244 | 1,350 |
| Mistral Small 3.2 | 8,60 / 8,60 | 9,60 | 7,70 / 9,70 | 1,54 / 1,36 | 1,141 | 1,361 | 1,399 |
| MiniMax M2 | 5,38 / 5,38 | 6,38 | 6,33 / 7,00 | 2,01 / 1,78 | 1,240 | 1,611 | 1,491 |
| Nemotron 3 Super | 8,60 / 8,60 | 9,60 | 7,70 / 9,70 | 1,53 / 1,35 | 1,141 | 1,360 | 1,398 |
| Kumru 2B (VNGRS) | 8,60 / 8,60 | 9,60 | 6,70 / 10,94 | 0,62 / 0,70 | 0,922 | 0,806 | 0,951 |
| Turkcell LLM 7B | 9,60 / 8,60 | 9,60 | 8,87 / 9,87 | 1,03 / 1,03 | 1,031 | 1,083 | 1,224 |
| Trendyol LLM 7B v4.1 | 8,60 / 8,60 | 8,60 | 8,21 / 9,70 | 1,67 / 1,47 | 1,171 | 1,432 | 1,501 |
| Türkçe GPT-2 (YTÜ Cosmos) | 6,21 / 6,21 | 6,21 | 4,00 / 6,49 | 0,61 / 0,67 | 0,927 | 0,810 | 0,929 |
Kaynaklar:
- CPython 3.14.0
Lib/(PSF lisansı): bisect, colorsys, fnmatch, glob, graphlib, heapq, queue, sched, shlex, textwrap - lodash-es 4.17.21 (MIT, npm, integrity
sha512-mKnC+QJ9…cxyw==): chunk, cloneDeep, debounce, get, isEqual, memoize, merge, set, template, throttle, truncate, words - FLORES-200 dev+devtest (CC BY-SA 4.0)
- Çevirmen: Qwen3.8-27B NVFP4 (yerel vLLM), temperature 0, düşünme kapalı, 326 istek
Tokenizer’lar:
- GPT-4o / 4.1 / o-serisi (o200k):
tiktoken 0.14.0 o200k_base - GPT-4 / 3.5 (cl100k):
tiktoken 0.14.0 cl100k_base - gpt-oss:
yerel gpt-oss-120b· SHA2560614fe83cada - Qwen3.8:
yerel Qwen3.8 NVFP4 snapshot 482ca0f· SHA2560997f410c57a - GLM-5.3 Flash:
huggingface.co/zai-org/GLM-5.3-Flash@46a050bec130· SHA25619e773648cb4 - DeepSeek V3.2:
huggingface.co/deepseek-ai/DeepSeek-V3.2@a7e62ac04ecb· SHA256cd050be35cae - Gemma 4:
huggingface.co/google/gemma-4-31b-it@842da3794eaa· SHA256cc8d3a0ce364 - Llama 4:
huggingface.co/unsloth/Llama-4-Scout-17B-16E-Instruct@afd8e498c87b· SHA256172c9eb4beaf - Mistral Small 3.2:
huggingface.co/unsloth/Mistral-Small-3.2-24B-Instruct-2506@3ed8d341b53e· SHA25623ad081f384b - MiniMax M2:
huggingface.co/MiniMaxAI/MiniMax-M2@757303d492a5· SHA256757622126525 - Nemotron 3 Super:
yerel nvidia-nemotron-3-super-120b-a12b-nvfp4· SHA256623c34567aeb - Kumru 2B (VNGRS):
huggingface.co/vngrs-ai/Kumru-2B@0b3cf37f657e· SHA2561f00b5bbea83 - Turkcell LLM 7B:
huggingface.co/TURKCELL/Turkcell-LLM-7b-v1@c84d2a719b90· SHA256126525bc4fa6 - Trendyol LLM 7B v4.1:
huggingface.co/Trendyol/Trendyol-LLM-7B-chat-v4.1.0@8d8006bc6584· SHA2569c5ae00e602b - Türkçe GPT-2 (YTÜ Cosmos):
huggingface.co/ytu-ce-cosmos/turkish-gpt2-large@c4ddd0f3808f· SHA256d9b4c033b96a
Yöntem ayrıntıları: Para ve tarih değerleri tutar/tarih başına ortalama. Kod oranı = 22 dosyanın toplam tokenı; yorum oranı yalnız çevrilen 307 parçanın tokenı. Yorumsuz sürüm, yorum metni silinip işaretleri bırakılarak üretildi. Sayımlar özel tokenlar olmadan yapıldı. Ortam: tokenizers 0.23.3, tiktoken 0.14.0, Threadripper PRO 5955WX, GPU yalnız çeviri için.
İndir: sayım sonuçları (JSON) · yorum parçası sonuçları · dosya bazında sayımlar (CSV) · örnek bölünmeler · sunucu kontrolü · betikler, ham çeviriler ve Türkçe yorumlu dosyalar (ZIP)