 zekayapar
Türkçe yazınca yapay zekâ daha mı pahalı?
Aynı 2009 cümleyi Türkçe ve İngilizce olarak 14 modelin tokenizer’ından geçirdim: fatura, bağlam ve bekleme süresine etkisi.
Ölçüm
- FLORES-200 · 2009 paralel cümle · Türkçe ve İngilizce
- 14 tokenizer · Hugging Face tokenizers 0.23 · tiktoken 0.14
- GPU gerekmedi · CPU üzerinde sayım
Sunucu kontrolü
- Qwen3.8-27B NVFP4 · vLLM · RTX 5090
- usage.prompt_tokens = yerel sayım (6.181 / 4.495)
Yapay zekâ modelleri metni harf harf ya da kelime kelime değil, token denen parçalar halinde okuyor. API faturası bu parçaların sayısıyla kesiliyor, modelin aklında tutabildiği metin de token ile ölçülüyor, cevabın yazılma hızı da saniyede kaç token ürettiğine bağlı. Türkçe soru sorduğumda bunun aleyhime işlediğinden hep şüpheleniyordum. Bu kez ölçtüm.
Kısa cevap: evet, aynı içerik Türkçe yazılınca çoğu modelde yüzde 30 ile yüzde 100 arası daha fazla token tutuyor. OpenAI’ın GPT-4o ailesinde fark 1,43 kat. Türkçe için eğitilmiş küçük modellerde ise tablo tersine dönüyor.
Nasıl ölçtüm
Kendi yazdığım iki metni karşılaştırsaydım sonuç benim çeviri tarzıma bağlı olurdu. Bu yüzden Meta’nın çeviri araştırmaları için hazırladığı FLORES-200 setini kullandım. İngilizce Wikinews, Wikijunior ve Wikivoyage’dan alınmış 2009 cümle, profesyonel çevirmenlerce birçok dile çevrilmiş. Yani elimde aynı anlamı taşıyan 2009 İngilizce ve 2009 Türkçe cümle var.
Bu cümleleri 14 farklı modelin tokenizer’ından, yani metni parçalara ayıran bölümünden geçirip saydım. Model çalıştırmaya gerek yok; tokenizer’lar modellerin yanında yayımlanan küçük dosyalar. Bilgisayarımda yerelde çalışan Qwen3.8 sunucusuna da aynı metni gönderip sunucunun faturaya yazacağı token sayısının benim sayımımla birebir aynı çıktığını kontrol ettim (6.181 ve 4.495 token, iki tarafta da aynı).
Bir not: Claude ve Gemini’nin tokenizer’ları açık değil; onları bu yöntemle ölçemedim, tabloda da yoklar.
Sonuç: model değişince fark da değişiyor
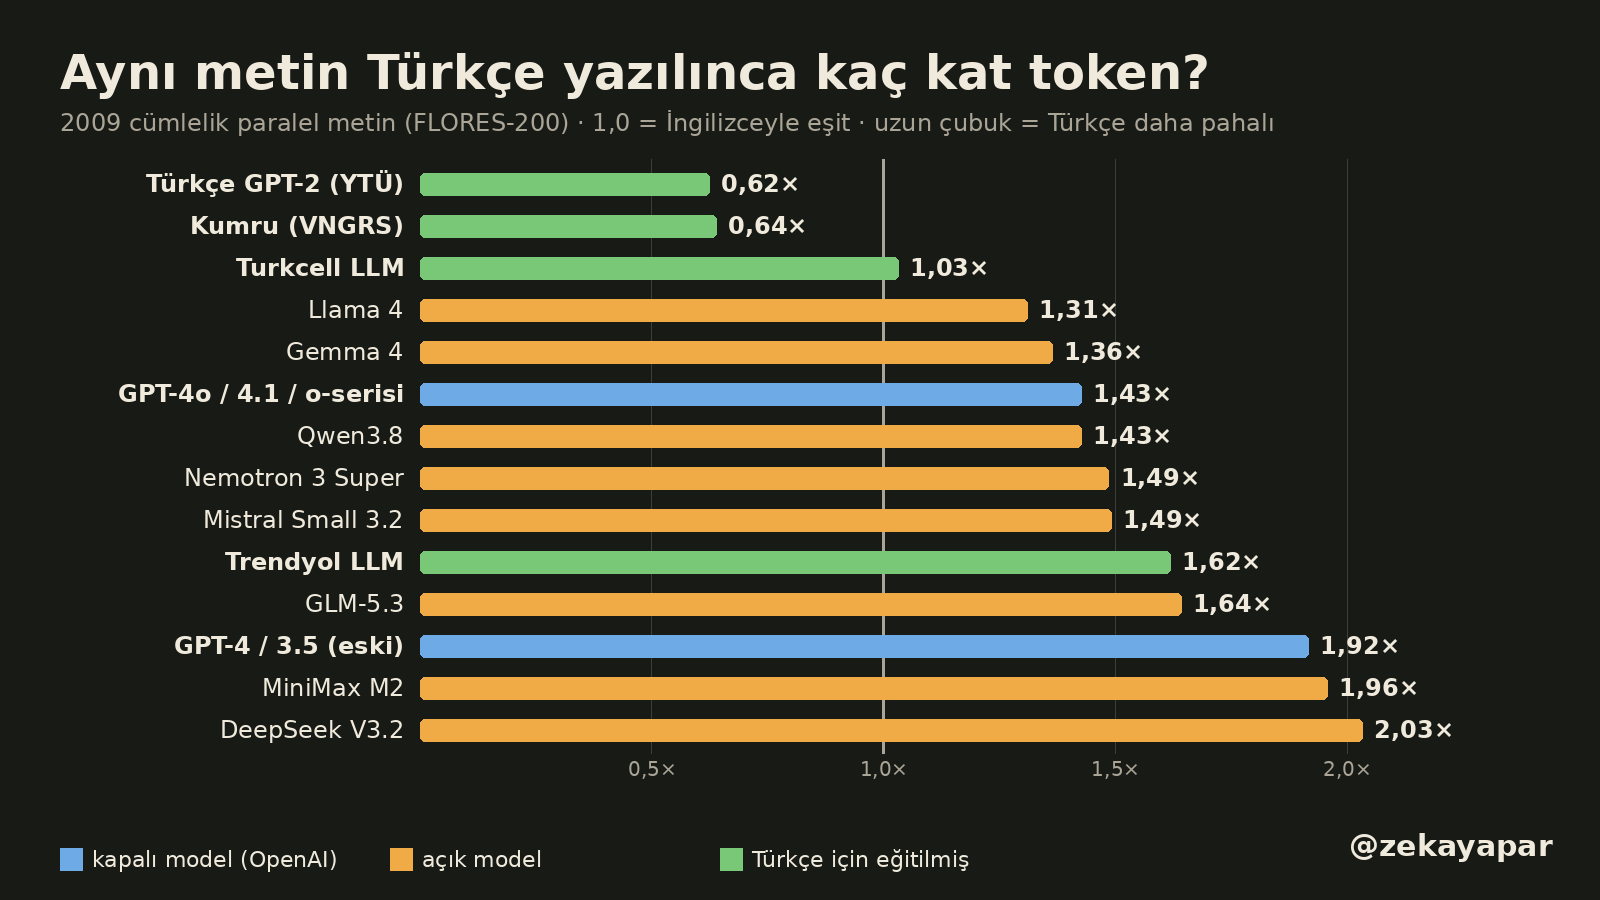
En pahalı taraf DeepSeek V3.2 (2,03×) ve MiniMax M2 (1,96×). Aynı soruyu Türkçe sorduğumda bu modeller iki katına yakın token sayıyor. OpenAI’ın eski GPT-4 ve GPT-3.5 tokenizer’ı da 1,92× ile bu grupta. OpenAI’ın GPT-4o ile getirdiği yeni tokenizer farkı 1,43× seviyesine indirmiş; yani Türkçe kullanıcı için sessiz ama ciddi bir indirim olmuş.
Açık modellerde en iyi sonucu Llama 4 (1,31×) ve Gemma 4 (1,36×) verdi. Benim her gün kullandığım Qwen3.8 GPT-4o ile aynı yerde, 1,43×. GLM-5.3’te bu oran 1,64×.
Türkçe için eğitilmiş modellere bakınca durum tersine dönüyor. Turkcell’in modeli iki dili neredeyse eşit sayıyor (1,03×). VNGRS’in Kumru’su ve YTÜ’nün Türkçe GPT-2’si ise Türkçeyi İngilizceden daha az tokenla yazıyor (0,64× ve 0,62×); çünkü sözlükleri baştan Türkçe metinle kurulmuş, İngilizce bu kez onlar için “yabancı dil”. Trendyol’un modeli ise Türkçe eğitilmiş olsa da Qwen2 mimarisinde ve Qwen ailesinin 151 bin parçalık sözlüğünü kullanıyor; bu yüzden 1,62× ile genel modellerin arasında kalıyor.
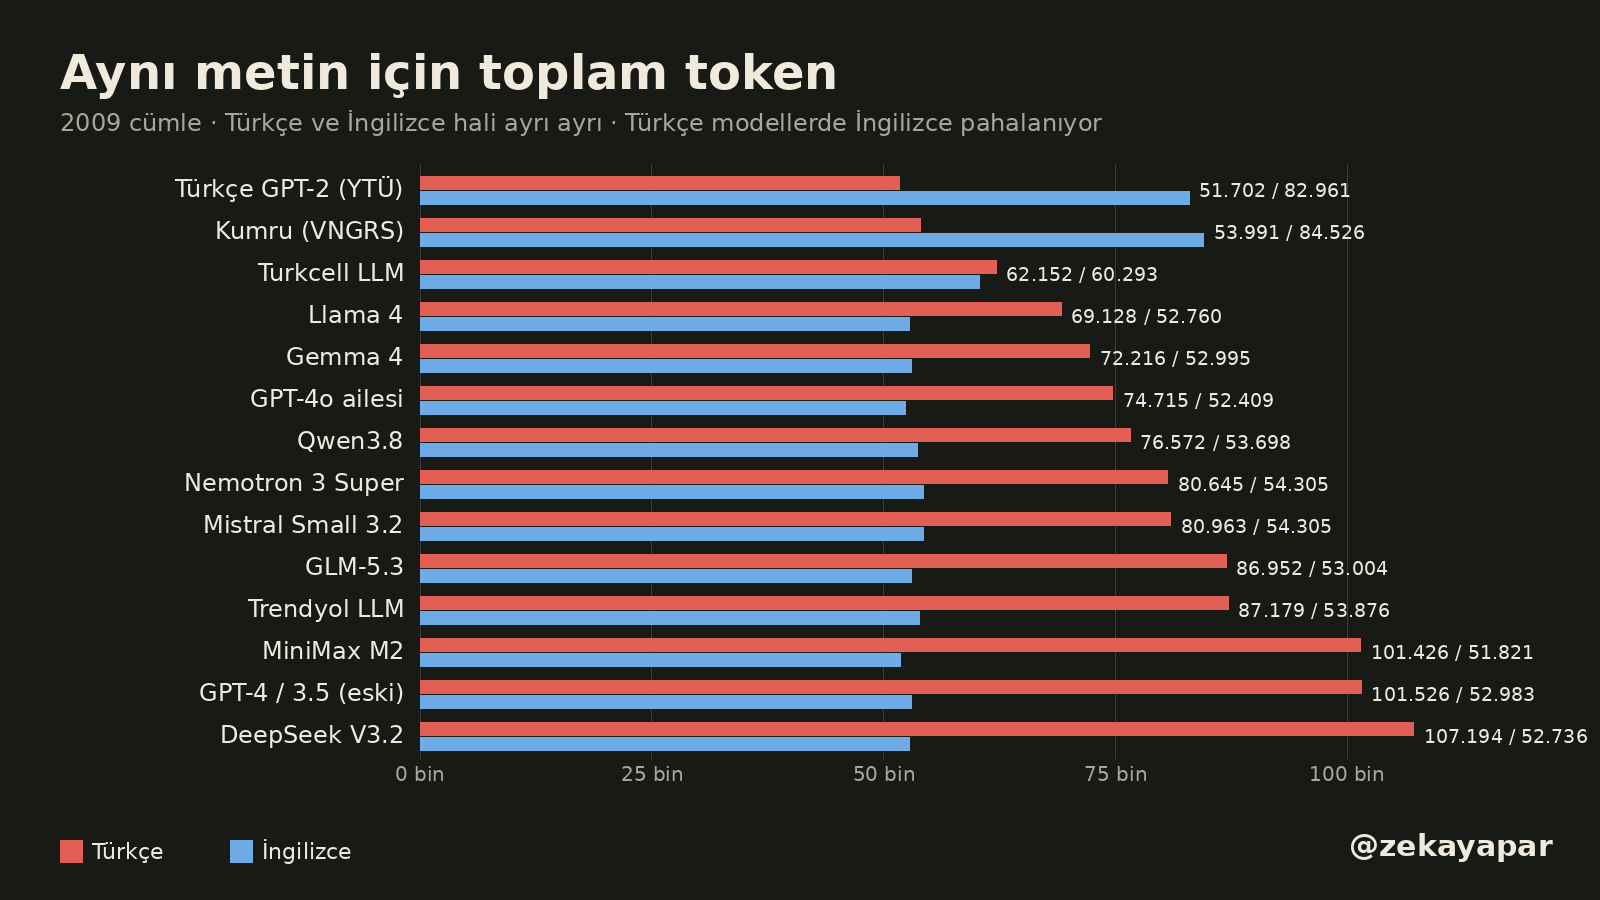
Aynı tabloyu iki dilin toplamlarıyla görünce durum daha net: genel modellerde İngilizce çubuklar hep yaklaşık 52–54 bin token civarında sabit kalırken, Türkçe çubuk modelden modele 69 bin ile 107 bin arasında değişiyor. Türkçe modellerde ise İngilizce çubuk uzuyor.
Neden böyle oluyor
Tokenizer’ın sözlüğü eğitim verisinde sık geçen parçalardan kuruluyor. İngilizce verinin çok olduğu modellerde “thank you” gibi bir ifade bir iki parça tutarken, Türkçe kelimeler daha küçük parçalara bölünüyor. Türkçenin eklemeli yapısı bunu büyütüyor: tek bir kelimeye eklenen her ek, sözlükte yoksa ayrı bir parça oluyor.
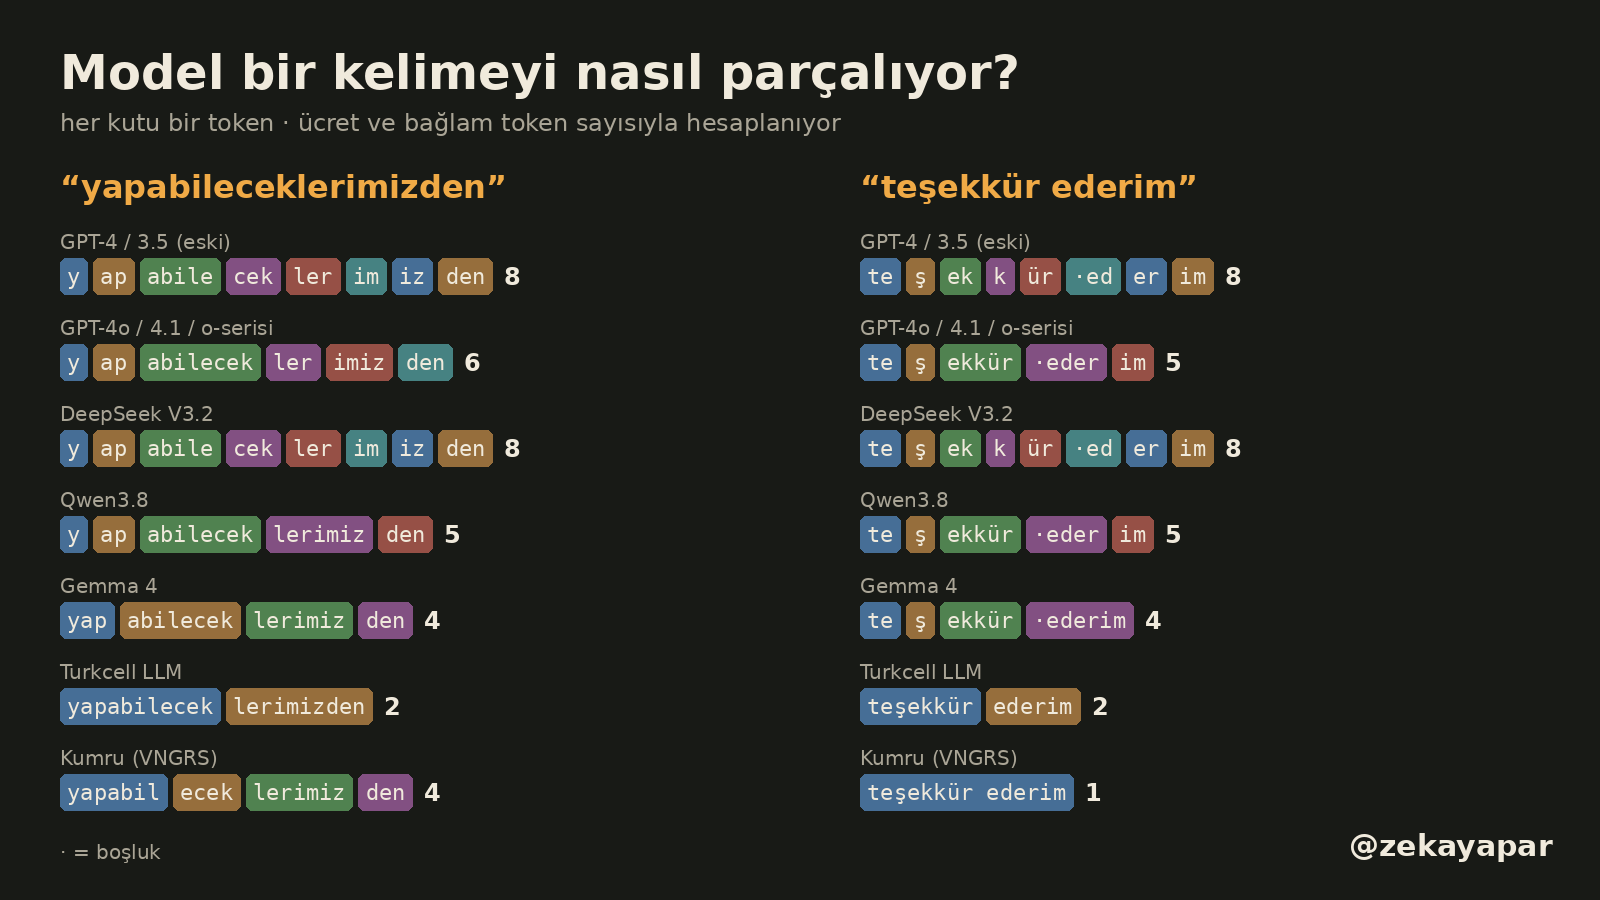
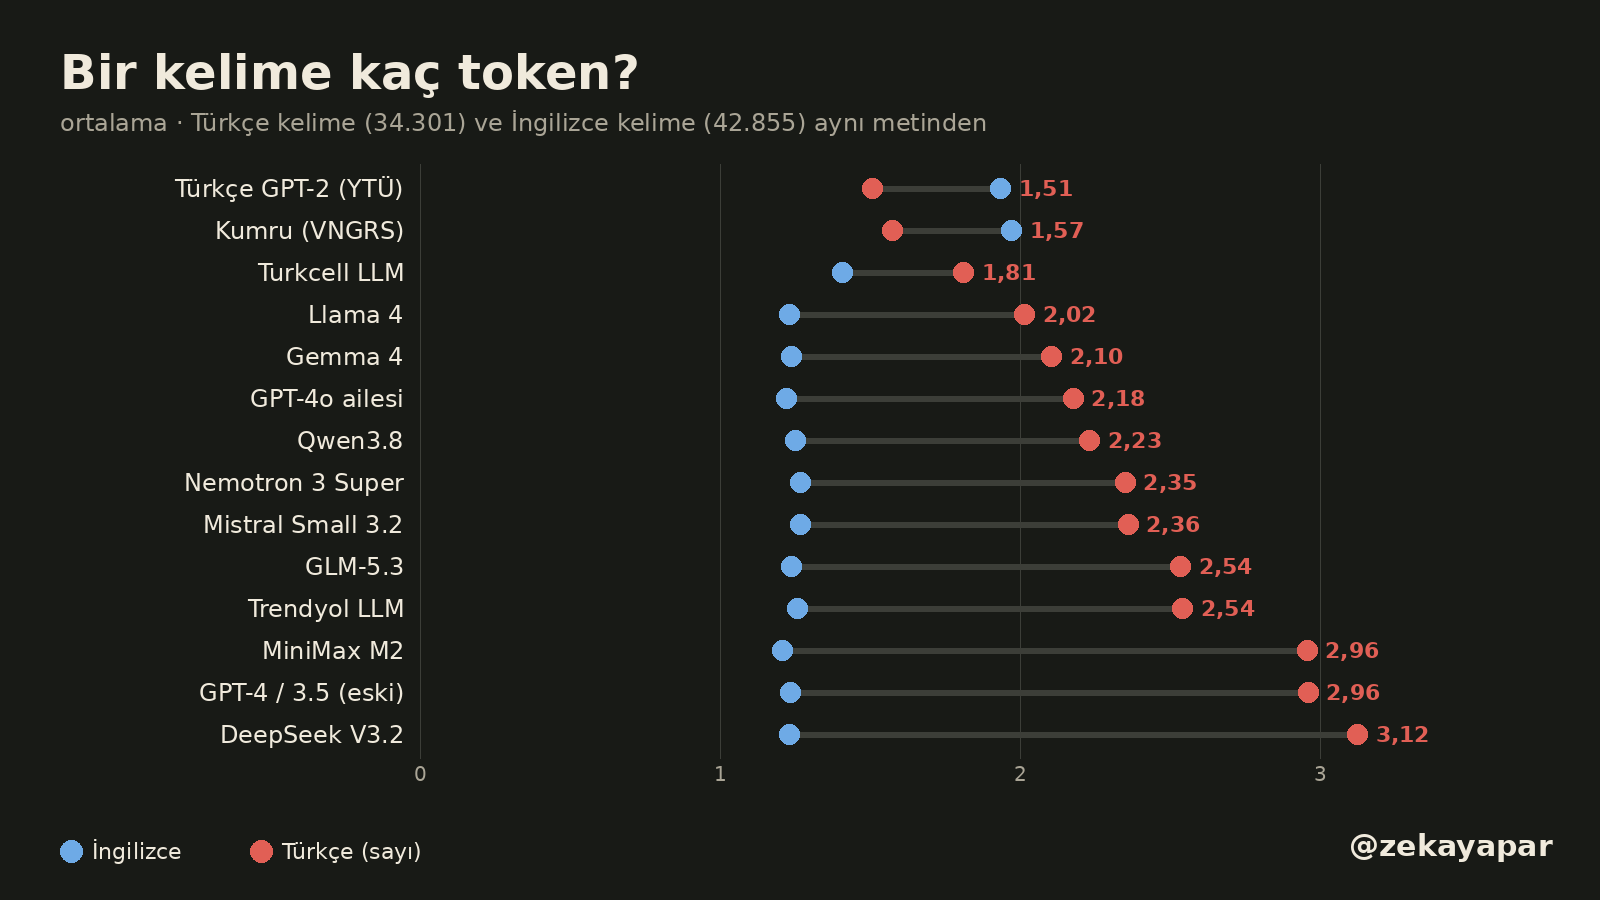
“yapabileceklerimizden” kelimesini eski GPT-4 ve DeepSeek sekiz parçaya bölüyor, Turkcell’in modeli iki parçada bitiriyor. Kelime başına ortalamada GPT-4o Türkçede 2,18, İngilizcede 1,22 token kullanıyor. Türkçe metin daha az kelimeyle yazılıyor (34.301 kelimeye karşı 42.855) ama her kelime daha çok parçaya bölündüğü için toplam yine Türkçe aleyhine çıkıyor. Karakter sayıları ise neredeyse aynı (264.373 ve 257.160).
Birkaç gerçek cümlede fark şöyle görünüyor (GPT-4o ailesinin tokenizer’ı ile):
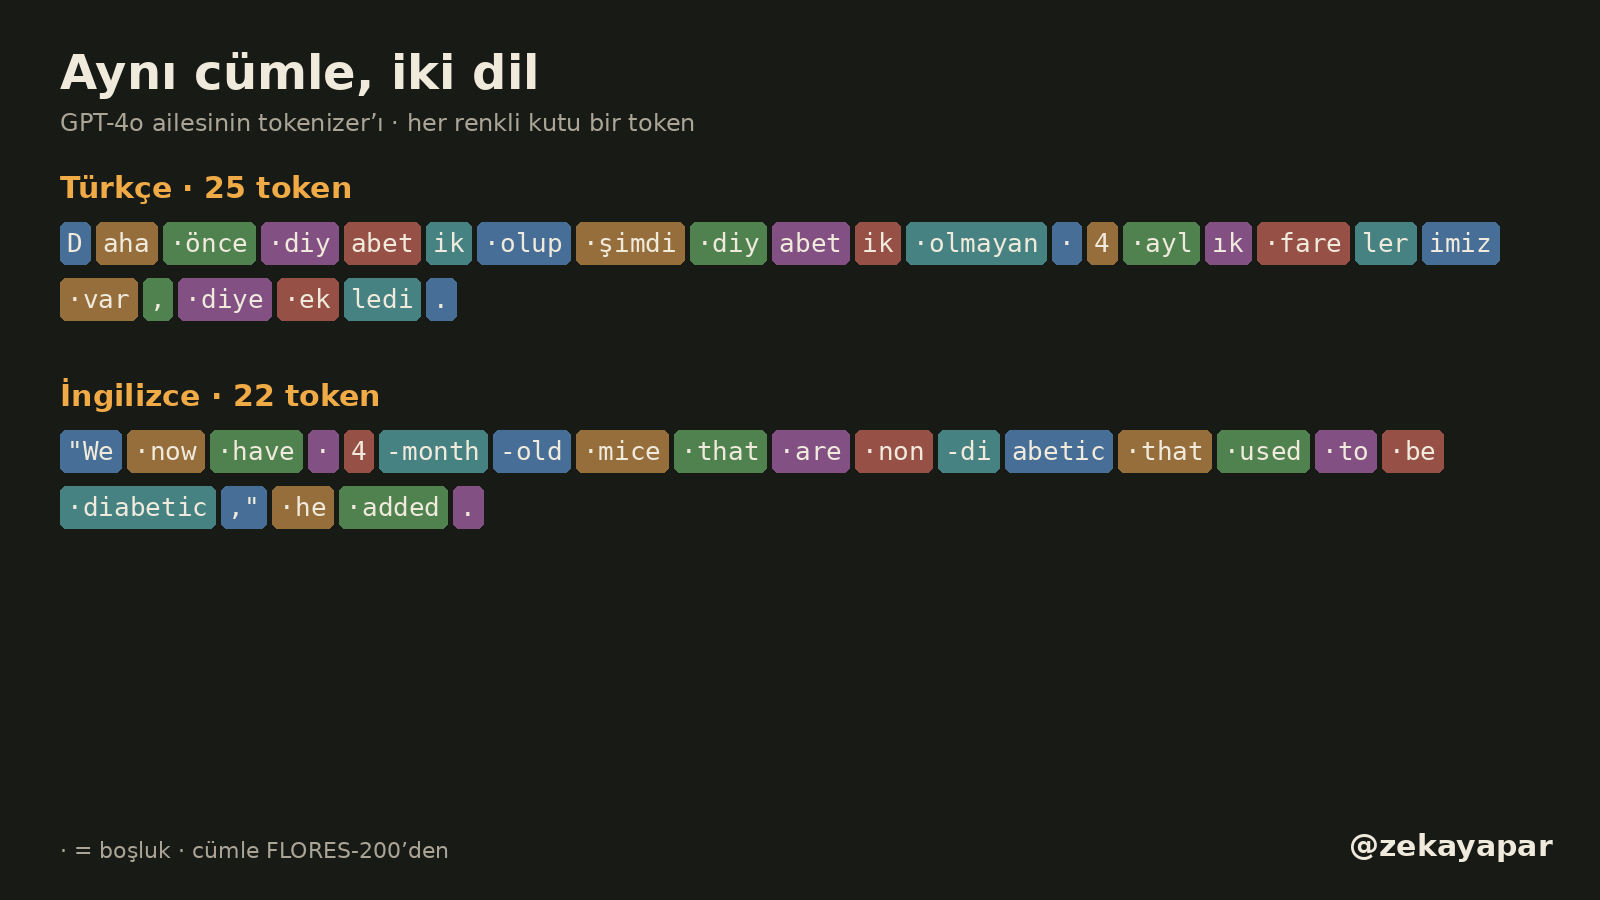
Daha önce diyabetik olup şimdi diyabetik olmayan 4 aylık farelerimiz var, diye ekledi. — 25 token
"We now have 4-month-old mice that are non-diabetic that used to be diabetic," he added. — 22 token
28 yaşındaki Vidal, üç sezon önce Sevilla'dan Barça'ya transfer olmuştu. — 19 token
28-year-old Vidal had joined Barça three seasons ago, from Sevilla. — 14 token
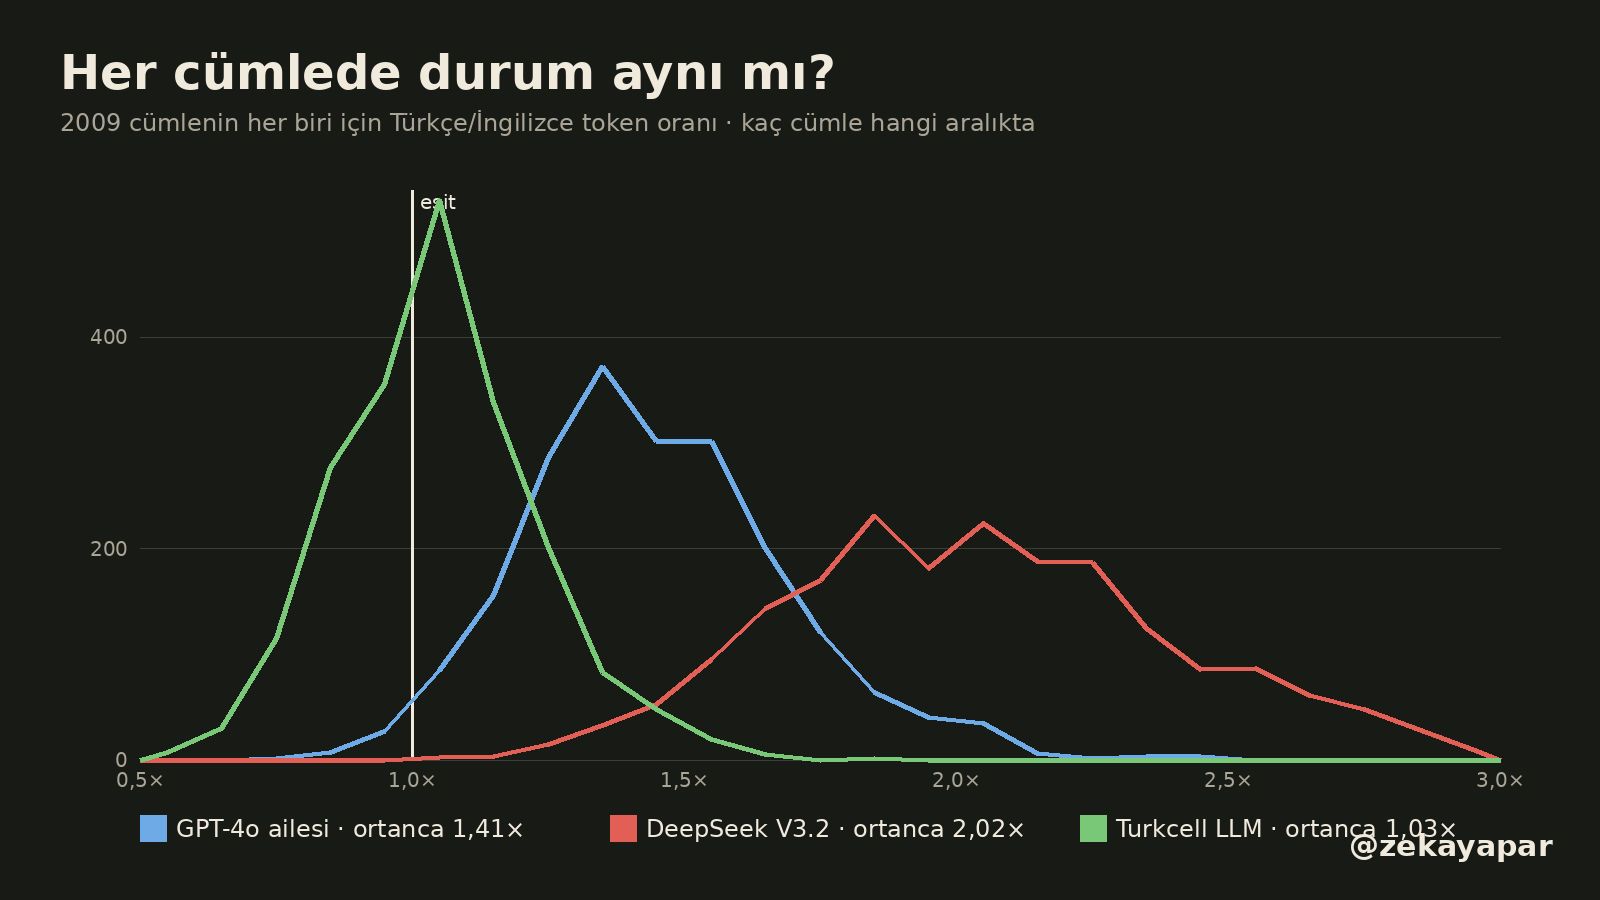
Bu tek tük örneklerin değil, genel bir eğilimin parçası. GPT-4o ailesinde cümlelerin yüzde 97’sinde Türkçe hali daha fazla token tuttu. Her cümle için oranı tek tek hesaplayıp dağılımına bakınca üç farklı tablo çıkıyor: Cümlelerin yüzde 80’i GPT-4o’da 1,16 ile 1,75 kat, DeepSeek’te 1,59 ile 2,58 kat arasında kalıyor. Turkcell’in modelinde ise dağılım tam “eşit” çizgisinin üstünde duruyor.
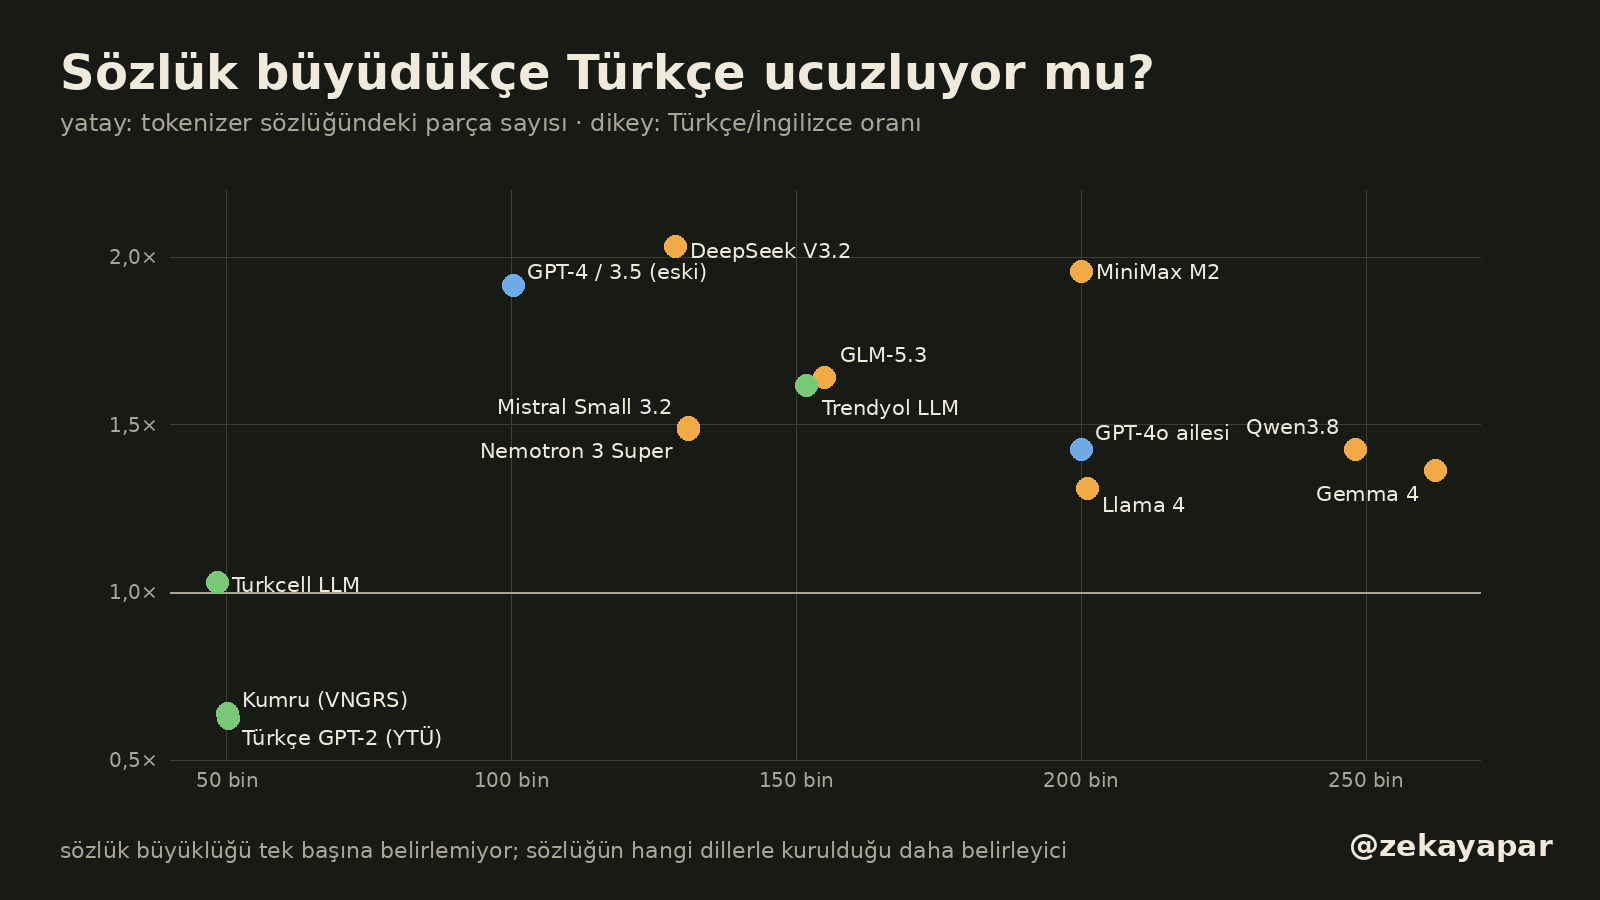
Peki sözlüğü büyük olan model Türkçede daha mı iyi? Kısmen. GPT-4’ten GPT-4o’ya geçişte sözlük 100 binden 200 bine çıkınca oran 1,92’den 1,43’e indi. Ama MiniMax M2’nin sözlüğü de 200 bin parça ve oranı 1,96. Turkcell’in sözlüğü ise yalnızca 48 bin parça ve oranı 1,03. Belirleyici olan sözlüğün büyüklüğünden çok, kurulurken ne kadar Türkçe metin gördüğü.
Türkçe karakterleri kullanmasam?
Aklıma ilk gelen kestirme buydu: ç, ğ, ı, ö, ş, ü yerine c, g, i, o, s, u yazarsam ucuzlar mı? Aynı 2009 cümleyi harfleri değiştirerek tekrar saydım.
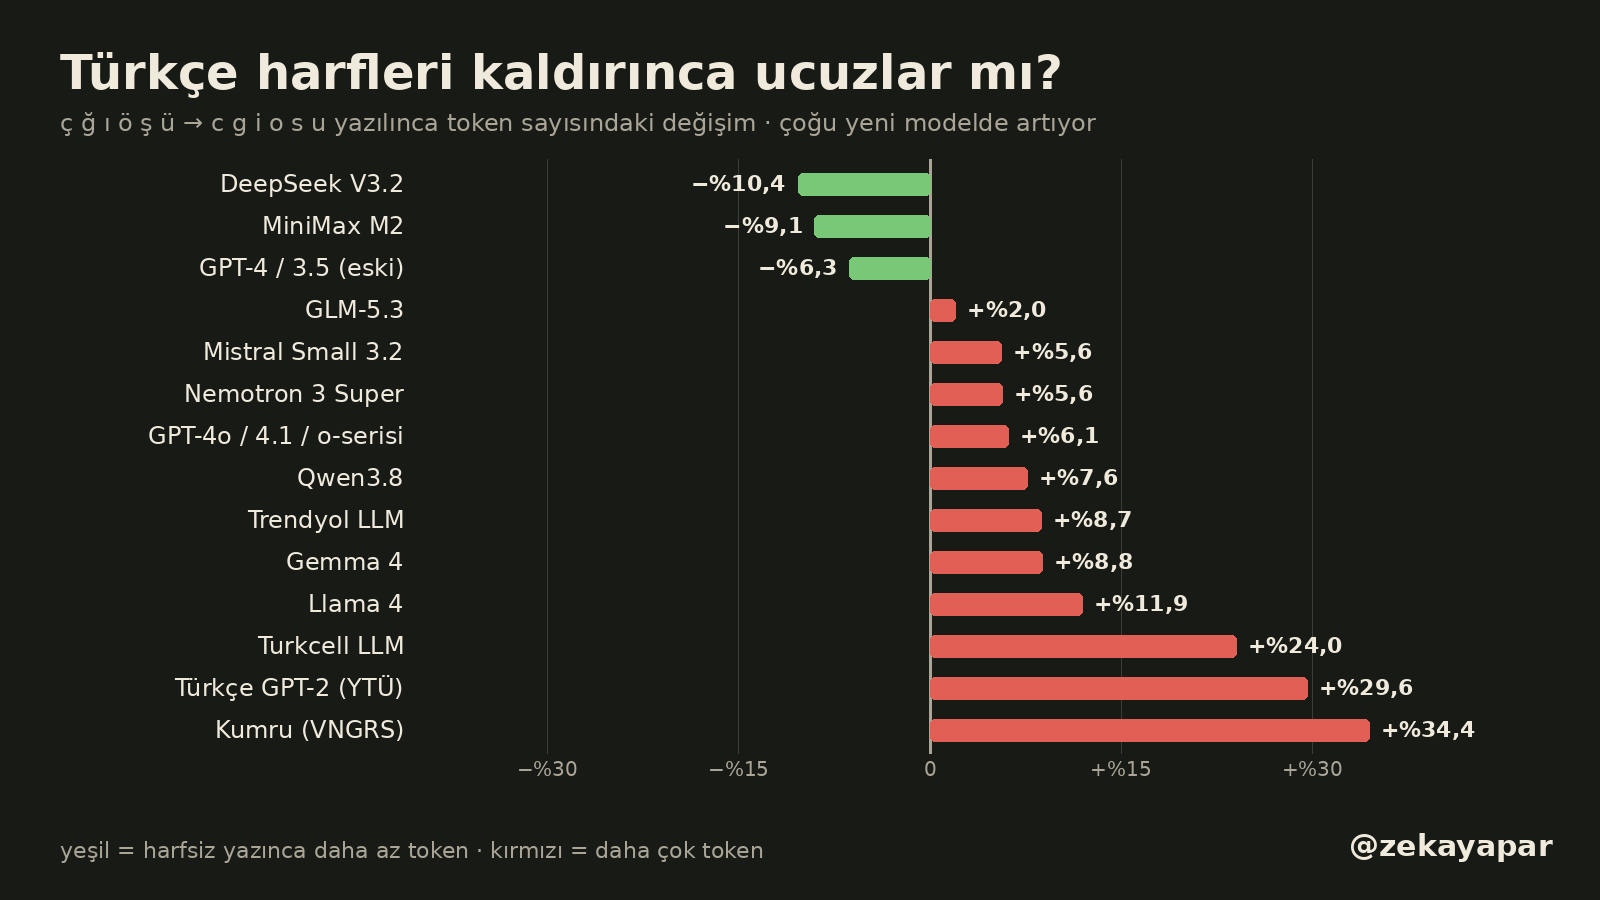
Yalnızca birkaç tokenizer’da işe yarıyor: DeepSeek’te yüzde 10, MiniMax’te yüzde 9, eski GPT-4’te yüzde 6 kazanç var. Yeni modellerin çoğunda tersine token sayısı artıyor; GPT-4o’da yüzde 6, Gemma 4’te yüzde 9. Bu modellerin sözlüğünde doğru yazılmış Türkçe parçalar var; harfleri değiştirilmiş yazım sözlükte daha az karşılık bulduğu için toplamda daha çok parçaya bölünüyor. Tek tek kelimelerde sonuç değişebiliyor, 2009 cümlenin toplamında ise bu yönde. Türkçe modellerde artış yüzde 24–34’e çıkıyor. Kısacası düzgün Türkçe yazmak hem anlam hem maliyet açısından daha iyi.
Günlük kullanımda ne demek
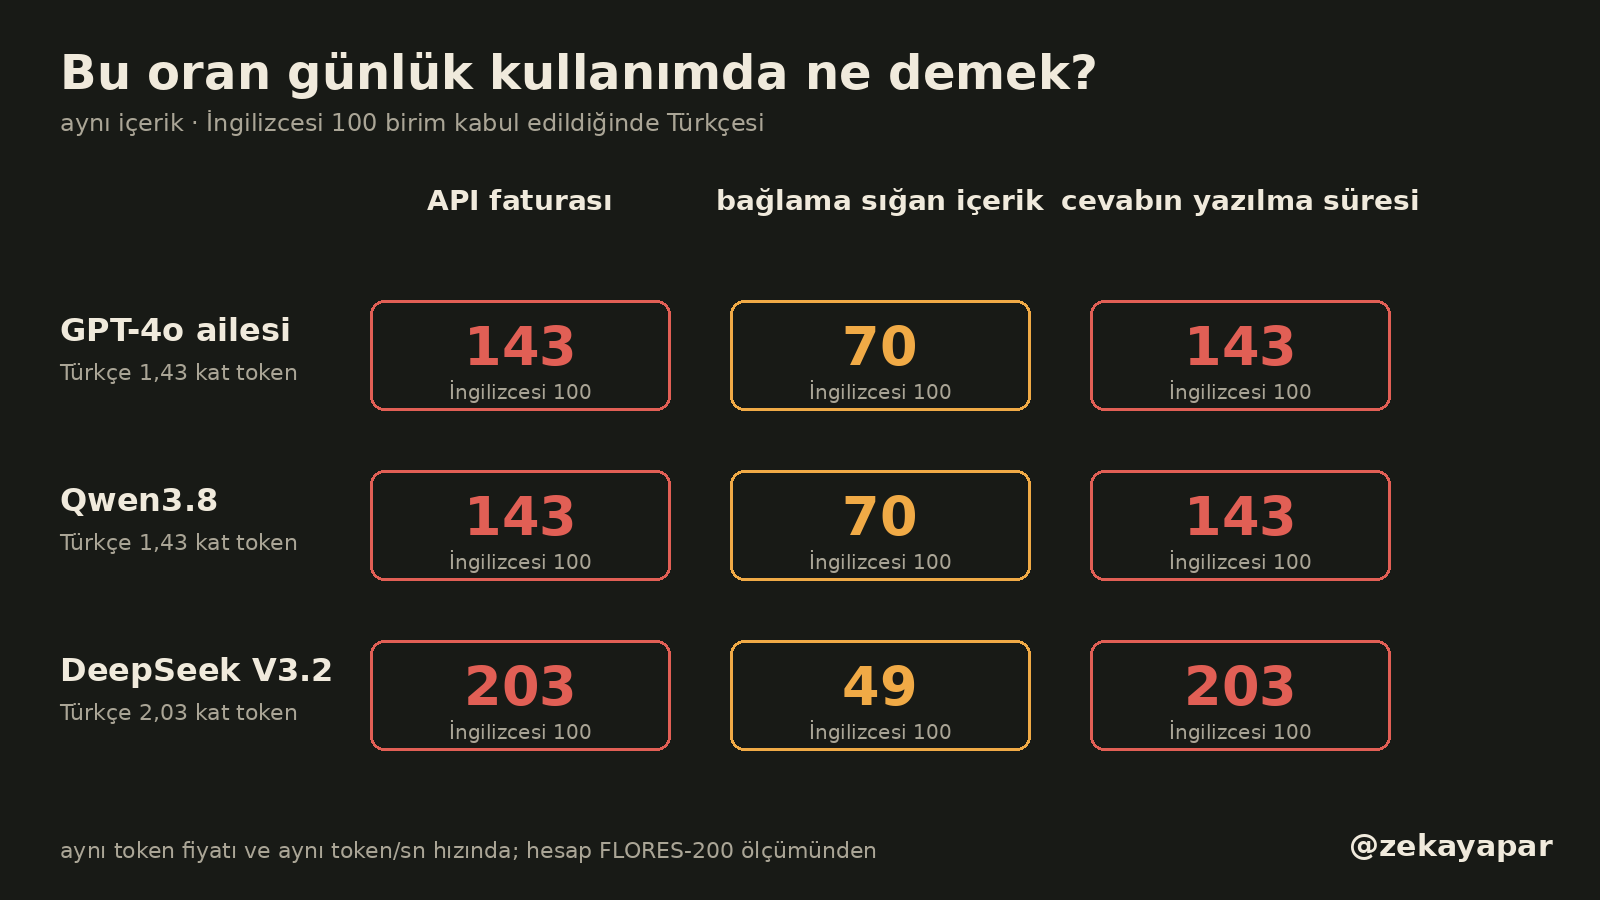
Bu oranı üç şeye çevirebiliriz. Bunlar ölçtüğüm token oranından yaptığım hesaplar; fiyat ve hız aynı kabul edildiğinde geçerli:
- Fatura: Token başına ücret alan bir API’de aynı iş Türkçe yapılınca GPT-4o ailesinde yaklaşık yüzde 43, DeepSeek V3.2’de yaklaşık iki kat ödeniyor. Bu hem sorulan soru hem gelen cevap için geçerli.
- Bağlam: Modelin aynı anda okuyabildiği metin token ile sınırlı. 128 bin token’lık bir bağlama İngilizce 100 sayfa sığıyorsa Türkçe aynı içerikten GPT-4o’da yaklaşık 70, DeepSeek’te 49 sayfa sığıyor.
- Bekleme: Model saniyede belli sayıda token üretiyor. Aynı cevabın Türkçesi daha çok token olduğu için, aynı hızda yazılması da o kadar uzun sürüyor. Yerelde çalıştırınca bu fark faturaya değil, bekleme süresine yansıyor.
Bağlam tarafını somut bir örnekle görmek için 8 bin token’lık bir bütçeye kaç cümle sığdığını hesapladım. Ortalama FLORES cümlesiyle GPT-4o ailesinde 220 Türkçe cümleye karşılık 314 İngilizce cümle, DeepSeek V3.2’de 154 Türkçe cümleye karşılık 312 İngilizce cümle sığıyor.
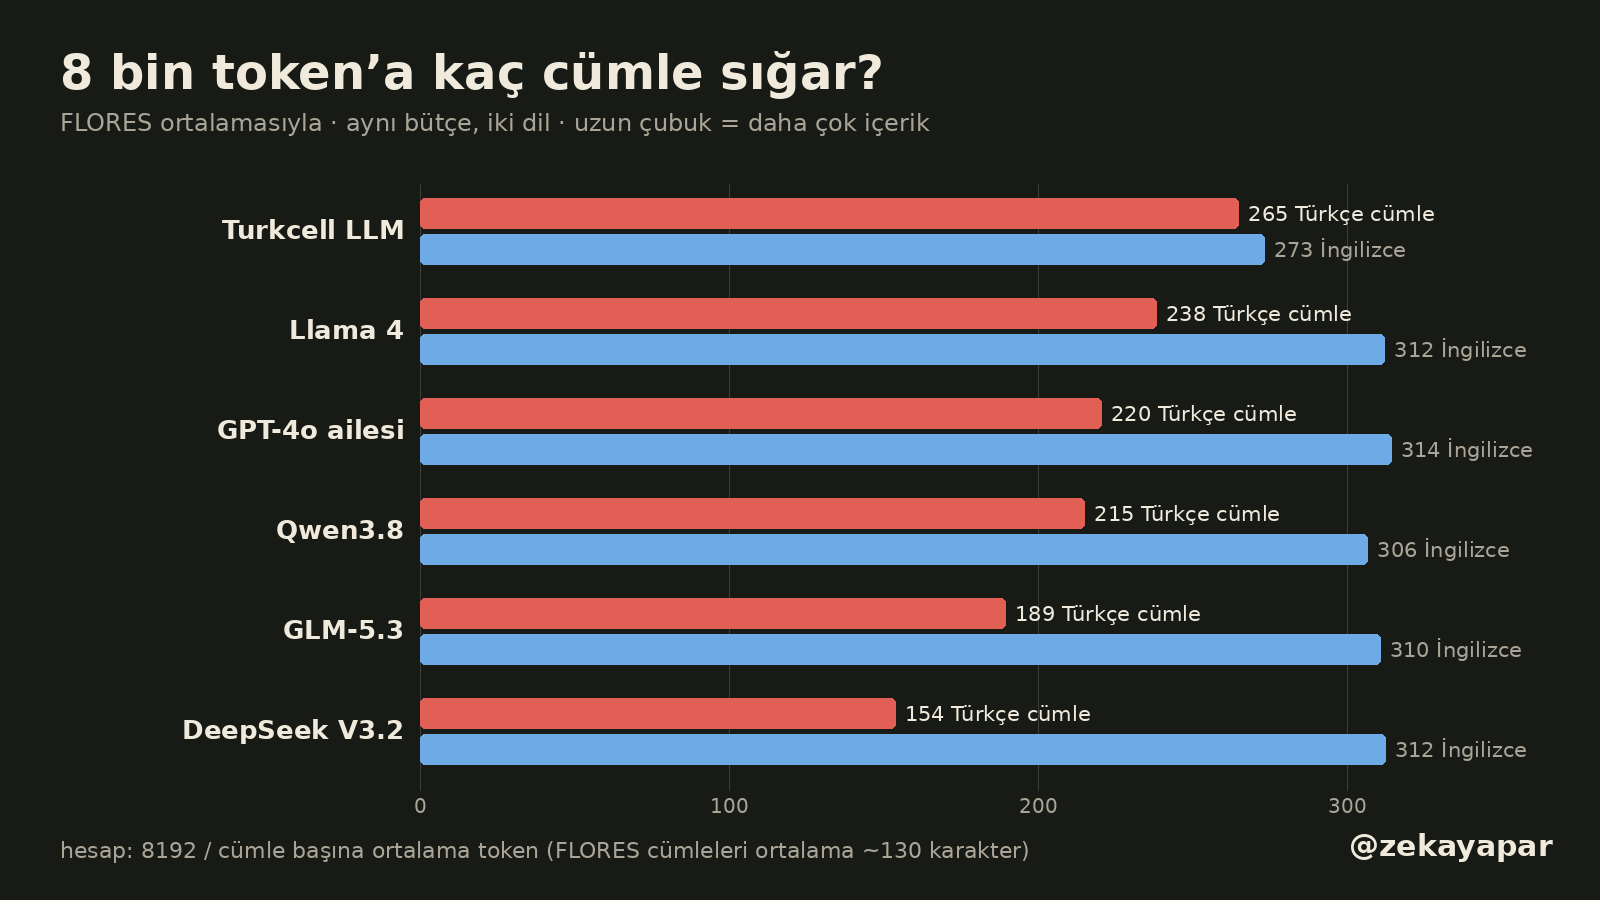
Model fiyatları farklı olduğu için bu oran tek başına “en ucuz model” sıralaması değil. Token başı fiyatı düşük bir model, Türkçe cezasına rağmen yine ucuz kalabilir. Ama aynı modelin Türkçe ve İngilizce kullanımını karşılaştırırken bu fark doğrudan faturaya yansıyor.
Benim için sonuç
Bu ölçümden çıkardığım pratik sonuç şu: uzun belgelerle ve sık tekrarlanan isteklerle çalışırken model seçiminde Türkçe oranına bakmak işe yarar. Sistem talimatları ve örnekler gibi her istekte yeniden gönderilen kısımları İngilizce yazıp cevabı Türkçe istemek bir orta yol olabilir; bunun cevap kalitesini nasıl etkilediğini ayrıca denemek gerekir. Türkçe harfleri bozmak ise yeni modellerin çoğunda işe yaramıyor.
Bu ölçüm yalnızca token sayısı. Modelin Türkçeyi ne kadar iyi anladığını ya da yazdığını ölçmüyor; Türkçede az token kullanan bir model daha iyi cevap veriyor demek değil.
Tam tablo ve yöntem
| Tokenizer | Tür | Türkçe token | İngilizce token | Oran | Türkçe token/kelime | Harfsiz yazınca |
|---|---|---|---|---|---|---|
| Türkçe GPT-2 (YTÜ Cosmos) | Türkçe model | 51.702 | 82.961 | 0,62× | 1,51 | +%29,6 |
| Kumru 2B (VNGRS) | Türkçe model | 53.991 | 84.526 | 0,64× | 1,57 | +%34,4 |
| Turkcell LLM 7B | Türkçe model | 62.152 | 60.293 | 1,03× | 1,81 | +%24,0 |
| Llama 4 | Açık model | 69.128 | 52.760 | 1,31× | 2,02 | +%11,9 |
| Gemma 4 | Açık model | 72.216 | 52.995 | 1,36× | 2,10 | +%8,8 |
| OpenAI o200k (GPT-4o, GPT-4.1, o3/o4) | Kapalı model | 74.715 | 52.409 | 1,43× | 2,18 | +%6,1 |
| Qwen3.8 | Açık model | 76.572 | 53.698 | 1,43× | 2,23 | +%7,6 |
| Nemotron 3 Super | Açık model | 80.645 | 54.305 | 1,49× | 2,35 | +%5,6 |
| Mistral Small 3.2 | Açık model | 80.963 | 54.305 | 1,49× | 2,36 | +%5,6 |
| Trendyol LLM 7B v4.1 | Türkçe model | 87.179 | 53.876 | 1,62× | 2,54 | +%8,7 |
| GLM-5.3 Flash | Açık model | 86.952 | 53.004 | 1,64× | 2,54 | +%2,0 |
| OpenAI cl100k (GPT-4, GPT-3.5) | Kapalı model | 101.526 | 52.983 | 1,92× | 2,96 | −%6,3 |
| MiniMax M2 | Açık model | 101.426 | 51.821 | 1,96× | 2,96 | −%9,1 |
| DeepSeek V3.2 | Açık model | 107.194 | 52.736 | 2,03× | 3,12 | −%10,4 |
- Metin: FLORES-200 dev + devtest, 2009 paralel cümle, Türkçe (tur_Latn) ve İngilizce (eng_Latn). Lisans CC BY-SA 4.0, NLLB Team / Meta.
- Her cümle ayrı sayıldı; başa/sona eklenen özel tokenlar ve sohbet şablonu dahil değil. Gerçek bir API isteğinde şablon için birkaç token daha eklenir.
- Oran = toplam Türkçe token / toplam İngilizce token. Cümle bazında ortanca oran neredeyse aynı çıktı.
- Harfsiz deneme: ç ğ ı ö ş ü â î û ve büyükleri c g i o s u a i u’ya çevrildi.
- gpt-oss, GPT-4o ailesiyle aynı o200k tokenizer’ını kullanıyor; sonuçlar birebir aynı olduğu için grafikte ayrı gösterilmedi.
- Sunucu kontrolü: yerel vLLM üzerindeki Qwen3.8’e ilk 150 cümle tek mesajda gönderildi, boş mesajın şablon payı (12 token) çıkarıldı; sunucunun prompt_tokens değeri yerel sayımla aynı.
- Claude ve Gemini tokenizer’ları yayımlanmadığı için ölçülmedi.
Kaynaklar ve revizyonlar:
- OpenAI o200k (GPT-4o, GPT-4.1, o3/o4):
tiktoken 0.14.0 o200k_base - OpenAI cl100k (GPT-4, GPT-3.5):
tiktoken 0.14.0 cl100k_base - gpt-oss:
/home/zeka/ai/models/gpt-oss-120b/tokenizer.json - Qwen3.8:
/home/zeka/ai/vllm/hf-cache/hub/models--nvidia--Qwen3.8-27B-NVFP4/snapshots/482ca0f3832238542f8f5295dde86b5f22711d80/tokenizer.json - GLM-5.3 Flash:
huggingface.co/zai-org/GLM-5.3-Flash@46a050bec130 - DeepSeek V3.2:
huggingface.co/deepseek-ai/DeepSeek-V3.2@a7e62ac04ecb - Gemma 4:
huggingface.co/google/gemma-4-31b-it@842da3794eaa - Llama 4:
huggingface.co/unsloth/Llama-4-Scout-17B-16E-Instruct@afd8e498c87b - Mistral Small 3.2:
huggingface.co/unsloth/Mistral-Small-3.2-24B-Instruct-2506@3ed8d341b53e - MiniMax M2:
huggingface.co/MiniMaxAI/MiniMax-M2@757303d492a5 - Nemotron 3 Super:
/home/zeka/ai/models/nvidia-nemotron-3-super-120b-a12b-nvfp4/tokenizer.json - Kumru 2B (VNGRS):
huggingface.co/vngrs-ai/Kumru-2B@0b3cf37f657e - Turkcell LLM 7B:
huggingface.co/TURKCELL/Turkcell-LLM-7b-v1@c84d2a719b90 - Trendyol LLM 7B v4.1:
huggingface.co/Trendyol/Trendyol-LLM-7B-chat-v4.1.0@8d8006bc6584 - Türkçe GPT-2 (YTÜ Cosmos):
huggingface.co/ytu-ce-cosmos/turkish-gpt2-large@c4ddd0f3808f
İndir: tokens.json · cümle bazında sayımlar (CSV) · sunucu kontrolü · sayım betiği · sunucu betiği · grafik betiği