 zekayapar
Kendi Türkçe tokenizer’ımı eğittim: GPT-4o’dan yüzde 27 az token
Türkçe Wikipedia’dan 100 milyon karakterle 9 saniyede bir BPE sözlüğü eğittim: GPT-4o’dan yüzde 27 az token. Sözlük büyüklüğü, metin miktarı ve İngilizcenin bedeli.
Eğitim
- Hugging Face tokenizers 0.23.3 · bayt düzeyinde BPE
- Wikipedia 20231101 · Türkçe 1M–300M, İngilizce 100M karakter
- 14 eğitim · 8k–256k sözlük · Threadripper PRO 5955WX · GPU yok
Ölçüm
- FLORES-200 · 2009 paralel cümle · Türkçe ve İngilizce
- Karşılaştırma: GPT-4o (o200k) · Qwen3.8 · Llama 4 · Kumru · YTÜ GPT-2
- Kayıpsız geri çevirme 4018/4018 · eğitim üç kez bayt bayt aynı
Bir önceki yazıda aynı metnin Türkçe hâlinin çoğu modelde daha fazla token tuttuğunu ölçmüştüm; GPT-4o ailesinde fark 1,43 kattı. Türkçe için eğitilmiş modellerde ise tablo tersine dönüyordu. Bunun üzerine sözlüğü kendim kurmak istedim: Türkçe metinle bir tokenizer eğittim ve aynı test cümleleriyle ölçtüm.
Kısa cevap: Türkçe Wikipedia’dan aldığım 100 milyon karakterlik metinle 32 bin parçalık bir sözlüğü 8,7 saniyede eğittim, GPU kullanmadan. Aynı 2009 Türkçe cümleyi GPT-4o ailesinin tokenizer’ı 74.715 tokenda yazarken benimki 54.625 tokenda yazdı; yani yüzde 27 daha az. Bedeli İngilizcede çıktı: aynı tokenizer İngilizce metni yüzde 65 daha fazla tokenla yazıyor.
Tokenizer ne, nasıl eğitiliyor
Model metni harf ya da kelime olarak değil, sözlüğündeki parçalarla, yani tokenlarla okuyor. Bu sözlük modelden önce, ayrı bir adımda kuruluyor. En yaygın yöntem BPE (byte pair encoding): metin önce baytlara ayrılıyor, sonra en sık yan yana gelen iki parça birleştirilip sözlüğe ekleniyor. Bu işlem sözlük istenen büyüklüğe ulaşana kadar tekrarlanıyor. Ortada sinir ağı yok, sadece sayma ve birleştirme var; bu yüzden GPU gerekmiyor.
Sözlük bir kez kurulduktan sonra model onunla eğitiliyor ve sonradan değiştirilemiyor. Bir modelin Türkçede kaç token harcayacağı, daha eğitimin ilk gününde verilen bu kararla belli oluyor.
Nasıl ölçtüm
Eğitim metni: Wikipedia’nın 1 Kasım 2023 dökümü (Hugging Face’te wikimedia/wikipedia). Türkçe dökümün ilk dosyasındaki 246.288 makaleyi sabit bir tohumla karıştırdım, 200 karakterden kısa olanları attım ve karakter bütçesi dolana kadar baştan makale aldım. Böylece 1, 3, 10, 30, 100 ve 300 milyon karakterlik altı Türkçe metin çıktı. Karşılaştırma için 100 milyon karakter İngilizce ve 50+50 milyon karakterlik karışık bir metin de hazırladım.
Test metni: Önceki yazıdaki FLORES-200 seti; profesyonel çevirmenlerin hazırladığı 2009 paralel Türkçe ve İngilizce cümle. Test cümleleri eğitim metninde geçiyorsa sonuç şişer. Bu yüzden 2009 Türkçe cümlenin her birini 300 milyon karakterlik eğitim metninde aradım; birebir geçen cümle sayısı 0.
Eğitim: Hugging Face tokenizers kütüphanesiyle GPT-2 ve GPT-4o’nun da kullandığı türden bayt düzeyinde BPE. Toplam 14 eğitim yaptım: aynı 100 milyon karakterle 8 binden 256 bine altı sözlük büyüklüğü, 32 binlik sözlükle altı farklı metin miktarı, bir de İngilizce ve karışık metinle üç eğitim. Hepsi Threadripper PRO 5955WX işlemcide çalıştı.
Kontroller: Karşılaştırdığım beş hazır tokenizer’ı yeniden saydım, önceki yazıdaki sayılarla birebir aynı çıktı. Ölçülen her tokenizer 4018 cümlenin hepsini harfi harfine geri çevirebildi, yani hiçbir harf kaybolmadı. 32 binlik eğitimi aynı ayarlarla üç kez çalıştırdım; üç sözlük dosyası bayt bayt aynı çıktı.
Sonuç: 32 binlik sözlük yetiyor
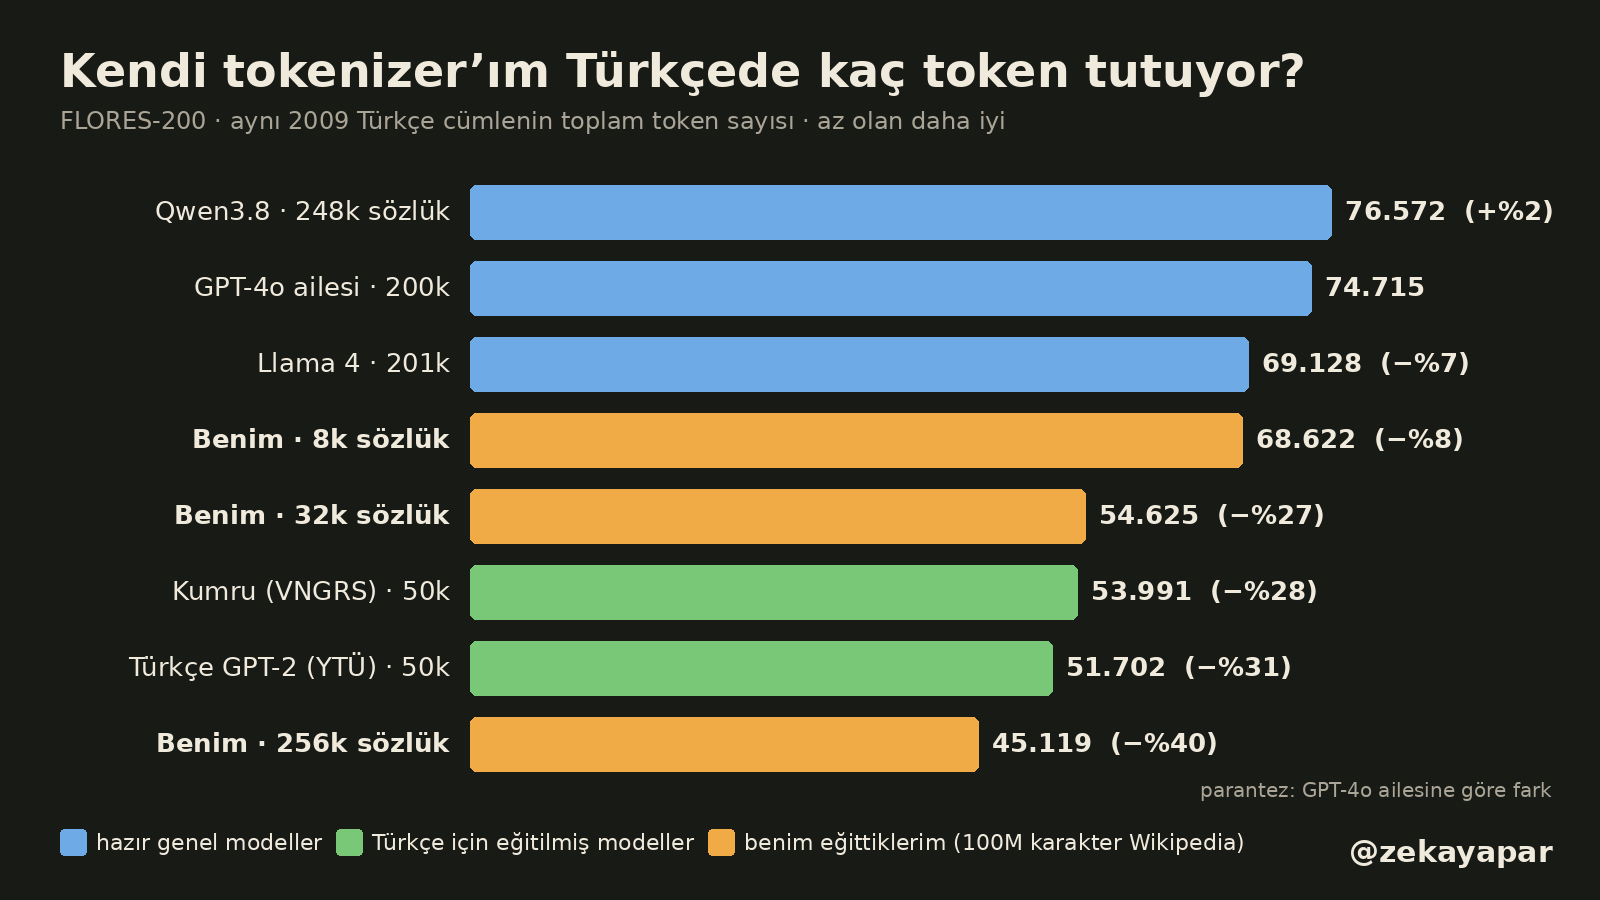
En küçük sözlük bile şaşırttı: yalnız 8 bin parçalık tokenizer’ım Türkçe metni 68.622 tokenda yazdı. Bu, sözlüğü 24 kat büyük olan GPT-4o ailesinden yüzde 8 daha az. 32 binlik sözlük (54.625) VNGRS’in Türkçe modeli Kumru’yla (53.991) neredeyse aynı yere geldi; Kumru’nun sözlüğü 50 bin parça. 256 bine çıkınca 45.119 token oldu; bu da YTÜ’nün Türkçe GPT-2’sinden (önceki ölçümde Türkçeyi en az tokenla yazan, 51.702) yüzde 13 daha az.
Bunu “benim tokenizer’ım GPT-4o’dan iyi” diye okumamak gerekiyor. GPT-4o’nun sözlüğü onlarca dili ve kodu birlikte taşıyor; benimki yalnız Türkçe Wikipedia gördü. Ölçülen şey, sözlükte Türkçeye ne kadar yer ayrıldığı.
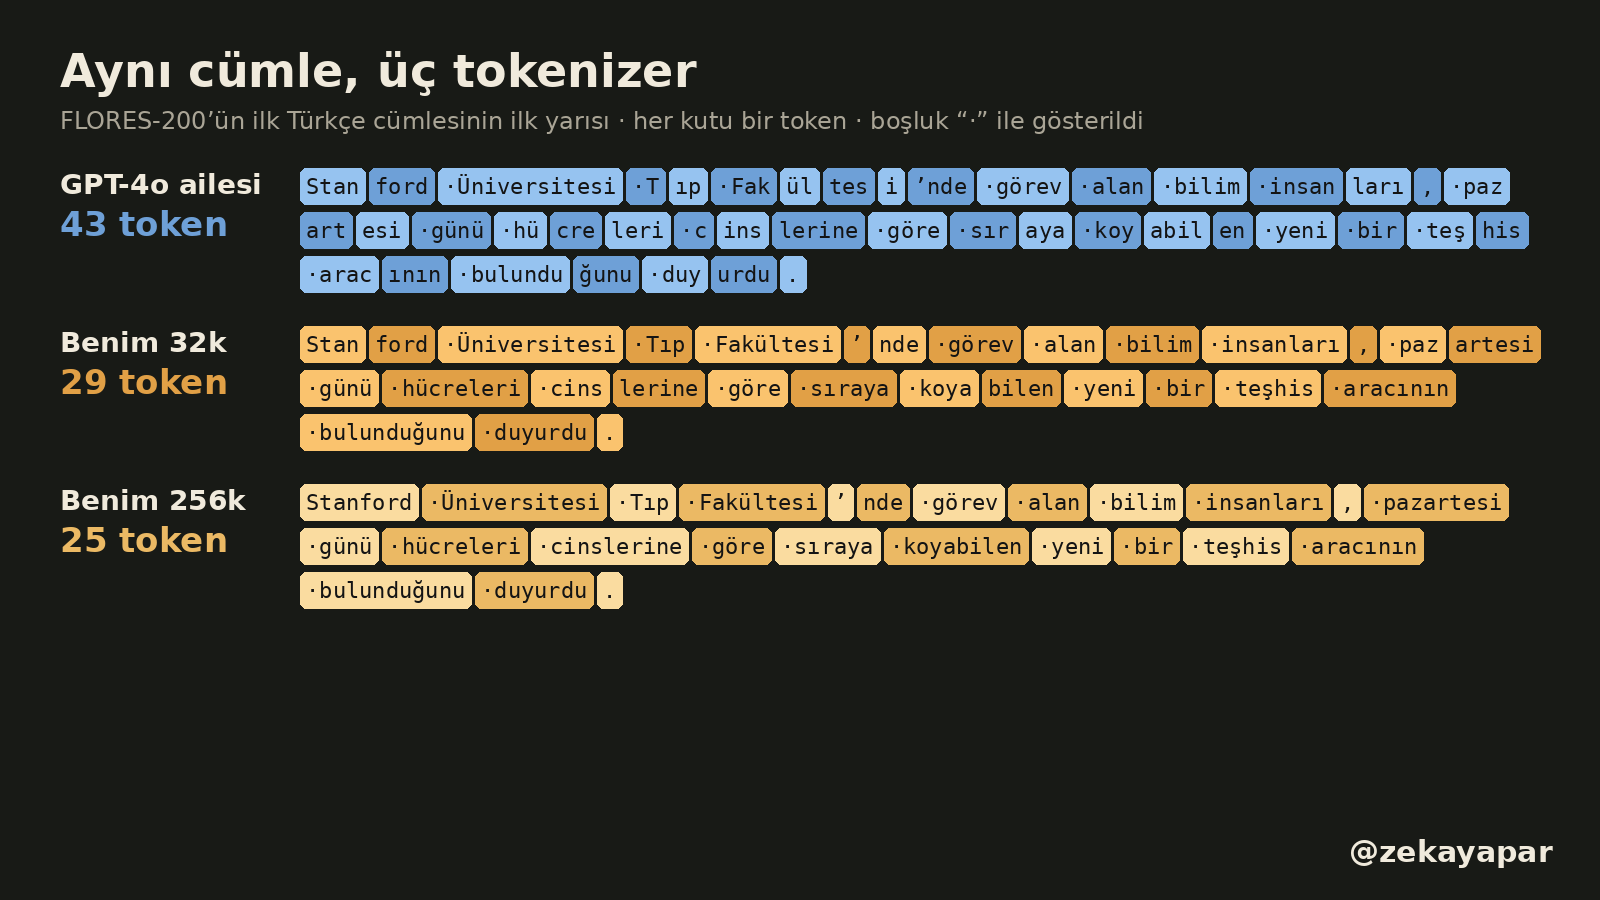
Tek bir cümlede fark şöyle görünüyor. FLORES’in ilk Türkçe cümlesinin ilk yarısını GPT-4o ailesi 43, benim 32 binlik sözlüğüm 29, 256 binlik sözlüğüm 25 parçaya bölüyor. “Fakültesi”, “hücreleri”, “bulunduğunu”, “kullanılarak” gibi kelimeler benim sözlükte tek parça.
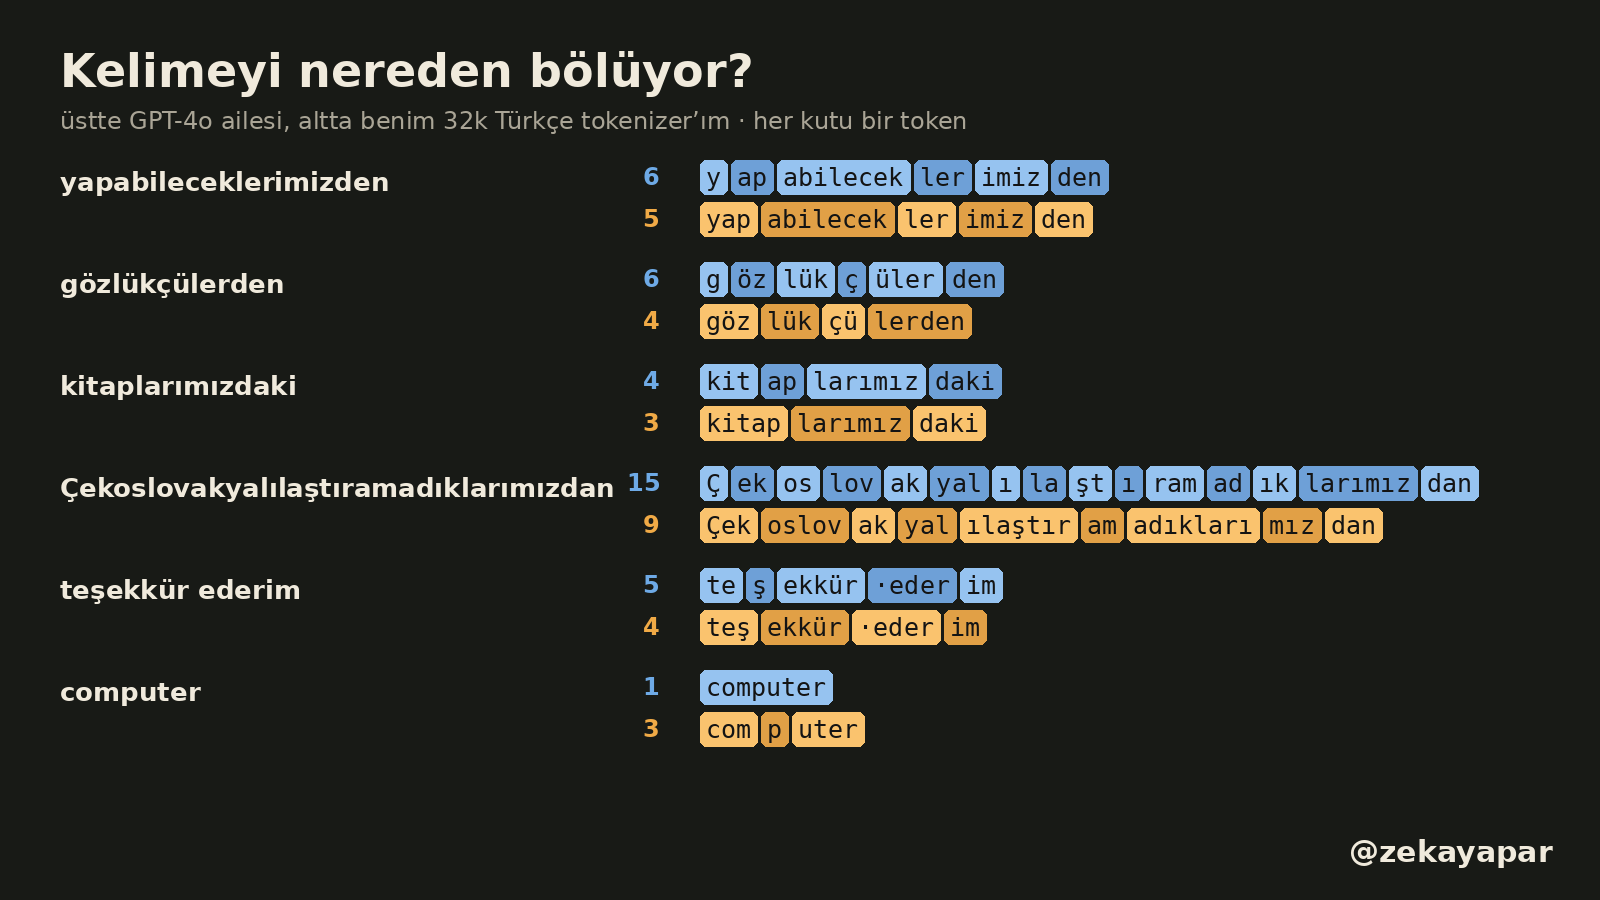
Kelime kelime bakınca “kitaplarımızdaki” GPT-4o ailesinde kit-ap-larımız-daki diye dört parça, benimkinde kitap-larımız-daki diye üç parça. Kelime başına ortalamada GPT-4o ailesi Türkçede 2,18, benim 32 binlik sözlüğüm 1,59 token kullanıyor. İngilizce kelimelerde ise tersi oluyor: “computer” GPT-4o ailesinde tek parça, benimkinde üç.
Sözlüğü büyütmek ne kadar kazandırıyor
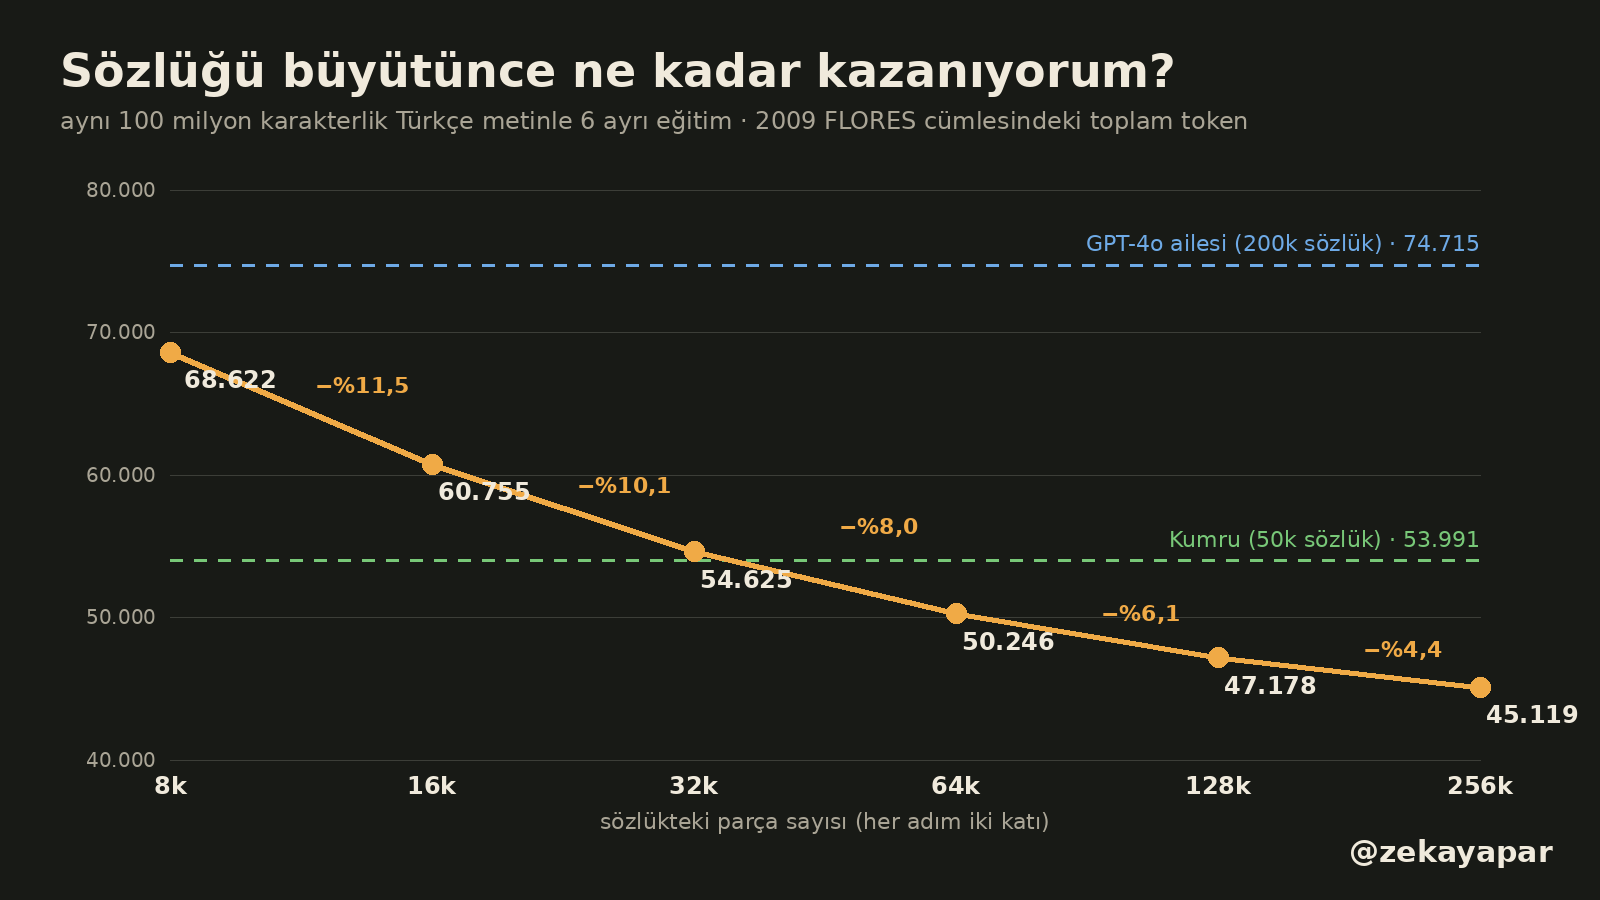
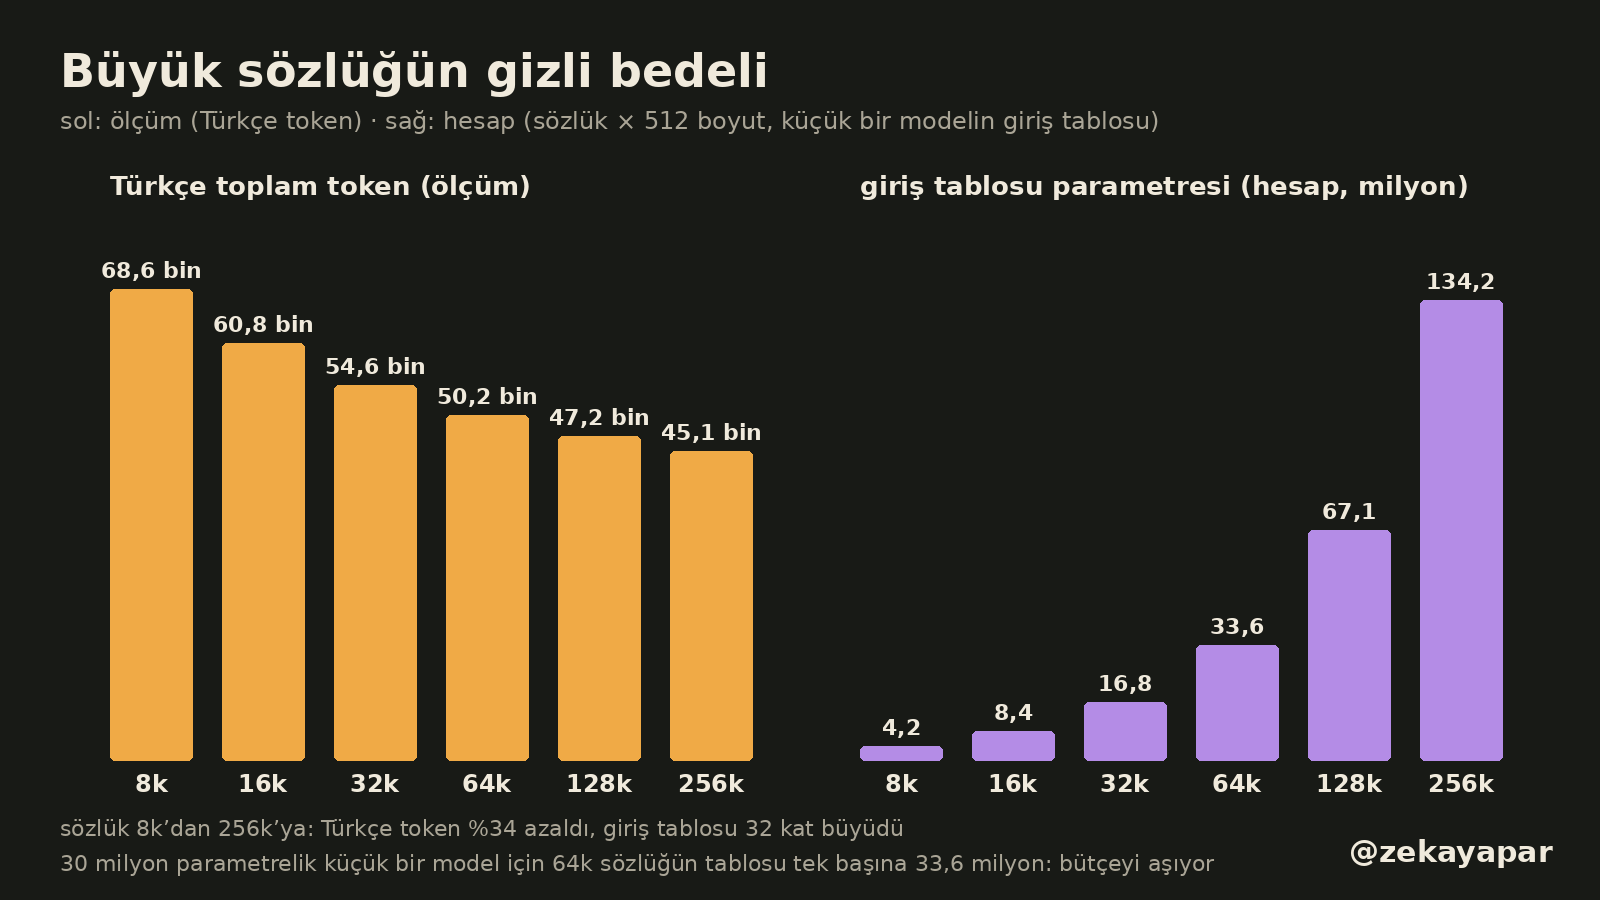
Aynı 100 milyon karakterle sözlüğü her seferinde iki katına çıkararak altı eğitim yaptım. Her ikiye katlamada kazanç biraz daha küçülüyor: sırasıyla yüzde 11,5, 10,1, 8,0, 6,1 ve 4,4. 8 binden 256 bine, yani 32 kat büyük sözlükle Türkçe token sayısı yüzde 34 azaldı.
Büyük sözlüğün bir bedeli de var. Modelin girişinde her token için bir satırlık bir tablo bulunuyor (embedding tablosu). Bu tablonun büyüklüğü sözlük büyüklüğü çarpı modelin iç boyutu kadar. Burada ölçüm değil, basit bir hesap yaptım: iç boyutu 512 olan küçük bir model için 8 binlik sözlüğün tablosu 4,2 milyon, 256 binliğin tablosu 134,2 milyon parametre ediyor. 30 milyon parametrelik küçük bir model hedeflesem, 64 binlik sözlüğün tablosu (33,6 milyon) tek başına bu bütçeyi aşardı. Yüz milyarlarca parametrelik büyük modellerde bu pay küçük kalıyor; küçük modellerde ise sözlük seçimi doğrudan bütçeyi etkiliyor. Kumru ve YTÜ’nün GPT-2’si 50 bin civarında sözlük kullanıyor.
Ne kadar metin gerekiyor
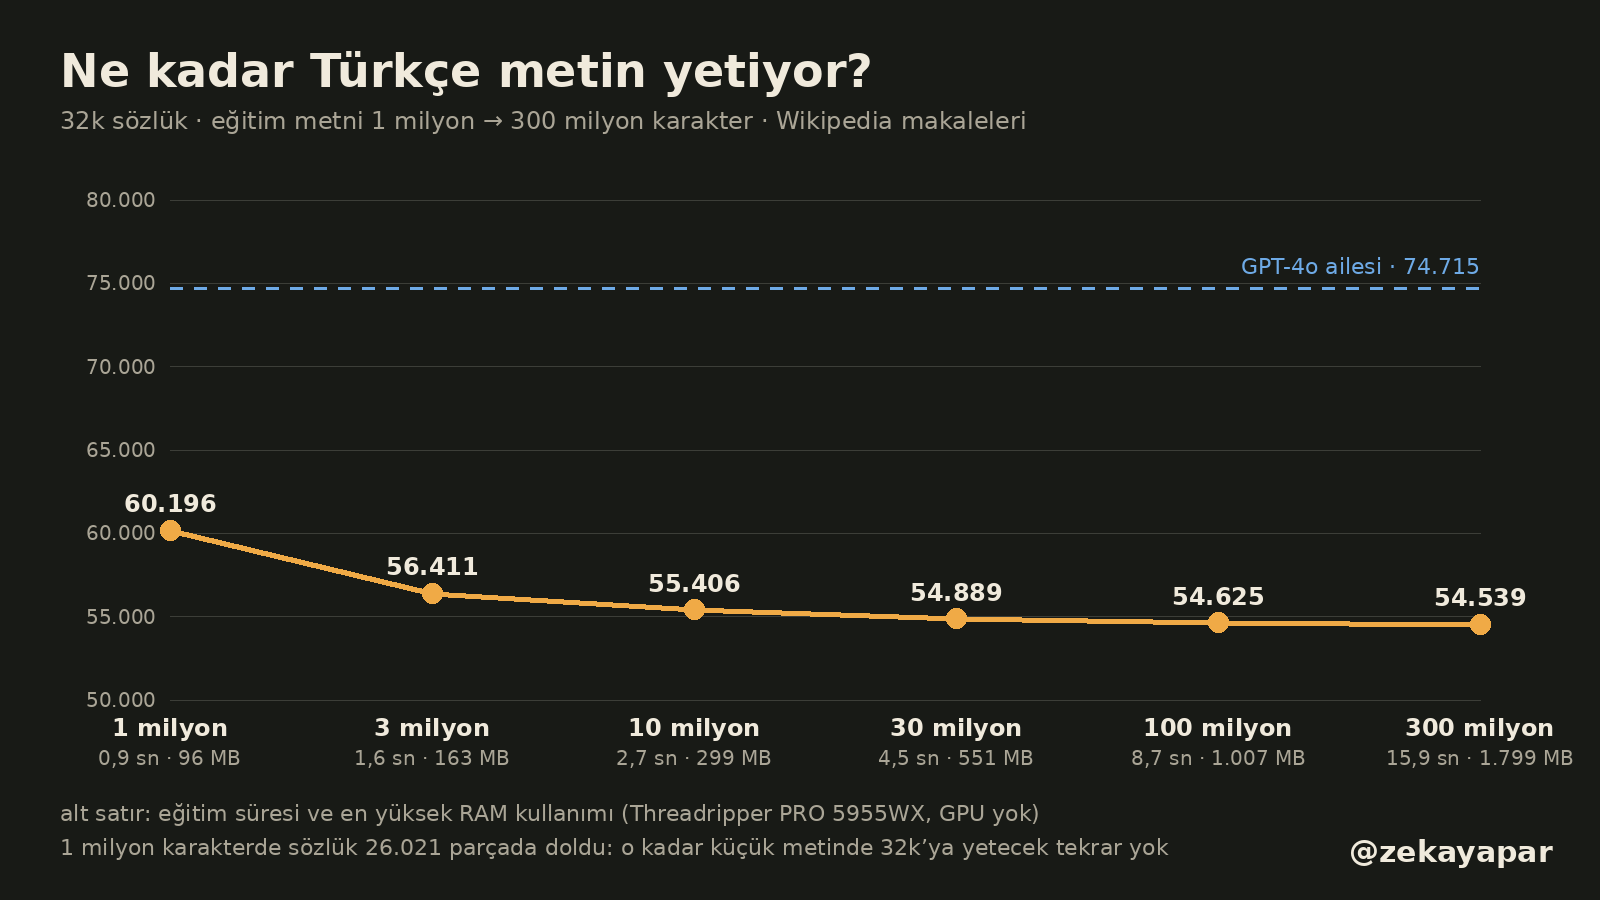
Sözlüğü 32 binde sabit tutup eğitim metnini değiştirdim. Yalnız 1 milyon karakterlik metinle bile sonuç 60.196 token; GPT-4o ailesinden yüzde 19 az. O kadar küçük metinde sözlük 32 bine ulaşamadı, 26.021 parçada durdu, çünkü daha fazla parça için yeterince tekrar yoktu. 10 milyon karakterde 55.406, 100 milyonda 54.625, 300 milyonda 54.539. 100 milyondan 300 milyona çıkınca kazanç yüzde 0,16; bu noktadan sonra daha fazla Wikipedia neredeyse hiçbir şey değiştirmiyor.
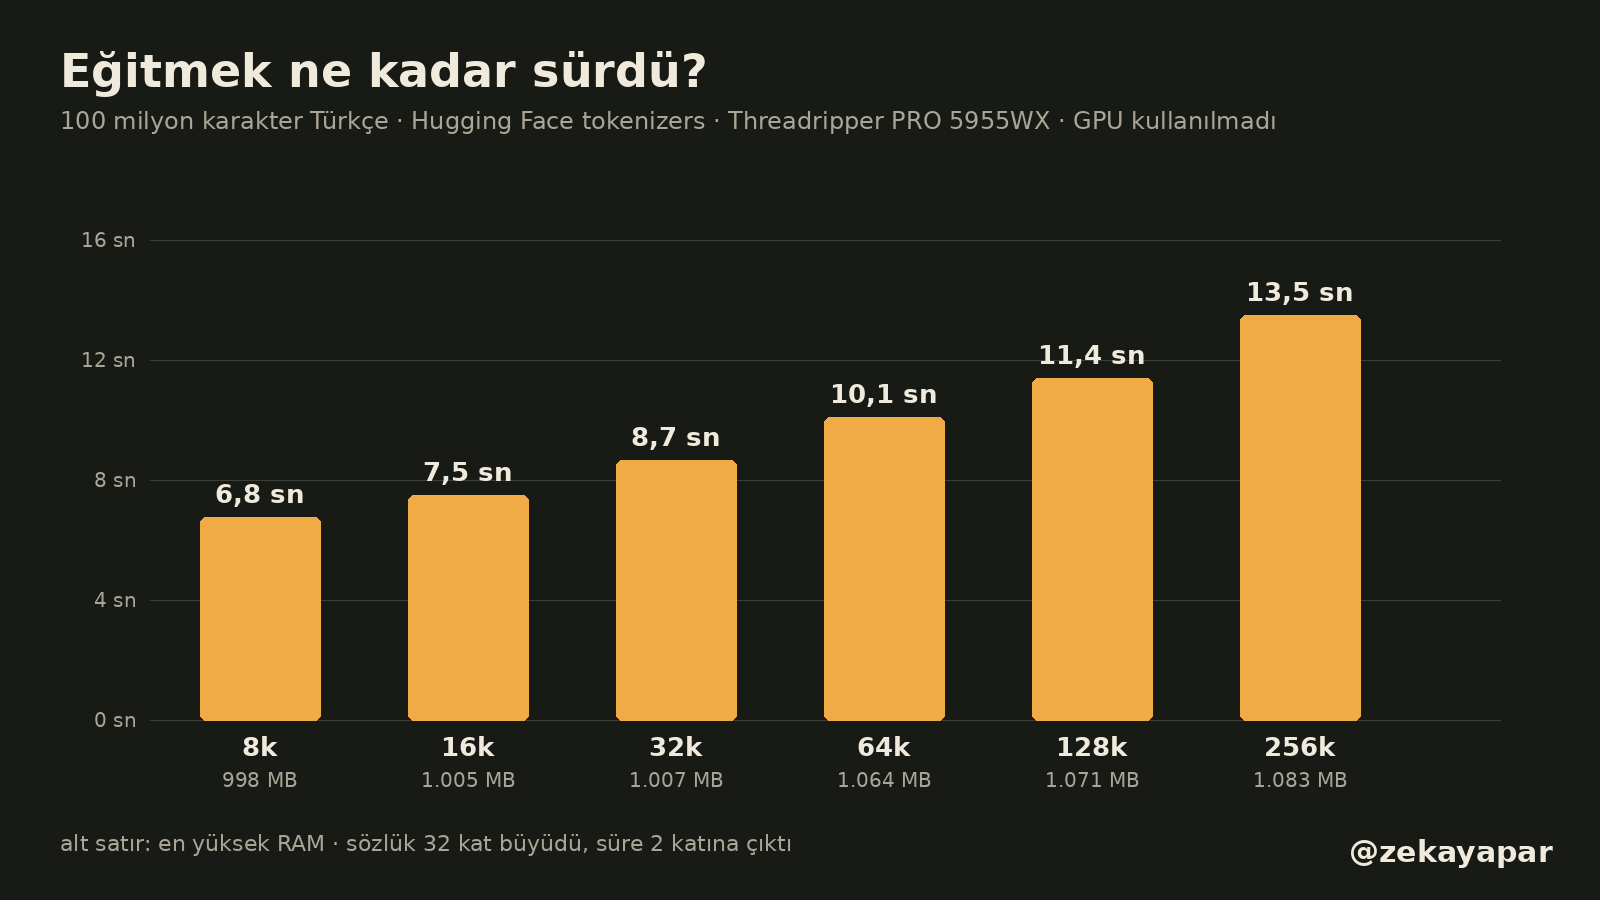
Eğitim süresi de hep kısa kaldı. 100 milyon karakterle 8 binlik sözlük 6,8 saniye, 256 binlik sözlük 13,5 saniye sürdü. Sözlük 32 kat büyüdü, süre iki katına çıktı. En büyük iş olan 300 milyon karakterlik eğitim 15,9 saniye sürdü ve en fazla 1,8 GB bellek kullandı.
Sözlük neyi öğrendi
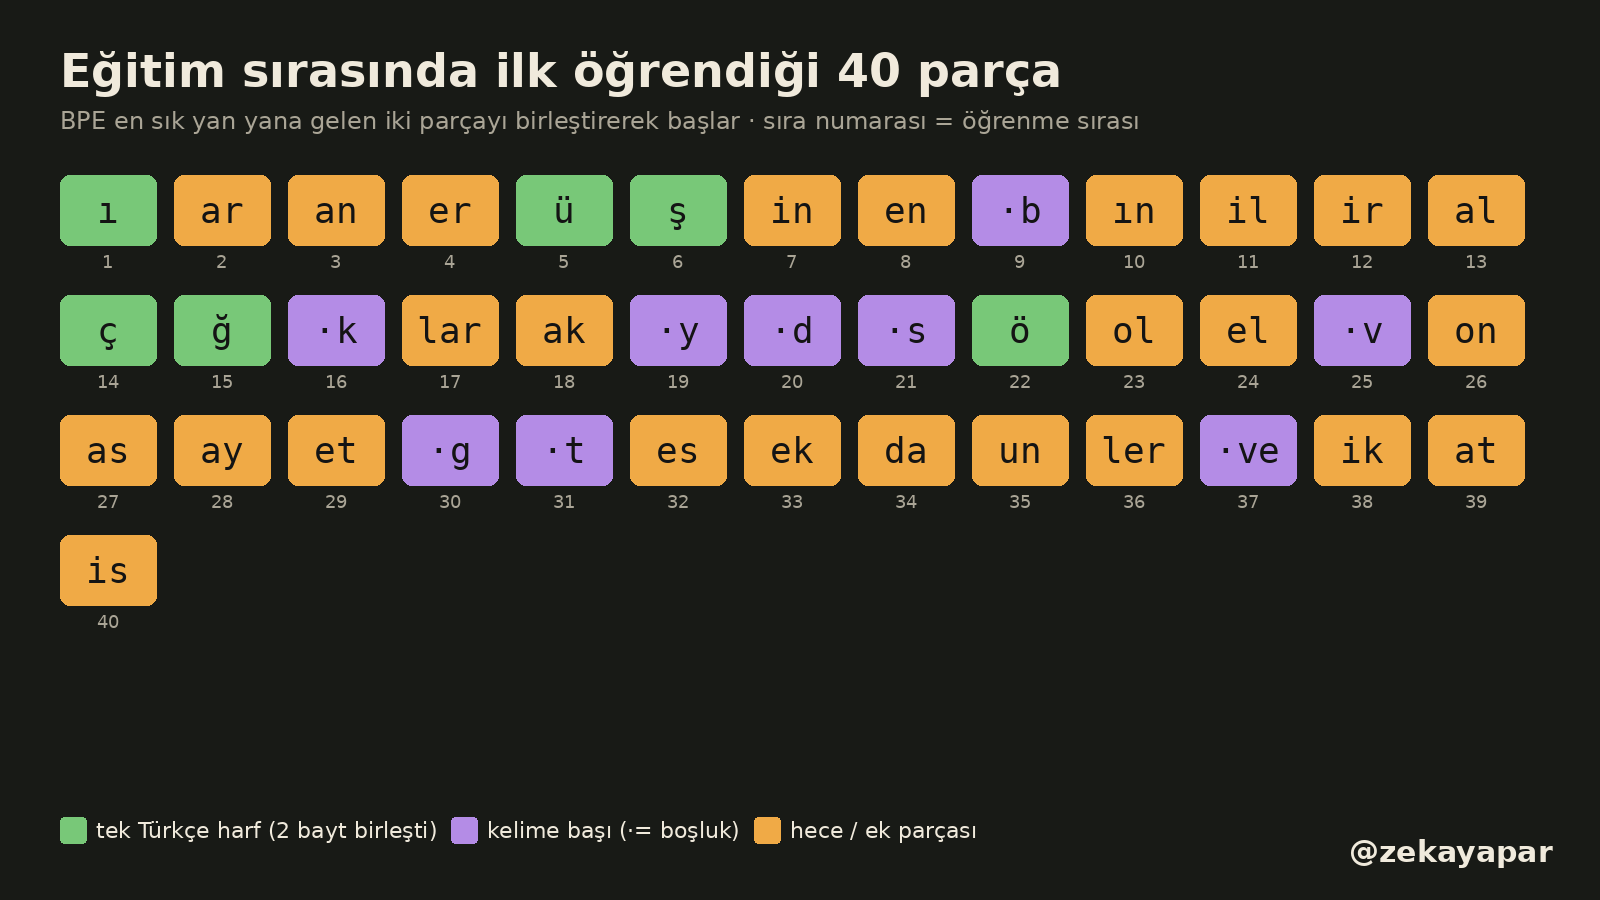
BPE’nin hangi parçaları hangi sırayla eklediğine baktım. İlk öğrendiği şeyler ı, ü, ş, ç, ğ, ö harfleri oldu. Bunun nedeni Türkçeye özgü harflerin bilgisayarda (UTF-8) iki bayt tutması: bayt düzeyinde başlayan eğitim ilk iş olarak bu iki baytı tek parçaya birleştiriyor. Ardından “ar”, “an”, “er”, “in” gibi heceler ve “lar”, “ler”, “ve” gibi parçalar geliyor.
32 binlik sözlüğün 10.861 parçasında (yaklaşık üçte biri) en az bir Türkçe harf var. Sözlükteki en uzun tek parçalar “gerçekleştirilmiştir”, “karşılaştırıldığında”, “karıştırılmamalıdır”, “adlandırılmaktadır”. Bunlar ansiklopedi dilinin izleri; günlük konuşmada pek kullanmadığımız ama Wikipedia’da sık geçen kalıplar.
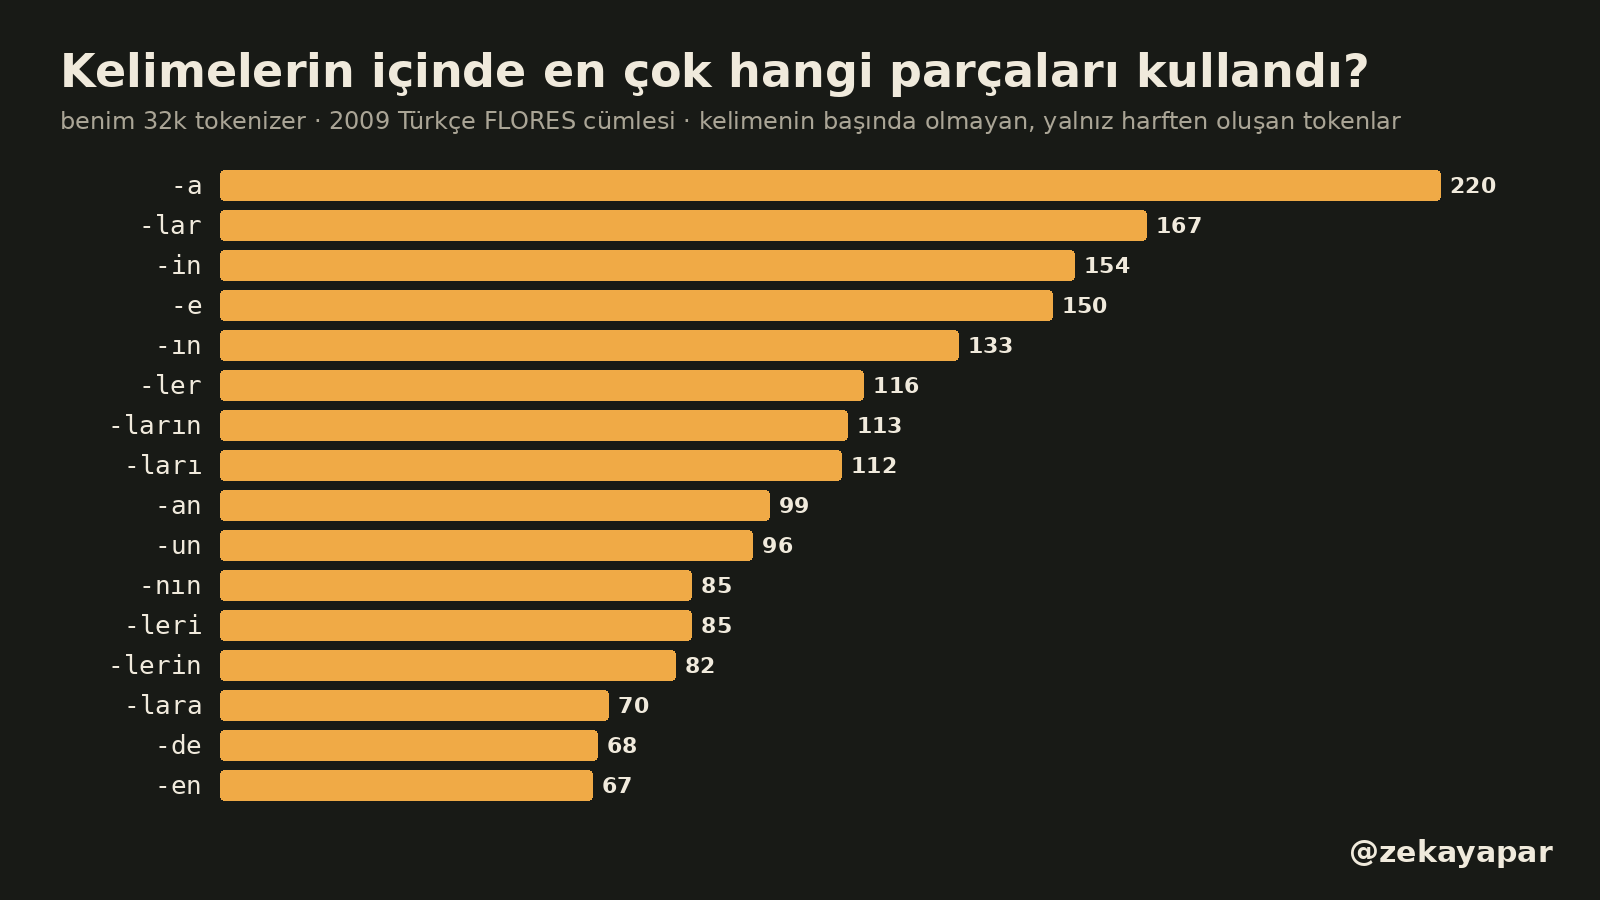
Test cümlelerini benim sözlükle bölünce kelimelerin içinde en çok kullanılan parçalar Türkçenin ekleri çıktı: -lar 167, -ler 116, -ların 113, -ları 112 kez. Tokenizer dil bilgisi bilmiyor, sadece sayıyor; ekleri sık geçtikleri için kendiliğinden ayırmış. Ama bölme yerleri her zaman ek sınırına denk gelmiyor. “Çekoslovakyalılaştıramadıklarımızdan” benim sözlükte Çek-oslov-ak-yal-ılaştır-am-adıkları-mız-dan diye bölünüyor.
İngilizceye ne oldu
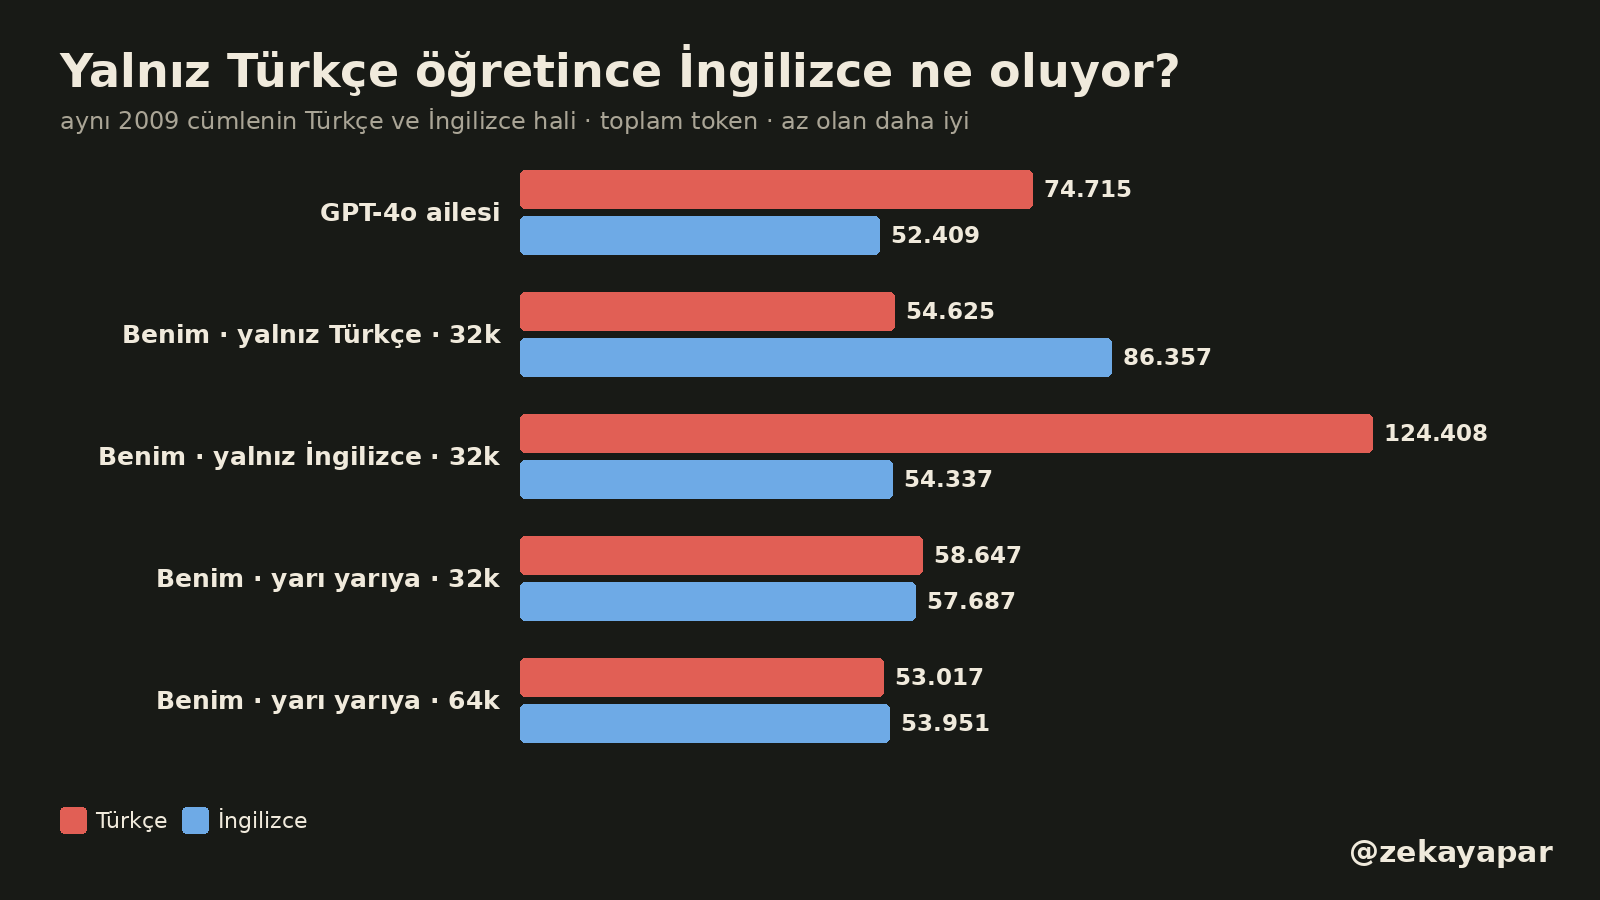
Yalnız Türkçe görmüş sözlük İngilizcede zorlanıyor: aynı cümlelerin İngilizcesi 86.357 token tuttu, GPT-4o ailesinde 52.409. Tersini de denedim: aynı ayarlarla yalnız İngilizce Wikipedia’dan eğittiğim sözlük Türkçe metni 124.408 tokenda yazdı, kendi İngilizcesinin 2,29 katı. Bu, önceki yazıda en pahalı çıkan DeepSeek V3.2’den (107.194) de kötü. Sözlük hangi dili gördüyse onu ucuz yazıyor.
Peki iki dil yarı yarıya karıştırılırsa? 32 binlik karışık sözlük iki dili neredeyse eşit yazdı: Türkçe 58.647, İngilizce 57.687. 64 bine çıkınca Türkçe 53.017 token oldu, yalnız Türkçe 32 binlik sözlükten bile az. İngilizce 53.951, GPT-4o ailesinden yalnız yüzde 2,9 fazla. Yani iki dile 64 bin parça ayırınca ikisini de iyi yazan bir sözlük çıkıyor.
Günlük kullanımda ne demek
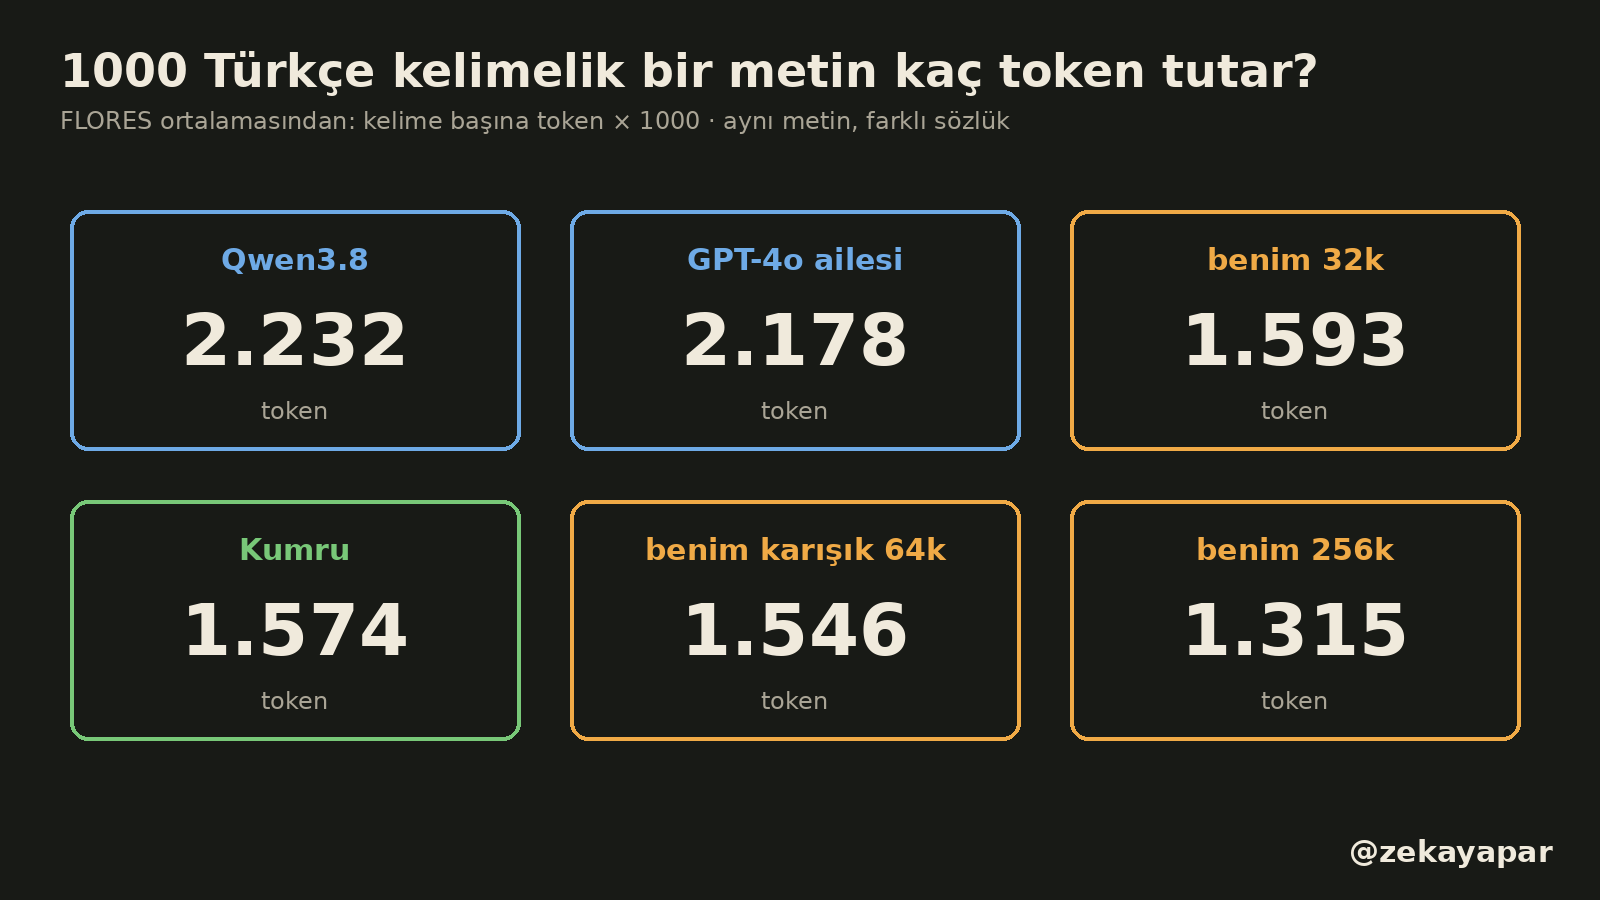
FLORES’teki kelime başına token ortalamasından gidersem, 1000 kelimelik bir Türkçe metin Qwen3.8’de yaklaşık 2.232, GPT-4o ailesinde 2.178 token tutuyor. Benim 32 binlik sözlüğümde 1.593, 256 binlikte 1.315. Aynı bağlam penceresine yaklaşık üçte bir daha fazla Türkçe metin sığması demek; saniyede aynı sayıda token üreten bir modelde de cevabın daha kısa sürede yazılması demek.
Burada önemli bir şart var: bu kazanç yalnız bu sözlükle eğitilmiş bir modelde işe yarıyor. Var olan bir modelin tokenizer’ını değiştirip ucuzlatamazsınız, çünkü model kendi parçalarıyla eğitildi. Sözlüğü değiştirmek, modelin en azından giriş ve çıkış katmanlarını yeniden eğitmek anlamına geliyor.
Benim için sonuç
Model eğitiminin bu ilk adımı çok ucuz: birkaç yüz MB metin, birkaç saniye işlemci zamanı ve tek bir kütüphane yetiyor. Türkçe için iyi bir sözlüğün sırrı büyüklükte değil, sözlüğün ne kadar Türkçe metinle kurulduğunda. 8 binlik bir Türkçe sözlük, 200 binlik çok dilli sözlükten daha az token harcıyor.
Asıl soru bundan sonra başlıyor: bu sözlükle küçük bir Türkçe dil modeli eğitilince token tasarrufu modelin hızına ve yazdığı metnin kalitesine nasıl yansıyor? Bunu evdeki kartlarda küçük bir model eğiterek denemek istiyorum.
Sınırlar
- Test metni FLORES-200; Wikinews, Wikijunior ve Wikivoyage kaynaklı, haber ve ansiklopedi diline yakın. Eğitim metnim de Wikipedia olduğu için alan benzerliği benim sözlüğün lehine. Günlük konuşma, sosyal medya ya da kod gibi metinlerde fark farklı çıkabilir; bunları ölçmedim.
- Token sayısı kalite ölçüsü değil. Daha az token, bu sözlükle eğitilecek modelin daha iyi olacağını göstermez.
- Kumru metni farklı bir ön bölmeyle parçalıyor (bazı parçalar iki kelimeyi ve boşluğu birlikte içeriyor); bu yüzden kelime başına sayılar birebir aynı yöntemle üretilmiş sayılmamalı.
- Giriş tablosu hesabı ölçüm değil, sözlük × 512 çarpımı. Gerçek modellerde iç boyut ve tablonun çıkışta paylaşılıp paylaşılmadığı değişir.
- Sözlük büyüklükleri 1024’ün katları: 8k = 8.192, 32k = 32.768, 256k = 262.144 parça.
- Claude ve Gemini tokenizer’ları açık olmadığı için karşılaştırmada yoklar.
Tam tablo ve yöntem
| Tokenizer | Tür | Sözlük | TR token | EN token | TR/EN | TR token/kelime | TR karakter/token | Eğitim | En yüksek RAM |
|---|---|---|---|---|---|---|---|---|---|
| GPT-4o ailesi (o200k) | hazır | 200.019 | 74.715 | 52.409 | 1,43× | 2,18 | 3,54 | – | – |
| Qwen3.8 | hazır | 248.077 | 76.572 | 53.698 | 1,43× | 2,23 | 3,45 | – | – |
| Llama 4 | hazır | 201.135 | 69.128 | 52.760 | 1,31× | 2,02 | 3,82 | – | – |
| Kumru (VNGRS) | hazır | 50.176 | 53.991 | 84.526 | 0,64× | 1,57 | 4,90 | – | – |
| Türkçe GPT-2 (YTÜ) | hazır | 50.257 | 51.702 | 82.961 | 0,62× | 1,51 | 5,11 | – | – |
| Türkçe 100M · 8k | benim | 8.192 | 68.622 | 106.007 | 0,65× | 2,00 | 3,85 | 6,8 sn | 998 MB |
| Türkçe 100M · 16k | benim | 16.384 | 60.755 | 96.625 | 0,63× | 1,77 | 4,35 | 7,5 sn | 1.005 MB |
| Türkçe 100M · 32k | benim | 32.768 | 54.625 | 86.357 | 0,63× | 1,59 | 4,84 | 8,7 sn | 1.007 MB |
| Türkçe 100M · 64k | benim | 65.536 | 50.246 | 77.613 | 0,65× | 1,47 | 5,26 | 10,1 sn | 1.064 MB |
| Türkçe 100M · 128k | benim | 131.072 | 47.178 | 68.881 | 0,68× | 1,38 | 5,60 | 11,4 sn | 1.071 MB |
| Türkçe 100M · 256k | benim | 262.144 | 45.119 | 61.715 | 0,73× | 1,31 | 5,86 | 13,5 sn | 1.083 MB |
| Türkçe 1M · 32k | benim | 26.021 | 60.196 | 96.715 | 0,62× | 1,75 | 4,39 | 0,9 sn | 96 MB |
| Türkçe 3M · 32k | benim | 32.768 | 56.411 | 89.194 | 0,63× | 1,65 | 4,69 | 1,6 sn | 163 MB |
| Türkçe 10M · 32k | benim | 32.768 | 55.406 | 87.003 | 0,64× | 1,61 | 4,77 | 2,7 sn | 299 MB |
| Türkçe 30M · 32k | benim | 32.768 | 54.889 | 85.766 | 0,64× | 1,60 | 4,82 | 4,5 sn | 551 MB |
| Türkçe 300M · 32k | benim | 32.768 | 54.539 | 86.954 | 0,63× | 1,59 | 4,85 | 15,9 sn | 1.799 MB |
| İngilizce 100M · 32k | benim | 32.768 | 124.408 | 54.337 | 2,29× | 3,63 | 2,12 | 5,2 sn | 636 MB |
| Karışık 100M · 32k | benim | 32.768 | 58.647 | 57.687 | 1,02× | 1,71 | 4,51 | 7,8 sn | 941 MB |
| Karışık 100M · 64k | benim | 65.536 | 53.017 | 53.951 | 0,98× | 1,55 | 4,99 | 8,9 sn | 1.004 MB |
- Test: FLORES-200 dev + devtest, 2009 paralel cümle, Türkçe (tur_Latn) ve İngilizce (eng_Latn), CC BY-SA 4.0, NLLB Team / Meta. 264.373 Türkçe karakter, 34.301 Türkçe kelime.
- Eğitim metni:
huggingface.co/datasets/wikimedia/wikipedia@b04c8d1ceb2f, CC BY-SA 4.0. Türkçe20231101.tr/train-00000-of-00002.parquet(SHA2566994014607c0), İngilizce20231101.en/train-00000-of-00041.parquet(SHA256382e7f6f09e4). 200 karakterden kısa makaleler atıldı, makaleler 20261021 tohumuyla karıştırıldı. - Eğitim: Hugging Face tokenizers 0.23.3, BPE, ByteLevel ön bölme (GPT-2 düzenli ifadesi, baştaki boşluk eklenmedi), en az 2 tekrar, tek özel token <|endoftext|>. Her eğitim ayrı süreçte; süre yalnız
train()çağrısı, RAM sürecin en yüksek RSS değeri. İşlemci Threadripper PRO 5955WX, GPU kullanılmadı. - Sayım özel tokenlar olmadan, her cümle ayrı yapıldı. Oran = toplam Türkçe token / toplam İngilizce token.
- Tekrar üretilebilirlik: Türkçe 100M · 32k eğitimi üç kez çalıştı, dosya SHA256 üçünde de
0511854096ebf400. - Sızıntı kontrolü: 2009 Türkçe FLORES cümlesinden 300 milyon karakterlik eğitim metninde birebir geçen: 0.
Hazır tokenizer’lar:
- GPT-4o ailesi (o200k):
tiktoken 0.14.0 o200k_base - Qwen3.8:
yerel Qwen3.8 NVFP4 snapshot 482ca0f· SHA2560997f410c57a - Llama 4:
huggingface.co/unsloth/Llama-4-Scout-17B-16E-Instruct@afd8e498c87b· SHA256172c9eb4beaf - Kumru (VNGRS):
huggingface.co/vngrs-ai/Kumru-2B@0b3cf37f657e· SHA2561f00b5bbea83 - Türkçe GPT-2 (YTÜ):
huggingface.co/ytu-ce-cosmos/turkish-gpt2-large@c4ddd0f3808f· SHA256d9b4c033b96a
İndir: Türkçe 32k tokenizer · Türkçe+İngilizce 64k tokenizer · ölçüm sonuçları (JSON) · cümle bazında sayımlar (CSV) · eğitim süreleri · veri kaynakları ve SHA256 · tekrar kontrolü · betikler: prep.py, train.py, eval.py, repro_check.py, charts.py
Paylaşılan tokenizer dosyaları Wikipedia metninden (CC BY-SA 4.0) türetildi.