 zekayapar
Uzun bir metni okutunca ne kadar bekliyorum? Ryzen AI Max+ 395’te 1k’dan 64k token’a
128 GB birleşik bellekli Ryzen AI Max+ 395’e 1k–64k token Türkçe metin verdim: üç model, Vulkan ve ROCm, 72 istek. Bekleme metinden hızlı uzuyor.
Donanım ve çalıştırıcı
- AMD Ryzen AI Max+ 395 · Radeon 8060S · 128 GB birleşik bellek
- llama.cpp b11803 · Vulkan ve ROCm 10.1
- Bağlam 67.584 token · tüm katmanlar GPU’da · önbellek kapalı
Modeller ve veri
- Gemma 4 26B-A4B (MoE) · gpt-oss-120b (MoE) · Gemma 4 31B (yoğun)
- Türkçe Vikipedi, 8 uzun madde · 1k–64k token
- Metne saklı kod sorusu · 2 tekrar · 72 istek
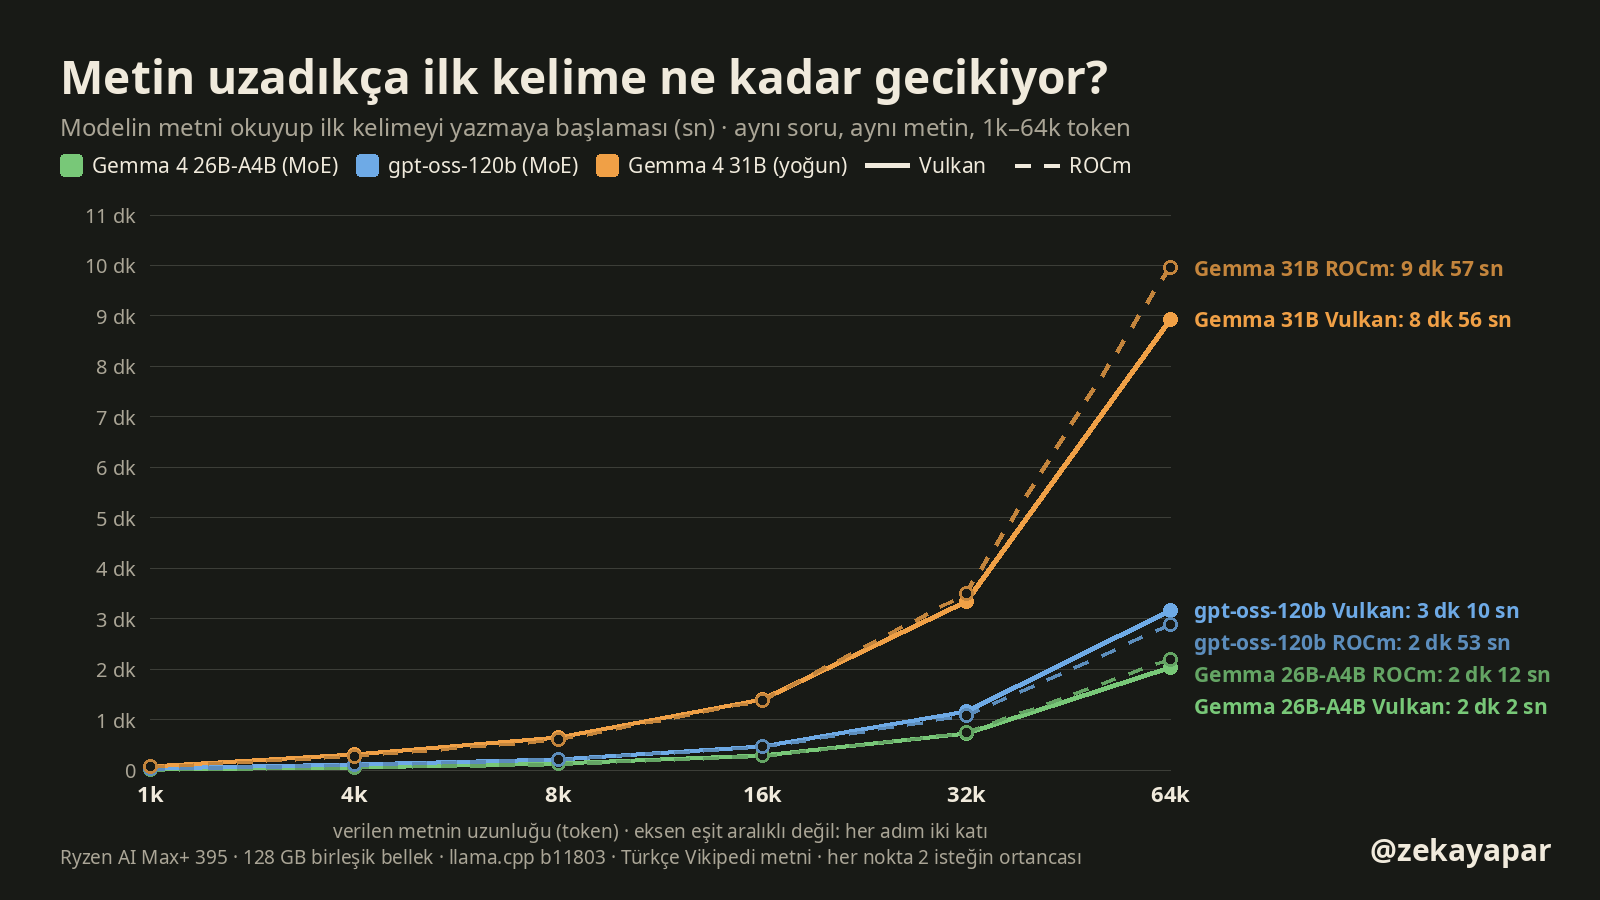
Soru: 128 GB birleşik belleği olan küçük bir bilgisayara uzun bir Türkçe metin verip soru sorunca ne kadar bekliyorum? Kısa cevap: iki sayfalık (1k token) metinde ilk kelime MoE modellerde 1–2 saniyede, yoğun modelde 4,2 saniyede geliyor. Metin 64k token’a (yaklaşık 123 sayfa) çıkınca ilk kelime, en hızlı modelde 2 dakika 2 saniye, en yavaşında 8 dakika 56 saniye sonra geliyor. Metin 64 kat uzarken bekleme 64 kattan fazla uzuyor, çünkü okuma hızının kendisi de düşüyor: Gemma 4 26B-A4B’de saniyede 1.115 token’dan 541 token’a.
Ryzen AI Max+ 395’li bilgisayarımın öne çıkan tarafı belleği: 128 GB’ın büyük kısmını ekran kartı kullanabiliyor, bu yüzden 60 GB’lık modeller bile sığıyor. Ama “sığıyor” ile “kullanılır” aynı şey değil. Uzun bir rapor, bir sözleşme ya da bir kitabın bölümü verdiğimde ne kadar bekleyeceğimi bilmek istedim. Bunu üç modelle, iki farklı sürücü yoluyla ve gerçek Türkçe metinle ölçtüm.
Nasıl ölçtüm
Metin olarak Türkçe Vikipedi’den sekiz uzun maddeyi art arda koydum (İstanbul, Osmanlı İmparatorluğu, Türk Kurtuluş Savaşı, Mustafa Kemal Atatürk, Ankara, Türk mutfağı, İzmir, Büyük Selçuklu İmparatorluğu). Toplam 535 bin karakter; kaynakça bölümlerini çıkardım. Her uzunluk için metni modelin kendi tokenizer’ıyla tam hedef token sayısına kırptım: 1k, 4k, 8k, 16k, 32k ve 64k token (1k = 1.024). Böylece her model aynı sayıda metin token’ı okudu (sohbet şablonu ve soru buna birkaç düzine token ekliyor); bir token Türkçede ortalama üç-dört karakter tutuyor.
Okuduğunu gerçekten kullanıp kullanmadığını görmek için metnin içine kendi uydurduğum bir cümle sakladım: “Kütüphanenin arşiv odasının kapı kodu 4817’dir.” Birinci tekrarda bu cümle metnin %25’inde, ikinci tekrarda (kod 6293) %75’inde duruyordu. Metnin sonunda şunu sordum:
Yukarıdaki metinde arşiv odasının kapı kodu geçiyor. İlk satıra yalnız bu dört haneli kodu yaz. Sonra metnin ilk bölümünü altı cümleyle Türkçe özetle.
Özet kısmı, cevap yazma hızını ölçebilmek için yeterince uzun bir çıktı istiyor. Modeller:
- Gemma 4 26B-A4B: karışık uzman (MoE) model. Toplam 26 milyar parametre var ama her token’da yaklaşık 4 milyarı çalışıyor.
- gpt-oss-120b: OpenAI’nin açık ağırlıklı büyük MoE modeli, dosyası 63 GB. Her token’da yaklaşık 5 milyar parametre çalışıyor.
- Gemma 4 31B: yoğun model. Her token’da 31 milyar parametrenin hepsi çalışıyor.
Her birini llama.cpp’nin aynı sürümüyle (b11803) iki yoldan çalıştırdım: Vulkan ve AMD’nin ROCm’u. Sunucu 67.584 token’lık bağlamla açıldı, tüm katmanlar GPU’daydı, hazır hesap önbelleği kapalıydı (her istek metni baştan okudu). Sıcaklık 0. Her uzunluk iki kez soruldu, ölçümden önce bir ısınma isteği atıldı ve sonuca katılmadı. Toplam 72 istek. Gemma’da düşünme modunu kapattım, gpt-oss’ta düşünmeyi “düşük” seviyeye aldım (bu modelde tamamen kapanmıyor). Grafiklerdeki “ilk kelime” süresi, isteği gönderdiğim andan modelin ilk token’ı (gpt-oss’ta kısa düşünme metninin ilk token’ı) gelene kadar geçen süre.
Sonuç: metin uzadıkça bekleme daha hızlı uzuyor
İlk grafikteki düz çizgiler Vulkan, kesik çizgiler ROCm. Vulkan ile ilk kelimeye kadar bekleme:
- Gemma 4 26B-A4B: 1k token’da 0,9 saniye, 64k token’da 2 dakika 2 saniye.
- gpt-oss-120b: 1k token’da 1,8 saniye, 64k token’da 3 dakika 10 saniye.
- Gemma 4 31B: 1k token’da 4,2 saniye, 64k token’da 8 dakika 56 saniye.
Metin 64 kat uzadı, Gemma 26B-A4B’nin beklemesi 139 kat uzadı. Doğrusal olsaydı 64k token’da yaklaşık 56,1 saniye beklerdim. Bunun nedeni ikinci grafikte görülüyor: model metni okurken saniyede işlediği token sayısı da metin uzadıkça düşüyor.
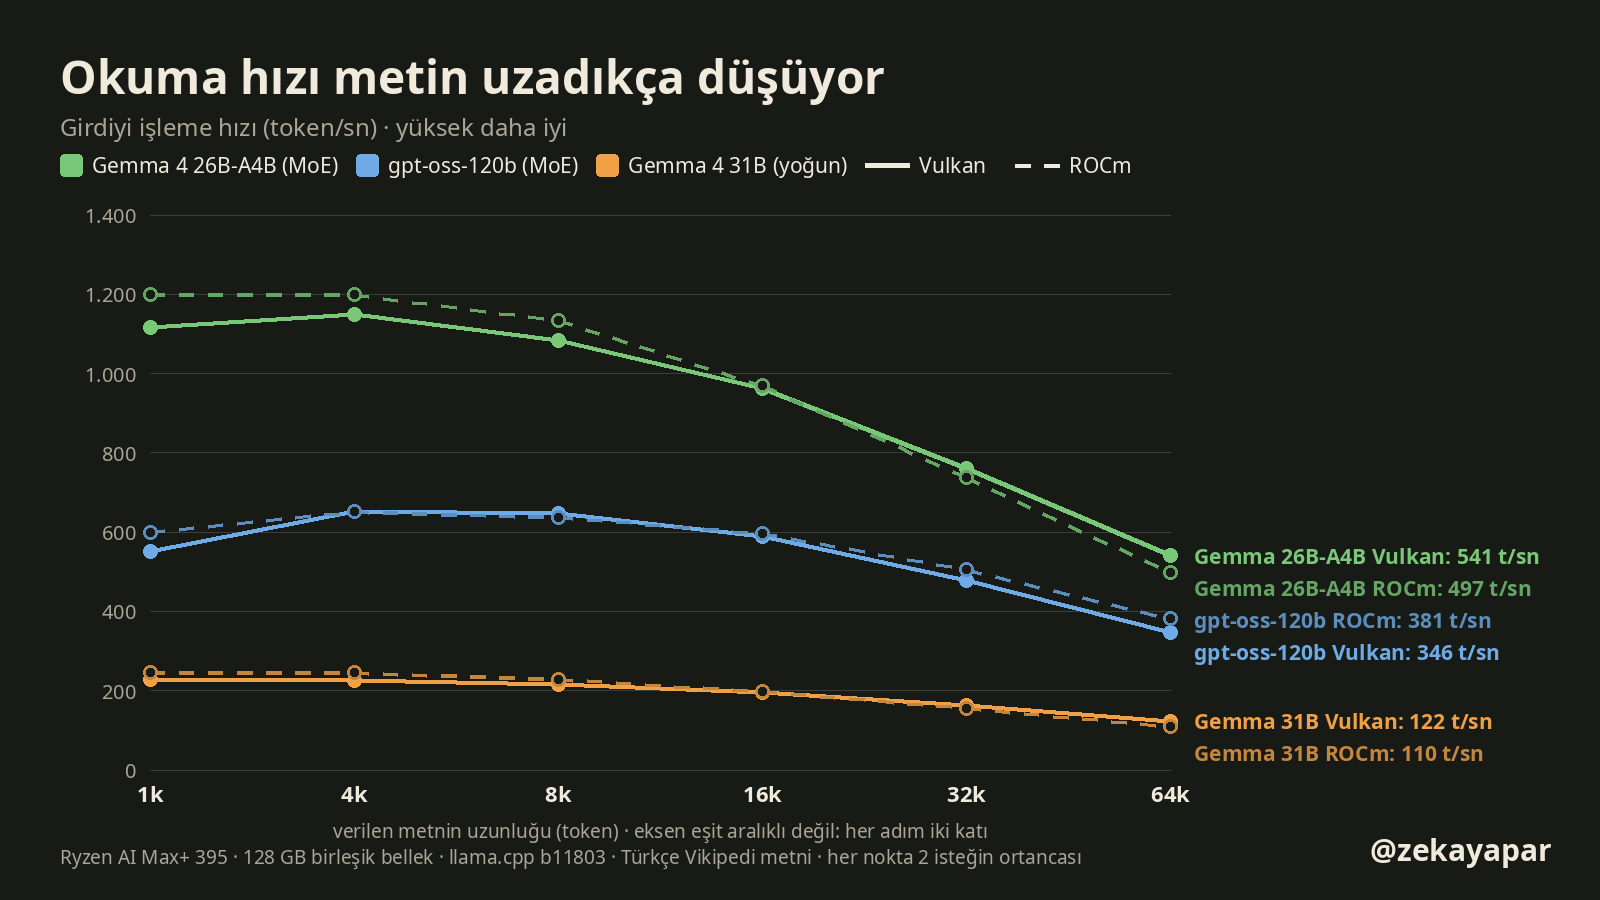
1k’dan 64k’ya okuma hızındaki düşüş (Vulkan): Gemma 4 26B-A4B %52; gpt-oss-120b %37; Gemma 4 31B %46. Bir dil modeli her yeni token’ı okurken önceki bütün token’lara bakıyor. Metnin başında bakılacak az şey var, 60 bininci token’da ise önünde 60 bin token duruyor. Bu yüzden her token biraz daha pahalı hâle geliyor. Düşüşün büyüklüğü modele göre değişiyor; bunu modellerin dikkat katmanlarının farklı kurulmasına bağlamak akla yatkın ama ayrıca ölçmedim.
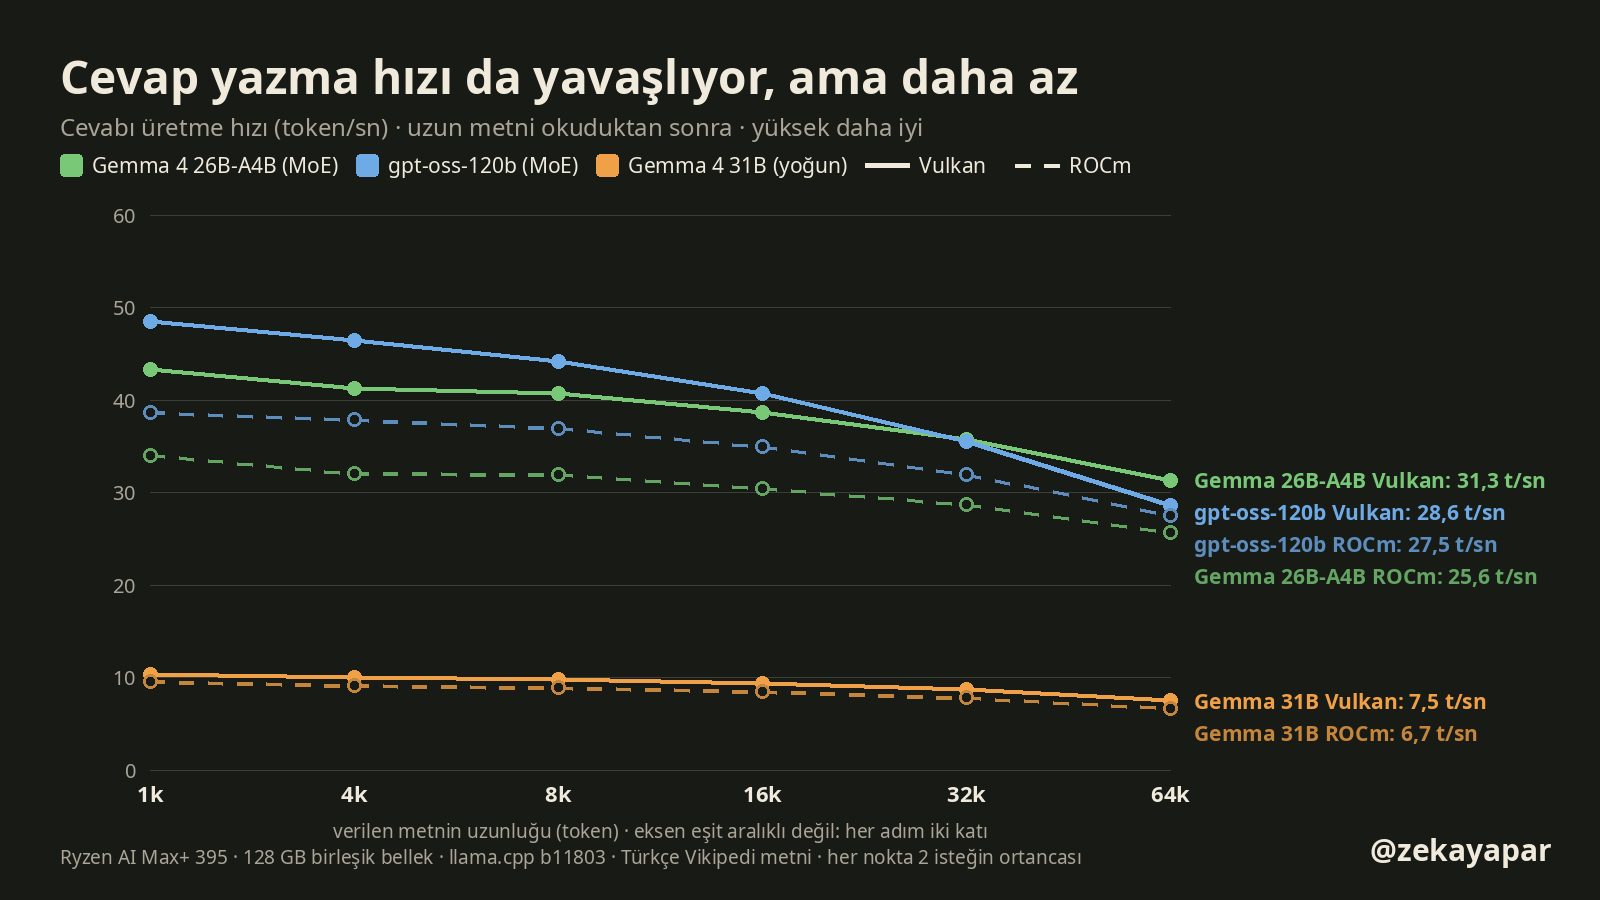
Cevabı yazma hızı da düşüyor ama daha az. Saniyede token, 1k ve 64k token’lık metinden sonra (Vulkan): Gemma 4 26B-A4B 43,3 → 31,3; gpt-oss-120b 48,5 → 28,6; Gemma 4 31B 10,3 → 7,5. Yazarken model her yeni kelime için yine bütün metne bakıyor, ama bu iş tek token için yapılıyor; asıl süreyi model ağırlıklarını bellekten okumak alıyor. Yoğun 31B model, her token’da 31 milyar parametrenin hepsini okuduğu için 4–5 milyar parametre çalıştıran MoE modellerden dört kattan fazla yavaş yazıyor.
Vulkan mı ROCm mi?
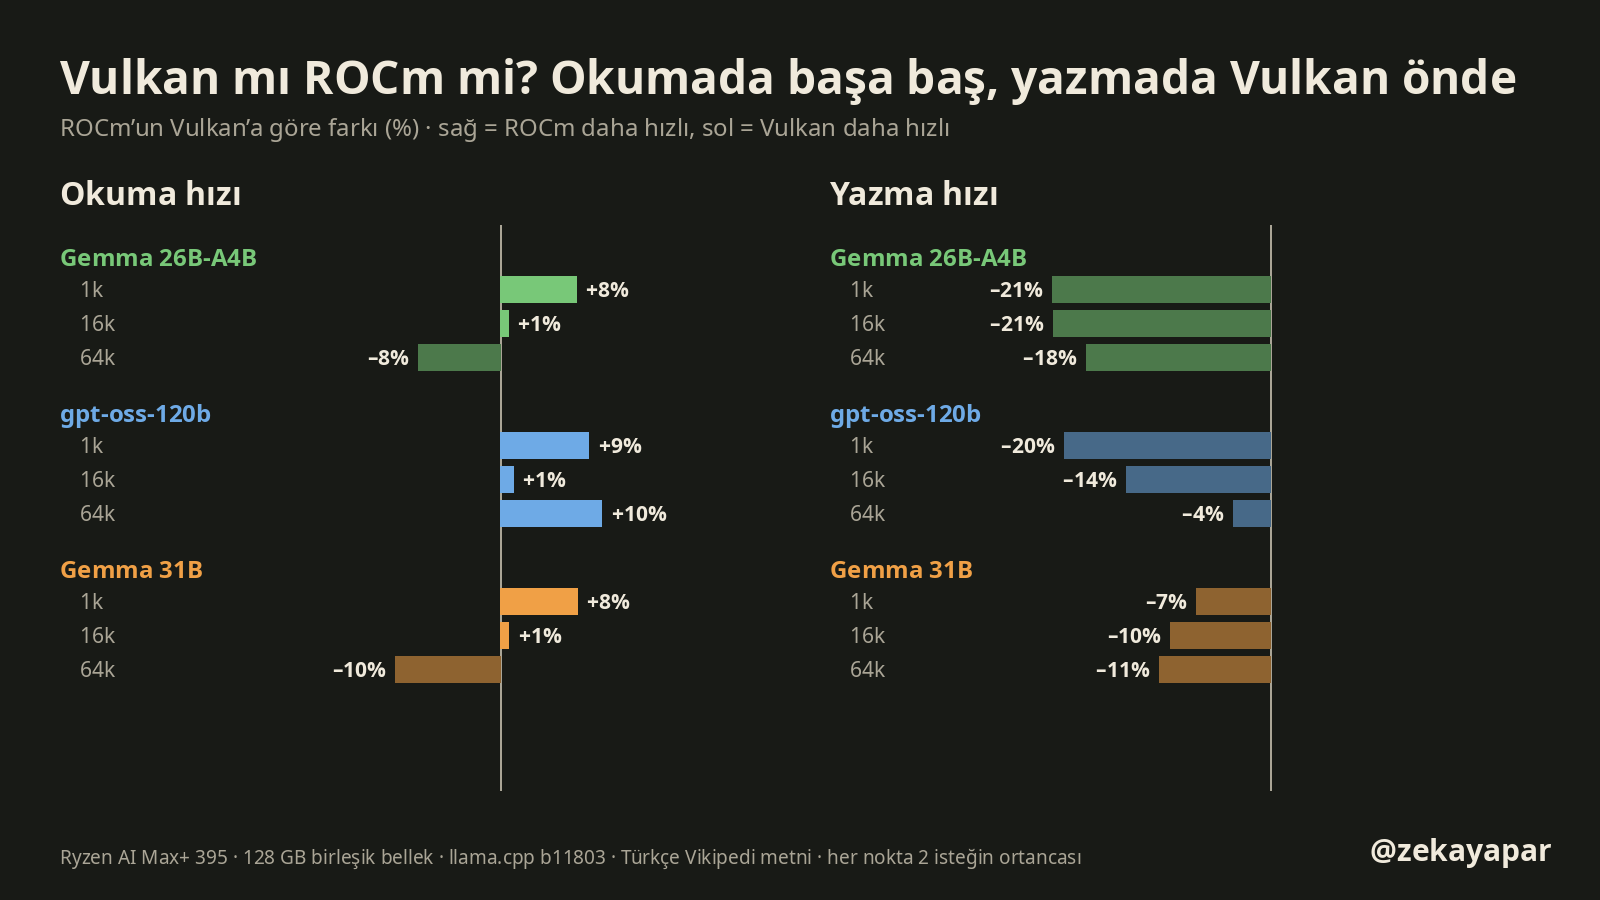
Bu makinede GPU’ya iki yoldan ulaşılabiliyor: Vulkan ve AMD’nin ROCm’u. Okuma hızında ROCm’un Vulkan’a göre farkı: Gemma 4 26B-A4B 1k: +%8, 64k: –%8; gpt-oss-120b 1k: +%9, 64k: +%10; Gemma 4 31B 1k: +%8, 64k: –%10. Yazma hızında 64k token’da: Gemma 4 26B-A4B 64k: –%18; gpt-oss-120b 64k: –%4; Gemma 4 31B 64k: –%11. Yazmada her modelde ve her uzunlukta Vulkan önde. Okumada fark iki yönde de %10 civarında kalıyor: kısa metinde ROCm biraz önde, 64k’da Gemma modellerinde Vulkan, gpt-oss’ta ROCm önde. Ölçünce bu küçük fark yine de hissediliyor; Gemma 31B 64k token’lık metni Vulkan’da 8 dakika 56 saniye, ROCm’da 9 dakika 57 saniye okudu. Benim için pratik sonuç: bu makinede varsayılanım Vulkan; uzun belge okutacaksam iki yolu kendi modelimle bir kez denemek yeterli. Bu fark sürücü ve llama.cpp sürümüyle değişebilir; bu ölçüm b11803 ve ROCm 10.1 için.
Sakladığım kodu buldu mu?
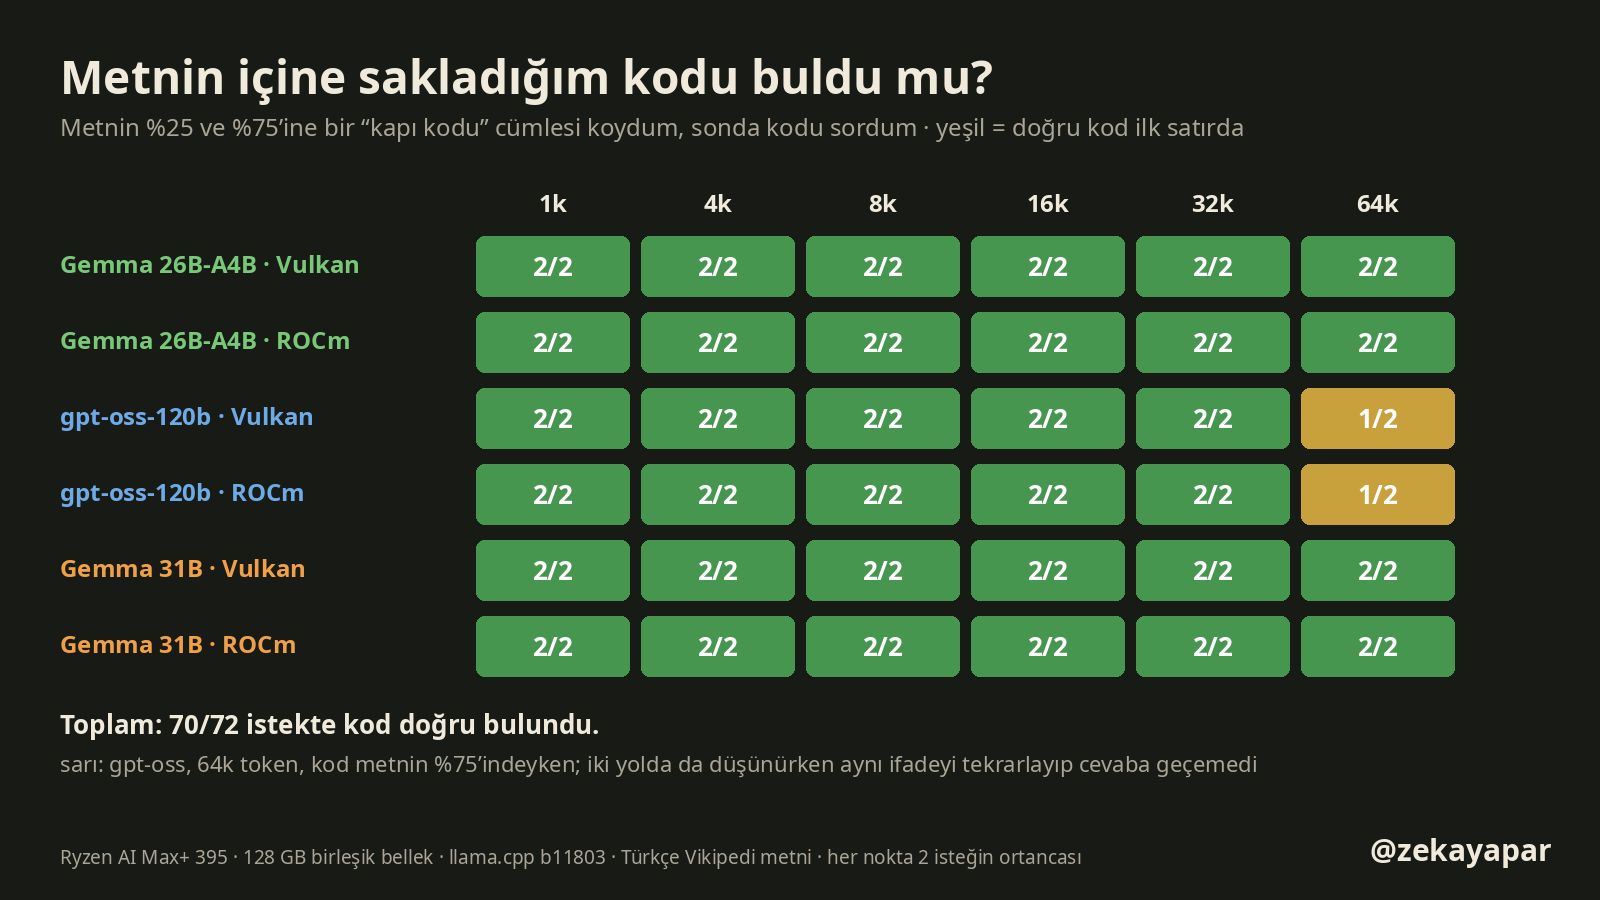
72 isteğin 70 tanesinde model doğru kodu ilk satıra yazdı. Gemma modelleri 64k token’da, yaklaşık 123 sayfalık metnin içine saklanmış tek cümleyi her denemede buldu. Özetin kendisini puanlamadım; ama okuduğum örneklerde özet metnin başındaki İstanbul maddesine dayanıyordu.
Başarısız olan 2 istek aynı koşuldu: gpt-oss-120b, 64k token, kod metnin %75’inde; biri Vulkan, biri ROCm ile. İkisinde de model cevaba hiç geçemedi. Kısa tutmasını istediğim düşünme bölümünde metinde geçen “6 Şubat 2023” ifadesini tekrar etmeye başladı ve 400 token’lık sınırın hepsini buna harcadı. Düşünme metninde kodu aradığı ama bu ifadeye takılıp kaldığı görülüyor. Vulkan’daki düşünme metninin sonu, aynen:
tarihinde gerçekleşen ...". Not.

Wait earlier: "6 Şubat 2023 tarihinde gerçekleşen ...". Also: "6 Şubat 2023 tarihinde gerçekleşen ...". Not.

Maybe code appears: "6 Şubat 2023 tarihinde gerçekleşen ...". No.

Search for "kapı". I see: "6 Şubat 2023 tarihinde
Aynı model aynı uzunlukta öbür denemelerde doğru cevap verdi. Örneğin ROCm ile, kod %25’teyken çıktının başı:
4817

İstanbul, Türkiye’nin en kalabalık ve ekonomik‑kültürel merkezi olup nüfusu 15,7 milyonu aşmaktadır; nüfusunun üçte ikisi Avrupa, geri kalanı Asya yakasında yaşamaktadır. Şehir, tarih boyunca Roma, Bizans ve Osmanlı imparatorluklarının başkenti olarak hizmet vermiş ve 1453’te Fatih Sultan Mehmet tarafından fethedilmiştir. Arkeolojik buluntular, insan varlığının 400 000 yıl öncesine kadar uzandığını gösterirke
Gemma 4 31B’nin 64k token’lık metinden sonraki cevabı (Vulkan, kod %75’te), kesmeden:
6293

İstanbul, Türkiye'nin ekonomik, kültürel ve tarihî merkezi olan, iki kıtaya yayılan en kalabalık şehridir. Jeopolitik konumu nedeniyle tarih boyunca Roma, Bizans ve Osmanlı gibi büyük imparatorluklara başkentlik yapmıştır. Şehir, binlerce yıllık yerleşim geçmişiyle dünyanın en eski ve kozmopolit metropollerinden biri olarak kabul edilir. Coğrafi olarak Marmara Denizi ile Karadeniz arasında yer alan kent, zengin bir bitki örtüsüne ve stratejik bir su yoluna sahiptir. Günümüzde ticaret, sanayi, eğitim ve turizm alanlarında Türkiye'nin öncü merkezi olma özelliğini sürdürmektedir. Nüfus yapısı ve altyapısı, tarihsel süreçteki büyüme ve modernleşme etkileriyle sürekli değişim göstermektedir.
Elektrik ve bellek
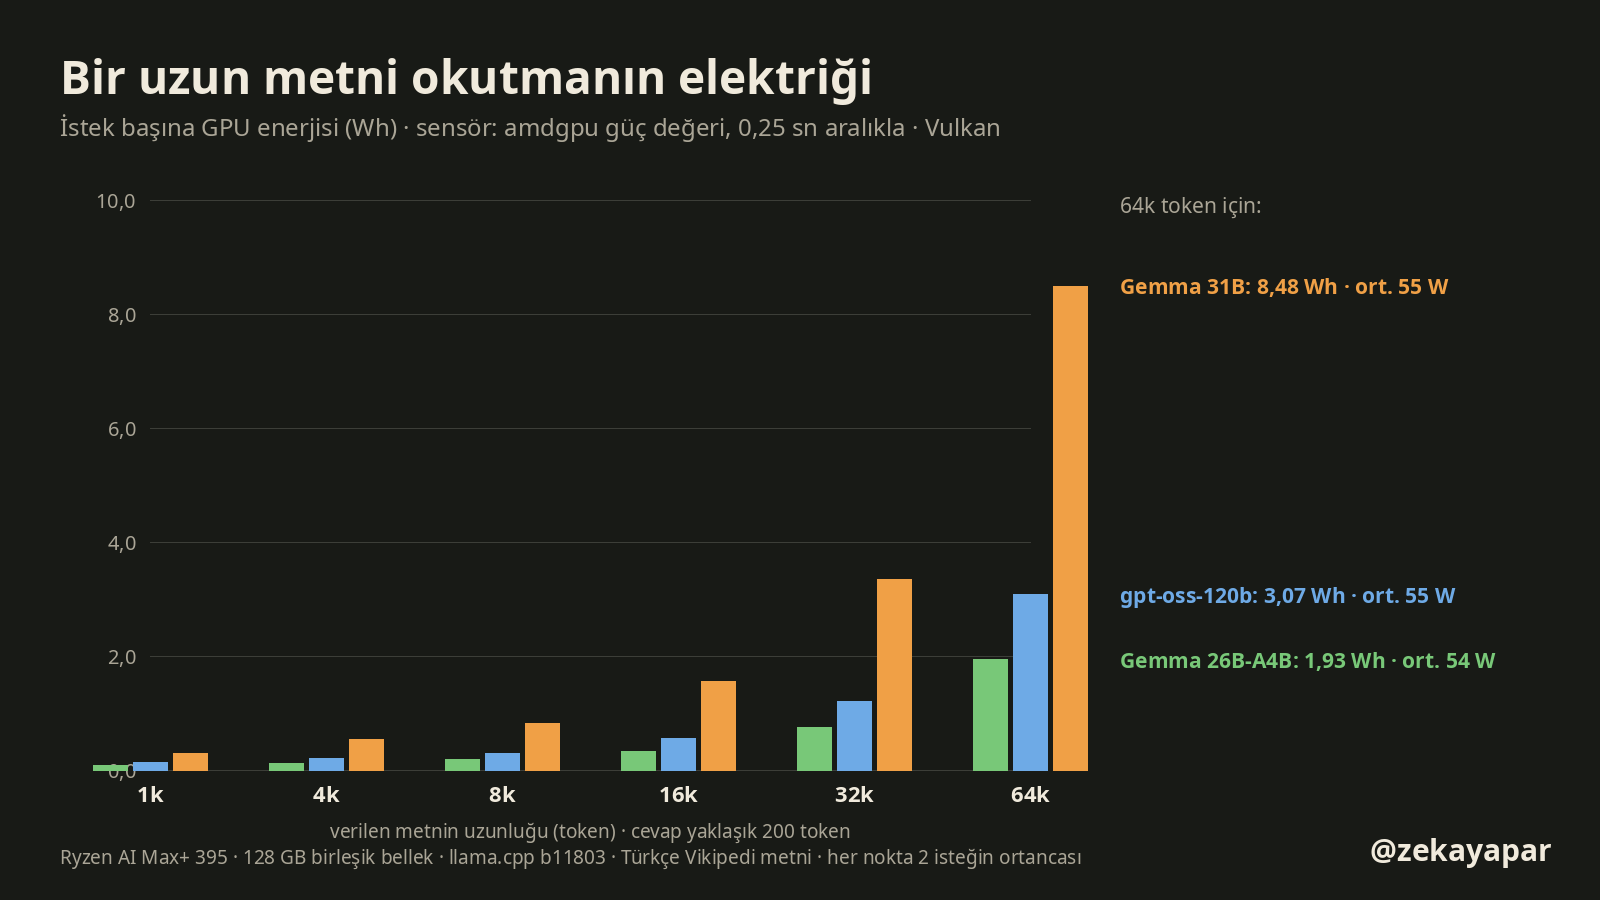
İstek sırasında ekran kartı tarafının güç değerini çeyrek saniyede bir okudum ve topladım. 64k token’lık bir isteğin enerjisi (Vulkan): Gemma 4 26B-A4B 1,93 Wh; gpt-oss-120b 3,07 Wh; Gemma 4 31B 8,48 Wh. Bu, makinenin tamamı değil, yalnız sürücünün bildirdiği GPU gücü; ortalama 54–55 W civarında kalıyor. Yani uzun metin okutmanın elektriği küçük; asıl bedel beklenen süre.
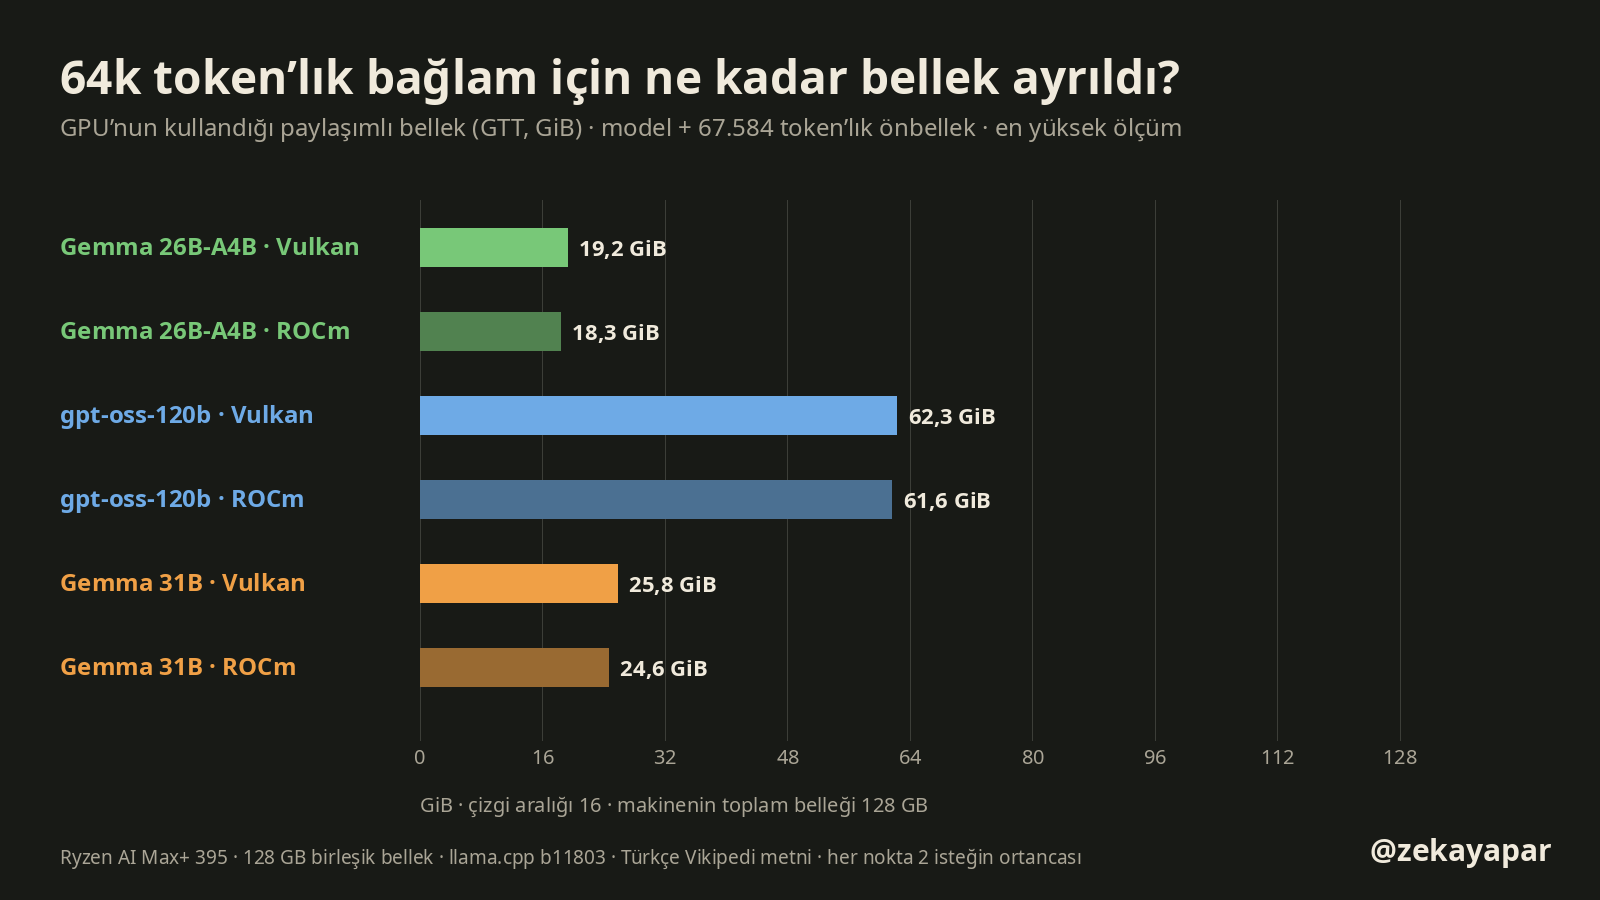
llama.cpp bağlam önbelleğini sunucu açılırken bir kerede ayırıyor; bu yüzden bellek kullanımı metin uzunluğuna göre değil, açılıştaki bağlam ayarına göre belirleniyor. 67.584 token’lık bağlamla en yüksek ölçüm: Gemma 26B-A4B 19,2 GiB, gpt-oss-120b 62,3 GiB, Gemma 31B 25,8 GiB. 128 GB’lık makinede en büyük model bile rahat sığıyor, yanında masaüstü ve tarayıcı da çalışıyordu.
Günlük kullanımda ne demek?
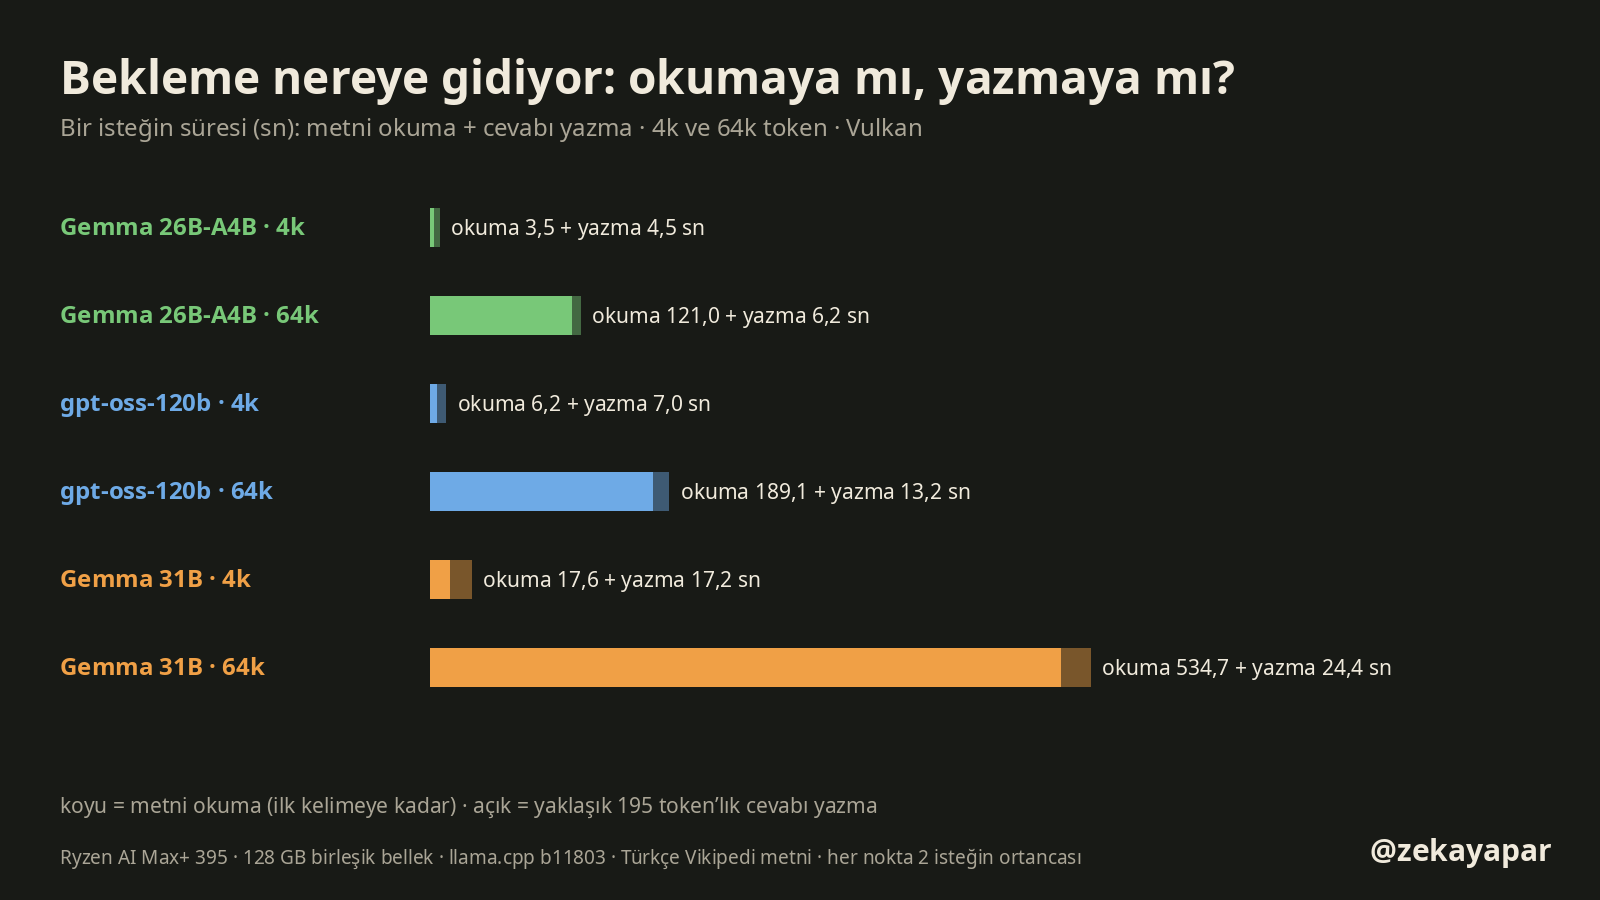
Kısa metinde zamanın çoğu cevabı yazmaya gidiyor: Gemma 26B-A4B 4k token’da 3,5 saniye okuyup 4,5 saniye yazdı. 64k token’da tablo tersine dönüyor: 121,0 saniye okuma, 6,2 saniye yazma. Uzun belgeyle çalışırken beklediğim şey okuma.
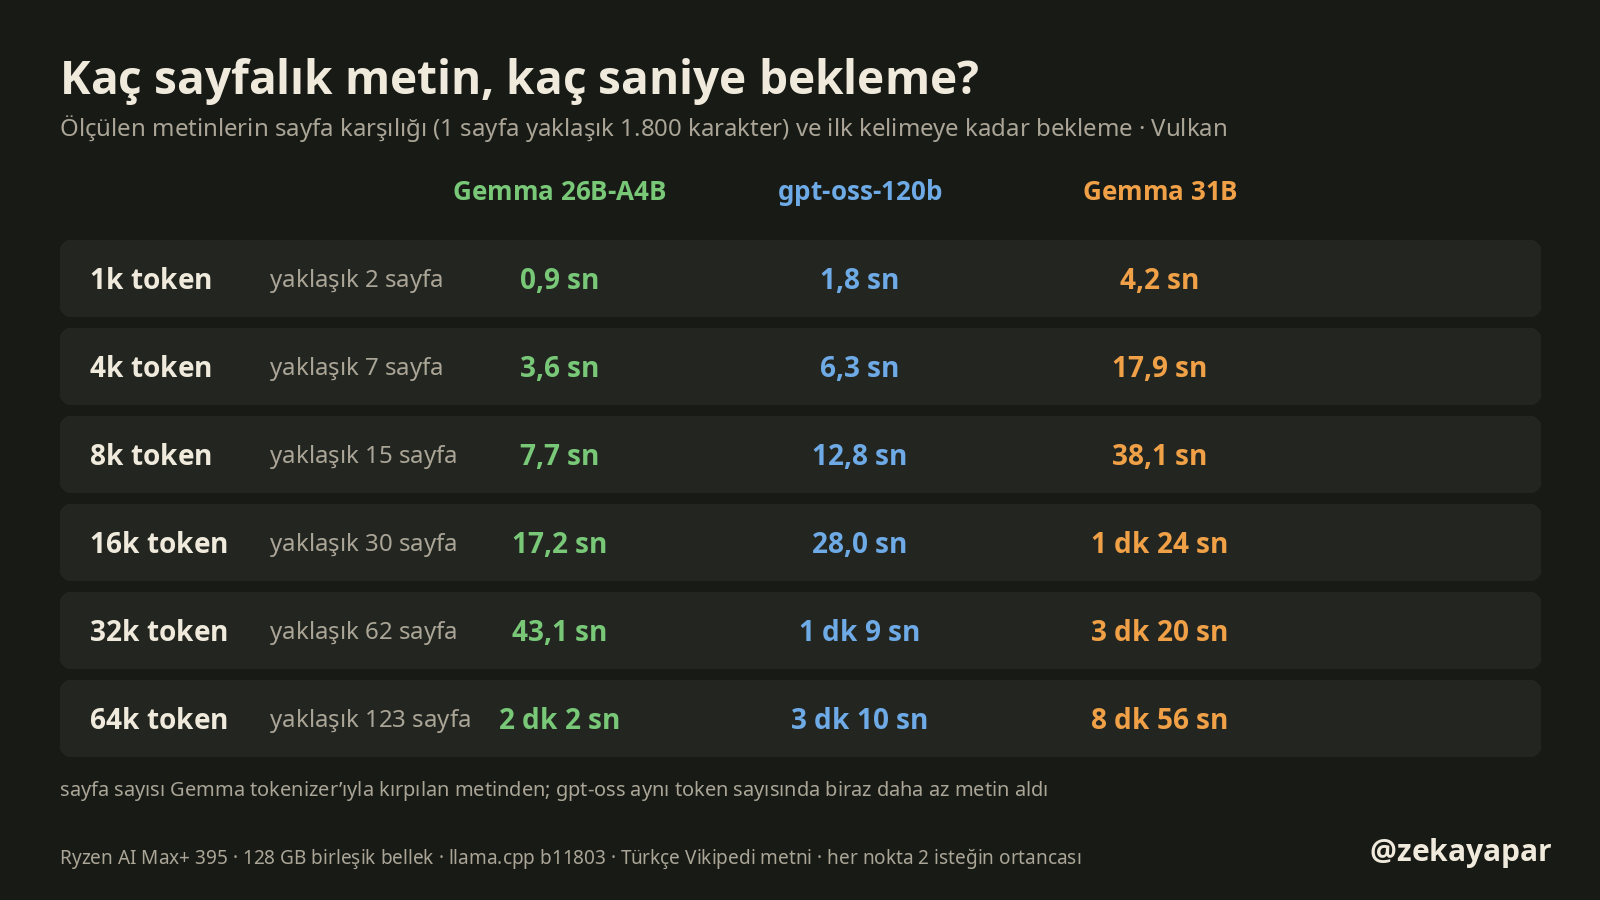
Sayfa olarak düşünürsem (bir sayfa yaklaşık 1.800 karakter): 30 sayfalık bir rapor 16k token civarı; Gemma 26B-A4B bunu 17,2 saniye, Gemma 31B 1 dakika 24 saniye okuyor. 123 sayfalık bir metinde ise MoE modellerle birkaç dakika, yoğun modelle 8 dakika 56 saniye bekliyorum. Aynı belgeye arka arkaya soru soracaksam bu bekleme bir kez ödenebilir: llama.cpp’nin hazır hesap önbelleği açıkken ikinci soru metni yeniden okumaz. Bu ölçümde önbelleği bilerek kapattım, her istek ilk soru gibi.
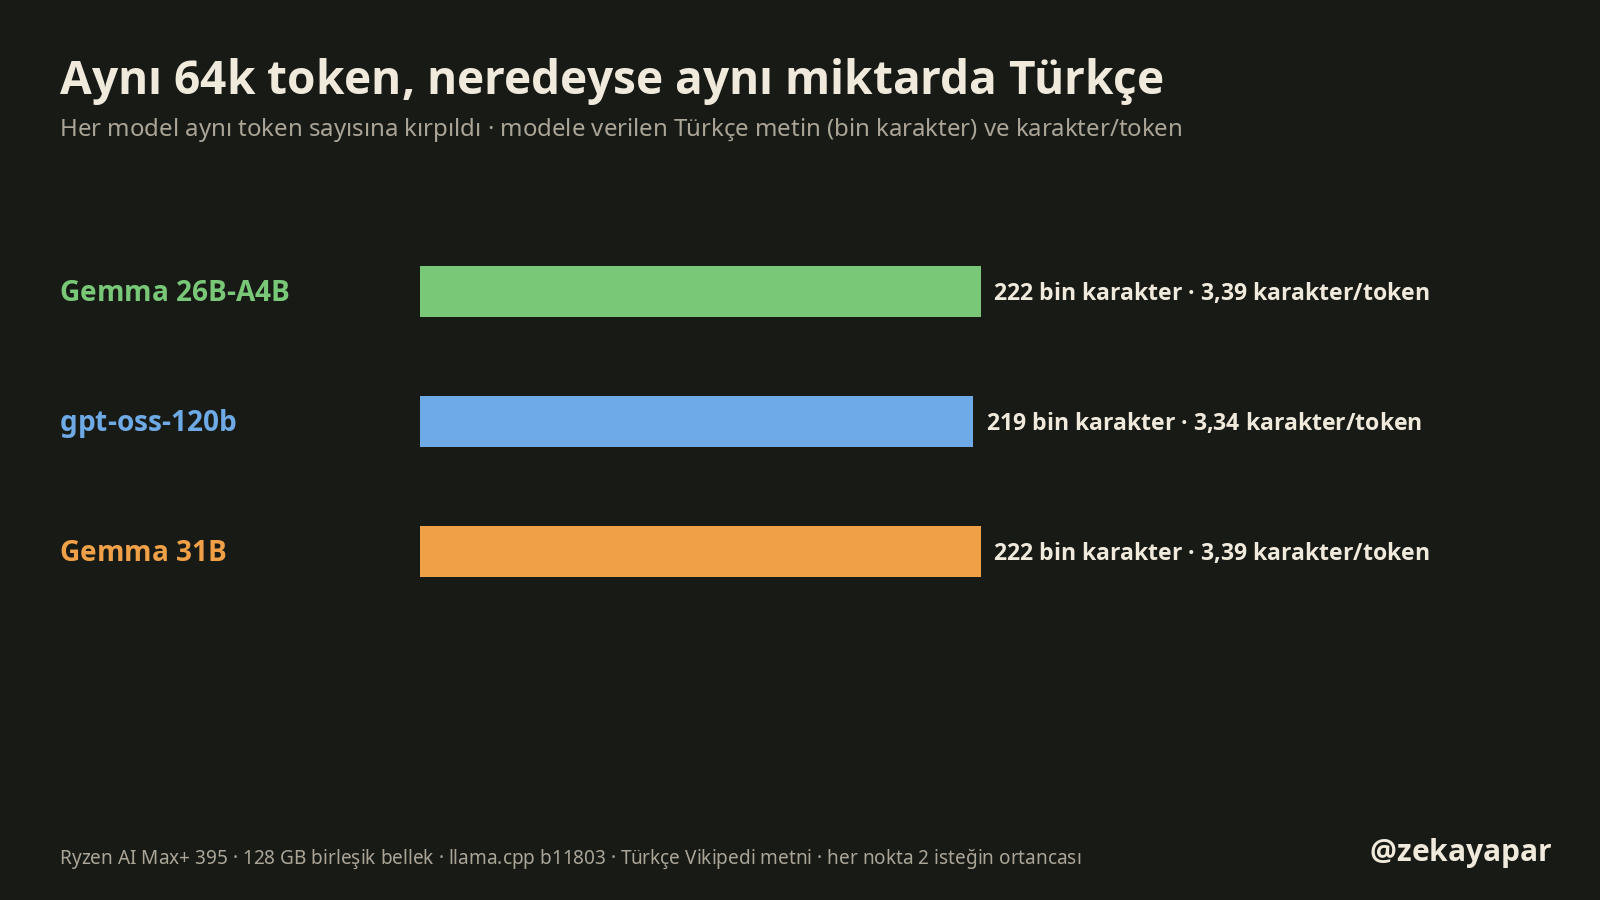
Bir ayrıntı: 64k token aynı miktarda Türkçe demek değil. Gemma’nın tokenizer’ı token başına 3,39, gpt-oss’unki 3,34 karakter tuttu. Yani aynı 64k token’da gpt-oss %1,4 daha az metin okudu. Türkçede bu iki tokenizer birbirine yakın; sayfa üzerinden kıyas bu yüzden adil kalıyor.
Benim için sonuç
Bu makinede uzun belge okutmak mümkün ve doğru çalışıyor: 70/72 istekte saklı kodu buldu. Ama bekleme metin uzunluğuyla doğru orantılı değil, daha hızlı artıyor. Birkaç sayfalık işler için MoE modeller saniyeler içinde cevap veriyor. Kitap boyutuna yaklaşan bir metinde (yaklaşık 123 sayfa) iki-üç dakika beklemeyi göze almak gerekiyor; yoğun Gemma 31B’de bu bekleme 8 dakika 56 saniye (ROCm’da 9 dakika 57 saniye). Uzun belgeyle çalışacaksam ilk tercihim MoE model ve aynı belgeye birden çok soru soracaksam önbelleği açık tutmak olurdu.
Sınırlar
- Tek makine, tek llama.cpp sürümü, üç model. Başka sürüm ya da ayar sonuçları değiştirebilir.
- Her nokta iki isteğin ortancası; aynı koşuldaki iki istek arasındaki hız farkı en çok %3,6 oldu, ama bu küçük bir örnek.
- gpt-oss’un iki başarısız isteği 400 token’lık cevap sınırında kesildi; daha yüksek sınırda döngüden çıkıp çıkmayacağını denemedim.
- Saklı kod testi basit bir bulma testi; uzun metni anlama ve özetleme kalitesini ölçmüyor. Özetleri puanlamadım.
- Enerji yalnız GPU sürücüsünün bildirdiği güçten hesaplandı, duvardan ölçülmedi.
- 64k token’ın üstünü (128k gibi) bu turda ölçmedim.
Tam tablo ve yöntem
| Model | Yol | Hedef | Girdi token | Karakter | İlk kelime (sn) | Okuma (t/sn) | Yazma (t/sn) | Toplam (sn) | Kod | Enerji (Wh) | GTT (GiB) |
|---|---|---|---|---|---|---|---|---|---|---|---|
| Gemma 4 26B-A4B | Vulkan | 1k | 900 | 2.971 | 0,88 | 1.115 | 43,3 | 4,8 | 2/2 | 0,08 | 18,9 |
| Gemma 4 26B-A4B | Vulkan | 4k | 3.972 | 13.252 | 3,56 | 1.149 | 41,3 | 8,0 | 2/2 | 0,12 | 18,9 |
| Gemma 4 26B-A4B | Vulkan | 8k | 8.068 | 26.576 | 7,67 | 1.082 | 40,7 | 12,4 | 2/2 | 0,19 | 18,9 |
| Gemma 4 26B-A4B | Vulkan | 16k | 16.260 | 54.884 | 17,19 | 961 | 38,7 | 22,1 | 2/2 | 0,33 | 18,9 |
| Gemma 4 26B-A4B | Vulkan | 32k | 32.644 | 111.218 | 43,14 | 761 | 35,7 | 48,8 | 2/2 | 0,74 | 19,0 |
| Gemma 4 26B-A4B | Vulkan | 64k | 65.412 | 221.820 | 121,51 | 541 | 31,3 | 127,7 | 2/2 | 1,93 | 19,2 |
| Gemma 4 26B-A4B | ROCm | 1k | 900 | 2.971 | 0,81 | 1.199 | 34,0 | 5,8 | 2/2 | 0,09 | 18,3 |
| Gemma 4 26B-A4B | ROCm | 4k | 3.972 | 13.252 | 3,40 | 1.198 | 32,0 | 8,9 | 2/2 | 0,13 | 18,3 |
| Gemma 4 26B-A4B | ROCm | 8k | 8.068 | 26.576 | 7,31 | 1.134 | 32,0 | 13,3 | 2/2 | 0,20 | 18,3 |
| Gemma 4 26B-A4B | ROCm | 16k | 16.260 | 54.884 | 17,04 | 969 | 30,4 | 23,6 | 2/2 | 0,36 | 18,3 |
| Gemma 4 26B-A4B | ROCm | 32k | 32.644 | 111.218 | 44,45 | 738 | 28,7 | 51,6 | 2/2 | 0,78 | 18,3 |
| Gemma 4 26B-A4B | ROCm | 64k | 65.412 | 221.820 | 131,99 | 497 | 25,6 | 139,5 | 2/2 | 2,11 | 18,3 |
| gpt-oss-120b | Vulkan | 1k | 965 | 3.019 | 1,84 | 552 | 48,5 | 8,6 | 2/2 | 0,13 | 62,1 |
| gpt-oss-120b | Vulkan | 4k | 4.037 | 13.335 | 6,31 | 651 | 46,5 | 13,3 | 2/2 | 0,20 | 62,1 |
| gpt-oss-120b | Vulkan | 8k | 8.133 | 26.616 | 12,77 | 646 | 44,1 | 19,5 | 2/2 | 0,29 | 62,1 |
| gpt-oss-120b | Vulkan | 16k | 16.325 | 54.487 | 27,97 | 589 | 40,7 | 36,7 | 2/2 | 0,56 | 62,1 |
| gpt-oss-120b | Vulkan | 32k | 32.709 | 110.227 | 69,01 | 477 | 35,5 | 79,6 | 2/2 | 1,20 | 62,2 |
| gpt-oss-120b | Vulkan | 64k | 65.477 | 218.859 | 189,82 | 346 | 28,6 | 202,9 | 1/2 | 3,07 | 62,3 |
| gpt-oss-120b | ROCm | 1k | 965 | 3.019 | 1,74 | 600 | 38,7 | 9,1 | 2/2 | 0,14 | 61,6 |
| gpt-oss-120b | ROCm | 4k | 4.037 | 13.335 | 6,35 | 652 | 37,8 | 15,2 | 2/2 | 0,23 | 61,6 |
| gpt-oss-120b | ROCm | 8k | 8.133 | 26.616 | 12,97 | 638 | 36,9 | 21,1 | 2/2 | 0,32 | 61,6 |
| gpt-oss-120b | ROCm | 16k | 16.325 | 54.487 | 27,64 | 597 | 34,9 | 36,6 | 2/2 | 0,55 | 61,6 |
| gpt-oss-120b | ROCm | 32k | 32.709 | 110.227 | 65,01 | 506 | 32,0 | 75,4 | 2/2 | 1,14 | 61,6 |
| gpt-oss-120b | ROCm | 64k | 65.477 | 218.859 | 172,57 | 381 | 27,5 | 186,5 | 1/2 | 2,82 | 61,6 |
| Gemma 4 31B | Vulkan | 1k | 900 | 2.971 | 4,17 | 229 | 10,3 | 19,6 | 2/2 | 0,29 | 25,0 |
| Gemma 4 31B | Vulkan | 4k | 3.972 | 13.252 | 17,91 | 226 | 10,1 | 35,1 | 2/2 | 0,53 | 25,1 |
| Gemma 4 31B | Vulkan | 8k | 8.068 | 26.576 | 38,11 | 216 | 9,8 | 54,5 | 2/2 | 0,82 | 25,1 |
| Gemma 4 31B | Vulkan | 16k | 16.260 | 54.884 | 83,59 | 197 | 9,4 | 103,0 | 2/2 | 1,55 | 25,2 |
| Gemma 4 31B | Vulkan | 32k | 32.644 | 111.218 | 199,93 | 164 | 8,7 | 220,3 | 2/2 | 3,33 | 25,4 |
| Gemma 4 31B | Vulkan | 64k | 65.412 | 221.820 | 536,17 | 122 | 7,5 | 560,6 | 2/2 | 8,48 | 25,8 |
| Gemma 4 31B | ROCm | 1k | 900 | 2.971 | 3,87 | 246 | 9,6 | 20,4 | 2/2 | 0,31 | 24,6 |
| Gemma 4 31B | ROCm | 4k | 3.972 | 13.252 | 16,49 | 245 | 9,1 | 33,9 | 2/2 | 0,51 | 24,6 |
| Gemma 4 31B | ROCm | 8k | 8.068 | 26.576 | 36,02 | 229 | 8,9 | 54,2 | 2/2 | 0,82 | 24,6 |
| Gemma 4 31B | ROCm | 16k | 16.260 | 54.884 | 82,83 | 198 | 8,5 | 102,1 | 2/2 | 1,54 | 24,6 |
| Gemma 4 31B | ROCm | 32k | 32.644 | 111.218 | 209,80 | 156 | 7,8 | 231,9 | 2/2 | 3,51 | 24,6 |
| Gemma 4 31B | ROCm | 64k | 65.412 | 221.820 | 597,43 | 110 | 6,7 | 624,5 | 2/2 | 9,44 | 24,6 |
Değerler iki isteğin ortancası (kod sütunu: doğru/istek). Okuma ve yazma hızları llama.cpp sunucusunun kendi zamanlamalarından (timings), ilk kelime süresi istemci tarafında akıştan ölçüldü.
Donanım ve yazılım: ASUS ProArt, AMD Ryzen AI Max+ 395, Radeon 8060S, 128 GB LPDDR5X birleşik bellek, Ubuntu (çekirdek 7.0). llama.cpp b11803 (commit a37cc4610) resmî Vulkan ve ROCm derlemeleri, ROCm 10.1. Sunucu: -c 67584 -ngl 999 -fa on -np 1; istek: sıcaklık 0, top_k 1, seed 1, cache_prompt: false, en çok 400 token, Gemma için enable_thinking: false, gpt-oss için reasoning_effort: low.
Modeller: unsloth/gemma-4-26B-A4B-it-GGUF @ c099eb48 (UD-Q4_K_M, SHA256 f2c28b3d…), unsloth/gemma-4-31B-it-GGUF @ c1ac76e9 (Q4_K_M, SHA256 38bd64c8…), ggml-org/gpt-oss-120b-GGUF @ 7200b74b (MXFP4, SHA256 582bd40f…).
Metin: Türkçe Vikipedi, CC BY-SA 4.0; birleşik metin SHA256 26664db104f818ba9d977dafa4bbf73b41f994a4958f6b52310d38ffd79d740f.
- İstanbul · revizyon 38102076 · 91.376 karakter
- Osmanlı İmparatorluğu · revizyon 38344072 · 126.393 karakter
- Türk Kurtuluş Savaşı · revizyon 38343529 · 48.438 karakter
- Mustafa Kemal Atatürk · revizyon 38321557 · 155.536 karakter
- Ankara · revizyon 38260985 · 28.371 karakter
- Türk mutfağı · revizyon 37198475 · 10.559 karakter
- İzmir · revizyon 38204638 · 41.482 karakter
- Büyük Selçuklu İmparatorluğu · revizyon 38120846 · 32.382 karakter
İndir: betikler, metin ve tüm istek/cevap kayıtları (ZIP) · özet (JSON) · istek başına sonuçlar (CSV).