 zekayapar
Yapay zekâya “düşün” deyince Türkçe sorularda ne değişiyor?
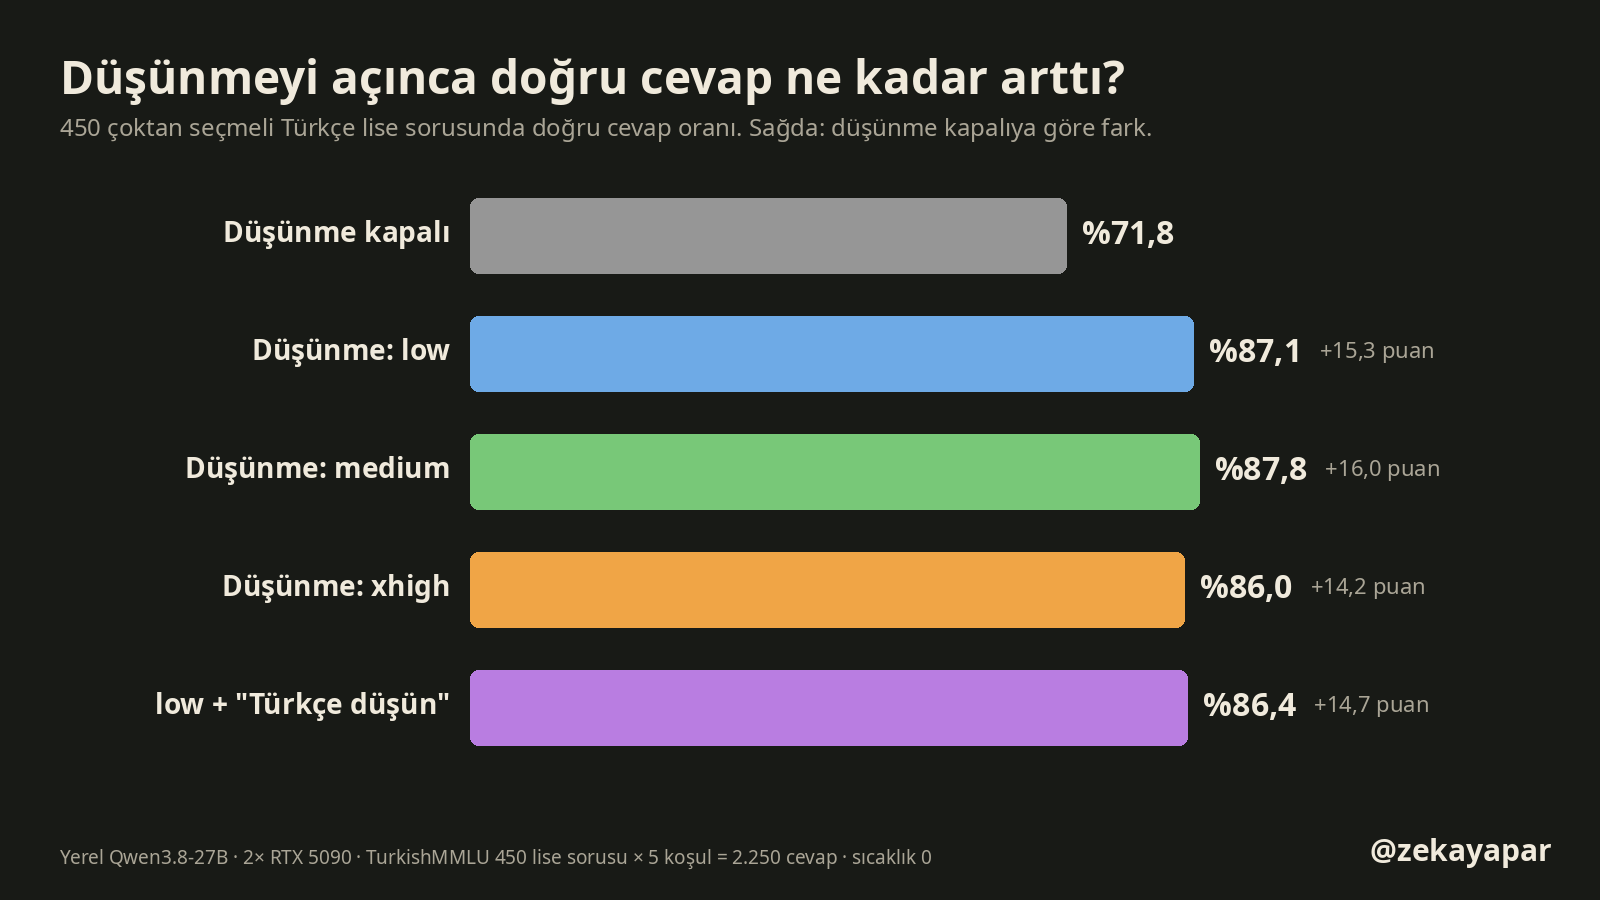
Yerel Qwen’e 450 Türkçe lise sorusunu düşünme kapalı ve üç seviyede sordum: doğruluk %72’den %87’ye çıktı; en uzun seviye 3,4 kat token harcadı, kazandırmadı.
Model ve sunucu
- Qwen3.8-27B NVFP4 · vLLM 0.30.0
- 2× RTX 5090 (TP2, 450 W)
- Düşünme: kapalı / low / medium / xhigh · sıcaklık 0
Veri ve ölçüm
- TurkishMMLU · 9 dersten 450 lise sorusu
- 5 koşul = 2.250 cevap · 8 eşzamanlı istek
- Tek kullanıcı bekleme: 18 soru × 4 koşul, sırayla
Soru: Yeni modellerin çoğunda bir “düşünme” ayarı var: açınca model cevaptan önce kendi kendine bir taslak yazıyor. Türkçe sorularda bu ne kadar fark ediyor, ne kadar bekletiyor ve model o taslağı hangi dilde yazıyor? Kısa cevap: Düşünme kapalıyken model 450 lise sorusunun %71,8 oranında doğru cevap verdi; düşünmeyi açınca seviyeye göre %86,0 ile %87,8 arasına çıktı. En kısa düşünme seviyesi yetti: en uzun seviye en kısanın 3,4 katı token yazdı, doğruluğu artırmadı. Model bu Türkçe soruların büyük çoğunluğunda İngilizce düşündü.
Düşünme ayarını genelde “zor sorularda aç” diye öneriyorlar ama bunun Türkçe sorularda kaç puan, kaç saniye ettiğini gösteren bir sayı görmedim. Masamdaki yerel modelle, cevabı belli sorular üzerinde ölçtüm.
Nasıl ölçtüm
Cevabı belli Türkçe sorular için açık yayımlanan TurkishMMLU veri setinin test bölümünü kullandım: biyoloji, kimya, coğrafya, tarih, matematik, felsefe, fizik, din kültürü, Türk dili ve edebiyatı. Her dersten sabit tohumla rastgele 50, toplam 450 beş şıklı lise sorusu. Sorular Türkçe yazılmış, çeviri değil.
Model masaüstündeki iki RTX 5090’da çalışan Qwen3.8-27B. Bu modelin sohbet şablonu düşünmeyi kapatmaya ve açıkken üç seviye seçmeye izin veriyor. Her soruyu beş koşulda sordum:
- Düşünme kapalı: model doğrudan cevap yazıyor. Benim sunucumda varsayılan bu.
- low: düşünme açık; şablon sohbetin başına benim görmediğim bir sistem cümlesi ekliyor: “düşünmeni kısa tut, gereksiz ayrıntıya girme”.
- medium: düşünme açık, şablon hiçbir cümle eklemiyor. Modelin kendi alışkanlığı bu.
- xhigh: düşünme açık; şablonun eklediği cümle “dikkatle düşün, varsayımlarını doğrula, başka ihtimalleri de değerlendir”. Şablonda düşünme açılıp seviye seçilmezse kullanılan seviye bu.
- low + “Türkçe düşün”: low ile aynı, sorunun sonuna tek cümle ekledim: “Düşüncelerini de Türkçe yaz.”
Şablonun eklediği cümleler İngilizce; tam halleri şöyle (low ve xhigh):
Reasoning effort is set to low. Keep your thinking brief and focused, moving directly to the conclusion without unnecessary elaboration.
Reasoning effort is set to xhigh. Please think carefully through the task, validate key assumptions, consider plausible alternatives, and prioritize correctness, consistency, and clarity in the final answer.
Yani “seviye” dediğimiz şey modelin içinde bir düğme değil, sohbetin başına konan tek bir cümle. Talimat her soruda aynıydı: “Yalnızca doğru şıkkın harfini yaz.” Sıcaklık 0 (model her adımda en olası parçayı seçiyor), cevap sınırı düşünme kapalıyken 64, açıkken 12.000 token. Toplam 2.250 cevap; sunucuya aynı anda 8 istek gönderdim ve toplam 33,5 dakika sürdü. Bekleme süresini bu toplu çalışmadan değil, sunucu boşken sırayla sorduğum ayrı 18 sorudan ölçtüm.
Bir örnek. Veri setindeki kimya sorusu modele tam olarak şöyle gitti:
Rubidyum (Rb) elementinin doğada  $^{85}$ Rb ve  $^{87}$ Rb olmak üzere iki izotopu vardır. Rb elementinin ortalama atom kütlesi 85,5 olduğuna göre, doğadaki Rb atomlarının % kaçı $^{85}$Rb izotopudur?

A) 20
B) 25
C) 50
D) 75
E) 80

Yalnızca doğru şıkkın harfini yaz.
Doğru cevap D. Düşünme kapalıyken modelin bütün cevabı B oldu: yanlış. low seviyesinde önce şu taslağı yazdı (değiştirmeden):
We need to find the percentage of ⁸⁵Rb in nature.

Given:
- Two isotopes: ⁸⁵Rb and ⁸⁷Rb
- Average atomic mass = 85.5

Let x = fraction of ⁸⁵Rb
Then (1-x) = fraction of ⁸⁷Rb

Average mass = x(85) + (1-x)(87) = 85.5

85x + 87 - 87x = 85.5
-2x = 85.5 - 87
-2x = -1.5
x = 0.75

So ⁸⁵Rb is 75% of natural Rb.

The answer is D) 75.
ve cevap olarak D yazdı. Aynı soruda xhigh seviyesinde taslak Türkçe çıktı:
Kullanıcı Türkçe bir kimya sorusu sormuş. Soru: Rubidyumun iki izotopu 85Rb ve 87Rb. Ortalama atom kütlesi 85,5. Doğadaki Rb atomlarının yüzde kaçı 85Rb? Seçenekler A 20, B 25, C 50, D 75, E 80. Yalnızca doğru şıkkın harfini yaz.

Çözüm: x = 85Rb yüzdesi (0-1), 1-x = 87Rb. Ortalama = 85x + 87(1-x) = 87 - 2x = 85.5 => 2x = 1.5 => x = 0.75 = %75. Doğru D.

Kullanıcı yalnızca doğru şıkkın harfini yaz diyor. Finalde sadece "D" olmalı.
Bu hesap sorusunda farkı yaratan şey belli: düşünme kapalıyken model hesap yapacak yer bulamadan tek harf seçmek zorunda kalıyor. Taslak yazınca denklemi kurup çözüyor. Bu örnekte düşünme 188 ve 223 token tuttu.
Sonuç: düşünmek çok işe yaradı, uzun düşünmek yaramadı
Düşünme kapalıyken doğru cevap oranı %71,8. low seviyesinde %87,1 (+15,3 puan, %95 güven aralığı +11,3 ile +19,6 puan), medium seviyesinde %87,8, xhigh seviyesinde %86,0. Düşünmeyi açmanın kazancı ölçüm belirsizliğinin çok üstünde. Seviyeler arasındaki fark ise ölçümün belirsizliğinin içinde: xhigh, low’a göre –1,1 puan (aralık –3,6 ile +1,3), medium +0,7 puan.
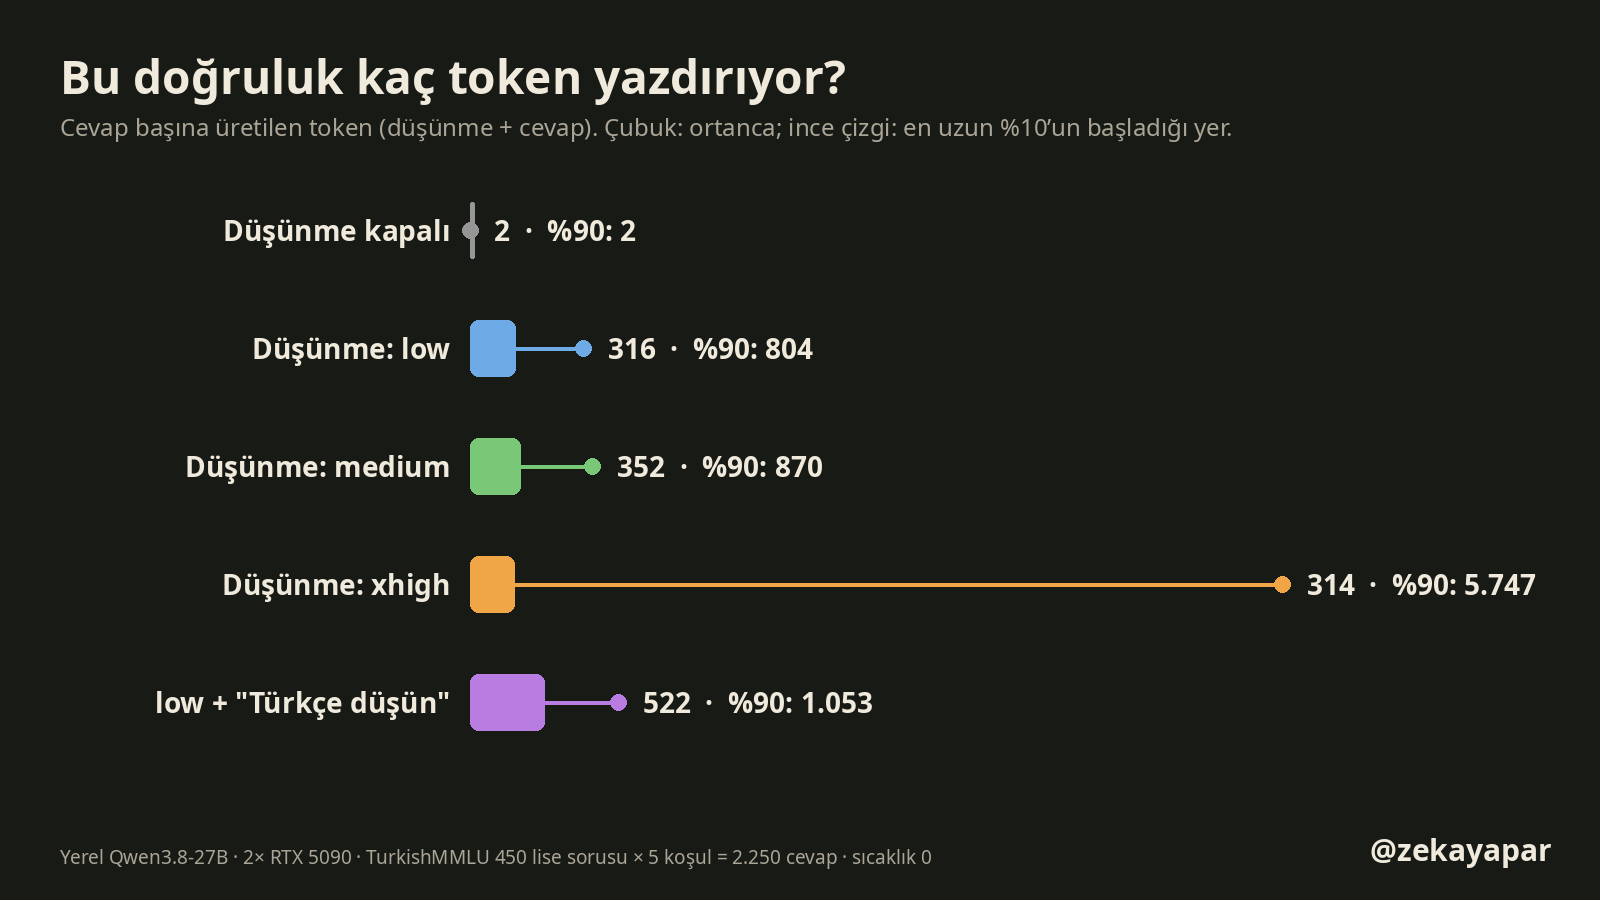
Bedel ise medium’da biraz, xhigh’ta çok büyüyor. Ortanca cevapta üç seviye birbirine yakın (316, 352 ve 314 token). Farkı uzun kuyruk yapıyor: en uzun %10’luk dilim low’da 804, xhigh’ta 5.747 tokenden başlıyor. 450 sorunun toplamında düşünme kapalıyken 2.766, low’da 197.581, medium’da 239.538, xhigh’ta 664.652 token üretildi. Bir buluta token başına para ödüyor olsaydım, yaklaşık aynı doğruluk için xhigh’ın çıktı token faturası low’un 3,4 katı olurdu.
xhigh’ta 21 soru 12.000 tokenlik sınıra dayandı ve cevap çıkmadı; bunları yanlış saydım. Taslaklarını okudum: 17 tanesinde model iki şık arasında gidip geliyor, “B’ye yakınım… ama şöyle de olabilir” diye yeniden başlıyor; 4 tanesinde aynı cümleleri tekrar eden bir döngüye girmiş. Bu 21 sorunun 9 tanesi Türk dili ve edebiyatından. Birinde soru veri setinde eksik görünüyordu (öncüller metinde yok) ve model “bilmiyorum” demek yerine on binlerce karakter boyunca öncülleri tahmin etmeye çalıştı.
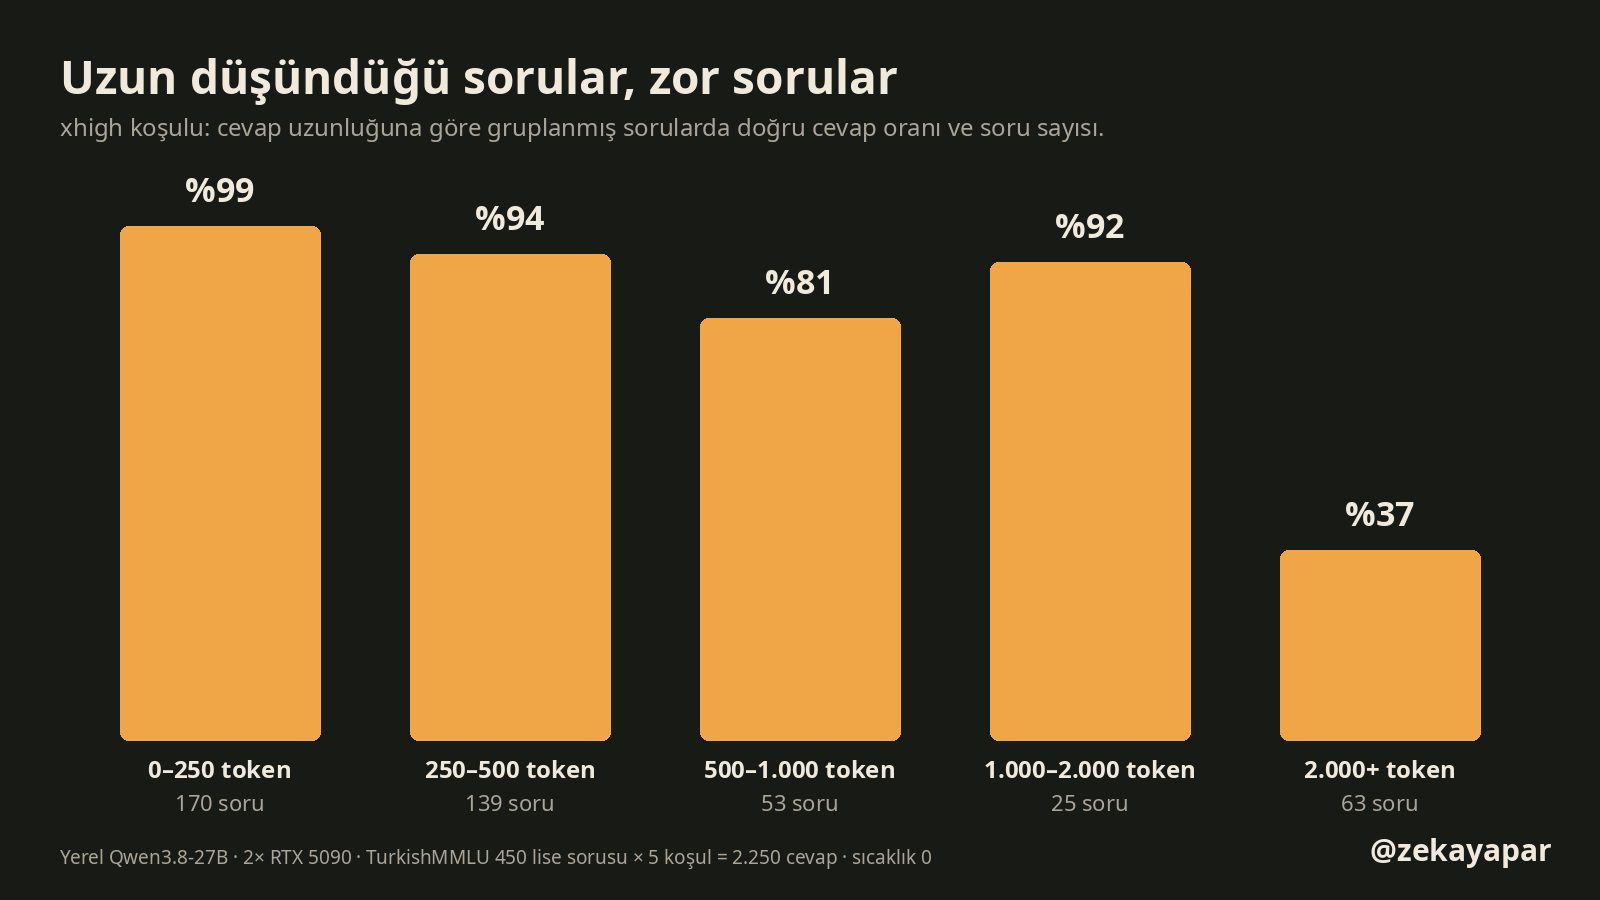
Uzun düşünmek daha doğru cevap demek değil. xhigh’ta 250 tokenin altında biten 170 cevapta doğru oranı %99; 2.000 tokeni geçen 63 cevapta bu oran yalnız %37. Bu son grubun 21 tanesi sınıra takılıp yanlış sayılanlar; cevaba ulaşan 42 cevabın 23 tanesi doğru, yani yaklaşık yarısı. Bu, uzun düşünmenin zarar verdiğini göstermiyor: model zaten emin olmadığı, zor sorularda uzun yazıyor. Ama seviyeyi xhigh’a çıkarmak da ortalamada doğruluğu artırmadı (–1,1 puan); zor sorularda daha uzun düşünmek çoğu zaman sonucu değiştirmedi.
Tek başıma sorunca ne kadar bekledim?
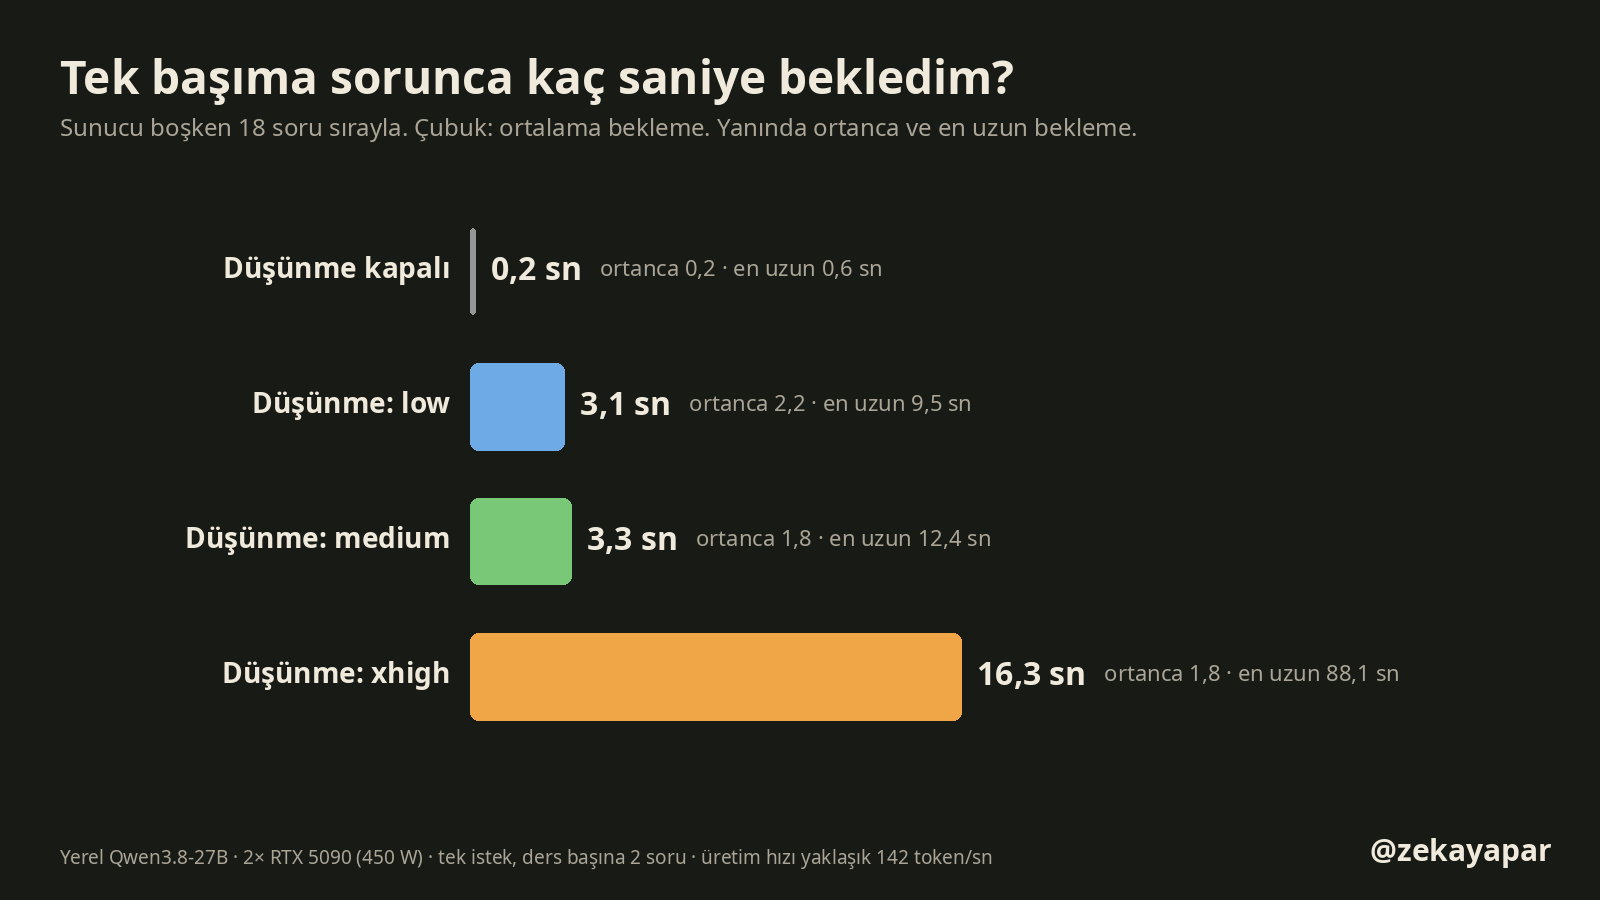
Sunucuda başka iş yokken her dersten 2 soruyu dört koşulda sırayla sordum. Düşünme kapalıyken cevap ortalama 0,16 saniyede geldi. low’da ortalama 3,1, medium’da 3,3 saniye. Ortancalar birbirine yakın (low 2,2, medium 1,8, xhigh 1,8 sn), ama xhigh’ın ortalaması 16,3 saniye: 18 sorudan birkaçında model uzun düşündü ve en uzun bekleme 88,1 saniye oldu. Yani xhigh çoğu zaman hızlı, ama ara sıra bir buçuk dakika bekletebiliyor. Bu ölçümde model saniyede yaklaşık 142 token yazıyordu; daha yavaş bir bilgisayarda aynı uzun taslak orantılı olarak daha uzun sürer. (medium koşulundaki bir istek sırasında sunucuda başka bir oturumdan gelen bir istek daha çalışıyordu; o bekleme biraz şişmiş olabilir.)
Türkçe soruya hangi dilde düşündü?
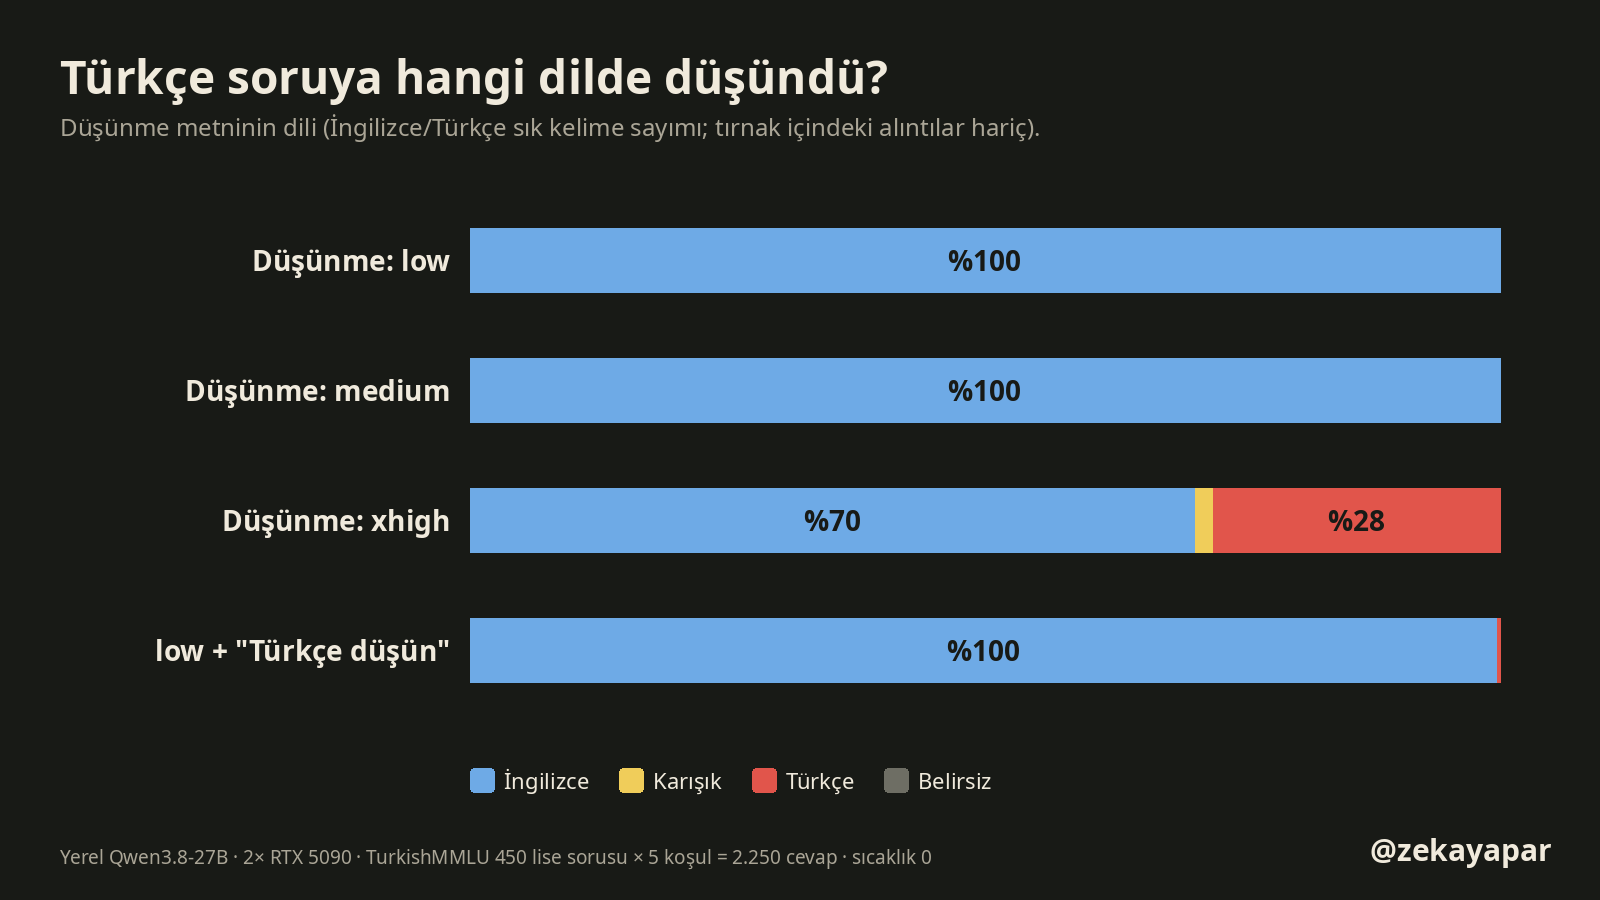
Düşünme metinlerinin dilini, İngilizce ve Türkçe sık kelimeleri (the, is, answer / ve, bir, için, cevap gibi) sayarak ayırdım; taslak soruyu tırnak içinde alıntıladığında o kısmı saymadım ve birkaç örneği elle kontrol ettim. low ve medium’da 450 taslağın hepsi İngilizce. Soru Türkçe, şıklar Türkçe, ama model kendi kendine İngilizce konuşuyor. xhigh’ta ise 125 taslak (%28) Türkçe; bunlar genelde “Kullanıcı Türkçe olarak bir çoktan seçmeli soru sormuş” diye başlıyor.
Şablonun eklediği tek bir İngilizce cümlenin modelin düşünme üslubunu bu kadar değiştirmesi ilginç; İngilizce kalan taslakların başlangıcı da değişiyor: xhigh’ta 450 taslağın 324 tanesi “We need …” diye başlıyor, low’da bu sayı 24, medium’da 27; low ve medium çoğunlukla “The question …” ya da “Let me …” ile açıyor. Türkçe düşündüğü sorularda xhigh’ın doğruluğu %93,6, İngilizce düşündüklerinde %83,3. Bunu “Türkçe düşünmek daha iyi” diye okumuyorum: Türkçe taslaklar daha kısa (ortanca 226 yerine 392 token), yani model muhtemelen kolay bulduğu sorularda Türkçe düşündü. Dili ben seçmediğim için neden-sonuç kuramıyorum. Ayrıca sınıra takılıp yanlış sayılan 21 cevabın 18 tanesi İngilizce taslaktı; bu da farkı büyütüyor.
Kestirme deneme: “Düşüncelerini de Türkçe yaz”
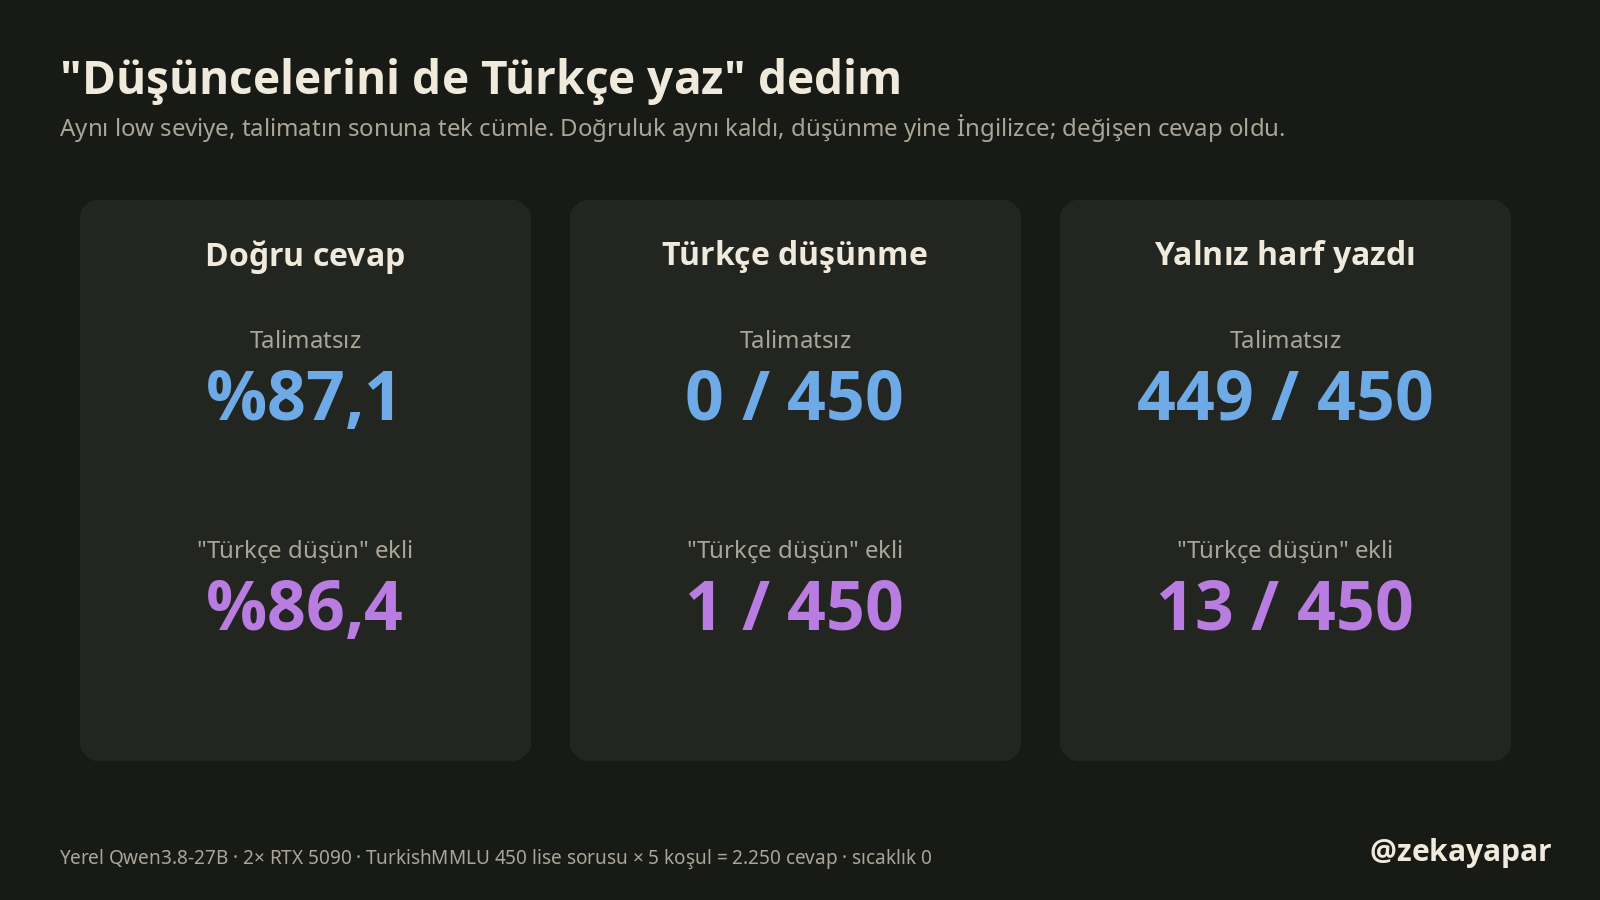
Madem kendiliğinden İngilizce düşünüyor, Türkçe düşünmesini isteyeyim dedim. Sonuç beklediğim gibi çıkmadı: 450 taslaktan 1 tanesi Türkçe oldu, gerisi yine İngilizce. Talimatı düşünmeye değil cevaba uyguladı: “yalnızca harfi yaz” dememe rağmen 437 cevapta harfin yanına Türkçe bir açıklama yazdı (229 tanesi “Düşünce:” başlığıyla). Kimya sorusundaki cevabı şuydu:
**Düşünce:**

⁸⁵Rb'nin oranını $x$, ⁸⁷Rb'nin oranını $(1-x)$ olarak alalım.

Ortalama atom kütlesi formülü:

$85x + 87(1-x) = 85{,}5$

$85x + 87 - 87x = 85{,}5$

$-2x = -1{,}5$

$x = 0{,}75 = \%75$

**D**
Bu, puanlamayı da bozdu. İlk sayımda cevabın içindeki ilk şık harfini aldığım için bu koşul %77,3 çıktı ve ben “Türkçe düşün demek 9,8 puan kaybettiriyor” yazmak üzereydim. Yanlış cevap sanılanları tek tek okuyunca açıklamanın içinde geçen başka şıkların yakalandığını gördüm. Harf dışında bir şey yazılmış bütün cevapları (470 cevap, 437 tanesi bu koşuldan) aynı modele “bu metinde hangi şık seçilmiş, soruyu kendin çözme” diye sorup yeniden puanladım; bu koşulda 47 cevabın harfi değişti. Çıkarılan harf, modelin kendi taslağının sonunda yazdığı “The answer is …” harfiyle, taslağında böyle bir satır olan 376 cevabın 375 tanesinde eşleşiyor; çıkarma büyük ölçüde tutarlı. Düzeltilmiş doğruluk %86,4: low ile aynı (–0,7 puan). Bedeli 1,5 kat token: çoğu cevabın uzamasından geliyor, düşünme de yaklaşık %15 uzadı.
Ders ders ve kaybedilen sorular
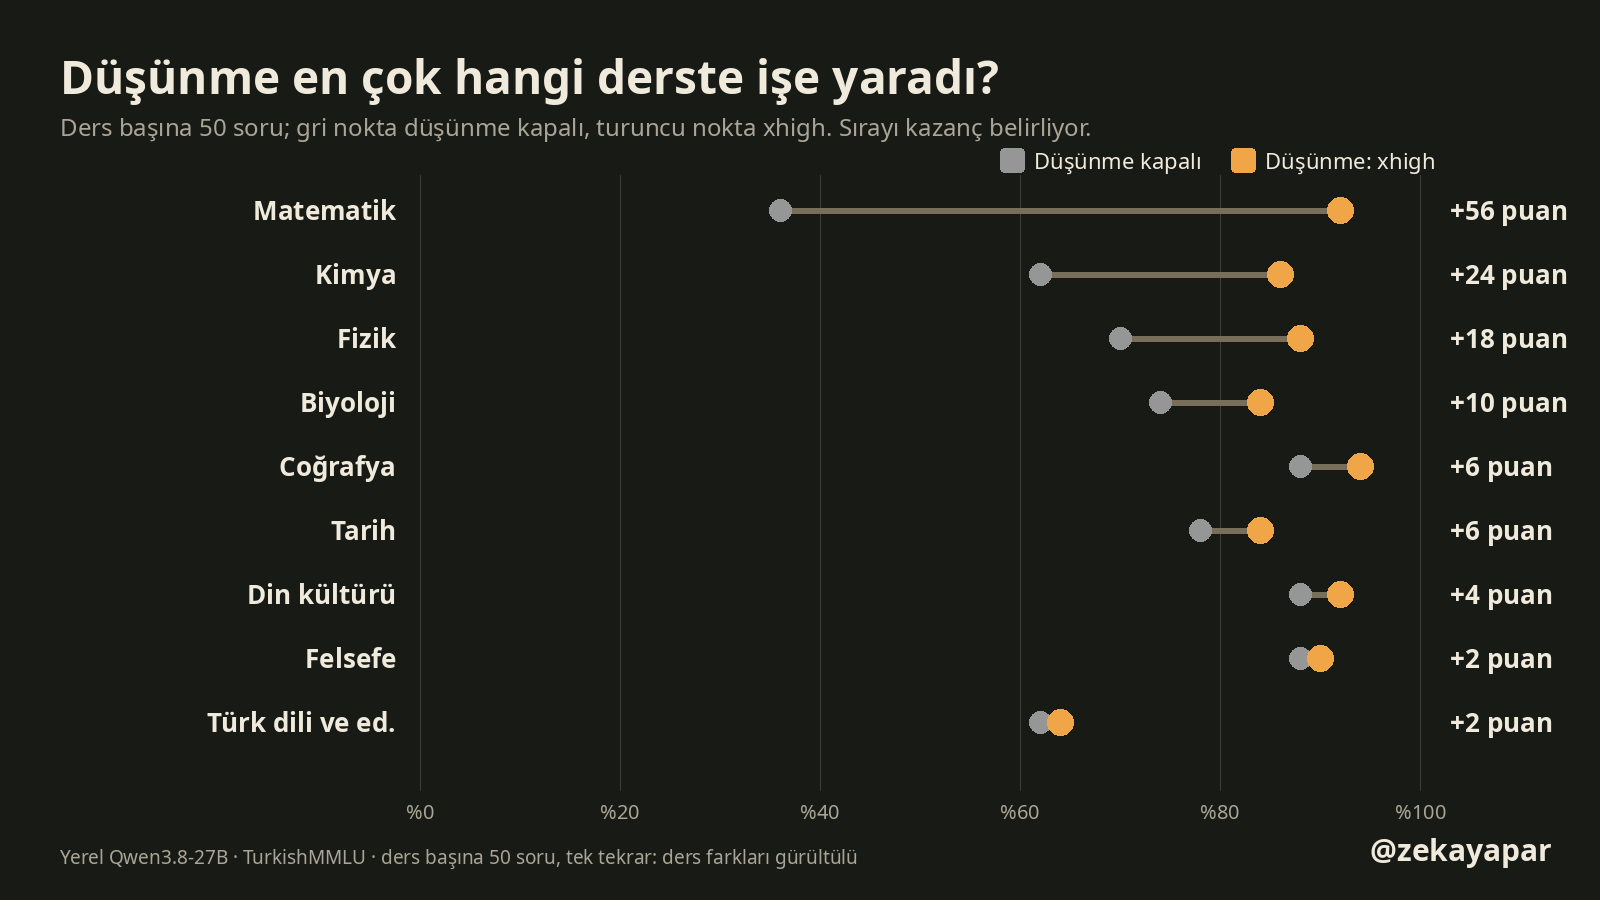
En büyük fark matematikte: düşünme kapalıyken %36, xhigh’ta %92. Bunun bir kısmı biçimden geliyor: düşünme kapalıyken model “yalnız harf” talimatına rağmen 30 soruda harfin yanına açıklama ya da çözüm yazmaya başlayıp 64 tokenlik sınıra takıldı ve bunların 17 tanesi matematik. Ama zaten hesap gerektiren bir soruyu tek harfle cevaplamak bir tahmin; düşünme açıkken model hesabı yapacak yeri buluyor. Kimya ve fizikte de kazanç büyük. Felsefe, din kültürü ve coğrafya gibi bilgiye dayalı derslerde fark birkaç puan. Felsefede low seviyesi düşünme kapalıdan biraz geride kaldı (%84 ve %88). Türk dili ve edebiyatında low ve medium 10–12 puan kazandırdı, xhigh ise yalnız 2 puan; sınıra takılan 9 cevap bu dersten. Her ders 50 soru, tek tek farklar gürültülü.
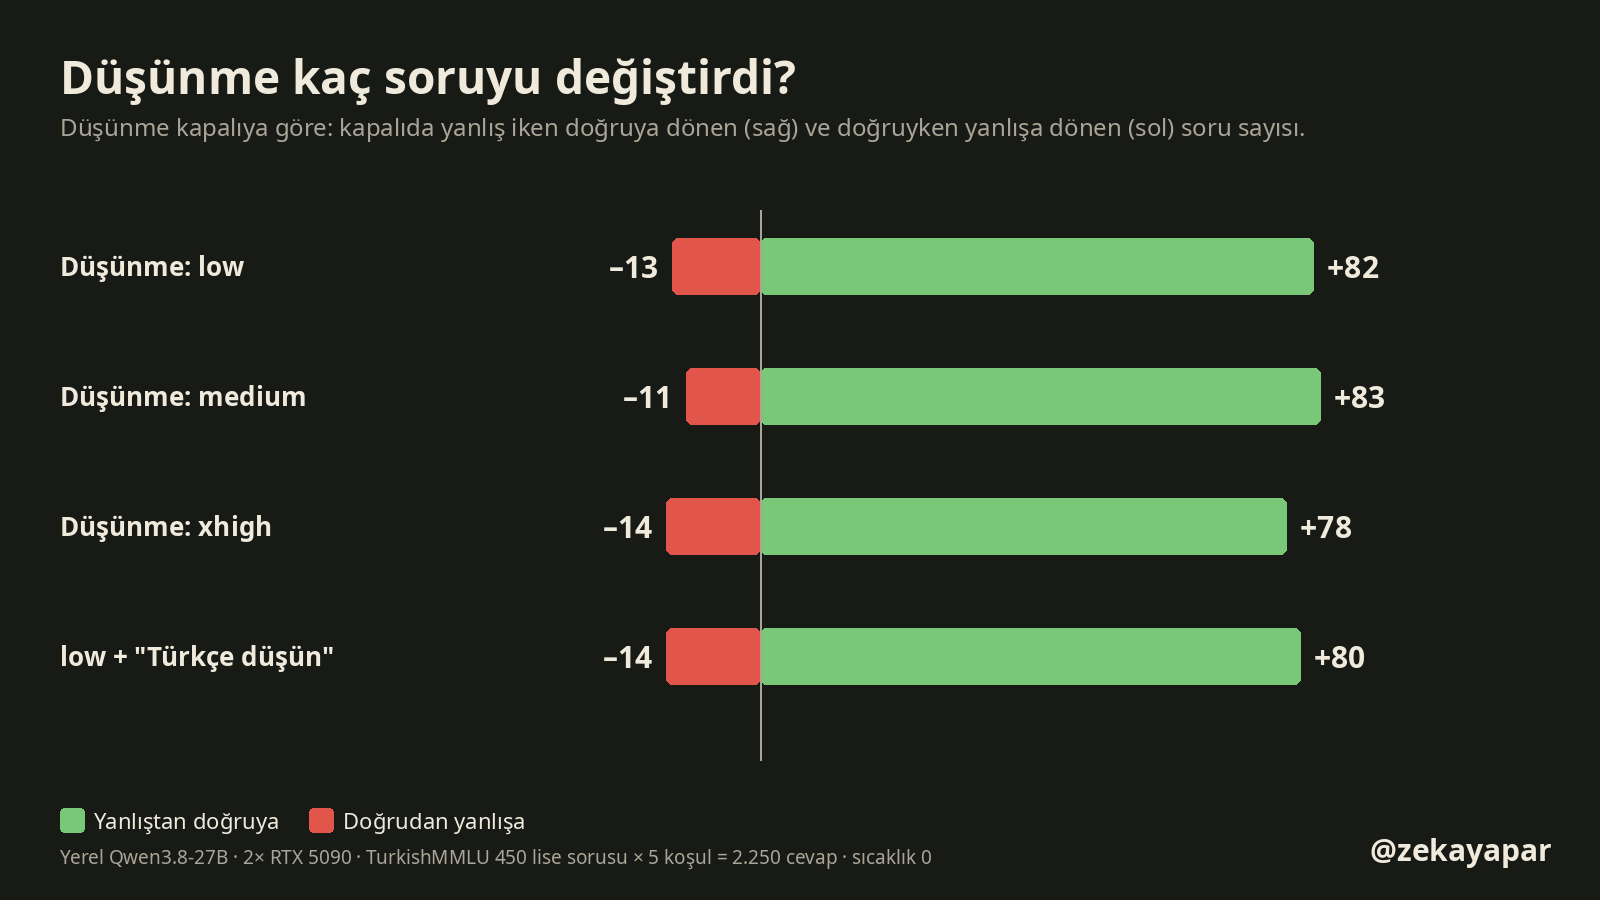
Ortalama artış, altındaki iki yönlü hareketi gizliyor. xhigh, düşünme kapalıyken yanlış olan 78 soruyu doğruya çevirdi ama doğru olan 14 soruyu yanlışa çevirdi. Düşünmek bazen ilk sezgiyi bozuyor; bunun sayısı her seviyede benzer (11–14 soru).
Günlük kullanımda ne demek?
- Matematik, kimya ve fizik gibi hesap gerektiren sorularda düşünmeyi açmak bu ölçümde açık ara işe yaradı. Bilgiye dayalı derslerde fark küçük.
- En kısa düşünme seviyesi bu sorularda yetti. Uzun seviye çoğu soruda aynı hızda, ama ara sıra çok uzun bekletiyor ve fazladan token ödetiyor; doğruluğu artırmadı.
- Model Türkçe soruyu çoğunlukla İngilizce düşünerek çözdü ve doğruluk yine de belirgin biçimde arttı. Taslağın dili ile cevabın dili ayrı şeyler.
- “Türkçe düşün” demek düşünmeyi değiştirmedi, cevabı uzattı. Türkçe bir açıklama istiyorsam bunu düşünme talimatı olarak değil, açıkça cevabın parçası olarak istemek daha doğru görünüyor.
Benim için sonuç
Kendi kullanımımda düşünmeyi kapalı tutuyorum, çünkü sohbet ve kısa işlerde hız istiyorum. Bu ölçümden sonra şu ayrımı yapacağım: hesap ya da çok adımlı bir soru gelirse kısa düşünme seviyesini açmak, en yüksek seviyeyi ise yalnız gerçekten gerekirse denemek. Modelin İngilizce düşünmesini de artık dert etmiyorum: bu sorularda İngilizce taslakla doğruluk %87’ye çıktı. Türkçe düşünse daha iyi olur muydu, bu ölçüm söylemiyor; çünkü modeli Türkçe düşündüremedim.
Sınırlar
- Tek model (Qwen3.8-27B) ve tek tür soru: beş şıklı lise soruları, cevap tek harf. Açık uçlu yazma, kod ya da uzun belge işlerinde tablo farklı olabilir.
- TurkishMMLU 2024’ten beri açık; modelin eğitim verisinde bu sorular bulunuyor olabilir. Bu yüzden mutlak doğruluk oranlarını “Türkçe lise başarısı” diye okumuyorum. Koşullar arası fark aynı sorular üzerinde ölçüldüğü için daha anlamlı.
- Sıcaklık 0 olsa da sunucu istekleri birlikte işlediği için aynı soru iki kez sorulunca cevap ve taslak uzunluğu değişebiliyor (tekrar sorduğum bir medium isteği ilkinde 2.027, ikincisinde 1.106 token tuttu). Tek tekrar yaptım; birkaç puanlık farkları anlamlı saymıyorum, güven aralığı veriyorum.
- xhigh’ta 12.000 tokenlik sınır 21 cevabı kesti. Daha yüksek bir sınırla bunların bir kısmı cevaba ulaşabilirdi; sohbet bağlamı 16.384 token, sınırı 12.000’de bıraktım.
- Düşünme dilini kelime sayımıyla ayırdım; kusursuz değil, karışık ya da kısa taslaklarda yanılabilir.
- Açıklama yazılmış cevaplardaki harfi aynı model çıkardı. Taslak sonuyla eşleşme yüksek, ama bu da bir model kararı.
Tam tablo ve yöntem
| Koşul | Doğru | Fark (puan) | %95 aralık | Kazanılan / kaybedilen | Token ortanca | Token %90 | Token en çok | Token toplam | Sınıra takılan | Yalnız harf | İstem token | Türkçe taslak |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Düşünme kapalı | %71,8 | – | – | – / – | 2 | 2 | 64 | 2.766 | 30 | 420 | 162,3 | – |
| low | %87,1 | +15,3 | +11,3 … +19,6 | 82 / 13 | 316 | 804 | 4.963 | 197.581 | 0 | 449 | 190,3 | 0 |
| medium | %87,8 | +16,0 | +12,0 … +20,0 | 83 / 11 | 352 | 870 | 10.558 | 239.538 | 0 | 448 | 160,3 | 0 |
| xhigh | %86,0 | +14,2 | +10,2 … +18,4 | 78 / 14 | 314 | 5.747 | 12.000 | 664.652 | 21 | 429 | 202,3 | 125 |
| low + “Türkçe düşün” | %86,4 | +14,7 | +10,4 … +18,7 | 80 / 14 | 522 | 1.053 | 7.759 | 297.805 | 0 | 13 | 200,3 | 1 |
| Ders (50 soru) | Kapalı | low | medium | xhigh | low + Türkçe | xhigh Türkçe taslak |
|---|---|---|---|---|---|---|
| Biyoloji | %74 | %82 | %80 | %84 | %80 | 20 |
| Coğrafya | %88 | %96 | %96 | %94 | %94 | 20 |
| Din kültürü | %88 | %98 | %94 | %92 | %92 | 14 |
| Felsefe | %88 | %84 | %90 | %90 | %82 | 19 |
| Fizik | %70 | %88 | %88 | %88 | %92 | 15 |
| Kimya | %62 | %90 | %90 | %86 | %90 | 10 |
| Matematik | %36 | %90 | %92 | %92 | %90 | 2 |
| Tarih | %78 | %84 | %86 | %84 | %84 | 17 |
| Türk dili ve edebiyatı | %62 | %72 | %74 | %64 | %74 | 8 |
| Tek kullanıcı | Soru | Ortanca sn | Ortalama sn | En uzun sn | Token ortanca |
|---|---|---|---|---|---|
| kapali | 18 | 0,17 | 0,16 | 0,6 | 2 |
| low | 18 | 2,19 | 3,12 | 9,5 | 290 |
| medium | 18 | 1,77 | 3,34 | 12,4 | 262 |
| xhigh | 18 | 1,78 | 16,25 | 88,1 | 246 |
Fark: düşünme kapalıya göre, aynı 450 soru. Güven aralığı: soru düzeyinde eşli fark, 2.000 bootstrap örneği. Token: düşünme + cevap (sunucunun usage.completion_tokens değeri). İstem token: sunucunun saydığı girdi; low ve xhigh’taki fazlalık şablonun eklediği sistem cümlesi. Puanlama: cevap yalnız bir harfse o harf; harf dışında metin varsa aynı modele (düşünme kapalı, sıcaklık 0) “bu metinde son olarak hangi şık seçilmiş, soruyu kendin çözme, seçilmemişse ? yaz” diye soruldu; boş ya da sınıra takılmış cevap yanlış. Düşünme dili: tırnak içi alıntılar çıkarılıp İngilizce/Türkçe sık kelime sayımı, en az %75 bir dil ise o dil.
Kaynaklar ve sürümler: Qwen3.8-27B NVFP4 (nvidia, Hugging Face revizyonu 482ca0f3832238542f8f5295dde86b5f22711d80, sohbet şablonundaki reasoning_effort: low / medium / xhigh) · vLLM 0.30.0, qwen3 reasoning parser · TP2, 2× RTX 5090 (450 W sınırı), çoklu token tahmini (MTP) açık · istek: temperature 0, seed 1, diğer örnekleme ayarları sunucu varsayılanı (presence_penalty 1,5); toplu bölümde 8 eşzamanlı istek, başlangıçta sunucuda başka istek yoktu (/metrics) · TurkishMMLU (Yüksel vd., ACL 2024 SIGTURK; AYueksel/TurkishMMLU, revizyon fcbe5bb19af2714186fdd5752671e0748efa0024, test bölümü; veri setinde lisans belirtilmemiş, bu yüzden soruları yeniden yayımlamıyorum, yalnız bir örnek alıntılandı) · ölçüm 7 Kasım 2026.
İndir: betikler ve 2.250 cevabın puanlama kaydı (ZIP; soru ve taslak metinleri yok) · özet (JSON) · istek başına sonuçlar (CSV). Betikler soruları veri setinden aynı tohumla yeniden seçer.