 zekayapar
Yapay zekâ YKS’ye girdi: yerel bir model 278 sorudan 261’ini bildi
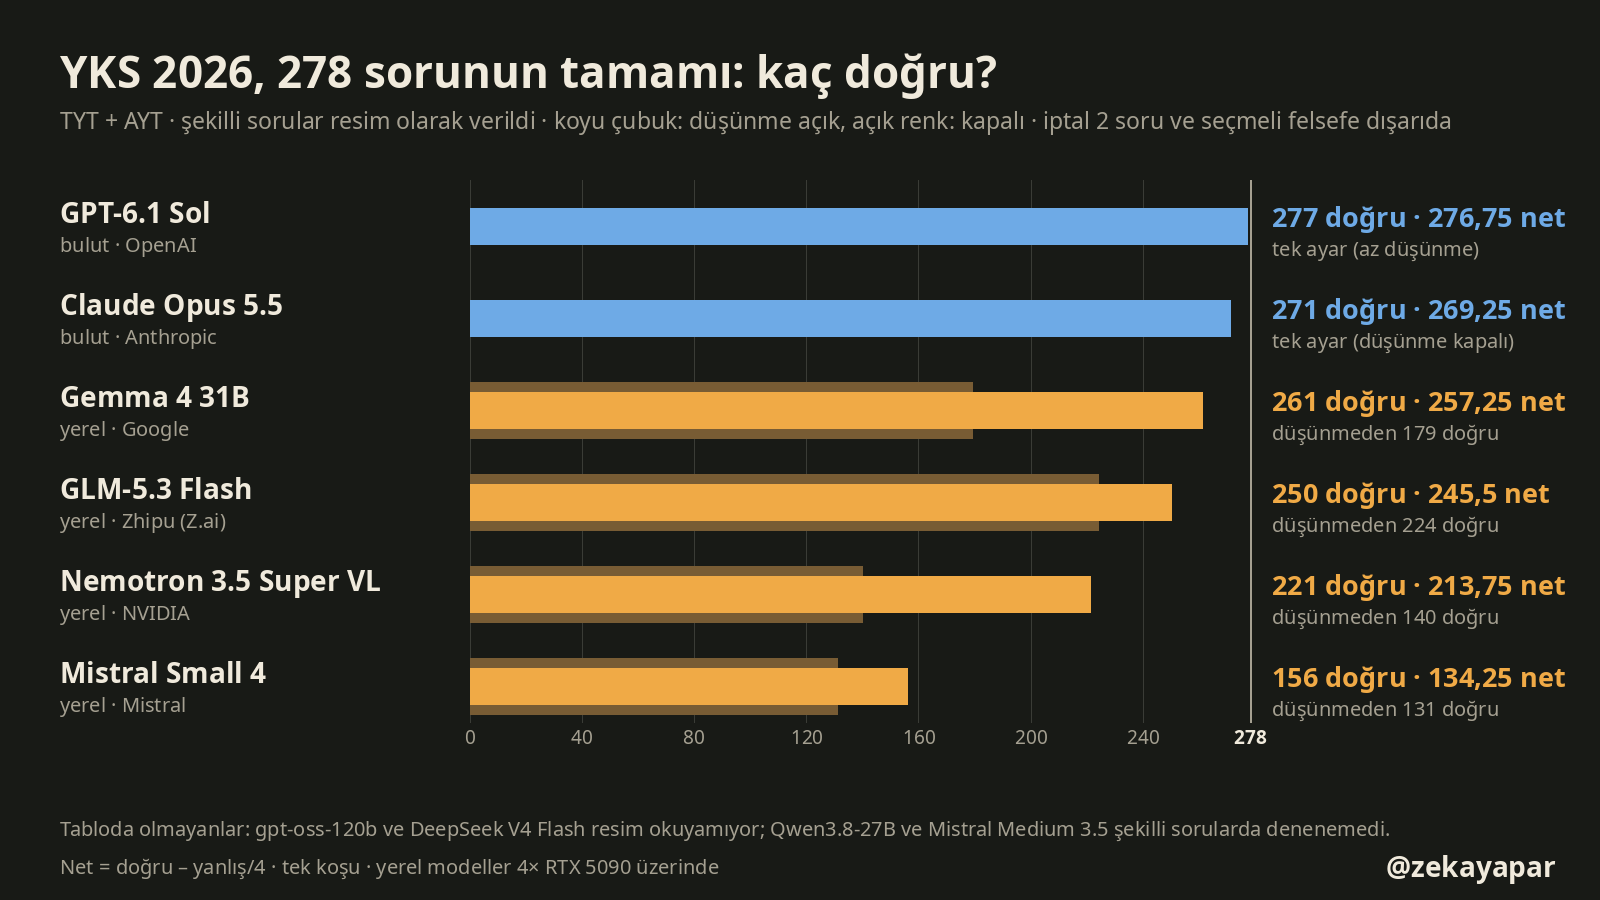
2026 YKS’nin 278 sorusunu 8 yerel ve 2 bulut modele çözdürdüm. Evdeki Gemma 4 31B 261 doğru yaptı, GPT 277, Claude 271. Matematikte düşünmek şarttı.
YKS 2026 ölçümü
- 4× RTX 5090 · vLLM 0.30.0 ve llama.cpp b11803
- 8 yerel model (2–16 bit) · bulutta Claude Opus 5.5 ve GPT-6.1 Sol
- ÖSYM 2026-YKS TYT + AYT · 278 puanlı soru, şekilliler resimle
- Düşünme kapalı/açık · Türkçe/İngilizce · şık karıştırma · 2023 kontrol
- Net = doğru − yanlış/4 · nvidia-smi güç kaydı (1 sn) · tek koşu
2026’da TYT’ye 2,25 milyon aday girdi. Yapay zekâ modellerinin “sınav sorusu çözebildiği” çok söyleniyor ama bunu çoğunlukla İngilizce testlerden duyuyoruz. Merak ettiğim şey daha somuttu: Haziran 2026’daki YKS’yi, ÖSYM’nin kendi kitapçığı ve kendi cevap anahtarıyla bir modele çözdürsem kaç doğru yapar? Bunu bulutta değil, evdeki bilgisayarımda çalışan açık bir model başarabilir mi?
Kısa cevap: Google’ın 31 milyar parametrelik açık modeli Gemma 4 31B, kendi bilgisayarımda (4× RTX 5090) TYT ve AYT’nin puanlanan 278 sorusundan 261 tanesini doğru çözdü; neti 257,25. Aynı soruları bulutta GPT-6.1 Sol 277, Claude Opus 5.5 271 doğruyla çözdü. Bu sonuç için modelin “düşünmesine” izin vermek gerekti: düşünmeden aynı model 179 doğruda kaldı ve matematikte neredeyse rastgele işaretleme seviyesindeydi.
Nasıl ölçtüm
Sorular: ÖSYM’nin sitesinde yayımladığı 2026-YKS temel soru kitapçıkları (TYT 20 Haziran, AYT 21 Haziran) ve kitapçıkların sonundaki resmî cevap anahtarı. Soruları PDF’ten bir betikle çıkardım, elle soru yazmadım. Toplam 291 soru var. ÖSYM sonradan 2 soruyu iptal etti (AYT Türk Dili ve Edebiyatı-Sosyal Bilimler-1 testinin 20. sorusu ve AYT Matematik 23. soru); bunları saymadım. Seçmeli felsefe sorularını (11 soru) da öğrencilerin puanlamasına uyacak biçimde dışarıda bıraktım. Geriye 278 puanlı soru kalıyor.
Kitapçıklarda “Bu soruların telif hakları ÖSYM’ye aittir” uyarısı var. Bu yüzden yazıda, grafiklerde ve indirilebilir dosyalarda tek bir soru metni, şıkkı ya da şekli yok; yalnız soru numaraları ve sonuçlar var. Soruları merak eden ÖSYM’nin kitapçığından numarasıyla bakabilir.
Metin ve resim: Soruların 171 tanesi düz metin olarak verilebiliyor. Kalan 120 sorunun şekli, grafiği, formülü ya da altı çizili bir ifadesi var; bunlar metne dökülünce bozuluyor. Matematikte bu oran çok yüksek: TYT Temel Matematik’in yalnız 10, AYT Matematik’in yalnız 5 sorusu düz metinle sorulabiliyor. Bu yüzden iki koşu yaptım: metne uygun soruları metin olarak, kalanları kitapçıktan kırptığım soru resmiyle. İkisinin toplamı sınavın tamamı. Resim okuyamayan ya da resimde çalıştıramadığım modeller yalnız metin kısmında yarıştı.
Modeller: farklı yapımcılardan sekiz açık model, hepsi kendi bilgisayarımda; karşılaştırma için bulutta iki model.
| Model | Yapımcı | Biçim | Çalıştırıcı | Şekilli sorular (resim) |
|---|---|---|---|---|
| Gemma 4 31B | BF16 (16 bit) | vLLM | evet | |
| GLM-5.3 Flash | Zhipu (Z.ai) | GGUF UD-Q2_K_XL (2 bit) | llama.cpp | evet |
| DeepSeek V4 Flash | DeepSeek | GGUF UD-IQ3_XXS (3 bit) | llama.cpp | hayır |
| Nemotron 3.5 Super VL | NVIDIA | NVFP4 (4 bit) | vLLM | evet |
| Qwen3.8-27B | Alibaba | NVFP4 (4 bit) | vLLM | hayır |
| gpt-oss-120b | OpenAI | MXFP4 (4 bit) | vLLM | hayır |
| Mistral Medium 3.5 | Mistral | GGUF UD-Q4_K_XL (4 bit) | llama.cpp | hayır |
| Mistral Small 4 | Mistral | NVFP4 (4 bit) | vLLM | evet |
| Claude Opus 5.5 | Anthropic | bulut | Claude Code CLI | evet |
| GPT-6.1 Sol | OpenAI | bulut | Codex CLI | evet |
Biçim sütunu önemli: büyük modelleri 128 GB ekran kartı belleğine sığdırmak için çoğunu 4 bite, GLM-5.3 Flash’ı 2 bite, DeepSeek V4 Flash’ı 3 bite sıkıştırılmış hâliyle çalıştırdım. Sonuçlar bu sıkıştırılmış sürümler için geçerli. Gemma 4 31B küçük olduğu için sıkıştırmadan, 16 bit çalıştı.
Koşullar: Her modeli düşünme kapalı ve açık olarak ayrı ayrı çalıştırdım. gpt-oss-120b ve GLM-5.3 Flash düşünmeyi tamamen kapatamıyor; onlarda “az düşün” ve “çok düşün” ayarlarını karşılaştırdım. Düşünme kapalıyken sıcaklık 0, açıkken model kartının önerdiği değer. Ayrıca aynı soruları İngilizceye çevirip sordum, şıkların yerini karıştırıp sordum ve aynı yöntemle 2023 sınavını çözdürdüm. Her koşul bir kez çalıştı.
Puanlama: ÖSYM’nin kuralı: her testte net = doğru − yanlış ÷ 4, boş sıfır. Model “emin değilsen boş bırakabilirsin” bilgisiyle başladı. Cevabı okunamayan ya da düşünürken üst sınıra takılıp yarıda kesilen cevaplar boş sayıldı.
İstem: Modele her soruda aynı sistem istemini verdim. Düşünme kapalıyken:
Sen Yükseköğretim Kurumları Sınavı'na (YKS) giren bir adaysın. Her soru beş seçeneklidir (A–E) ve yalnızca bir doğru cevabı vardır. Yanlış cevap dört yanlış bir doğruyu götürecek biçimde puanlanır; emin değilsen boş bırakabilirsin. Açıklama yapma; yalnızca tek satır yaz: 'Cevap: X' (X = A, B, C, D ya da E; boş bırakmak için 'Cevap: BOŞ').
Düşünme açıkken son cümle şu oldu:
Soruyu dikkatle çöz; cevabının son satırı tam olarak 'Cevap: X' olsun (X = A, B, C, D ya da E; boş bırakmak için 'Cevap: BOŞ').
Kullanıcı mesajı yalnız sorunun kendisiydi: varsa ortak okuma parçası, ardından soru numarası ve kökü, alt alta A)–E) şıkları. Şekilli sorularda sistem istemine “Soru görsel olarak verilmiştir.” cümlesi eklendi; mesaj “Soru 12 (TYT Temel Matematik). Görseldeki soruyu çöz.” biçimindeydi ve yanında sorunun kırpılmış resmi vardı.
Gerçek bir örnek: TYT Türkçe 1. soruda Gemma 4 31B’nin düşünme kapalı cevabı tam olarak Cevap: B oldu (doğru). Düşünme açıkken aynı soruya 1.523 token’lık bir çözüm yazdı; son satırı Cevap: B (doğru). Çözüm metinleri soruyu ve şıkları alıntıladığı için yayımlamıyorum; indirilebilir dosyalarda her sorunun verilen cevabı, doğru cevabı, süresi ve token sayısı var.
Sonuç: sınavın tamamı
Yukarıdaki ilk grafik, şekilli sorular dahil sınavın tamamını çözebilen altı modeli gösteriyor. Bulut modelleri neredeyse tam yaptı: GPT-6.1 Sol 277 doğru (276,75 net), Claude Opus 5.5 271 doğru (269,25 net). Yerel modellerde en iyisi Gemma 4 31B: 261 doğru, 15 yanlış, 2 boş; 257,25 net. GLM-5.3 Flash 250 doğruyla (245,5 net) çok geride değil. NVIDIA’nın Nemotron 3.5 Super VL modeli 221, Mistral Small 4 156 doğruda kaldı.
Benim için asıl şaşırtıcı olan model boyutuydu. Gemma 4 31B, sınavın tamamına giren yerel modellerin en küçüğü; GLM-5.3 Flash’ın toplam parametresi (320 milyar) onun on katından fazla. Ama Gemma sıkıştırılmadan, tam hassasiyetle çalıştı ve şekilli sorularda da iyiydi. Koyu renkli kısa çubuklar aynı modellerin düşünmeden yaptığı doğruları gösteriyor: Gemma 179, Nemotron 140, Mistral Small 4 131. GLM-5.3 Flash düşünmeyi kapatamadığı için “az düşün” ayarında bile 224 doğru yaptı.
Grafikte olmayan dört model var. gpt-oss-120b ve DeepSeek V4 Flash resim okuyamıyor. Qwen3.8-27B’yi her gün çalışan sunucumda yalnız metin moduyla kullanıyorum, sunucuyu bu test için değiştirmedim. Mistral Medium 3.5’te ise resimli istekler boş cevap döndü; hatayı ayıklamaya vaktim yetmedi. Bu dört model aşağıdaki metin sorularında var.
Metin soruları: on modelin hepsi
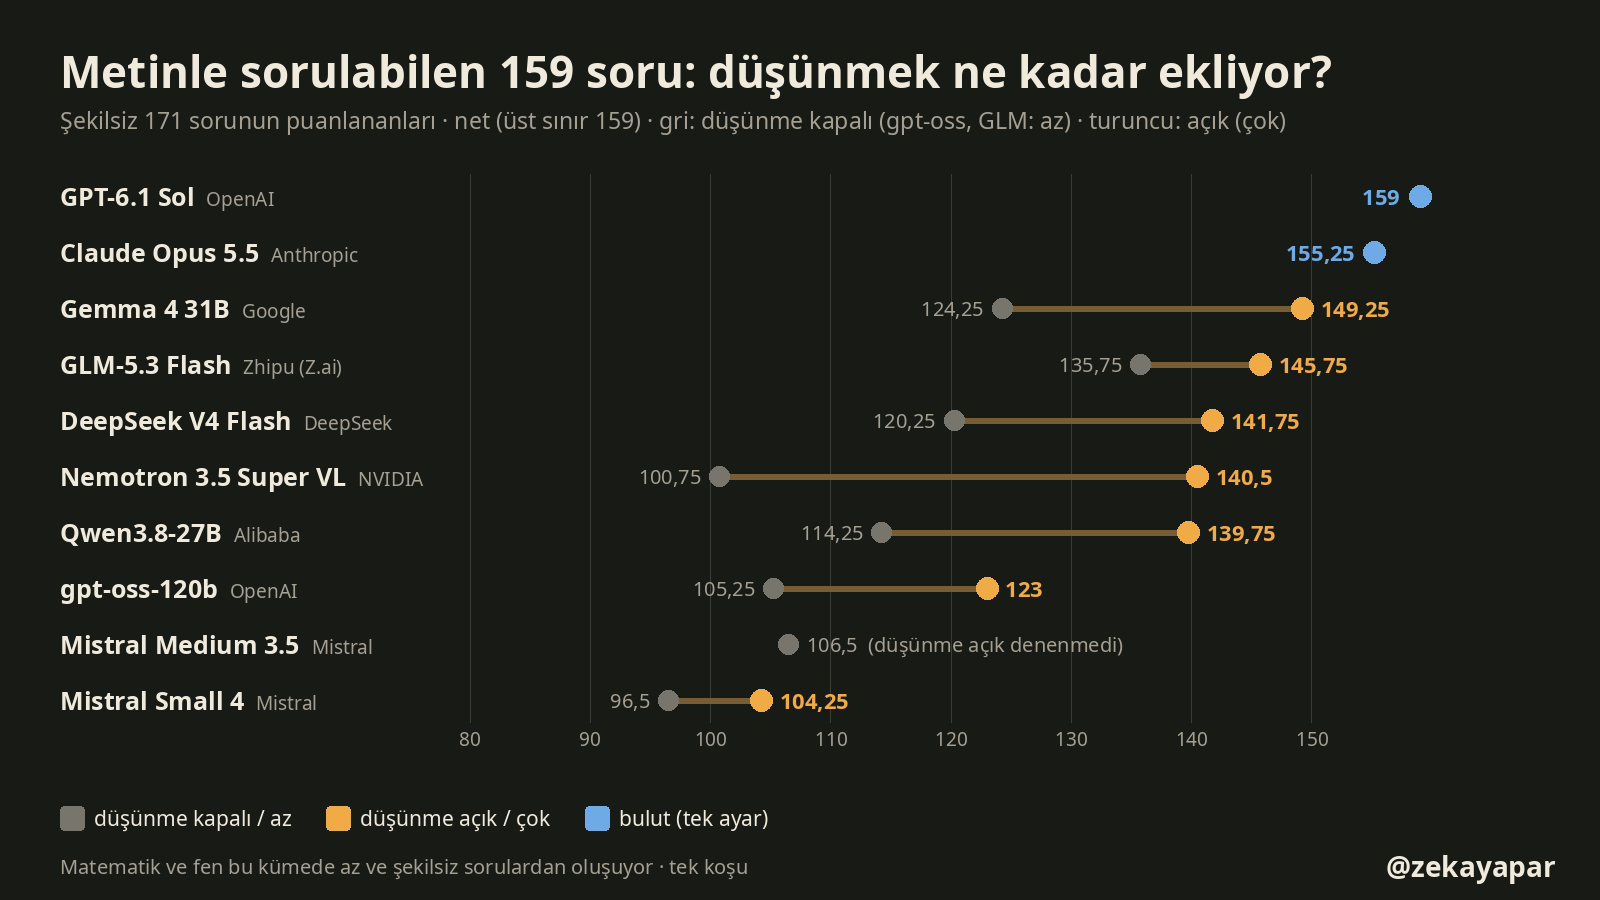
Düz metinle sorulabilen 159 puanlı soruda on modelin hepsini karşılaştırabildim. GPT-6.1 Sol hepsini doğru yaptı (159 net), Claude Opus 5.5 düşünmeden 155,25 net aldı. Yereller arasında yine Gemma 4 31B önde (149,25), onu GLM-5.3 Flash (145,75), DeepSeek V4 Flash (141,75), Nemotron (140,5) ve Qwen3.8-27B (139,75) izliyor. Bu beş model arasındaki fark 9,5 net; tek koşuda bu kadar yakın sonuçların sırası tekrar edilse değişebilir.
OpenAI’ın açık modeli gpt-oss-120b 123, Mistral’in iki modeli 106,5 (Medium, yalnız düşünme kapalı) ve 104,25 (Small) netle geride kaldı. Mistral Small 4 TYT Türkçe’de düşünme açıkken de kapalıyken de aynı neti (15) aldı; Türkçe paragraf sorularında düşünmek ona yardım etmedi. Listedeki en küçük model olan Qwen3.8-27B (27 milyar) ise beşinci sırada.
Bu grafikte bir uyarı gerekiyor: metin kümesinde matematik ve fen soruları az ve şekilsiz olanlar, yani genelde daha kolayları. Bu kümedeki sonuçları öğrenci ortalamasıyla karşılaştırmıyorum; o karşılaştırma tam sınavla aşağıda.
Düşünmek kaç net getirdi?
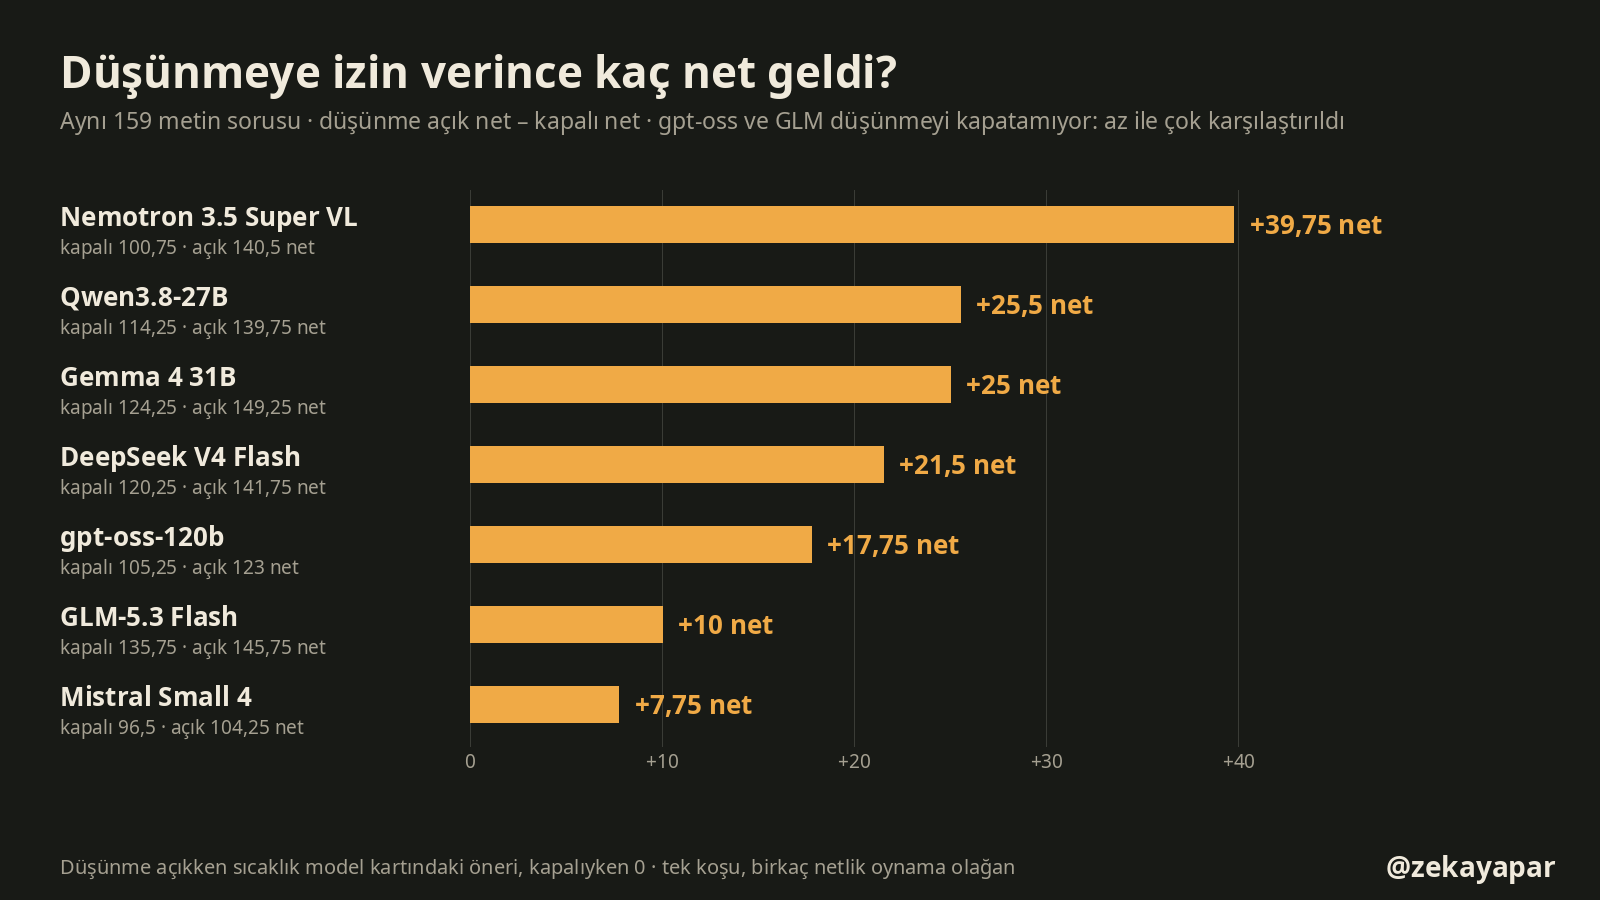
Aynı 159 soruda düşünmeye izin verince en çok kazanan Nemotron 3.5 Super VL oldu: 100,75 netten 140,5 nete, +39,75 net. Qwen3.8-27B +25,5, Gemma 4 31B +25, DeepSeek V4 Flash +21,5 net kazandı. En az kazanan Mistral Small 4 (+7,75). GLM-5.3 Flash’ın kazancı (+10) küçük görünüyor ama onun karşılaştırması “az” ile “çok” düşünme arasında; zaten az düşünürken yüksek bir yerden başlıyor.
Düşünmenin bedeli zaman: Gemma 4 31B düşünme açıkken soru başına ortalama 1.448 token üretti, kapalıyken yalnız “Cevap: X” satırını yazdı. Bunun elektrik ve dakika karşılığı aşağıda.
Matematik: düşünmeden şans seviyesi
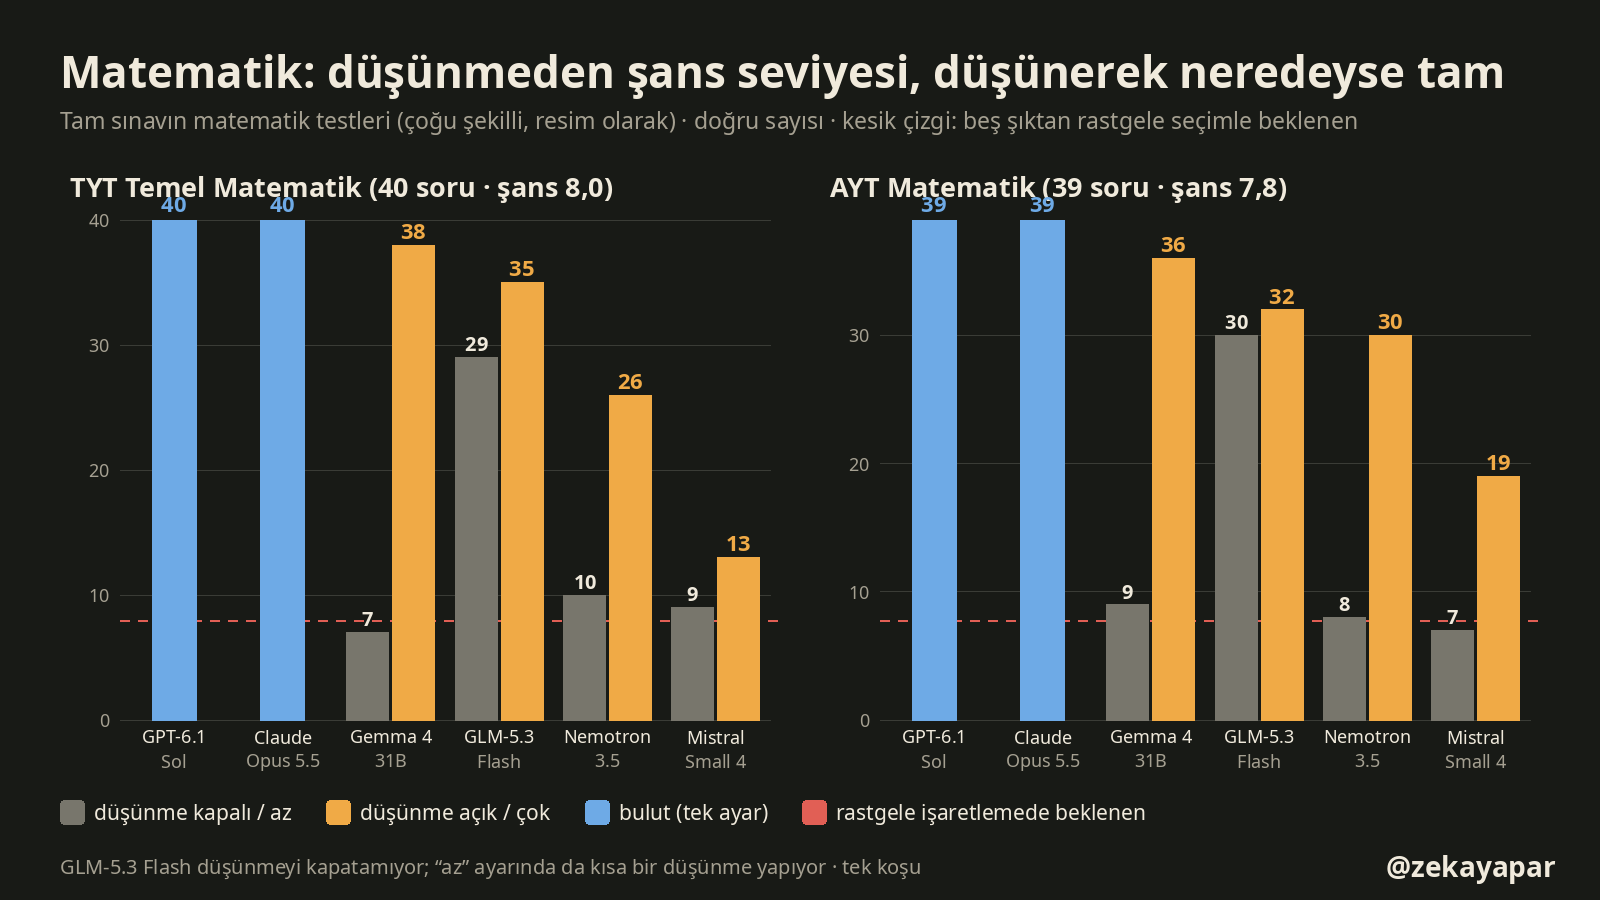
En büyük fark matematikte çıktı. TYT Temel Matematik 40 soru; beş şıktan rastgele işaretleyen biri ortalama 8 doğru bekler. Gemma 4 31B düşünmeden 7 doğru yaptı, yani şans seviyesinde. Düşünmeye izin verince aynı model aynı soruların 38 tanesini doğru çözdü. AYT Matematik’te (39 geçerli soru) tablo aynı: 9 doğrudan 36 doğruya.
Nemotron’da da benzer bir sıçrama var (TYT 10’dan 26’ya). Mistral Small 4 düşünürken de matematikte zayıf kaldı: TYT’de 13, AYT’de 19 doğru. GLM-5.3 Flash’ın “az düşün” ayarında bile 29 doğru yapması da aynı şeyi söylüyor: o ayar da kısa bir düşünme içeriyor. İki bulut modeli iki testin de tamamını doğru yaptı.
Bu bana şunu gösterdi: bu modeller matematik sorusunu “bakıp bilmiyor”, adım adım hesaplayarak çözüyor. Düşünmeyi kapatıp hızlı cevap istediğimde matematikte cevaplar rastgeleden farksız.
Öğrencilerle karşılaştırınca
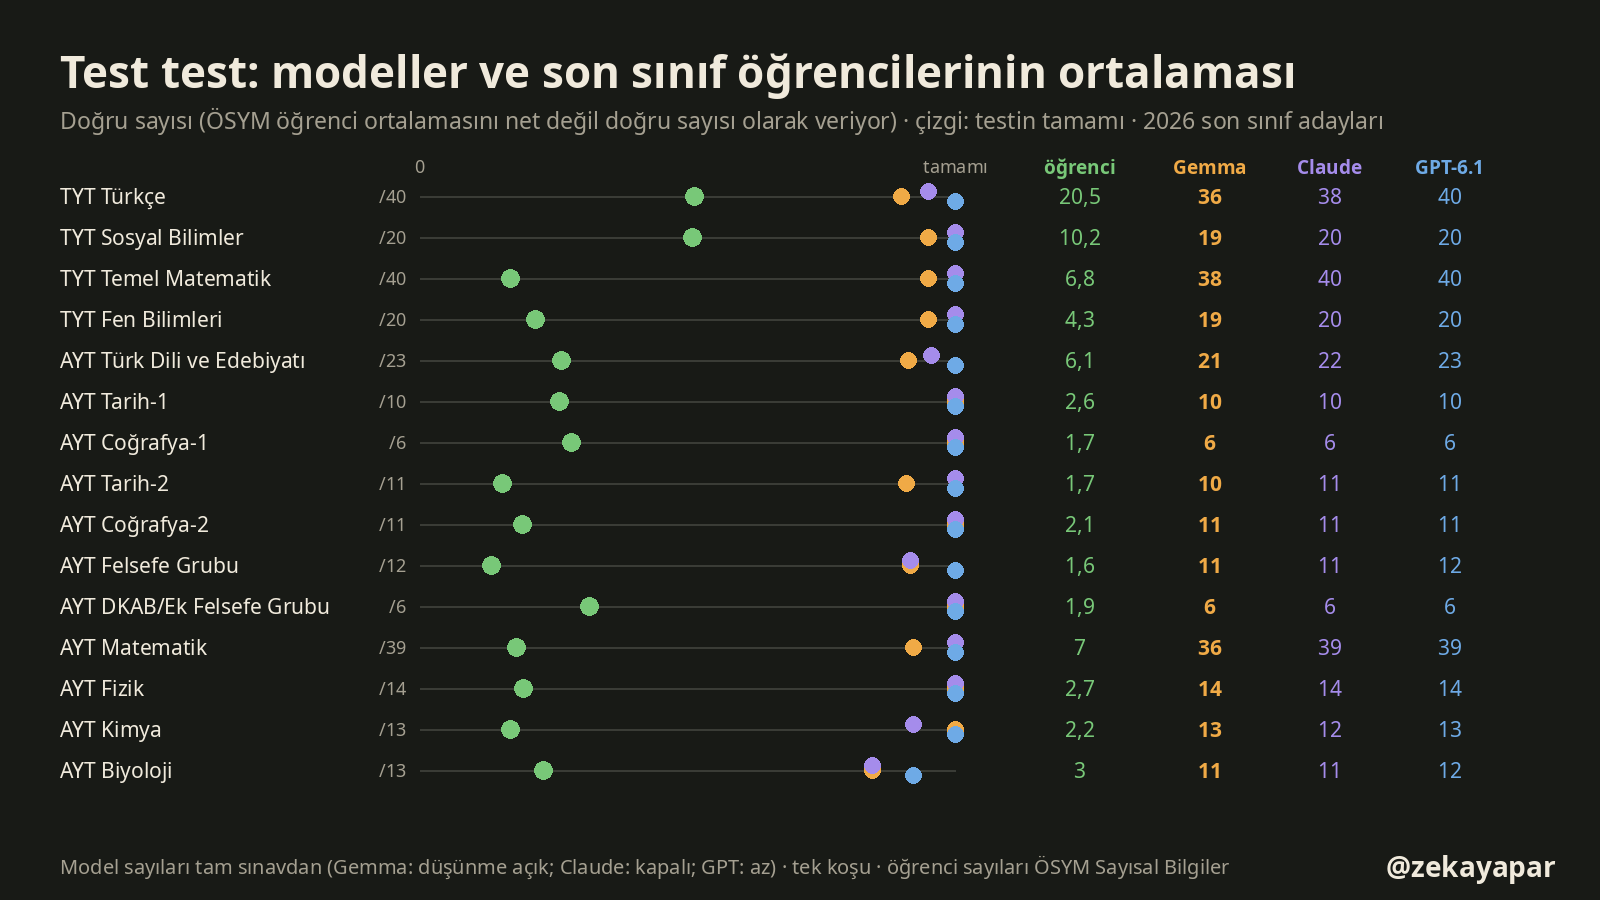
ÖSYM sınavdan sonra test test ortalamaları yayımlıyor. Burada dikkat edilmesi gereken bir ayrıntı var: ÖSYM bu ortalamaları net olarak değil, doğru sayısı olarak veriyor. Bu yüzden grafikte modellerin de doğru sayısını kullandım. Karşılaştırdığım grup son sınıf öğrencileri (TYT’ye giren 788.804 aday); tüm adayların ortalaması çok yakın.
TYT Türkçe’de son sınıf ortalaması 20,5 doğru; Gemma 4 31B 36, Claude 38, GPT 40 doğru yaptı. Fark matematikte daha da açılıyor: TYT Temel Matematik’te öğrenci ortalaması 6,8, AYT Matematik’te 7 doğru; Gemma bu testlerde 38 ve 36 doğru yaptı. Gemma’nın oran olarak en zayıf olduğu test AYT Biyoloji (11/13); 6 testin tamamını doğru yaptı.
Bu karşılaştırmanın sınırını da söylemeliyim: modeller her soruya süre baskısı olmadan, gerektiği kadar düşünerek cevap verdi; öğrenciler ise iki oturumda saatle yarıştı. Ayrıca AYT testlerine her öğrenci girmiyor; ortalamalar o teste giren adaylar üzerinden. Grafik “model öğrenciden zeki” demiyor; bu soruların bu modeller için ne kadar kolay olduğunu gösteriyor.
Türkçe mi, İngilizce mi?
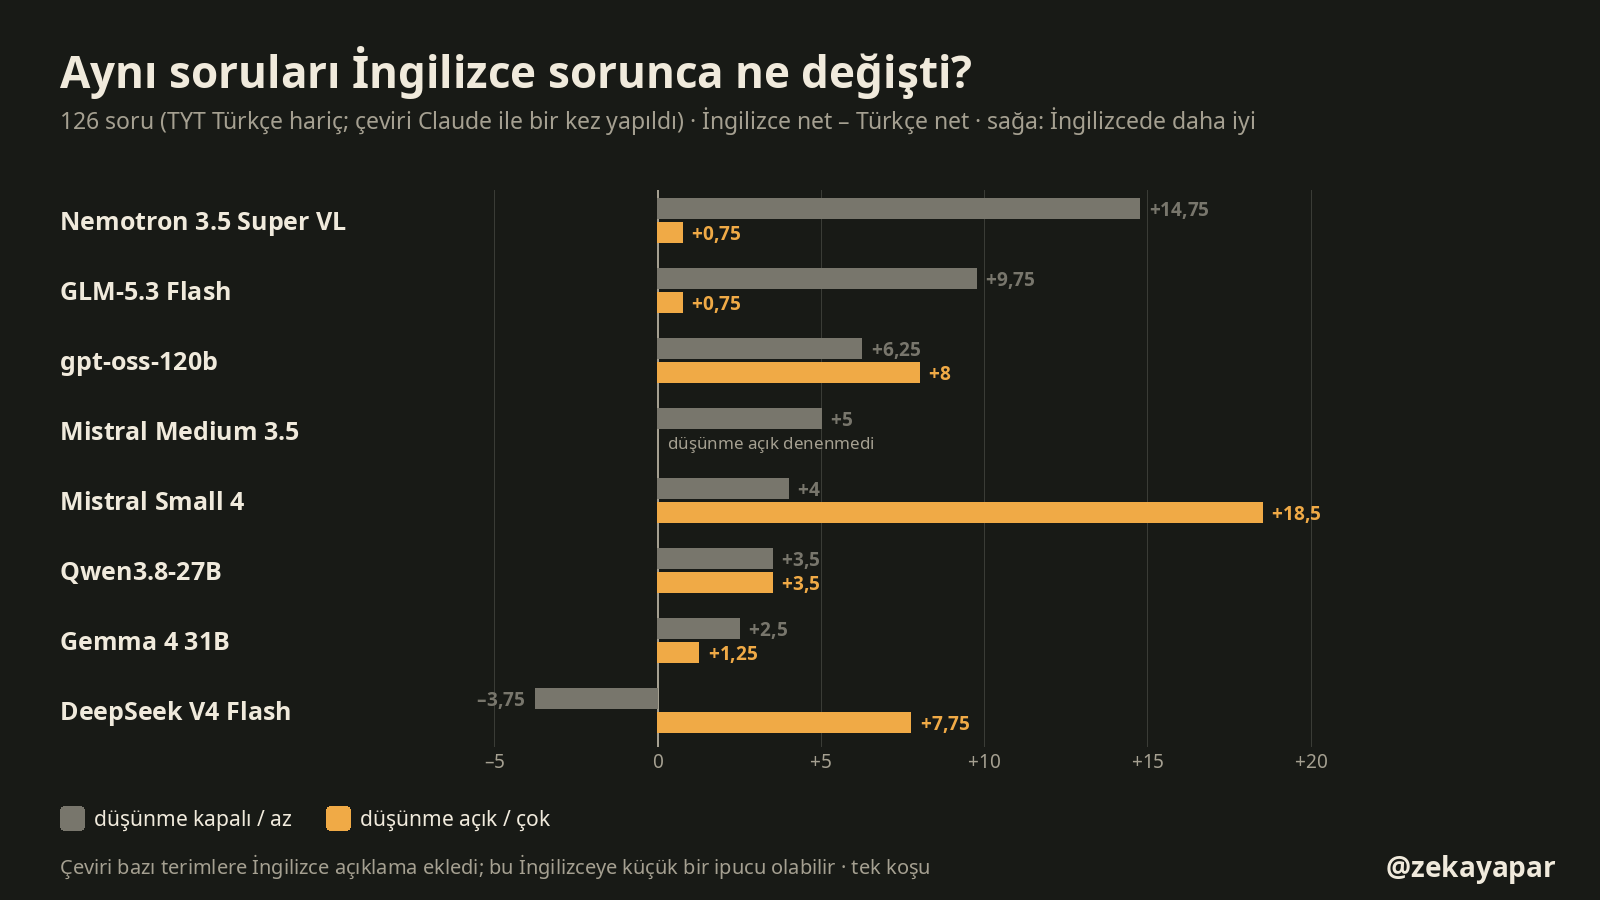
Soruların Türkçe olması modelleri zorluyor mu? Bunu görmek için TYT Türkçe dışındaki soruları İngilizceye çevirdim ve aynı modellere sordum (126 puanlı soru; dil bilgisi soruları çevrilince anlamını yitirdiği için TYT Türkçe’yi çevirmedim). Çeviriyi Claude Opus 5.5 ile bir kez yaptım ve dondurdum; birkaç soruyu elle kontrol ettim.
Düşünme kapalıyken 8 modelin 7 tanesi İngilizcede daha iyi yaptı. En büyük fark Nemotron’da: İngilizce +14,75 net. Tek istisna DeepSeek V4 Flash (−3,75). Düşünme açıkken Gemma, Nemotron ve GLM’de fark en çok 1,25 nete indi; bu modeller düşünürken Türkçe soruyu da neredeyse İngilizcesi kadar iyi çözüyor. Mistral Small 4 ise düşünürken İngilizcede +18,5 net daha iyiydi; Türkçe soruda düşünmek ona İngilizcedeki kadar yaramadı.
Bir çekincem var: çeviri modeli bazı Osmanlıca ve teknik terimlerin yanına parantez içinde İngilizce açıklama ekledi. Bu, İngilizce soruya küçük bir ipucu vermiş olabilir. Yani İngilizce lehine olan farkın bir kısmı çeviriden gelebilir.
Şıkların yeri değişince
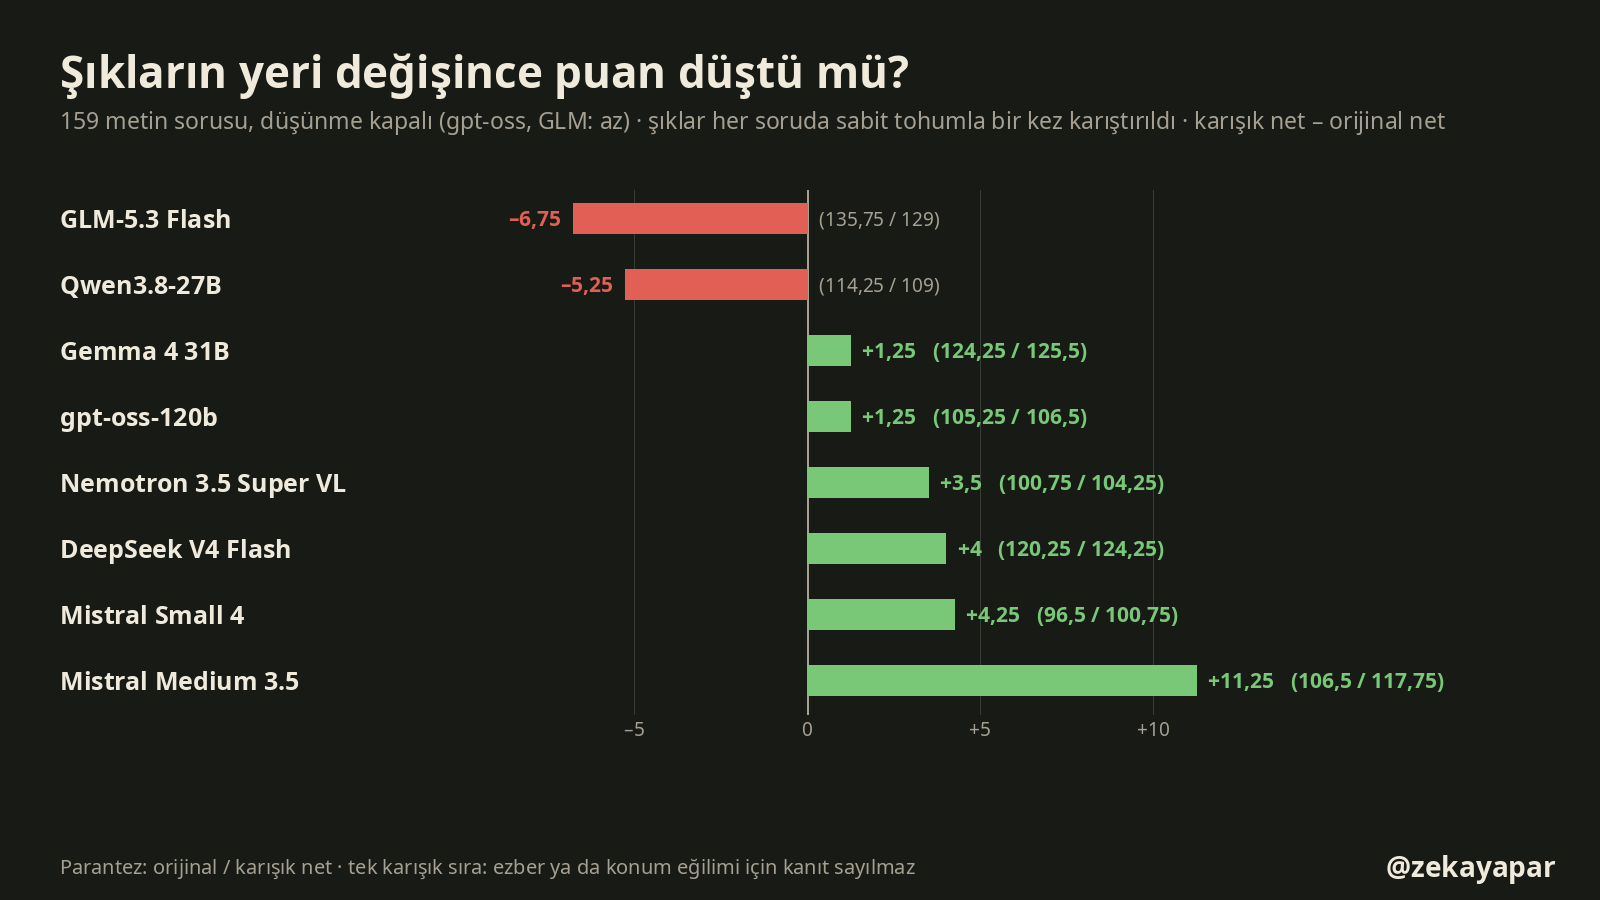
Bir model soruyu daha önce gördüyse doğru şıkkın harfini ezberlemiş olabilir. Bunu yoklamak için her sorunun şıklarını sabit bir tohumla karıştırdım ve modelin cevabını orijinal harfe geri çevirdim. Ezber olsaydı karışık sırada belirgin bir düşüş beklerdim.
Böyle bir düşüş yok: 8 modelin 2 tanesi biraz geriledi (GLM-5.3 Flash −6,75, Qwen3.8-27B −5,25), 6 tanesi ise karışık sırada daha iyi yaptı; Mistral Medium 3.5 +11,25 net. Düşünme kapalıyken sıcaklık 0 olmasına rağmen tek bir karıştırmanın sonucu bu kadar oynuyor. Bundan çıkardığım sonuç: tek karıştırma ezber için kanıt da değil, aklama da değil; daha çok karıştırmayla tekrar gerekiyor.
Elektrik ve süre
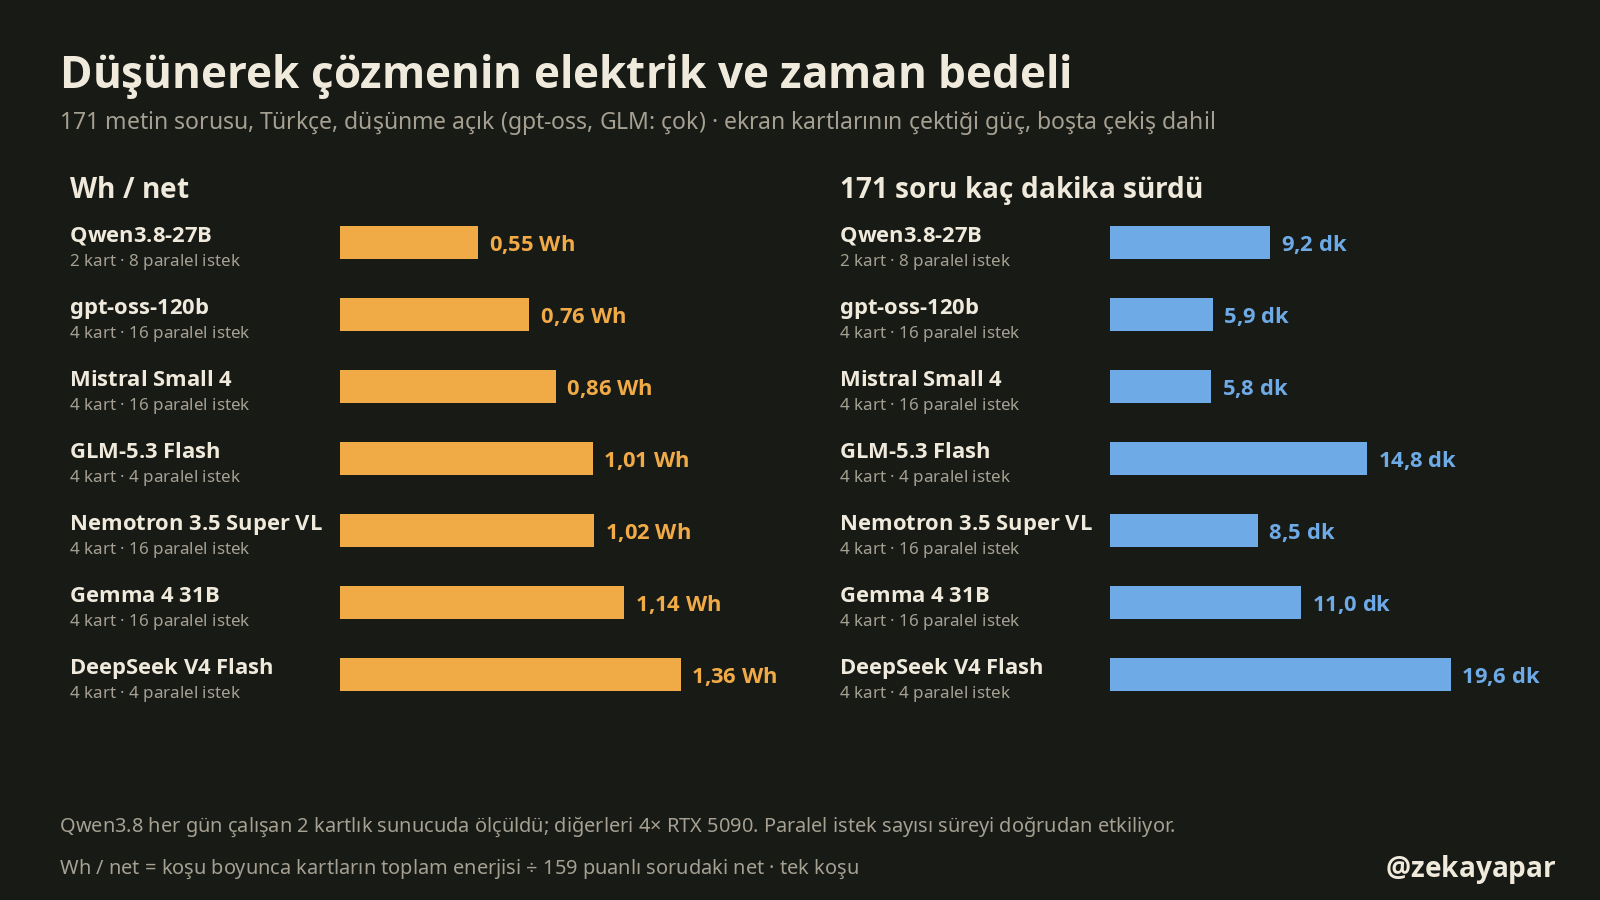
Yerel modellerin koşusu boyunca ekran kartlarının güç çekişini saniyede bir kaydettim. Düşünme açıkken 171 metin sorusu Mistral Small 4’te 5,8 dakika, Gemma 4 31B’de 11,0 dakika, DeepSeek V4 Flash’ta 19,6 dakika sürdü. Net başına enerji 0,55 Wh (Qwen3.8-27B) ile 1,36 Wh (DeepSeek V4 Flash) arasında; Gemma 4 31B 1,14 Wh.
Gemma 4 31B’nin sınavın tamamı (metin ve resimli sorular birlikte, düşünme açık) 26,8 dakika sürdü ve kartlar 417 Wh çekti. Resimli sorular daha pahalı: orada soru başına ortalama 2.870 token düşündü. Düşünme kapalıyken aynı model 171 soruyu 25 saniyede, 4,0 Wh ile bitirdi; ama puanı da ona göre.
Bu sayılar brüt: kartların boşta çektiği güç de içinde. Süreler ise aynı anda kaç soru gönderdiğime çok bağlı. vLLM ile çalışan modellere aynı anda 16 soru, llama.cpp ile çalışanlara (GLM, DeepSeek) 4 soru gönderdim; Qwen3.8-27B her gün çalışan 2 kartlık sunucumda 8 paralel istekle ölçüldü. Bu yüzden saniyede kaç token ürettiklerini yalnız “toplam verim” olarak veriyorum: Gemma 4 31B bu koşuda saniyede toplam 375 token, gpt-oss-120b 1.248 token üretti. Bunlar birçok paralel istekle ölçüldü; tek bir kullanıcının bir sohbette göreceği hız değil. Tek istekli hız ölçümünü ayrıca yapmadım.
Bu modeller sınavı daha önce görmüş olabilir mi?
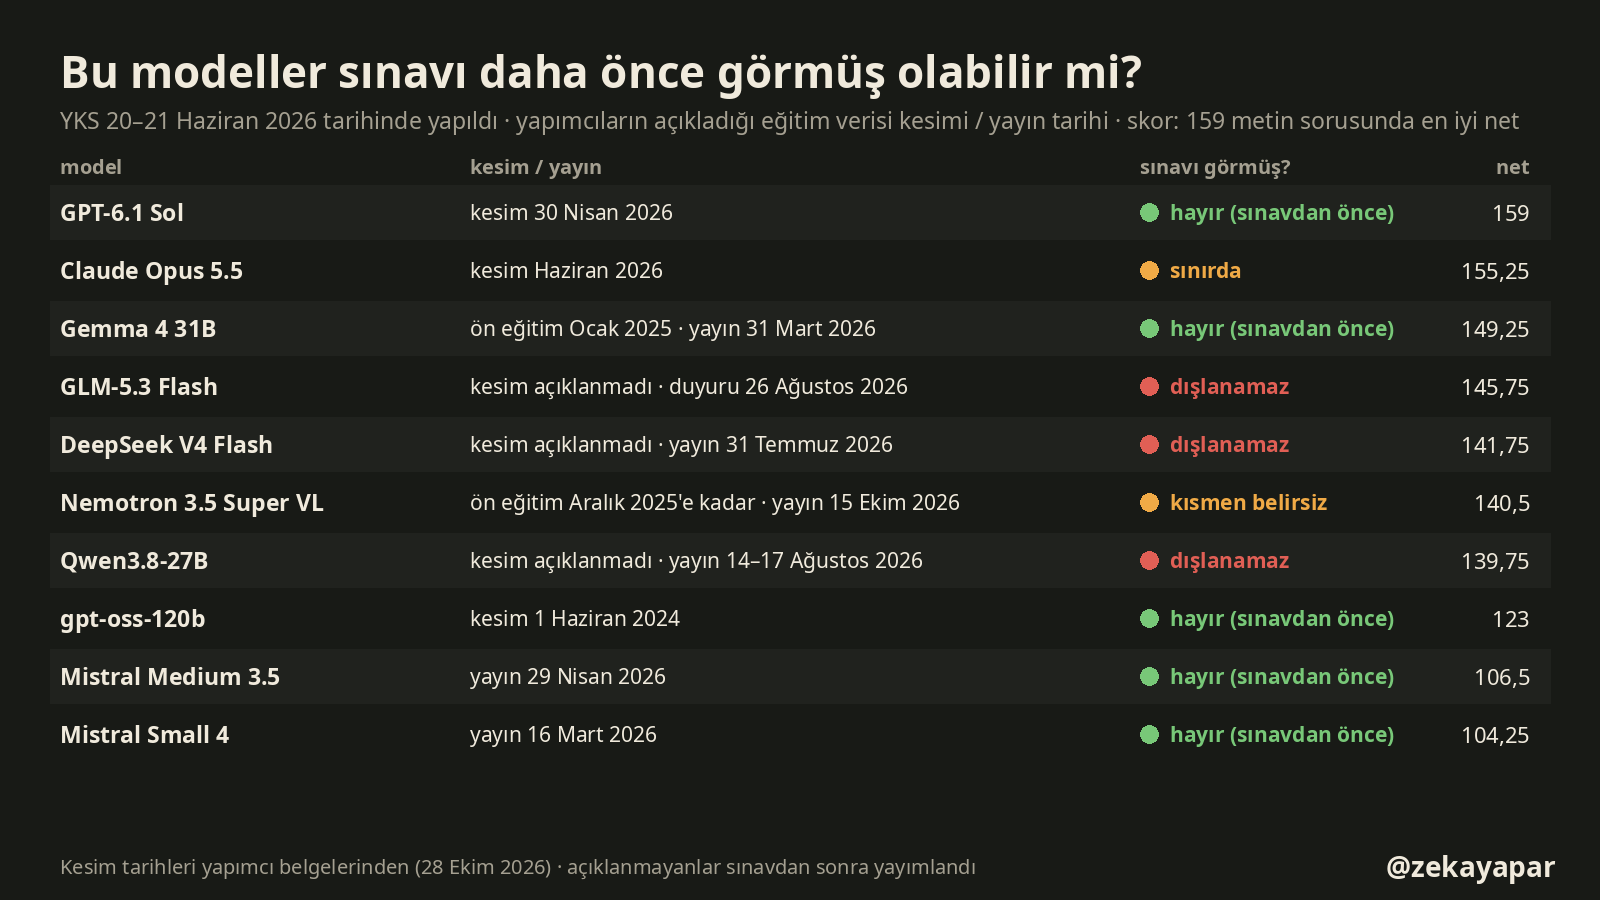
Sınav 20–21 Haziran 2026 tarihinde yapıldı; ÖSYM kitapçıkları ve cevap anahtarını 21 Haziran 2026 tarihinde yayımladı. Sınavdan sonra eğitilmiş bir model soruları ve cevapları görmüş olabilir. Bu yüzden her modelin eğitim verisinin nerede bittiğine, yapımcının açıklamasından baktım.
En yüksek iki skor (GPT-6.1 Sol 277, Gemma 4 31B 261 doğru) bilgi kesimi sınavdan önce olan modellerin: GPT-6.1 Sol’ün kesimi 30 Nisan 2026, Gemma 4 31B’nin ön eğitim verisi Ocak 2025’te bitiyor. Bu iki sonuç ezberle açıklanamaz. Claude Opus 5.5’in bilgi kesimi Haziran 2026, yani sınırda; bulut modellerinde web araması kapalıydı (Claude resimli sorularda yalnız resmi açmak için dosya okuma aracını kullanabildi). DeepSeek V4 Flash, Qwen3.8-27B ve GLM-5.3 Flash’ın yapımcıları kesim tarihini açıklamamış ve üçü de sınavdan sonra yayımlanmış; onlarda ezber ihtimalini dışlayamıyorum. Nemotron 3.5’in ön eğitim verisi 2025 sonunda bitiyor ama sonraki eğitim verisinin tarihi açıklanmamış.
Kontrol: 2023 sınavı
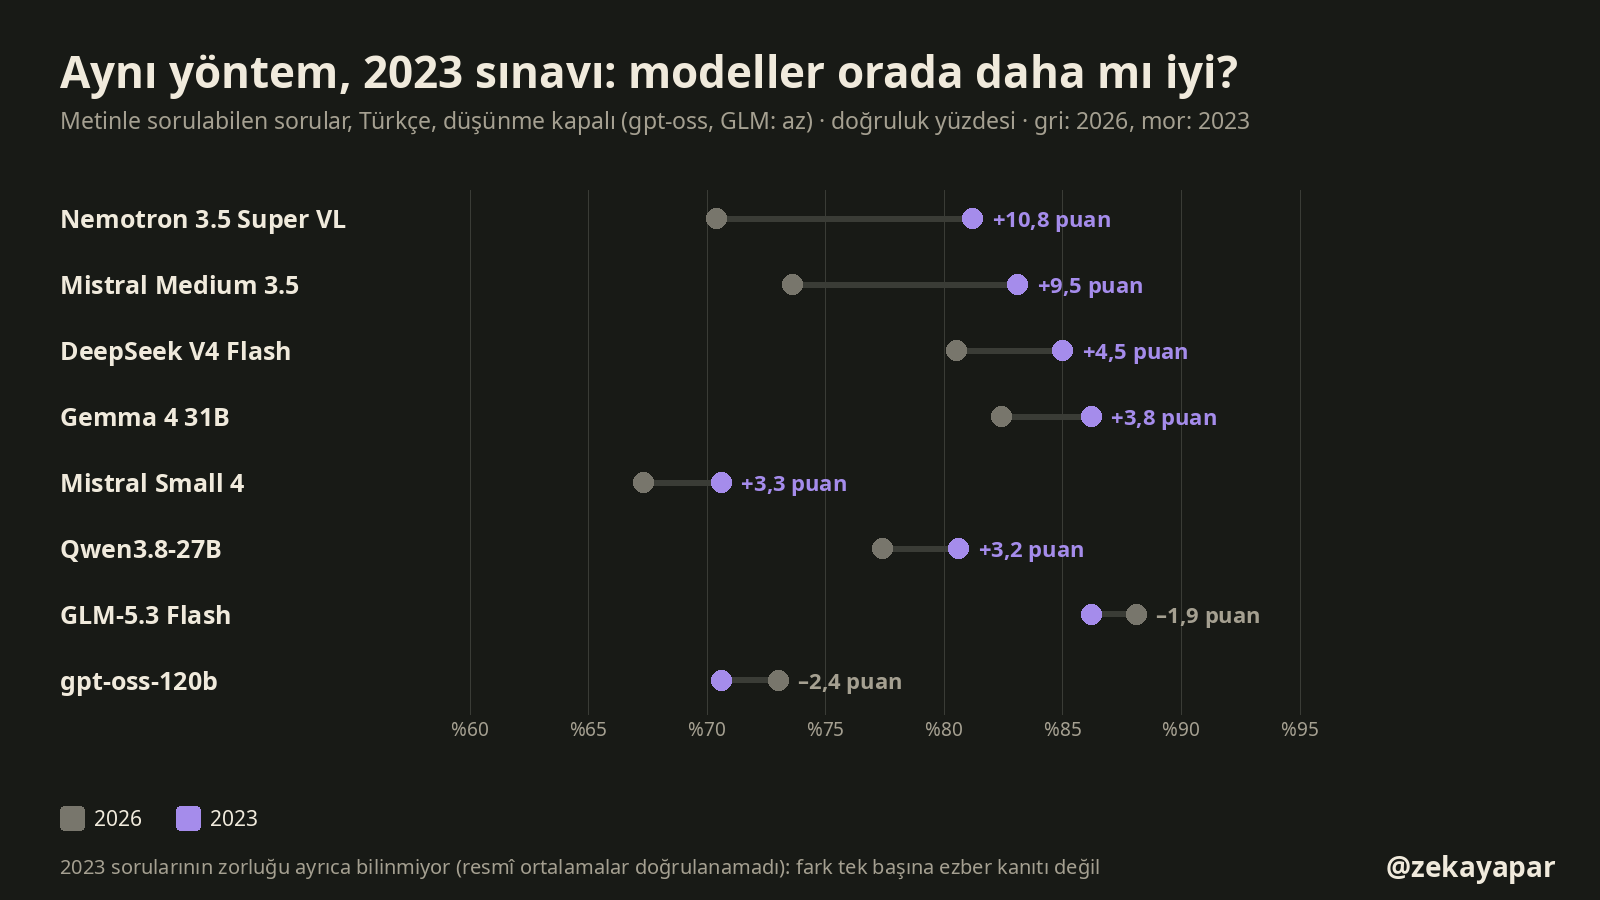
Bir kontrol daha yaptım: aynı yöntemle 2023 YKS’sinin metin sorularını, düşünme kapalı olarak sordum. 2023 soruları bu modellerin hepsinin eğitim verisine girmiş olabilir; model 2023’te belirgin biçimde daha iyiyse bu ezbere işaret edebilir. 8 modelin 6 tanesi 2023’te daha yüksek doğruluk aldı. En büyük farklar Nemotron 3.5 (+10,8 puan) ve Mistral Medium 3.5’te (+9,5 puan); GLM-5.3 Flash (−1,9) ve gpt-oss-120b (−2,4) ters yönde.
Bunu ezber kanıtı olarak okumuyorum. 2023 sınavı 2026’dan daha kolay da olabilir: ÖSYM’nin 2023 için yayımladığı ortalama dosyasına ulaşamadım, ikincil kaynaklardaki sayıları da doğrulayamadım. Zorluk farkını bilmeden bu farkı yorumlamak mümkün değil.
Günlük kullanımda ne demek
Evde, internete çıkmadan çalışan bir model artık YKS sorularının büyük kısmını çözebiliyor. Bir öğrenci için en işe yarar kısmı bence şu: düşünme açıkken model yalnız cevabı değil, çözüm yolunu da yazıyor. Ama iki şeyi akılda tutmak gerekiyor. Birincisi, düşünmeyi kapatıp hızlı cevap istemek matematikte işe yaramıyor. İkincisi, en iyi yerel model bile 278 sorudan 15 tanesine kendinden emin biçimde yanlış cevap verdi; çözüm yolu ne kadar düzgün görünse de kontrol etmek gerekiyor.
Benim için sonuç
Bu testten önce yerel modellerin Türkçe sınav sorularında bulutun epey gerisinde kalacağını düşünüyordum. Sözel testlerde fark beklediğimden küçük çıktı; asıl fark şekilli sorularda ve matematikte, o da düşünmeyle büyük ölçüde kapanıyor. Beni en çok şaşırtan, 31 milyarlık bir modelin, sıkıştırılmadan çalıştığında, kendinden çok daha büyük sıkıştırılmış modellerin önüne geçmesi oldu. Sıradaki denemeler: birkaç tekrarla oynaklığı ölçmek, şıkları daha çok kez karıştırmak ve tek istekli hızı ayrıca ölçmek.
Sınırlar
- Her koşul bir kez çalıştı. Düşünme açıkken sıcaklık sıfır değil; tekrar edilse birkaç netlik oynama olağan. Birbirine yakın modellerin sırası değişebilir.
- Mistral Medium 3.5’i düşünme açık çalıştıramadım: dört karta bölünen bu büyük yoğun model düşünmeli sorularda çok yavaştı, koşunun saatler süreceği görülünce durdurdum. Resimli sorularda da boş cevap döndü.
- Qwen3.8-27B’yi resimli sorularda denemedim (sunucum metin modunda çalışıyor). gpt-oss-120b ve DeepSeek V4 Flash resim okuyamıyor.
- Şekilli sorular kitapçıktan kırpılmış resim olarak verildi; resimlerde ÖSYM’nin filigranı da var. Adaylar filigransız kâğıt gördü.
- İngilizce sorular Claude Opus 5.5 ile çevrildi; çeviri bazı terimlere açıklama ekledi. TYT Türkçe çevrilmedi.
- Bulut modelleri abonelik komut satırı araçlarıyla (Claude Code ve Codex) çalıştı: Claude düşünme kapalı, GPT az düşünme ayarında. Onlarda İngilizce, karıştırma ve 2023 koşuları yapılmadı, enerji ölçülemedi.
- Büyük modeller sıkıştırılmış (2–4 bit) hâlleriyle çalıştı; tam hassasiyetli hâlleri farklı sonuç verebilir.
- Enerji yalnız ekran kartlarının kendi sayacı; işlemci ve bilgisayarın geri kalanı dahil değil.
- Öğrenci karşılaştırması doğru sayısıyla yapıldı; modellerin süre sınırı yoktu.
Tam tablo ve yöntem
Tam sınav (278 puanlı soru; hücre: net (doğru/yanlış/boş)). TDE-SB1: Türk Dili ve Edebiyatı-Sosyal Bilimler-1, SB2: Sosyal Bilimler-2. Düşünme sütununda GLM-5.3 Flash için az/çok, GPT için az düşünme ayarı.
| Model | Düşünme | TYT Türkçe | TYT Sosyal | TYT Temel Mat. | TYT Fen | AYT TDE-SB1 | AYT SB2 | AYT Mat. | AYT Fen | Net | Doğru |
|---|---|---|---|---|---|---|---|---|---|---|---|
| GPT-6.1 Sol | az | 40 (40/0/0) | 20 (20/0/0) | 40 (40/0/0) | 20 (20/0/0) | 39 (39/0/0) | 40 (40/0/0) | 39 (39/0/0) | 38,75 (39/1/0) | 276,75 | 277 |
| Claude Opus 5.5 | kapalı | 37,5 (38/2/0) | 20 (20/0/0) | 40 (40/0/0) | 20 (20/0/0) | 37,75 (38/1/0) | 38,75 (39/1/0) | 39 (39/0/0) | 36,25 (37/3/0) | 269,25 | 271 |
| Gemma 4 31B | açık | 35,25 (36/3/1) | 18,75 (19/1/0) | 37,75 (38/1/1) | 18,75 (19/1/0) | 36,5 (37/2/0) | 37,5 (38/2/0) | 35,25 (36/3/0) | 37,5 (38/2/0) | 257,25 | 261 |
| Gemma 4 31B | kapalı | 31,5 (33/6/1) | 17,5 (18/2/0) | −1,25 (7/33/0) | 10 (12/8/0) | 31,5 (33/6/0) | 36,25 (37/3/0) | 1,5 (9/30/0) | 27,5 (30/10/0) | 154,5 | 179 |
| GLM-5.3 Flash | çok | 34 (35/4/1) | 20 (20/0/0) | 34,25 (35/3/2) | 18,75 (19/1/0) | 32 (33/4/2) | 37,5 (38/2/0) | 31,25 (32/3/4) | 37,75 (38/1/1) | 245,5 | 250 |
| GLM-5.3 Flash | az | 29,25 (31/7/2) | 16,25 (17/3/0) | 26,75 (29/9/2) | 15 (16/4/0) | 32,75 (34/5/0) | 35 (36/4/0) | 28 (30/8/1) | 28,75 (31/9/0) | 211,75 | 224 |
| Nemotron 3.5 Super VL | açık | 25,5 (28/10/2) | 20 (20/0/0) | 25,25 (26/3/11) | 14,5 (15/2/3) | 30,25 (32/7/0) | 36,25 (37/3/0) | 29,25 (30/3/6) | 32,75 (33/1/6) | 213,75 | 221 |
| Nemotron 3.5 Super VL | kapalı | 20,25 (24/15/1) | 16,25 (17/3/0) | 2,5 (10/30/0) | 5 (8/12/0) | 22,75 (26/13/0) | 27,5 (30/10/0) | 0,5 (8/30/1) | 11,25 (17/23/0) | 106 | 140 |
| Mistral Small 4 | açık | 16 (20/16/4) | 11,25 (13/7/0) | 10 (13/12/15) | 12,75 (14/5/1) | 21,5 (25/14/0) | 25,5 (28/10/2) | 16,5 (19/10/10) | 20,75 (24/13/3) | 134,25 | 156 |
| Mistral Small 4 | kapalı | 16 (20/16/4) | 15 (16/4/0) | 2 (9/28/3) | 6,75 (9/9/2) | 24,5 (27/10/2) | 24,25 (27/11/2) | 0 (7/28/4) | 10 (16/24/0) | 98,5 | 131 |
Metin soruları (159 puanlı soru; parantezde doğruluk). İngilizce farkı 126 soruda, karıştırma düşünme kapalı, 2023 kontrolü düşünme kapalı (160 soru, 2023 iptalleri doğrulanmadı).
| Model | Düşünme kapalı/az | Düşünme açık/çok | Kesilen (açık) | Düşünme kazancı | İngilizce farkı (kapalı) | İngilizce farkı (açık) | Karıştırma farkı | Doğruluk 2026 / 2023 |
|---|---|---|---|---|---|---|---|---|
| GPT-6.1 Sol | 159 (%100,0) | — | — | — | — | — | — | — |
| Claude Opus 5.5 | 155,25 (%98,1) | — | — | — | — | — | — | — |
| Gemma 4 31B | 124,25 (%82,4) | 149,25 (%95,0) | 0 | +25 | +2,5 | +1,25 | +1,25 | %82,4 / %86,2 |
| GLM-5.3 Flash | 135,75 (%88,1) | 145,75 (%93,1) | 2 | +10 | +9,75 | +0,75 | −6,75 | %88,1 / %86,2 |
| DeepSeek V4 Flash | 120,25 (%80,5) | 141,75 (%90,6) | 2 | +21,5 | −3,75 | +7,75 | +4 | %80,5 / %85,0 |
| Nemotron 3.5 Super VL | 100,75 (%70,4) | 140,5 (%90,6) | 1 | +39,75 | +14,75 | +0,75 | +3,5 | %70,4 / %81,2 |
| Qwen3.8-27B | 114,25 (%77,4) | 139,75 (%89,3) | 8 | +25,5 | +3,5 | +3,5 | −5,25 | %77,4 / %80,6 |
| gpt-oss-120b | 105,25 (%73,0) | 123 (%81,1) | 6 | +17,75 | +6,25 | +8 | +1,25 | %73,0 / %70,6 |
| Mistral Medium 3.5 | 106,5 (%73,6) | — | — | — | +5 | — | +11,25 | %73,6 / %83,1 |
| Mistral Small 4 | 96,5 (%67,3) | 104,25 (%71,1) | 5 | +7,75 | +4 | +18,5 | +4,25 | %67,3 / %70,6 |
Öğrenci karşılaştırması (doğru sayısı; öğrenci ortalamaları ÖSYM Sayısal Bilgiler, son sınıf ve tüm adaylar).
| Test | Geçerli soru | Son sınıf ort. | Tüm adaylar ort. | GPT-6.1 Sol | Claude Opus 5.5 | Gemma 4 31B | GLM-5.3 Flash | Nemotron 3.5 Super VL | Mistral Small 4 |
|---|---|---|---|---|---|---|---|---|---|
| TYT Türkçe | 40 | 20,5 (SS 8,4) | 20,1 | 40 | 38 | 36 | 35 | 28 | 20 |
| TYT Sosyal Bilimler | 20 | 10,2 (SS 3,9) | 10 | 20 | 20 | 19 | 20 | 20 | 13 |
| TYT Temel Matematik | 40 | 6,8 (SS 8) | 6,4 | 40 | 40 | 38 | 35 | 26 | 13 |
| TYT Fen Bilimleri | 20 | 4,3 (SS 5,3) | 3,9 | 20 | 20 | 19 | 19 | 15 | 14 |
| AYT Türk Dili ve Edebiyatı | 23 | 6,1 (SS 5,2) | 6,5 | 23 | 22 | 21 | 17 | 17 | 14 |
| AYT Tarih-1 | 10 | 2,6 (SS 2,7) | 2,9 | 10 | 10 | 10 | 10 | 9 | 8 |
| AYT Coğrafya-1 | 6 | 1,7 (SS 1,8) | 1,9 | 6 | 6 | 6 | 6 | 6 | 3 |
| AYT Tarih-2 | 11 | 1,7 (SS 2,3) | 1,9 | 11 | 11 | 10 | 11 | 11 | 8 |
| AYT Coğrafya-2 | 11 | 2,1 (SS 2,5) | 2,4 | 11 | 11 | 11 | 10 | 10 | 7 |
| AYT Felsefe Grubu | 12 | 1,6 (SS 2,1) | 1,8 | 12 | 11 | 11 | 11 | 10 | 7 |
| AYT DKAB/Ek Felsefe Grubu | 6 | 1,9 (SS 2,2) | 2 | 6 | 6 | 6 | 6 | 6 | 6 |
| AYT Matematik | 39 | 7 (SS 9,1) | 7,1 | 39 | 39 | 36 | 32 | 30 | 19 |
| AYT Fizik | 14 | 2,7 (SS 3,7) | 2,6 | 14 | 14 | 14 | 14 | 11 | 7 |
| AYT Kimya | 13 | 2,2 (SS 3,7) | 2,1 | 13 | 12 | 13 | 13 | 11 | 8 |
| AYT Biyoloji | 13 | 3 (SS 3,6) | 3 | 12 | 11 | 11 | 11 | 11 | 9 |
Süre ve enerji (171 metin sorusu, Türkçe, düşünme açık). Wh brüt (kartların boşta çekişi dahil). Toplam verim = koşuda üretilen tüm token ÷ duvar saati süresi; aynı anda birçok istekle ölçüldü, tek kullanıcı hızı değildir.
| Model | Koşul | Dakika | Wh | Wh/net | Ort. token/soru | Toplam verim (token/sn) | Kart | Paralel istek |
|---|---|---|---|---|---|---|---|---|
| Qwen3.8-27B | tr-on | 9,2 | 77,1 | 0,552 | 2.068 | 641 | 2 | 8 |
| gpt-oss-120b | tr-high | 5,9 | 93,2 | 0,758 | 2.514 | 1.248 | 4 | 16 |
| Mistral Small 4 | tr-on | 5,8 | 90,1 | 0,864 | 1.744 | 861 | 4 | 16 |
| GLM-5.3 Flash | tr-high | 14,8 | 147,3 | 1,011 | 778 | 150 | 4 | 4 |
| Nemotron 3.5 Super VL | tr-on | 8,5 | 143,1 | 1,018 | 2.035 | 697 | 4 | 16 |
| Gemma 4 31B | tr-on | 11,0 | 169,9 | 1,139 | 1.448 | 375 | 4 | 16 |
| DeepSeek V4 Flash | tr-on | 19,6 | 193,3 | 1,364 | 1.244 | 180 | 4 | 4 |
Eğitim verisi kesimleri (28 Ekim 2026’da yapımcı belgelerinden).
| Model | Kesim / yayın | Sınavı görmüş olabilir mi? | Kaynak |
|---|---|---|---|
| GPT-6.1 Sol | bilgi kesimi 30 Nisan 2026 | Hayır (kesim sınavdan önce). Koşuda web araması kapalıydı (codex exec --search verilmedi). | developers.openai.com/api/docs/models/gpt-6.1-sol |
| Claude Opus 5.5 | bilgi kesimi Haziran 2026 | Sınır durumu (ay aynı). Koşuda araç yoktu (--tools ""; görselde yalnız Read). | platform.claude.com/docs/en/models/opus-5-5/overview |
| Gemma 4 31B | ön eğitim kesimi Ocak 2025; yayın 31 Mart 2026 | Hayır | huggingface.co/google/gemma-4-31B, ai.google.dev/gemma/docs/releases |
| gpt-oss-120b | bilgi kesimi 1 Haziran 2024 | Hayır | developers.openai.com/api/docs/models/gpt-oss-120b |
| Mistral Small 4 | yayın 16 Mart 2026 | Hayır | Mistral model kartı / sağlayıcı listeleri |
| Mistral Medium 3.5 | yayın 29 Nisan 2026 (kesim Ocak 2026, üçüncü taraf) | Hayır | sağlayıcı listeleri |
| Nemotron 3.5 Super VL | temel veri 2013–Aralık 2025; son eğitim verisi açıklanmadı; yayın 15 Ekim 2026 | Ön eğitim hayır; son eğitim belirsiz | build.nvidia.com model kartı |
| DeepSeek V4 Flash | kesim açıklanmadı; yayın 31 Temmuz 2026 | Belirsiz | resmî kartta yok (epoch.ai: unknown) |
| Qwen3.8-27B | kesim açıklanmadı; yayın 14–17 Ağustos 2026 | Belirsiz | resmî kartta yok |
| GLM-5.3 Flash | kesim açıklanmadı; duyuru 26 Ağustos 2026 | Belirsiz | Z.ai belgeleri (anlık kopya) |
Çalıştırma ayarları (model deposu @ revizyon; sıcaklık; düşünme kapalı / açık en çok token).
| Model | Depo @ revizyon | Çalıştırıcı | Sıcaklık · token sınırı | Paralel istek |
|---|---|---|---|---|
| Gemma 4 31B | google/gemma-4-31B-it@842da3794eaa0b77d5f08bae87a17459d91ff475 (BF16) | vLLM 0.30.0, TP4, gpu-memory-utilization 0.80, max-model-len 32768, reasoning-parser gemma4 | kapalı 0 / açık 1 · en çok 1.024 / 16.000 token | 16 |
| GLM-5.3 Flash | unsloth/GLM-5.3-Flash-GGUF@a38483c8cd5df544f53d70fb281afe97369d5ab6 UD-Q2_K_XL + mmproj-F16 | llama.cpp b11803 (a37cc4610) llama-server, -ngl 999 -fa on --fit on, -c 81920 -np 4 | kapalı 1 / açık 1 · en çok 8.192 / 16.000 token | 4 |
| DeepSeek V4 Flash | unsloth/DeepSeek-V4-Flash-0731-GGUF@fbbb5b93fb787c21338159b0af3318bb3f4d9768 UD-IQ3_XXS | llama.cpp b11803 (a37cc4610) llama-server, -ngl 999 -fa on --fit on, -c 81920 -np 4 | kapalı 0 / açık 1 · en çok 1.024 / 16.000 token | 4 |
| Nemotron 3.5 Super VL | nvidia/NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-NVFP4@da5b2650a835292c678994a1fa3fb653250fb508 | vLLM 0.30.0 (kart 0.32 istiyor), TP4, gpu-memory-utilization 0.80, trust-remote-code, mamba-ssm-cache-dtype float16, reasoning-parser nemotron_v3, MTP kapalı | kapalı 0 / açık 1 · en çok 1.024 / 16.000 token | 16 |
| Qwen3.8-27B | nvidia/Qwen3.8-27B-NVFP4@482ca0f3832238542f8f5295dde86b5f22711d80 | vLLM 0.30.0 (günlük sunucu, TP2, MTP-3 spekülatif, max_model_len 16384, max-num-seqs 10) | kapalı 0 / açık 0,6 · en çok 1.024 / 14.000 token | 8 |
| gpt-oss-120b | openai/gpt-oss-120b@b5c939de8f754692c1647ca79fbf85e8c1e70f8a (MXFP4) | vLLM 0.30.0, TP4, gpu-memory-utilization 0.80, max-model-len 32768, max-num-seqs 16, reasoning-parser openai_gptoss | kapalı 1 / açık 1 · en çok 4.096 / 16.000 token | 16 |
| Mistral Medium 3.5 | unsloth/Mistral-Medium-3.5-128B-GGUF@c8f5b1477e1b22cd2d819157d450f001f7047298 UD-Q4_K_XL + mmproj-F16 | llama.cpp b11803 (a37cc4610) llama-server, -ngl 999 -fa on --fit on (monitör kartında 5 GB pay), -c 36864 -np 2 (ilk ayar belleğe sığmadı) | 0 · en çok 1.024 token | 4 (sunucuda 2 yuva) |
| Mistral Small 4 | mistralai/Mistral-Small-4-119B-2603-NVFP4@45331841b631f4e281df8e959ea3cc9beb84298a | vLLM 0.30.0 + shims/sitecustomize.py (transformers 5.18 pixtral ad uyumu), TP4 (kart TP2 öneriyor; 2×32 GB sığmıyor), gpu-memory-utilization 0.80, attention-backend TRITON_MLA, reasoning-parser mistral | kapalı 0 / açık 0,7 · en çok 1.024 / 16.000 token | 16 |
| Claude Opus 5.5 | — | Claude Code CLI 2.1.303, claude -p, MAX_THINKING_TOKENS=0 | — | 3 |
| GPT-6.1 Sol | — | codex-cli 0.163.0, codex exec --sandbox read-only --ephemeral, model_reasoning_effort=low | — | 3 |
- Donanım: 4× NVIDIA GeForce RTX 5090 (32 GB); Qwen3.8-27B günlük sunucunun 2 kartında. vLLM 0.30.0, llama.cpp b11803.
- Ayrıştırma: cevaptaki son “Cevap: X” / “Answer: X” satırı (A–E), yoksa son satırda tek harf; “BOŞ”, okunamayan ya da token sınırında kesilen cevap boş sayıldı.
- Şık karıştırma: soru başına
random.Random("2026:<soru kimliği>")ile A–E permütasyonu; cevap orijinal harfe geri eşlendi. - Şekilli soru seçimi: şekil/tablo/grafik, formül resmi, içerikte alt çizgi, boş şık ya da özel sembol içeren sorular resimle soruldu; geri kalanlar metinle.
- Enerji:
nvidia-smipower.draw, saniyede bir, modelin kullandığı kartların toplamı, koşu boyunca toplandı.
İngilizce istemler (çeviri koşusu):
You are a candidate taking Turkey's university entrance exam (YKS). Each question has five options (A–E) and exactly one correct answer. Four wrong answers cancel one correct answer; you may leave a question blank if unsure. Do not explain; write a single line only: 'Answer: X' (X = A, B, C, D or E; to leave blank write 'Answer: BLANK').
You are a candidate taking Turkey's university entrance exam (YKS). Each question has five options (A–E) and exactly one correct answer. Four wrong answers cancel one correct answer; you may leave a question blank if unsure. Solve carefully; the last line of your reply must be exactly 'Answer: X' (X = A, B, C, D or E; to leave blank write 'Answer: BLANK').
Kaynaklar
- ÖSYM, 2026-YKS TYT temel soru kitapçığı ve cevap anahtarı: dokuman.osym.gov.tr/pdfdokuman/2026/YKS/TSK/yks_tyt_2026_kitapcik_d350.pdf
- ÖSYM, 2026-YKS AYT temel soru kitapçığı ve cevap anahtarı: dokuman.osym.gov.tr/pdfdokuman/2026/YKS/TSK/yks_ayt_2026_kitapcik_kt12.pdf
- ÖSYM, 2026-YKS Sayısal Bilgiler (test ortalamaları ve standart sapmaları, s. 3): dokuman.osym.gov.tr/pdfdokuman/2026/YKS/SB/sayisal_ykdd21072026.pdf
- ÖSYM, 2026-YKS sonuçları açıklandı (iptal edilen sorular): www.osym.gov.tr/2026-yks-sonuclari-aciklandi
- ÖSYM, 2023-YKS temel soru kitapçıkları (kontrol seti): www.osym.gov.tr/2023yks-tyt-ayt-ve-ydt-temel-soru-kitapciklari-ve-cevap-anahtarlari
- GPT-6.1 Sol eğitim verisi kesimi / yayın tarihi: developers.openai.com/api/docs/models/gpt-6.1-sol
- Claude Opus 5.5 eğitim verisi kesimi / yayın tarihi: platform.claude.com/docs/en/models/opus-5-5/overview
- Gemma 4 31B eğitim verisi kesimi / yayın tarihi: huggingface.co/google/gemma-4-31B
- gpt-oss-120b eğitim verisi kesimi / yayın tarihi: developers.openai.com/api/docs/models/gpt-oss-120b
İndir: betikler ve soru başına sonuçlar (ZIP) · yazıdaki tüm sayılar (JSON). ZIP’teki her satırda yalnız soru kimliği, modelin cevabı, resmî cevap, doğru/yanlış, puanlanıp puanlanmadığı, süre ve token sayısı var; soru metinleri ve model çözümleri telif nedeniyle yok. Betikler soruları ÖSYM’nin PDF’lerinden yeniden çıkarır.