 zekayapar
Yapay zekâya yazım hatasıyla sorunca cevap bozuluyor mu?
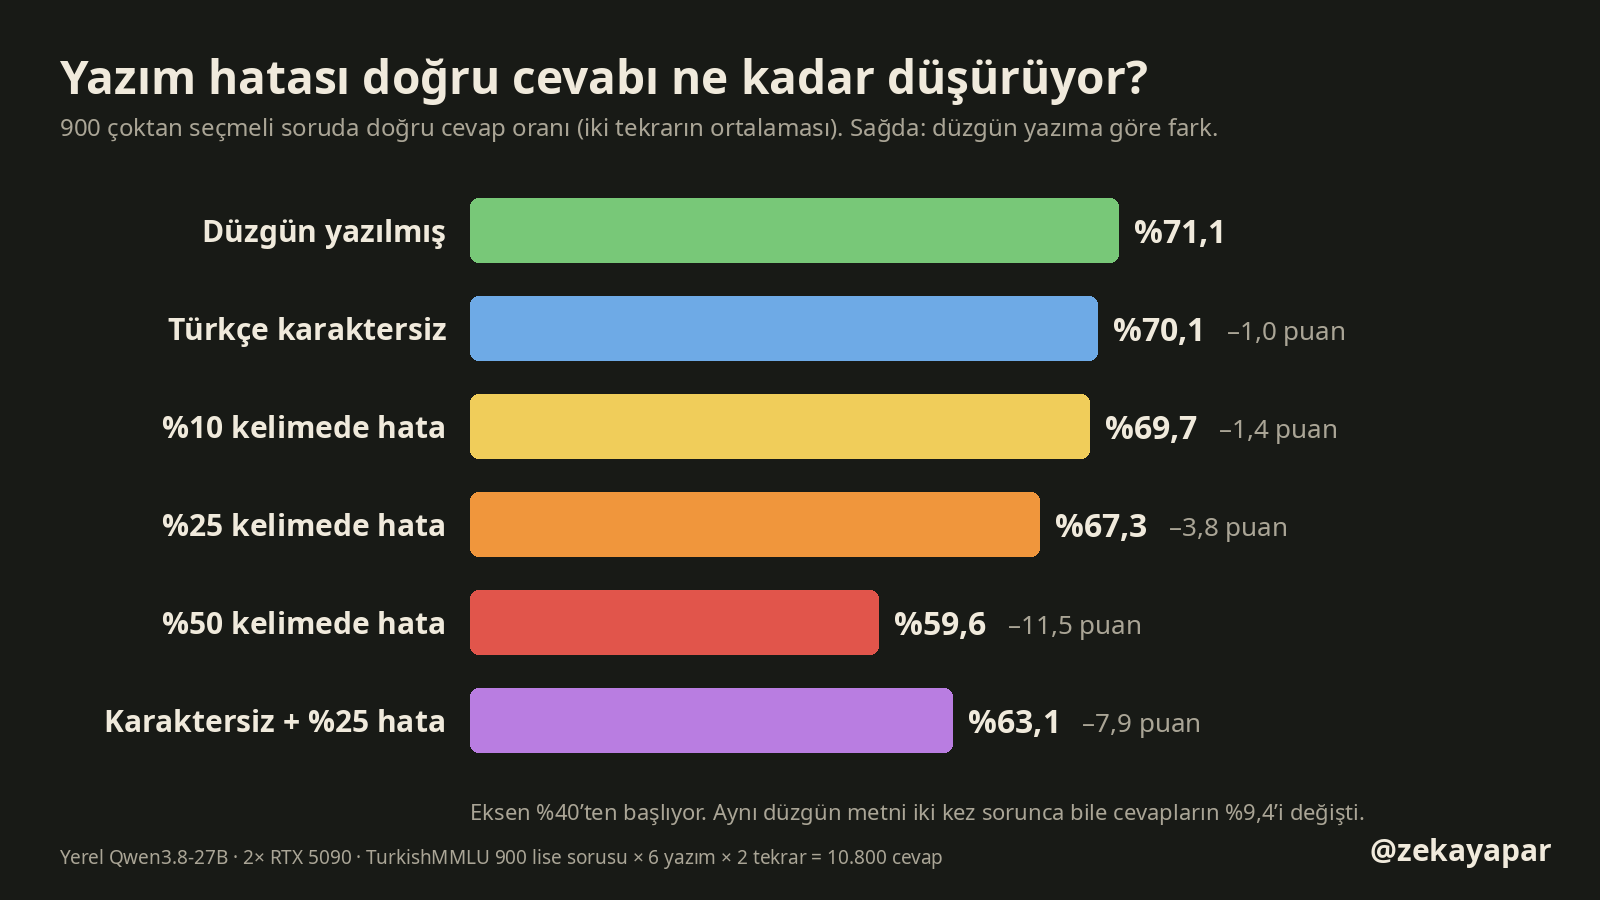
Yerel Qwen’e 900 lise sorusunu altı yazımla 10.800 kez sordum: Türkçe karaktersiz yazmak fark etmiyor, kelimelerin yarısı hatalıysa doğru cevap 11,5 puan düşüyor.
Model ve sunucu
- Qwen3.8-27B NVFP4 · vLLM 0.30.0 · düşünme kapalı
- 2× RTX 5090 (TP2)
- Sıcaklık 0 · cevap: yalnız şık harfi (en çok 16 token)
Veri ve ölçüm
- TurkishMMLU · 9 dersten 900 lise sorusu
- 6 yazım biçimi × 2 tekrar = 10.800 cevap
- Bozulma: tohumlu betik (Türkçe Q klavye) · 270 düzeltme denemesi
Soru: Yapay zekâya aceleyle, harfleri karıştırarak ya da ç, ş, ğ kullanmadan yazınca cevap kötüleşiyor mu? Kısa cevap: Türkçe karakter kullanmamak neredeyse hiçbir şey değiştirmedi (%71,1 yerine %70,1, tekrar farkının içinde). Ara sıra yapılan yazım hatası da küçük kaldı. Ama kelimelerin yarısında hata olunca doğru cevap oranı %71,1 seviyesinden %59,6 seviyesine indi: 11,5 puan.
Telefonda hızlı yazarken “asagidakilerden hangsi” gibi soruları ben de yazıyorum. Modelin bunları “anladığını” biliyoruz, cevap veriyor. Benim merak ettiğim, anlamış gibi görünürken doğru cevabı kaçırıp kaçırmadığı. Bunu tek tük örnekle değil, cevabı belli sorularla ve sayarak ölçmek istedim.
Nasıl ölçtüm
Doğruluğu ölçebilmek için cevabı belli sorular lazımdı. Türkiye’deki lise müfredatından derlenmiş, açık yayımlanan TurkishMMLU veri setinin test bölümünü kullandım: biyoloji, kimya, coğrafya, tarih, matematik, felsefe, fizik, din kültürü, Türk dili ve edebiyatı; dokuz dersten 100’er, toplam 900 beş şıklı soru. Sorular makine çevirisi değil, Türkçe yazılmış.
Her soruyu altı biçimde sordum. Bozmayı elle yapmadım, sabit tohumlu küçük bir betik yaptı; böylece aynı bozulmayı herkes yeniden üretebilir:
- Düzgün yazılmış: veri setindeki metin.
- Türkçe karaktersiz: ç→c, ş→s, ğ→g, ı→i, ö→o, ü→u (İ→I, â→a da).
- %10 / %25 / %50 kelimede hata: en az üç harfli kelimelerin bu oranında tek bir klavye hatası. Hatanın türü de gerçekçi: Türkçe Q klavyede komşu tuşa basmak, harf atlamak, iki harfin yerini değiştirmek, harfi iki kez basmak. %25 koşulunda toplam 19.181 hata vardı (komşu tuş: 7.620, atlanan harf: 4.728, yer değişimi: 3.867, çift harf: 2.966). Gerçekleşen oranlar %10,1, %25,2, %50,0.
- Karaktersiz + %25 hata: ikisi birlikte, telefondan aceleyle yazılmış gibi.
Sayılar, formüller ve şık harfleri bozulmadı; hata soru metnine ve şıkların metnine uygulandı. Sona eklediğim tek satırlık talimat her koşulda aynı ve düzgündü. Örneğin bir sorunun düzgün ve %50 hatalı hali modele tam olarak şöyle gitti:
Hangi seçenekte yer alan davranışların tamamı İslam ahlakının yerdiği davranışlardandır?

A) Haset, suizan, mahremiyet ihlali
B) Gıybet, gıpta, iftira
C) Hile, israf, hüsnüzan
D) Bencillik, tutumluluk, çekememezlik
E) Yalan, kibir, adalet

Yalnızca doğru şıkkın harfini yaz.
Hagni seçenekte yer aan davranışların tamamı İslam aahlakının yerdiiği davranışlardandır?

A) Hsaet, suizan, mahremiyet ihlali
B) Gıybet, gpıta, iftria
C) Hile, israf, hüsnüzan
D) Bencillik, tuutmluluk, çekeemezlik
E) Halan, kkibir, adaıet

Yalnızca doğru şıkkın harfini yaz.
Doğru cevap A. Model düzgün haline A, hatalı haline B cevabını verdi.
Model, masaüstündeki iki RTX 5090’da çalışan Qwen3.8-27B. Sıcaklık 0 (en olası cevap), düşünme modu kapalı, cevap sınırı 16 token. Her soru × biçim iki kez soruldu: hatalı biçimlerde iki ayrı rastgele hata dağılımıyla, düzgün ve karaktersizde aynı metinle iki kez. Toplam 10.800 cevap. Cevabın ilk harfi doğru şıkla karşılaştırıldı.
Bir not: veri setindeki metinler Unicode’un “ayrışık” biçiminde saklanmış (ü harfi u + iki nokta olarak). İlk denemede bu yüzden ü, ç, ş harfleri karaktersiz biçime çevrilmeden kaldı; bunu fark edip metinleri klavyenin ürettiği normal biçime çevirdim ve ölçümü baştan yaptım. Yarım kalan ilk deneme sonuçlara karışmadı.
Sonuç: az hata zararsız, çok hata pahalı
Düzgün yazılmış sorularda model %71,1 doğru cevap verdi. Türkçe karakterleri kaldırınca %70,1 (–1,0 puan); bu farkın %95 güven aralığı –2,9 ile +0,8 puan arasında, yani sıfırı içine alıyor. %10 hatada %69,7 (–1,4 puan, aralık yine sıfıra değiyor). %25 hatada %67,3 (–3,8 puan) ile ilk net düşüş geliyor, %50 hatada %59,6 (–11,5 puan).
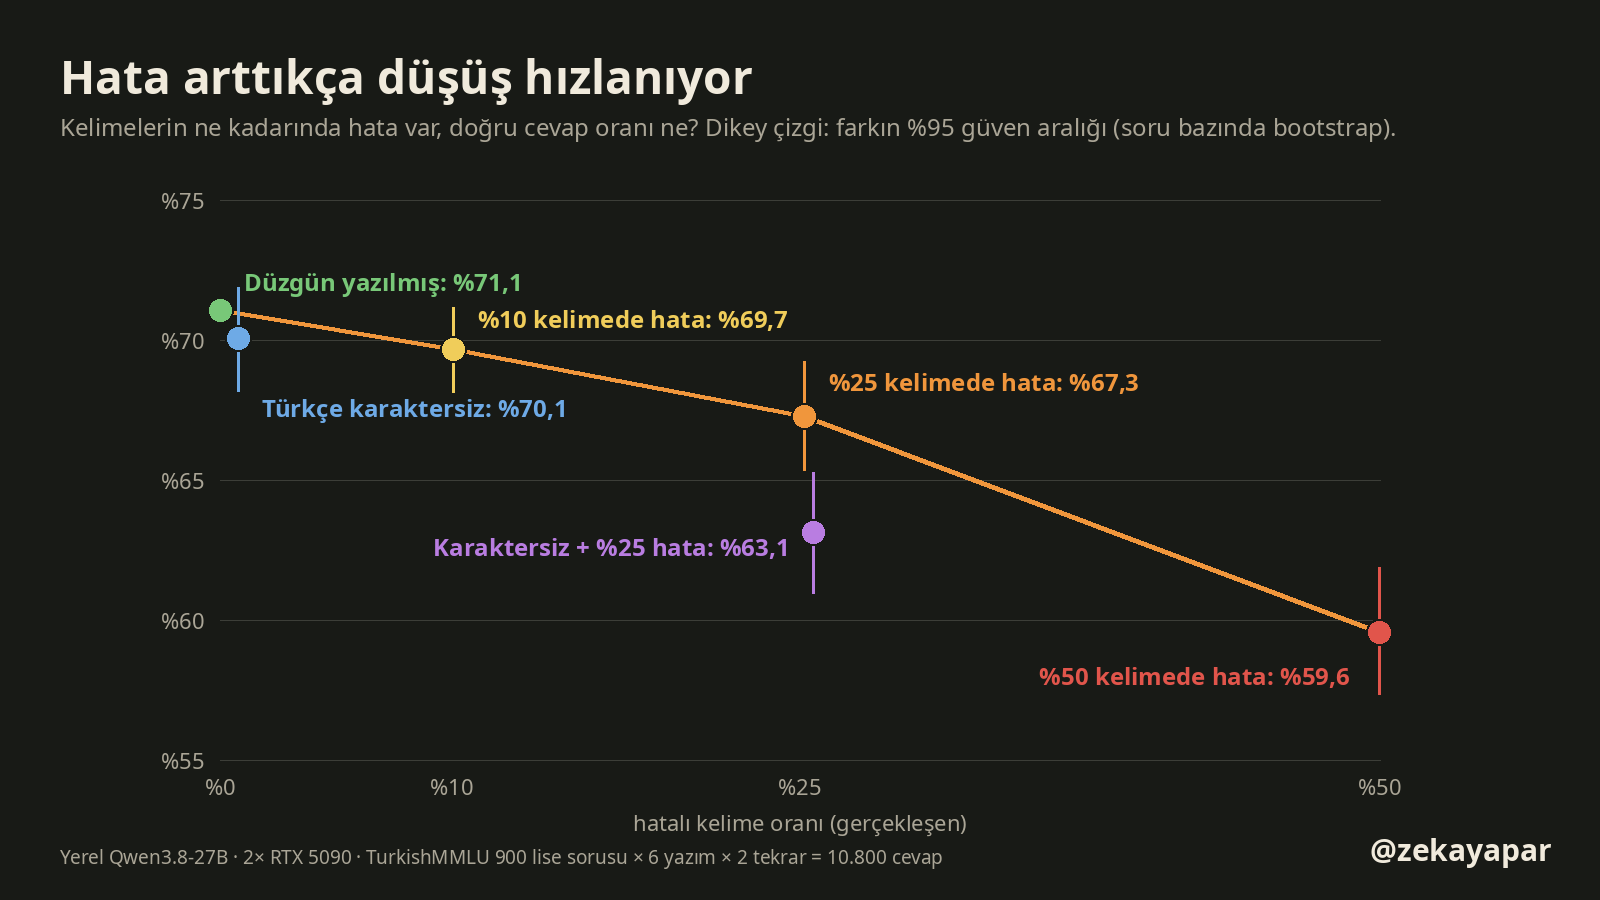
Düşüş düz bir çizgi değil. İlk %10 neredeyse bedava, %25 ile %50 arası en pahalı bölüm: hata oranı iki katına çıkınca kayıp üç katına çıkıyor (3,8 puandan 11,5 puana). Karaktersiz + %25 hata ise %63,1 ile –7,9 puan; ikisinin ayrı ayrı kaybının toplamından (4,8 puan) daha kötü. Muhtemel açıklama: tek başına zararsız görünen karaktersiz yazım, hatalarla birleşince kelimeyi tanımayı zorlaştırıyor; “cevrf”ten “çevre”ye gitmek, “çevrf”ten gitmekten zor. Bunu ayrıca ölçmedim.
Hangi sorular kayboldu?
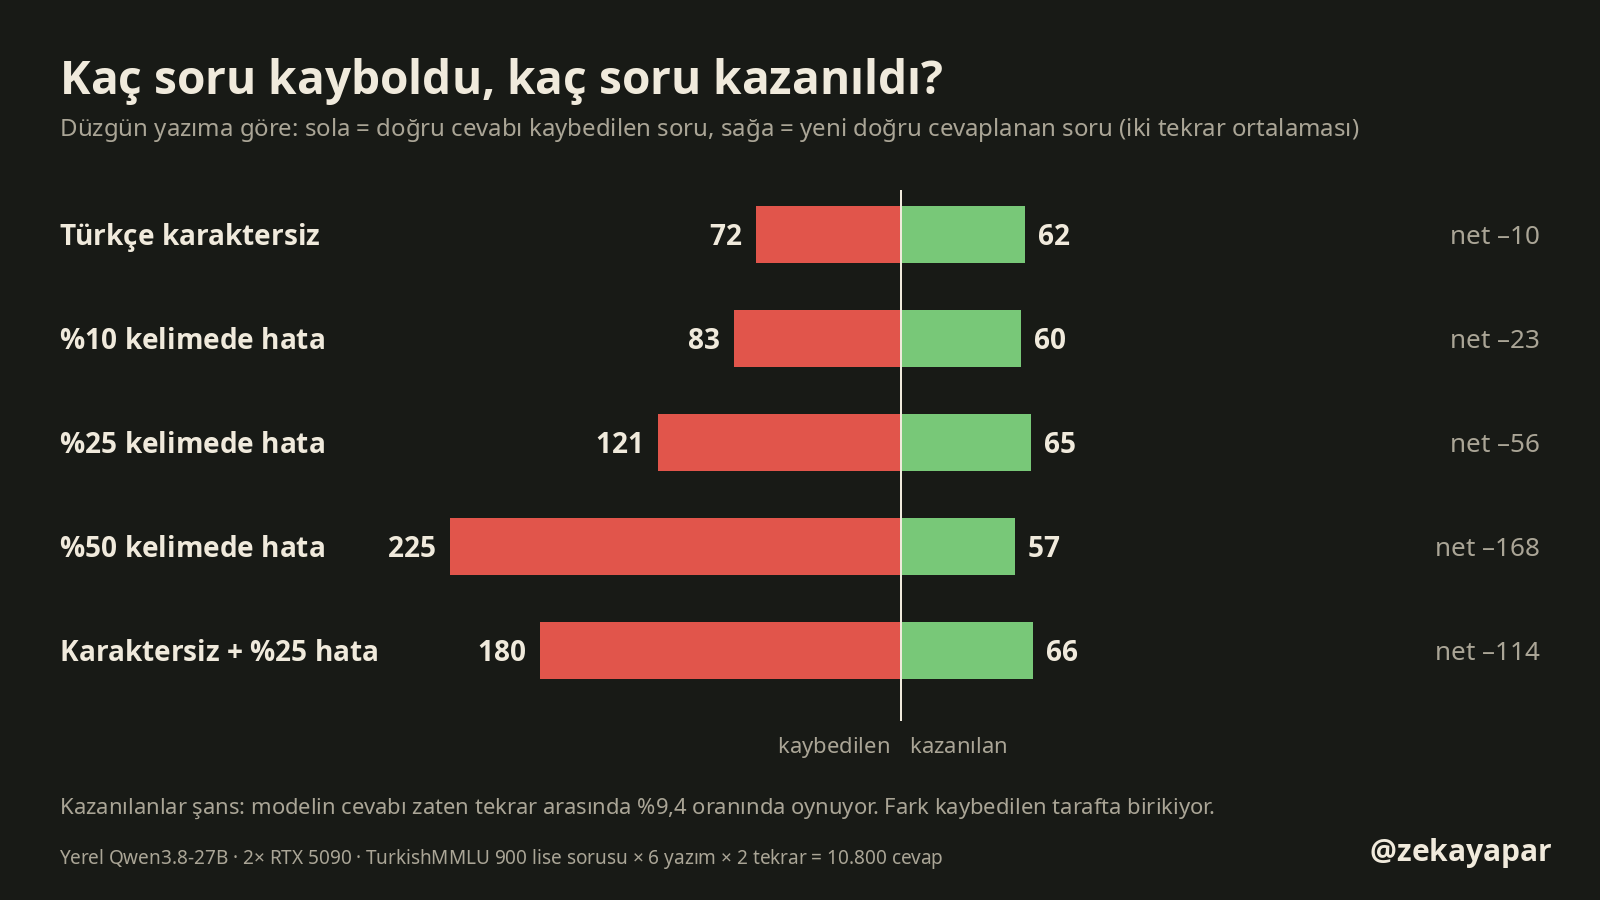
Ortalama fark, altındaki hareketi gizliyor. %50 hatada 225 soru düzgün haline göre daha kötü cevaplandı, 57 soru ise daha iyi. Kazanılan soruların sayısı bütün biçimlerde benzer (57–66); bu modelin zaten sınırda olduğu sorulardaki oynama. Hata arttıkça büyüyen taraf kaybedilenler.
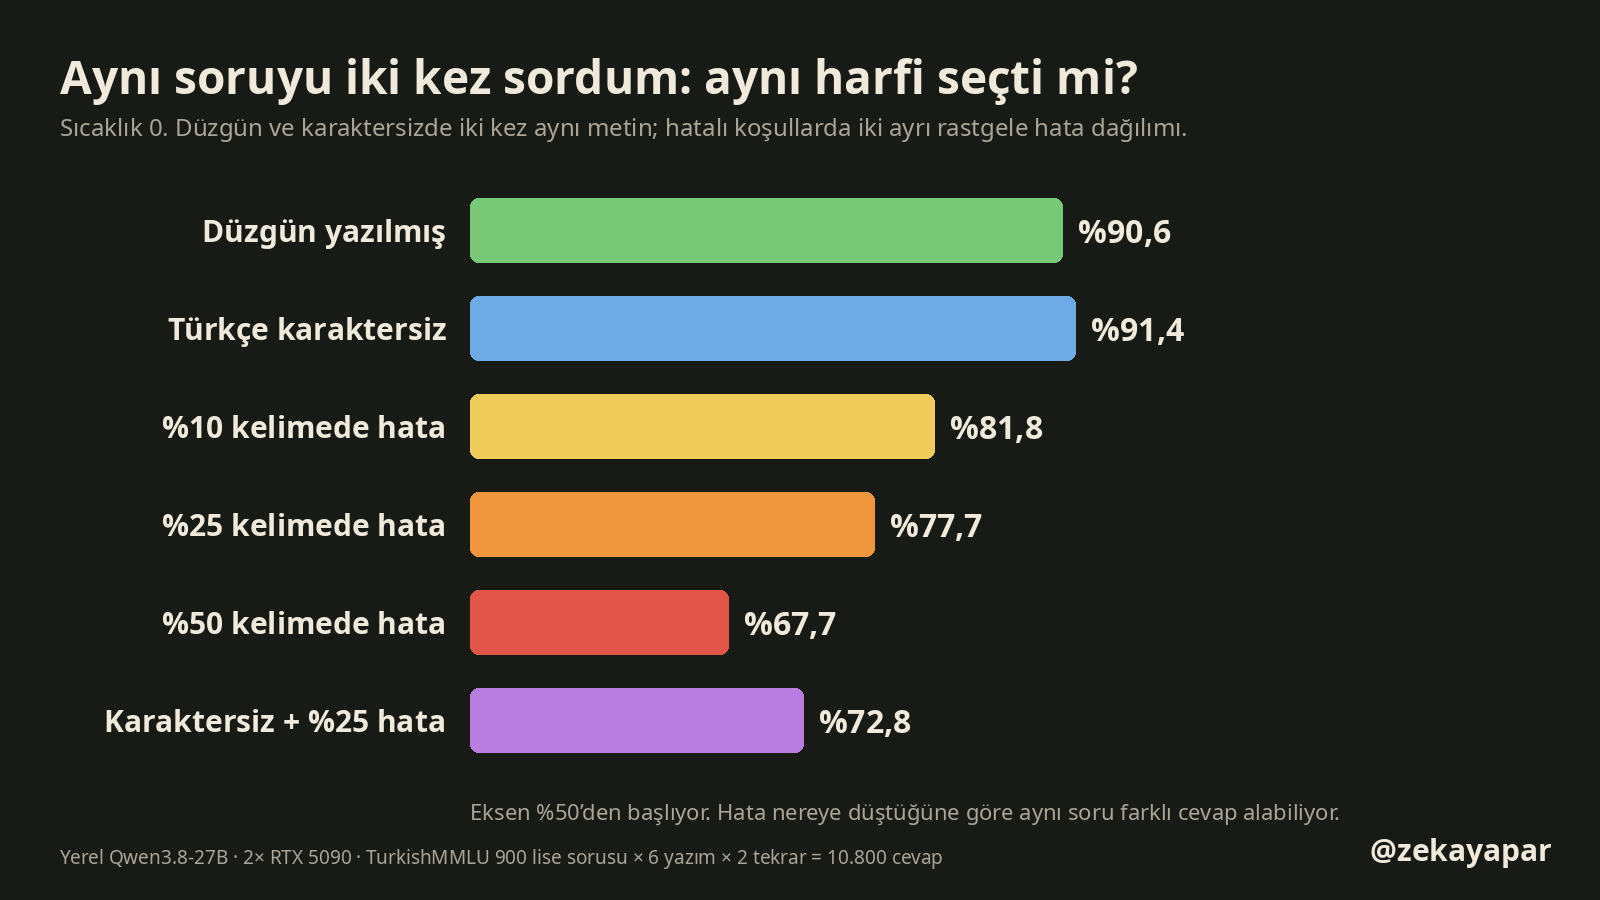
Bu oynamayı ayrıca ölçtüm: sıcaklık 0’da aynı düzgün metni iki kez sorduğumda bile farklı harf gelen cevapların oranı %9,4 oldu. Sunucu aynı anda birkaç isteği birlikte işlediği için hesaplar birebir aynı sırada yapılmıyor ve sınırdaki sorularda cevap değişebiliyor. Hatalı biçimlerde ise iki tekrar iki ayrı hata dağılımı demek: %50 hatada aynı soru iki seferde yalnız %67,7 oranında aynı cevabı aldı. Yani hatanın hangi kelimeye düştüğü, cevabı belirleyebiliyor.
Kaybedilen sorulardan iki örnek. İkisi de düzgün halde iki seferde de doğru cevaplandı, %50 hatalı iki ayrı halinde iki seferde de yanlış:
Physics-003, doğru cevap C. Düzgün hali (cevap C), hatalı hal 1 (cevap D) ve hatalı hal 2 (cevap D):
Işık şiddeti ile ilgili aşağıdaki bilgilerden hangisi yanlıştır?

A) Fotometre ile ölçülür.
B) Işık şiddetinin sembolü “I” dir.
C) Türetilmiş bir büyüklüktür.
D) Birimi “Candela” dır.
E) Birim sembolü “cd”dir.

Yalnızca doğru şıkkın harfini yaz.
Işkk şiddeti ilee ilgşli aşağıdak bilgilerden hangisş aynlıştır?

A) Fohometre ilr ölçülür.
B) Iık şiddetinin sembolü “I” dir.
C) Türetilmiş bir büuüklüktür.
D) Birimü “Candela” dlr.
E) Birm semholü “cd”idr.

Yalnızca doğru şıkkın harfini yaz.
Işık şiddeti ilw ilgüli zşağıdaki bligilerden hangisi yanlıştır?

A) Fıtometre ile ölçülür.
B) Işkı şiddetijin sembolü “I” dir.
C) Türetilmiş bir büyüklüktür.
D) Birimii “Candel” dr.
E) BBirim sembolü “cd”rir.

Yalnızca doğru şıkkın harfini yaz.
Biology-061, doğru cevap B. Düzgün hali (cevap B), hatalı hal 1 (cevap C) ve hatalı hal 2 (cevap E):
ATP molekülü ile ilgili aşağıdaki aşıklamalardan hangisi doğrudur?

A) Pirimidin bazı içerir.
B) Monosakkarit içerir.
C) Aminoasit bulundurur.
D) Peptit bağı bulundurur.
E) Sentezi ekzergonik bir olaydır.

Yalnızca doğru şıkkın harfini yaz.
AYP moleküpü ioe ilili aşağıdaki aşıklamakardan hangisi dşğrudur?

A) Pirimidpn bqzı ilerir.
B) Mobosakkarit ieçrir.
C) Aminoasit bulundurur.
D) Peptt bağı bulundruur.
E) Sentezi ekzergoik bir olaydı.

Yalnızca doğru şıkkın harfini yaz.
AP olekülü ile ilgili aşağıdaki aşıklamalardan angisi doğrudue?

A) Pirimidinn azı içerir.
B) Monosakkarit ikerir.
C) Aminasit bulundurur.
D) Pepyit bağı bulunurur.
E) Sentezi ekzdrgonik bir ılaydır.

Yalnızca doğru şıkkın harfini yaz.
İkinci örnekte “içerir” kelimesi şıklarda “ilerir”, “ieçrir”, “ikerir” olmuş; şıkları ayırt eden asıl kelimeler bozulunca model başka şıkka kaydı. Kaybın büyük kısmı bu tür, cevabı taşıyan kelimeye isabet eden hatalardan geliyor gibi görünüyor; bunu ayrıca ölçmedim.
Ders ders
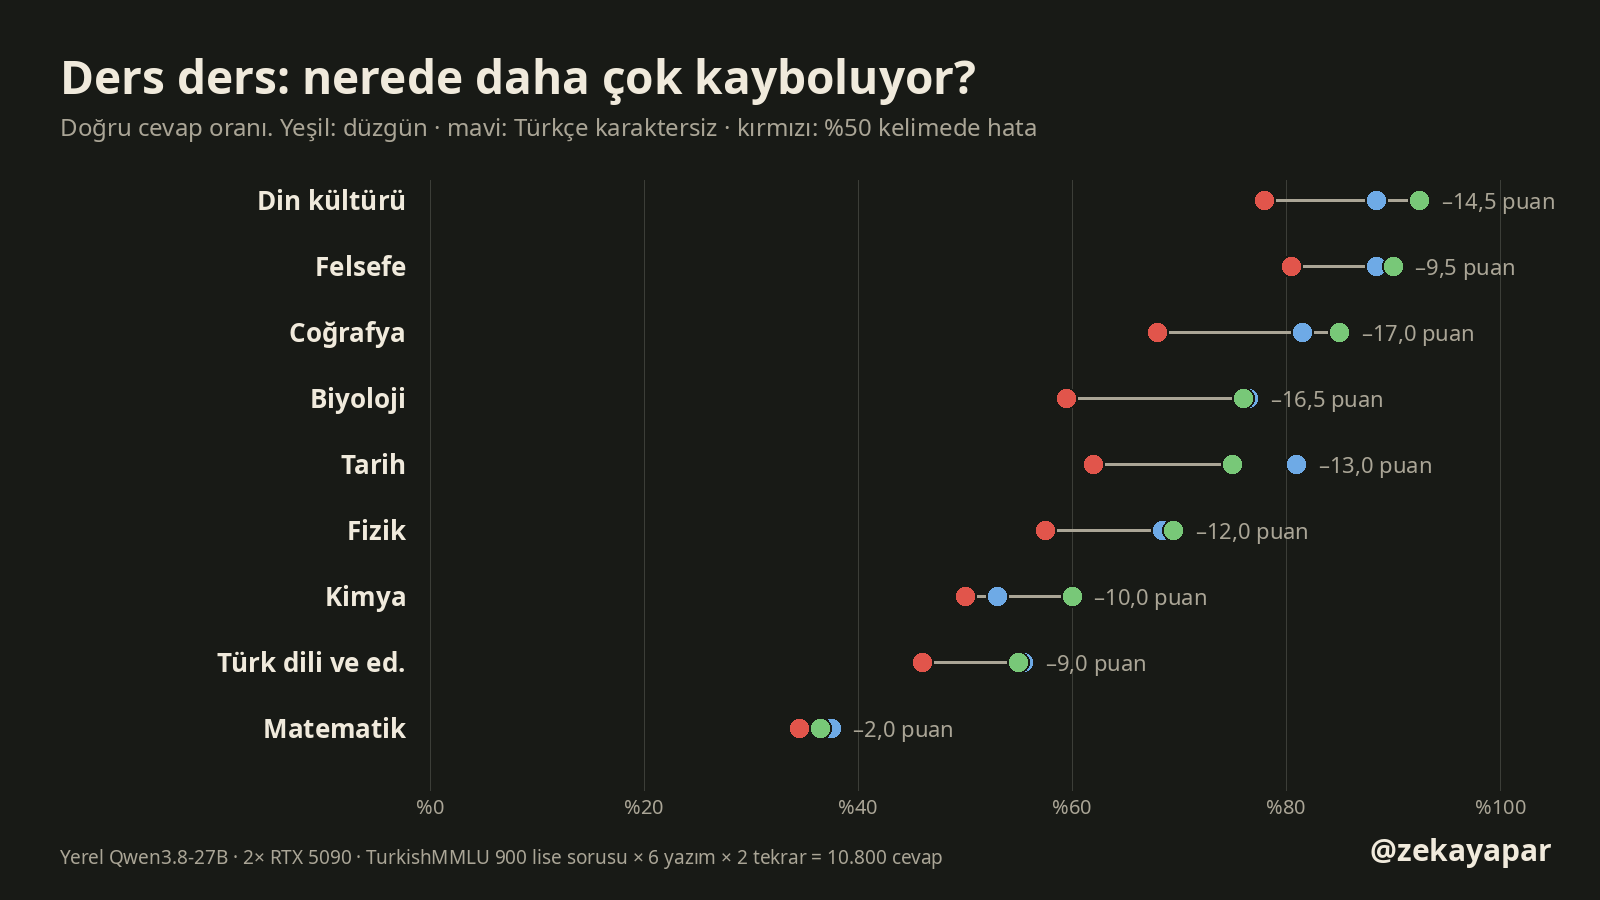
%50 hatada en çok kaybeden dersler coğrafya (17,0 puan), biyoloji (16,5) ve din kültürü (14,5). Bunlar sözel ağırlıklı, cevabın kelimelerde olduğu dersler. Matematik neredeyse hiç kaybetmedi (2,0 puan), ama orada model düzgün soruda da yalnız %36,5 doğru veriyor: sayılar ve formüller bozulmadığı için hatanın etkisi az, zaten düşünmeden harf seçtirince model zorlanıyor. Her ders 100 soru; ders bazındaki farklar tek tek ele alınınca gürültülü, sıralamaya fazla anlam yüklemiyorum.
Hatalı yazmak faturayı da artırıyor
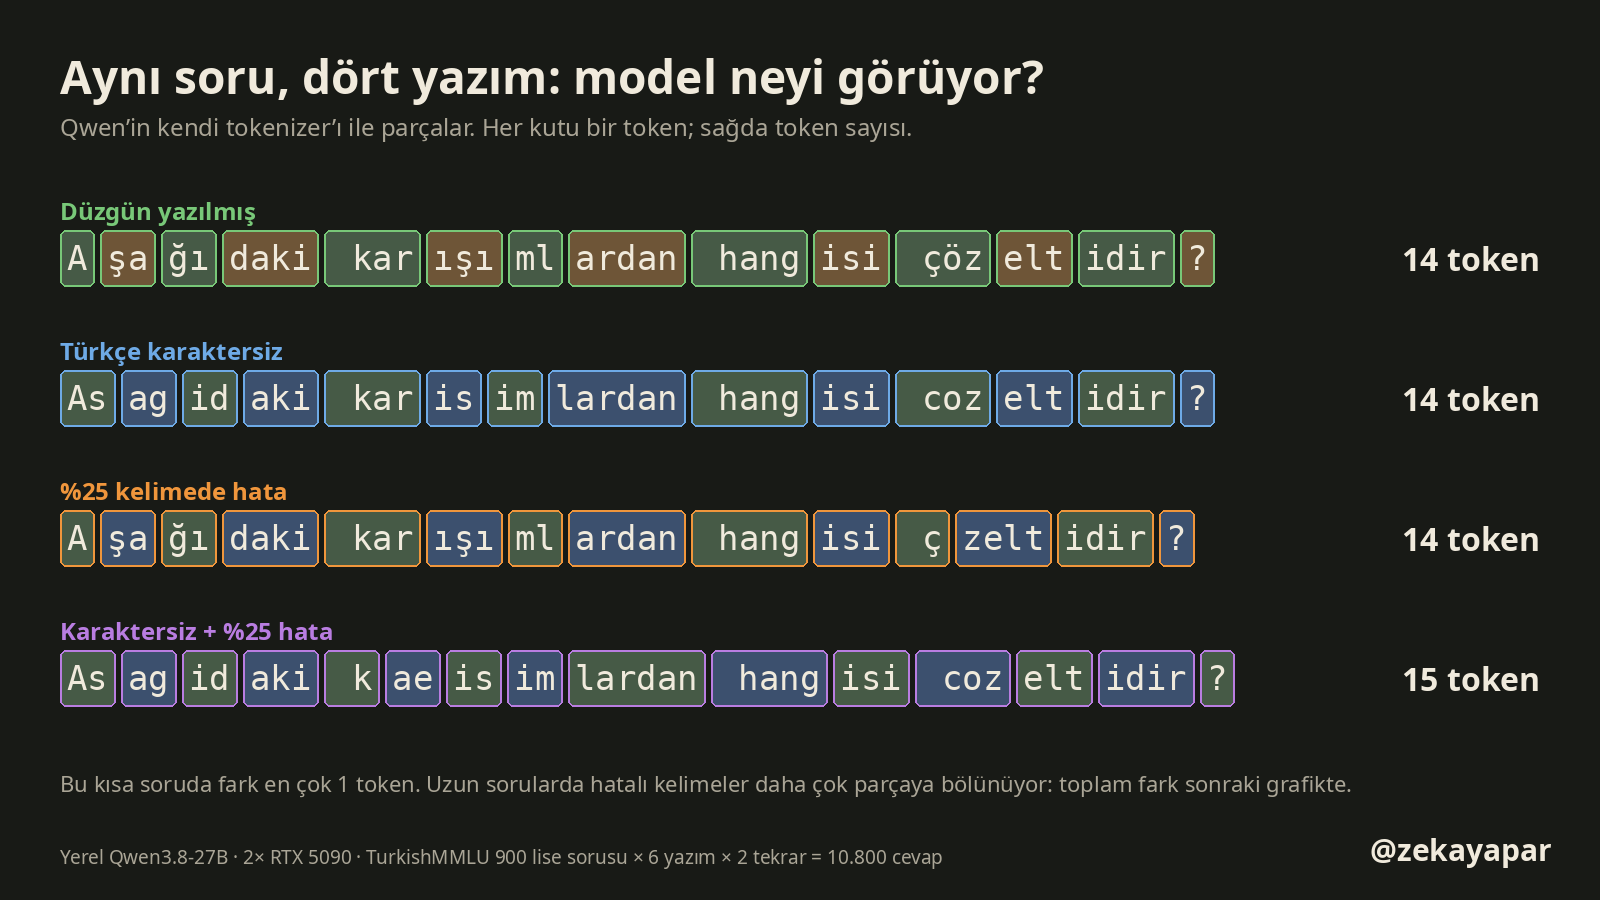
Model metni kelime kelime değil, token denen parçalarla okuyor. Bildiği kelime tek ya da iki parçaya sığıyor; “kaeisimlardan” gibi bir kelimeyi tanıdık parçalara ayıramıyor ve daha çok parçaya bölüyor. Kısa bir soruda fark bir iki token, ama hepsini toplayınca görünüyor:
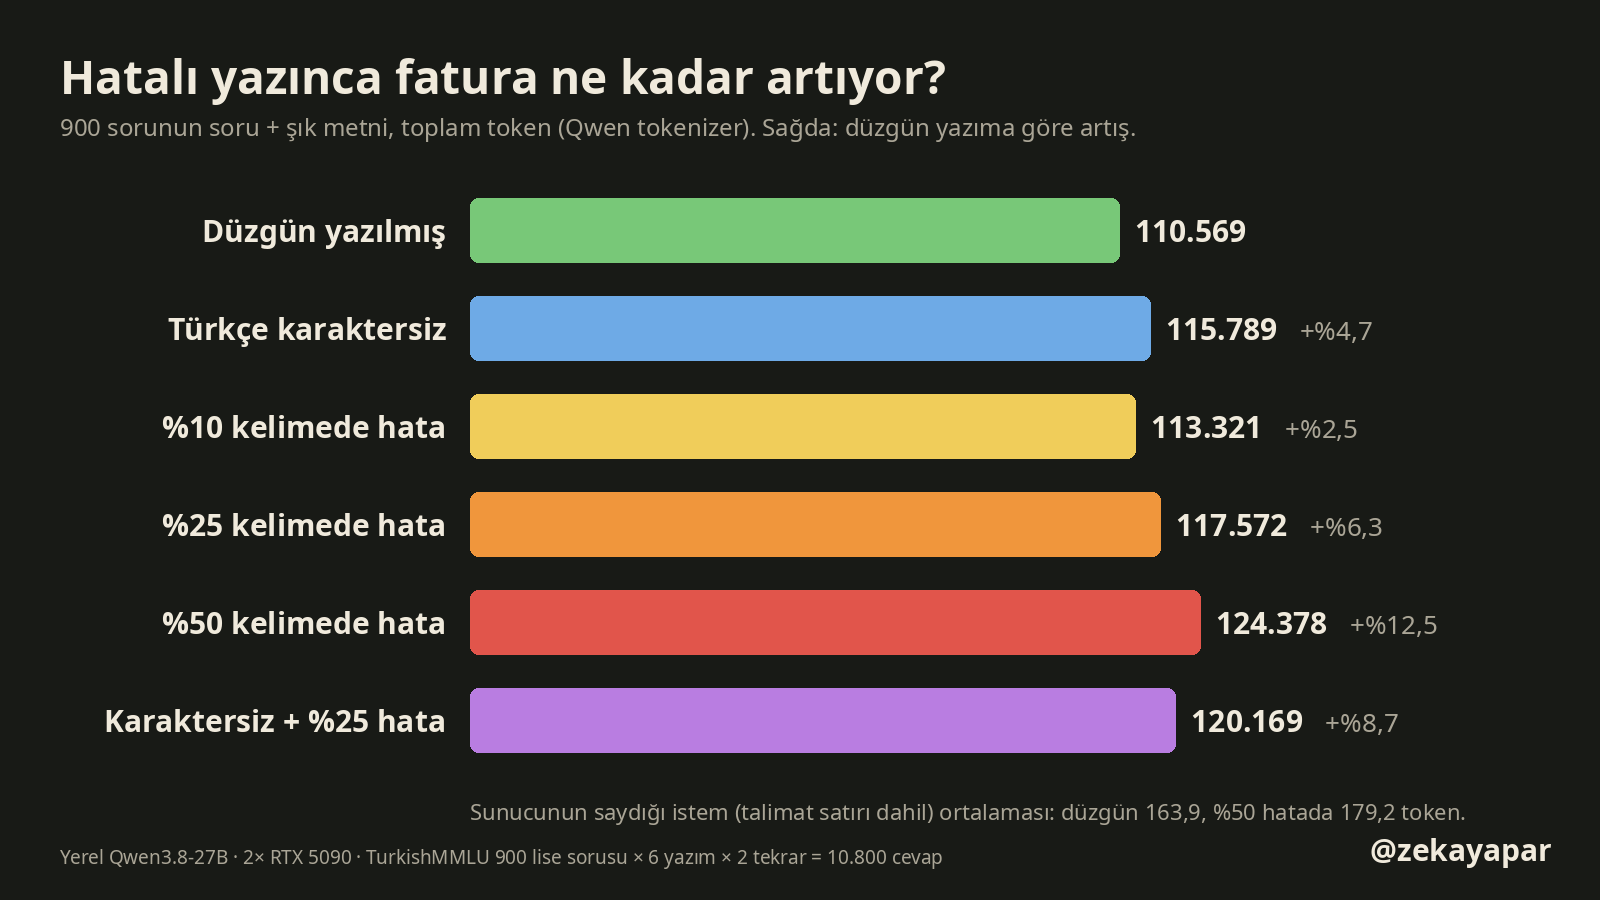
900 sorunun soru ve şık metni düzgün yazımda 110.569 token. Türkçe karaktersiz yazınca %4,7 artıyor; Qwen’in tokenizer’ı Türkçe karakterli kelimeleri, karaktersiz hallerinden daha iyi tanıyor. %50 hatada artış %12,5. Sunucunun saydığı istem uzunluğu (talimat satırı ve sohbet şablonu dahil) ortalama 163,9 yerine 179,2 token. Kısa sorularda bu küçük para; uzun bir metni karaktersiz yapıştırmak ise aynı oranda daha pahalı.
Kestirme: önce düzelttirsem?
Akla gelen çözüm, soruyu önce modele düzelttirmek. Bunu da denedim: dokuz dersten 10’ar, 90 sorunun karaktersiz, %25 hatalı ve ikisi birlikte hallerini aynı modele şu talimatla verdim:
Aşağıdaki metindeki yazım hatalarını ve eksik Türkçe karakterleri düzelt. Yalnızca düzeltilmiş metni yaz, başka bir şey ekleme.

{bozuk soru}
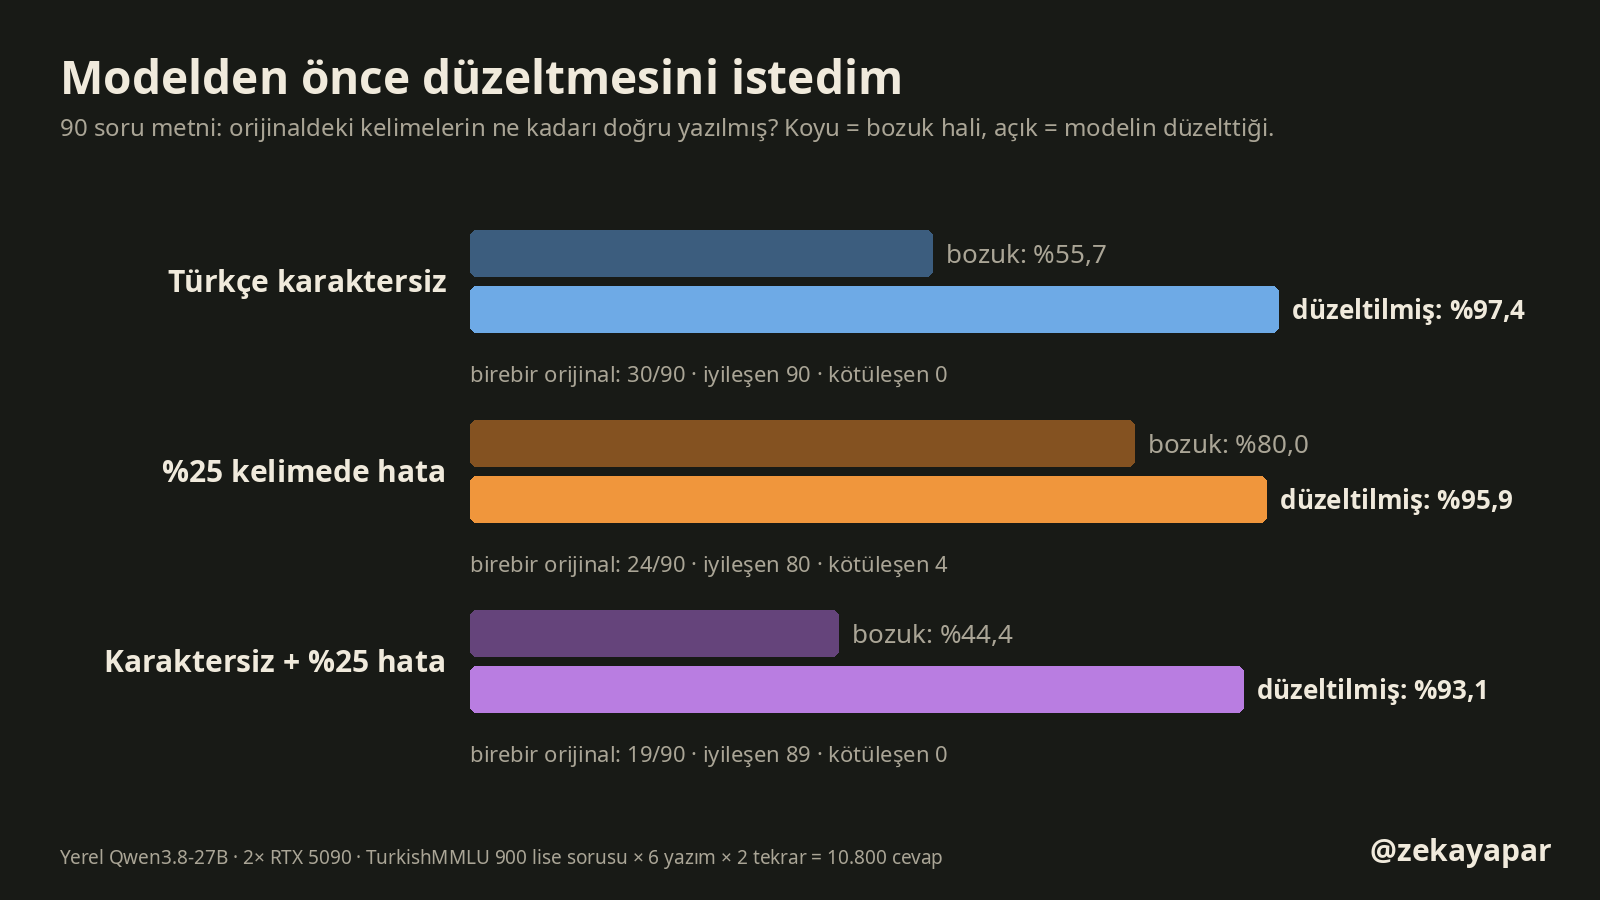
Düzeltme işe yarıyor: karaktersiz metinde orijinal kelimelerin doğru yazılmış oranı %55,7 iken düzeltme sonrası %97,4; ikisi birlikte bozulmuş metinde %44,4 seviyesinden %93,1 seviyesine çıktı. Ama birebir orijinal metne dönen soru sayısı az: 30/90, 24/90 ve 19/90. %25 hatalı metinlerin 4’ünde düzeltme metni daha da uzaklaştırdı.
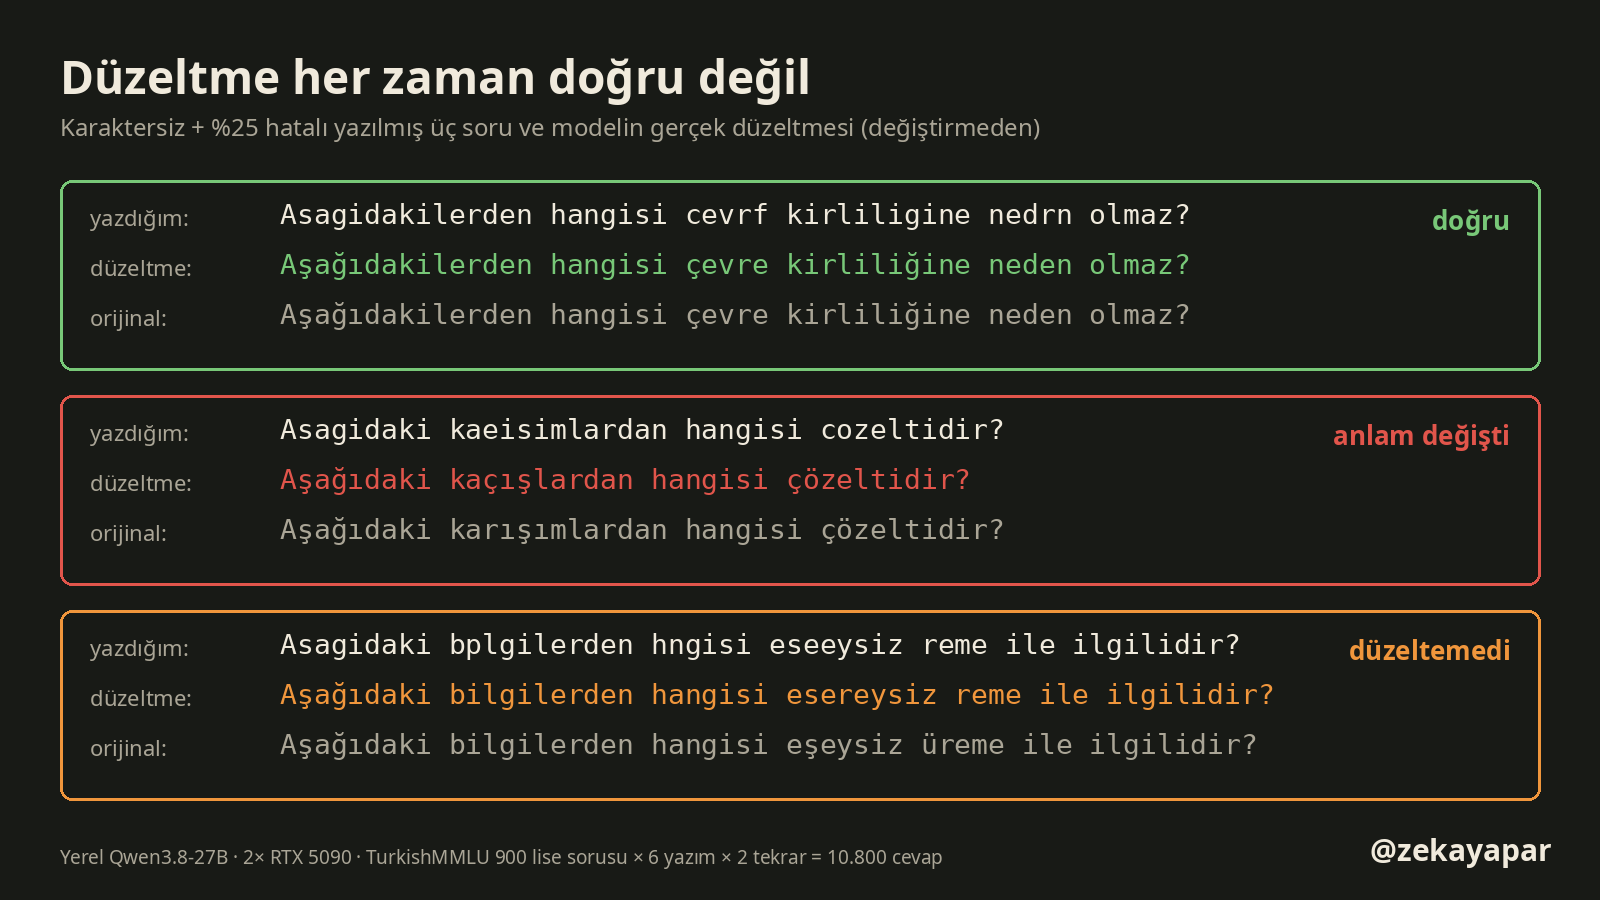
Asıl tehlikeli olan ortadaki örnek: “Asagidaki kaeisimlardan hangisi cozeltidir?” metnini model “Aşağıdaki kaçışlardan hangisi çözeltidir?” diye düzeltti. Akıcı, kusursuz Türkçe; ama “karışım” “kaçış” olmuş ve soru artık anlamsız. Düzeltilmiş metin düzgün göründüğü için bu hatayı fark etmek, bozuk metindekinden daha zor. Düzeltilmiş sorularla doğruluğun geri gelip gelmediğini bu turda ölçmedim; bu bir sonraki deneme.
Günlük kullanımda ne demek?
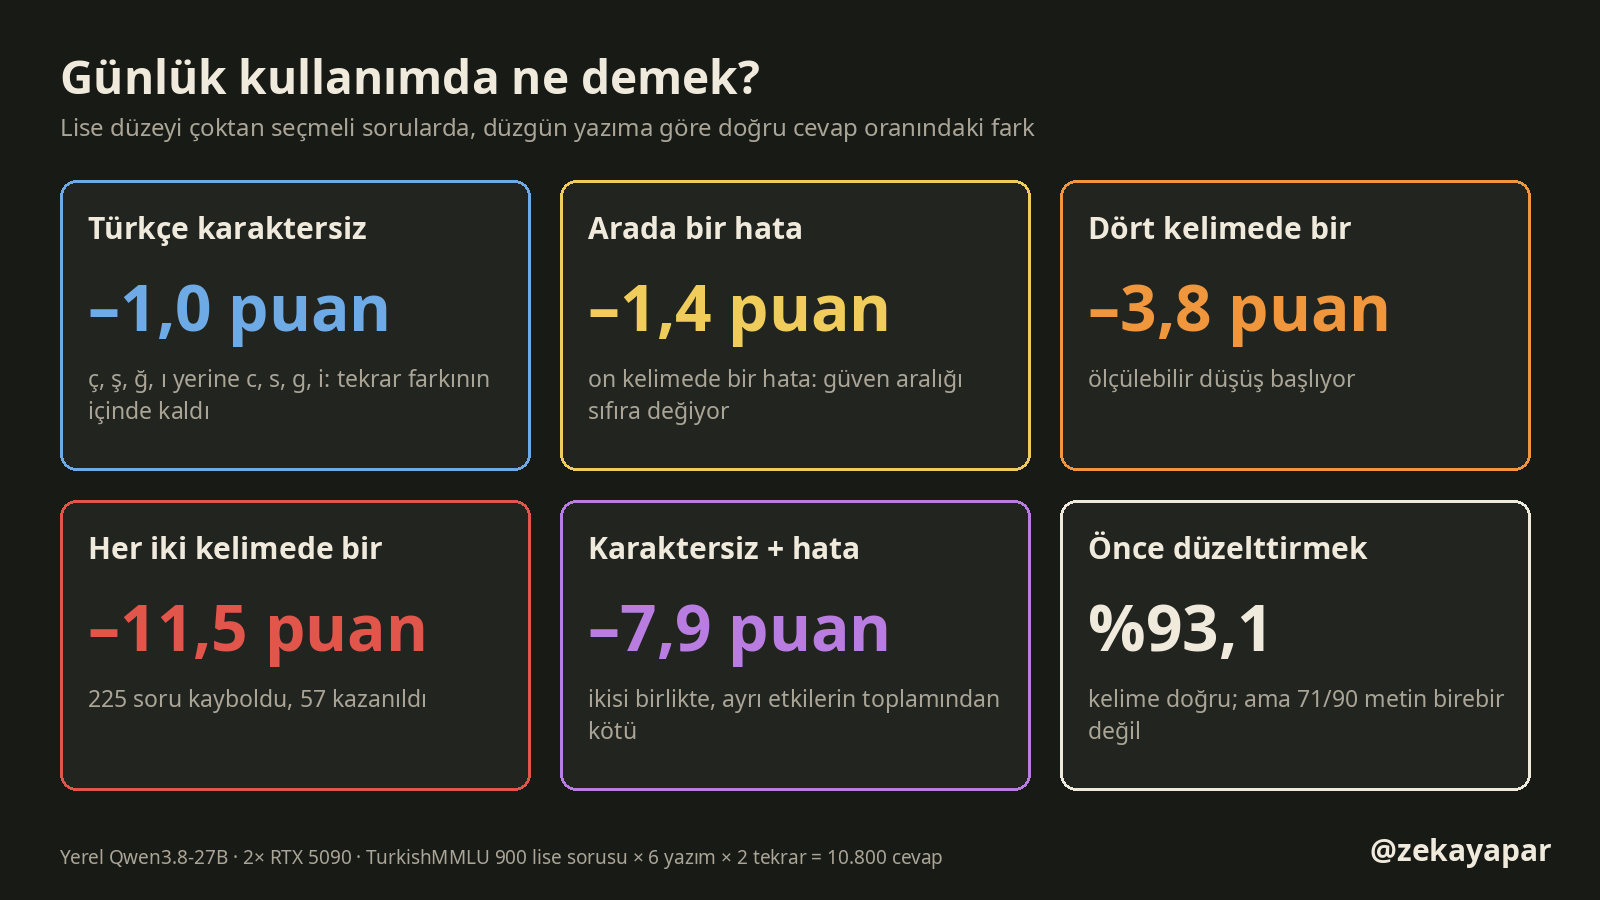
Telefonda ç, ş, ğ’siz yazmanın ya da ara sıra harf kaçırmanın etkisi bu ölçümde tekrar farkı kadar küçüktü; bunun için soruyu yeniden yazmaya gerek yok. Kelimelerin dörtte biri ya da yarısı bozuk, aceleyle yazılmış bir soruda ise doğru cevabı kaçırma ihtimali ölçülebilir şekilde artıyor ve cevap aynı soruya bir sonraki seferde değişebiliyor. Özellikle şıkları ya da önemli kavramları (ilaç adı, kişi adı, terim) yazarken dikkat etmek, bütün metni temizlemekten daha çok iş görüyor gibi; bunu ayrıca test etmedim, bir seçenek olarak not ediyorum.
Benim için sonuç
Karaktersiz yazdığım hızlı sorular için içim rahat. Önemli bir soruyu sorarken ise yazdıktan sonra bir kez gözden geçirmek, modelden düzeltmesini istemekten daha güvenli: model düzeltirken anlamı değiştirebiliyor ve bunu çok inandırıcı bir dille yapıyor. Bir de şunu gördüm: aynı soru iki kez sorulunca bile her on cevaptan biri değişebiliyor. Sınırdaki bir soruda tek bir cevaba güvenmek yerine soruyu biraz farklı sorup iki cevabı karşılaştırmak işe yarayabilir.
Sınırlar
- Tek model (Qwen3.8-27B), düşünme modu kapalı ve yalnız şık harfi istendi. Düşünerek cevap veren modellerde ya da açık uçlu sorularda etki farklı olabilir.
- 160 cevap (%1,5) 16 tokenlik sınıra takıldı ya da harf içermedi: model “yalnız harfi yaz” talimatına rağmen çözüm yazmaya başladı (bunların 85’i matematik, 51’i kimya). Bunları yanlış saydım; her biçimde benzer sayıda (17–35).
- Hatalar gerçek kullanıcı hatalarından değil, kurallı rastgele bir betikten geliyor. Gerçek insanlar belli kelimelerde daha çok hata yapar; dağılım farklı olabilir.
- Lise sınav soruları cevabı belli olduğu için seçildi; günlük sohbet sorularını temsil etmiyor.
- Aynı metinde bile cevapların %9 kadarı değişiyor; bir iki puanlık farkları tek başına anlamlı saymıyorum, güven aralığı veriyorum.
Tam tablo ve yöntem
| Biçim | Doğru | Tekrar 1 / 2 | Fark (puan) | %95 aralık | Kaybedilen / kazanılan soru | İki tekrar aynı harf | Hatalı kelime | Soru+şık token | İstem token (ort.) | Harfsiz cevap |
|---|---|---|---|---|---|---|---|---|---|---|
| Düzgün yazılmış | %71,1 | %71,8 / %70,3 | 0,0 | 0,0 … 0,0 | – / – | %90,6 | %0,0 | 110.569 | 163,9 | 35 |
| Türkçe karaktersiz | %70,1 | %70,3 / %69,8 | –1,0 | –2,9 … +0,8 | 72 / 62 | %91,4 | %0,0 | 115.789 | 169,7 | 20 |
| %10 kelimede hata | %69,7 | %69,8 / %69,6 | –1,4 | –2,9 … +0,1 | 83 / 60 | %81,8 | %10,1 | 113.321 | 166,9 | 28 |
| %25 kelimede hata | %67,3 | %68,0 / %66,6 | –3,8 | –5,7 … –1,8 | 121 / 65 | %77,7 | %25,2 | 117.572 | 171,6 | 31 |
| %50 kelimede hata | %59,6 | %61,2 / %57,9 | –11,5 | –13,7 … –9,2 | 225 / 57 | %67,7 | %50,0 | 124.378 | 179,2 | 29 |
| Karaktersiz + %25 hata | %63,1 | %63,1 / %63,1 | –7,9 | –10,1 … –5,8 | 180 / 66 | %72,8 | %24,8 | 120.169 | 174,4 | 17 |
Fark: düzgün yazıma göre, iki tekrarın ortalaması. Güven aralığı: soru düzeyinde (iki tekrar ortalaması) eşli fark, 2.000 bootstrap örneği. Kaybedilen/kazanılan: soru başına iki tekrar ortalaması düzgünden düşük/yüksek olan soru sayısı. Cevap ayrıştırma: cevabın başındaki harf, yoksa “X)” kalıbı, yoksa tek başına duran ilk A–E harfi. Düzeltme deneyinde “doğru kelime oranı”: orijinaldeki kelimelerin (küçük harfe çevrilmiş) sırayla eşleşen kısmı (difflib).
| Düzeltme | Soru | Doğru kelime (bozuk) | Doğru kelime (düzeltilmiş) | Birebir orijinal | İyileşen / kötüleşen |
|---|---|---|---|---|---|
| Türkçe karaktersiz | 90 | %55,7 | %97,4 | 30 | 90 / 0 |
| %25 kelimede hata | 90 | %80,0 | %95,9 | 24 | 80 / 4 |
| Karaktersiz + %25 hata | 90 | %44,4 | %93,1 | 19 | 89 / 0 |
Kaynaklar ve sürümler: Qwen3.8-27B NVFP4 (nvidia, Hugging Face revizyonu 482ca0f3832238542f8f5295dde86b5f22711d80) · vLLM 0.30.0 · TP2, 2× RTX 5090 (450 W sınırı) · düşünme kapalı (sunucu varsayılanı) · istek: temperature 0, seed 1, max_tokens 16 (düzeltme deneyinde 1.024), 6 eşzamanlı; ölçüm başında sunucuda başka istek yoktu (/metrics) · TurkishMMLU (Yüksel vd., ACL 2024 SIGTURK; AYueksel/TurkishMMLU, revizyon fcbe5bb19af2714186fdd5752671e0748efa0024, test bölümü 9 JSON dosyası, birleşik SHA256 66187e57c177eb15f23446de5994edabe49c61b2d5b706ad62a7456e6d9abec5; veri setinde lisans belirtilmemiş, bu yüzden soruların tamamını yeniden yayımlamıyorum, yalnız örnekler alıntılandı) · metinler Unicode NFC’ye çevrildi · tokenizer sayımı: Qwen3.8 tokenizer.json, tokenizers 0.23.3.
İndir: betikler, bozulma tohumları ve 10.800 cevabın model çıktısı (ZIP) · özet (JSON) · istek başına sonuçlar (CSV) · noise.py (bozulma betiği). Betikler soru metinlerini veri setinden yeniden kurar; aynı tohumlarla aynı bozuk soruları üretir.