 zekayapar
Belgeyi okutmak mı, modeli eğitmek mi? Bağlam, RAG ve ince ayar farkı
PDF yüklemek modeli eğitmek mi? Bağlama belge koymak, arşivde arama yaptırmak ve ince ayar arasındaki farkı somut kullanım örnekleriyle ayırıyorum.
Bu yazıda incelenenler
- Anthropic bağlam penceresi belgeleri
- Hugging Face Transformers RAG · PEFT / LoRA
Yöntem ve sınır
- Birincil teknik kaynaklara dayanan rehber
- Yeni eğitim veya model performans ölçümü yok
Bir PDF’yi sohbete yükleyince model onu öğrenmiş mi oluyor? Genellikle hayır: ürüne göre dosyanın tamamı, seçilen bölümleri veya aramayla bulunan parçaları cevap hazırlanırken modele sunulabilir. Belge arşivinde arama yaptırmak ve modeli örneklerle yeniden eğitmek ise başka işler. Kendi belgeleriyle çalışan bir yardımcı kurmak isteyen biri için ilk karar, model seçmekten önce bu ayrımı yapmak.
Bu yazı bir model yarışı değil. Bağlam penceresi, belge arama ve ince ayar belgelerini okuyup aynı ihtiyaca nerede farklı çözümler verdiklerini ayırıyorum. Burada yeni bir eğitim veya başarı testi yapmadım; aşağıdaki kullanım örnekleri de gerçek model cevapları değil, yöntemi açıklayan temsili senaryolar.
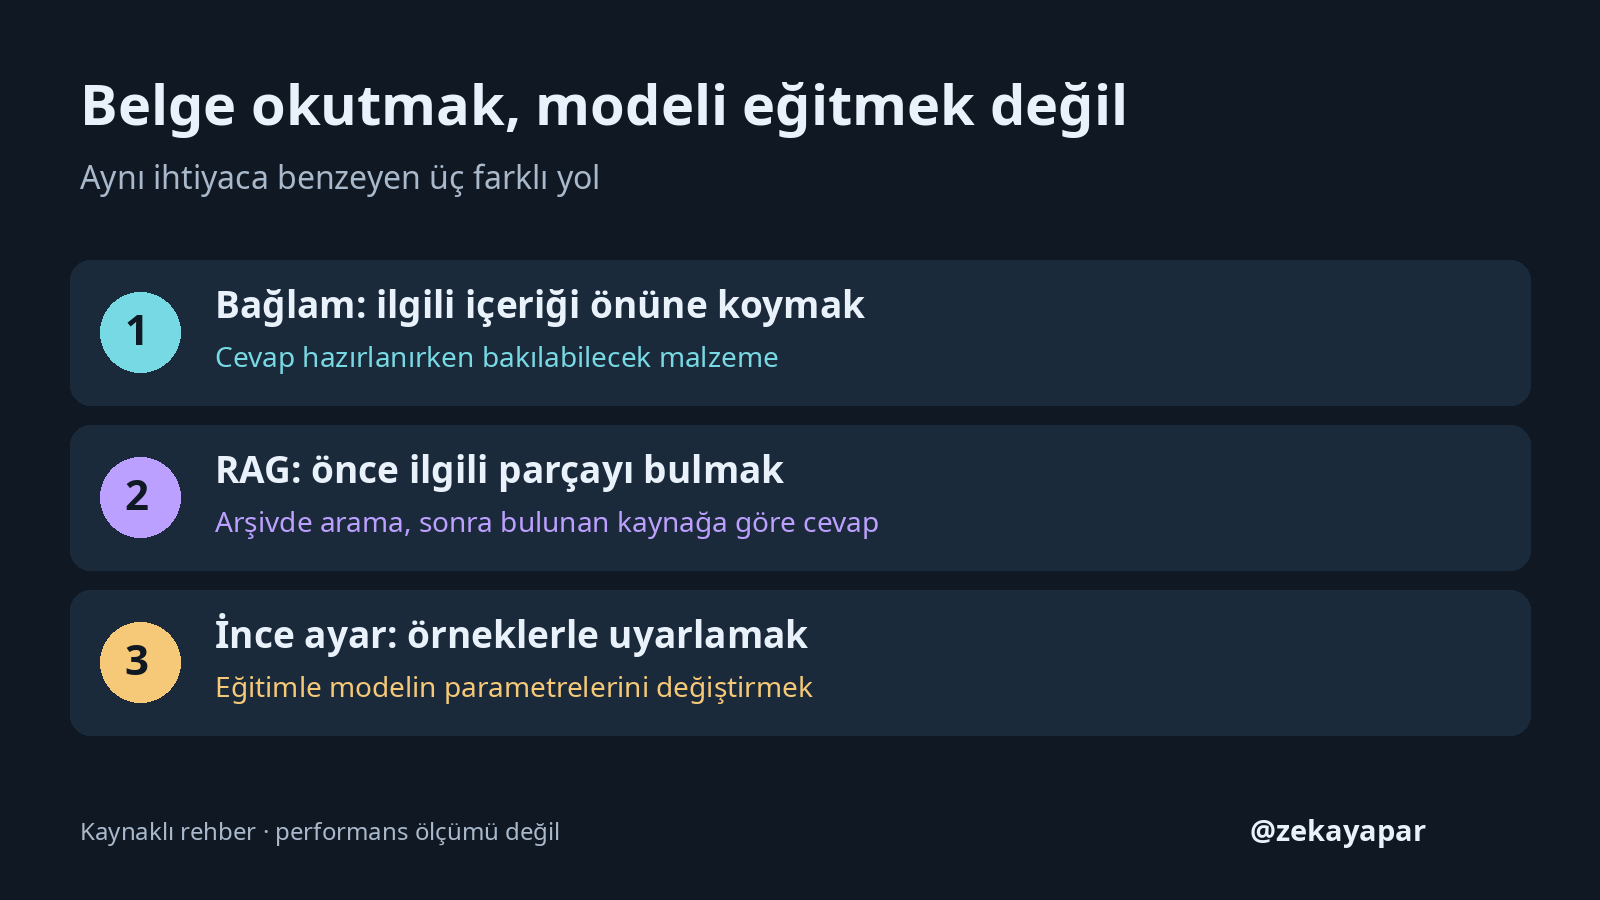
Önce soruyu değiştirelim: Bilgiyi mi, davranışı mı değiştirmek istiyorum?
“Model benim belgelerimi öğrensin” cümlesi iki ayrı beklentiyi bir araya getiriyor. İlki, bir sorunun cevabını doğru belgeden bulması: örneğin güncel iade şartını okuyup ilgili maddeyi göstermesi. İkincisi, işi belirli bir biçimde yapması: dağınık bir notu her defasında aynı başlıklarla düzenlemesi veya bir metni belirli kategorilere ayırması.
İlkinde değişen şey çoğunlukla başvurulacak bilgi. İkincisinde ise tekrar eden bir görevdeki davranış. Başlangıç için kullandığım karar ayrımı bu; kesin bir sınır değil. Aynı uygulama, belgelerden bilgi bulurken ayrıca örneklerle uyarlanmış bir model de kullanabilir.
| İhtiyaç | Önce denenebilecek yol | Kontrol edilecek şey |
|---|---|---|
| Tek bir sözleşmedeki maddeyi bulmak | İlgili belgeyi soruyla birlikte vermek | Cevabın işaret ettiği bölüm gerçekten var mı? |
| Sık güncellenen geniş bir arşive soru sormak | Belge arama ve bulunan parçaları modele verme | Doğru sürüm ve doğru parça bulundu mu? |
| Aynı tür girdilerde tutarlı bir iş yapmasını sağlamak | Önce açık talimat ve örnek; yetmezse ince ayar deneyi | Daha önce görmediği örneklerde de iyileşiyor mu? |
1. Belgeyi önüne koymak: Bağlam
Anthropic’in teknik belgesinde bağlam penceresi, modelin cevap üretirken başvurabildiği metin olarak tanımlanıyor; eğitimde kullanılan büyük veri yığınından özellikle ayrılıyor. Çalışma masası benzetmesi burada işe yarıyor: soruyu, ilgili sayfaları ve önceki konuşmadan gereken kısmı masaya koyuyorum. Bu malzeme cevabı etkileyebilir ama sırf masada durduğu için modelin eğitimle oluşmuş parametrelerinin güncellendiği anlamına gelmez.
Üstelik masanın tamamı yalnız benim PDF’me ayrılmıyor. Sistem talimatları, konuşma, araçlardan gelen içerik ve üretilecek cevap da bağlam hesabının parçaları. Bu nedenle bir ürünün büyük bir token sınırı sunması, aynı büyüklükteki dosyayı her durumda eksiksiz inceleyebileceğim anlamına gelmiyor. Dosyanın nasıl işlendiği ve içeriğin hangi kısmının modele sunulduğu da önemli.
Az sayıda belgeyle başlarken önce bu yolu denerim: soruyu daraltmak, ilgili bölümü eklemek, cevabın dayandığı yeri istemek. Bu bir hız veya doğruluk garantisi değil; araya ayrı bir arama sistemi koymadan önce en basit kurulumu sınama önerisi.
2. Arşivden ilgili sayfaları bulmak: RAG
RAG, kabaca “önce bul, sonra cevapla” düzeni. Hugging Face’in RAG açıklamasında, dış veri kaynağından ilgili parçaların getirildiği ve cevabın üretim sırasında bu parçalara dayandırıldığı anlatılıyor. Pratikte arşiv önceden aranabilir hâle getirilebilir; soru geldiğinde seçilen bölümler modele verilir. Her soruda bütün arşivi göndermek şart değildir.
Örneğin bir cihazın kullanım kılavuzları arasında batarya değiştirme koşulunu aradığımı düşünelim. Modelin kulağa makul gelen genel bir cevap vermesini değil, doğru cihazın doğru sürüm kılavuzunu bulmasını istiyorum. Burada ilk kontrolüm cevap cümlesi değil, getirilen sayfa olur. Yanlış kılavuz gelmişse akıcı anlatım sorunu çözmez.
Bu düzenin yararlı ayrımı şu: kaynak bilgi değiştiğinde, her değişiklik için modelin tamamını yeniden eğitmek yerine belgeyi ve arama indeksini güncellemek mümkün. Ama dosyayı klasöre bırakmak her sistemde yeterli değildir; eski parçalar indekste kalabilir. Güncellemenin arama sonucuna yansıdığını ayrıca kontrol etmek gerekir.
RAG bir doğruluk mührü de değil. İlgili bölüm bulunamayabilir, eski sürüm öne çıkabilir veya model doğru parçadan yanlış sonuç çıkarabilir. “Kaynak gösterdi” kontrolünü bu yüzden ikiye ayırıyorum: gösterdiği yer var mı ve o yer gerçekten bu cevabı destekliyor mu?
3. Örneklerle uyarlamak: İnce ayar
İnce ayarda ise bir eğitim süreci var. Tam ince ayar modelin parametrelerini günceller; parametre açısından verimli ince ayar (PEFT) yöntemleri daha küçük bir parametre kümesini eğiterek uyarlama yapar. Hugging Face’in PEFT deposu da bunu, tüm parametreler yerine az sayıda ek parametrenin eğitilmesi olarak açıklıyor. LoRA bu ailenin yöntemlerinden biri.
Temsili bir örnek: yüzlerce kısa başvuruyu “bilgi isteği”, “itiraz” ve “eksik belge” başlıklarından birine ayırmak istiyorum. Açık talimat ve birkaç örnek yeterli gelmiyorsa, etiketlenmiş örneklerle bir uyarlama deneyi anlamlı olabilir. Ama eğitimdeki örnekleri doğru etiketlemesi yetmez; ayrı tutulmuş, daha önce görmediği başvurularda ne yaptığını ölçmem gerekir.
Buradan “ince ayar bilgi öğretemez” sonucu çıkarmıyorum. Eğitim modelin öğrendiği örüntüleri ve vereceği cevapları değiştirebilir. Söylediğim daha dar: sürekli değişen bir bilgi listesini güncel tutmak ile tekrarlanan bir görevde davranışı uyarlamak aynı hedef değil. Her yeni fiyatı veya yönerge maddesini eğitim yoluyla taşımayı varsayılan çözüm yapmak yerine, belgeye erişimle çözülüp çözülmediğine bakarım.
Bir arada kullanıldıklarında ne olur?
Bu üç yol birbirinin rakibi olmak zorunda değil. Bir uygulama önce arşivde arama yapabilir, bulunan parçaları bağlama koyabilir ve cevabı belirli bir biçimde üretmesi için uyarlanmış bir model kullanabilir. Sonuç kötü olduğunda bütün sorunu “model zayıf” diye adlandırmak hangi parçayı düzeltmem gerektiğini gizler.
- Kaynak yanlışsa: Belge seçimini, sürümü ve arama sonucunu kontrol ederim.
- Kaynak doğru ama cevap yanlışsa: Modelin hangi cümleden hangi sonucu çıkardığını incelerim.
- Bilgi doğru ama istenen işi tutarsız yapıyorsa: Talimatları ve örnekleri gözden geçirir, gerekiyorsa ayrı bir ince ayar deneyi tasarlarım.
Bunlar bir başarı sıralaması değil, hatayı yerelleştirmek için bir kontrol sırası. Hangi yolun daha ucuz veya daha iyi olduğu belge sayısına, güncelleme sıklığına, modele ve göreve bağlı; bu yazıda bu maliyetleri ölçmedim.
“Dün söyledim, bugün neden bilmiyor?”
Bir sohbet ürününün geçmişi veya hafıza özelliği, burada anlattığım teknik bağlam mekanizmasına ek bir ürün katmanı olabilir. Uygulama önceki bilgileri saklayıp sonraki isteğe yeniden ekleyebilir. Bunun varlığını, hangi bilgiyi seçtiğini ve ne kadarını taşıdığını ürünün kendi açıklamasından kontrol etmek gerekir. Aynı modeli kullanan iki uygulamanın aynı şeyi hatırlaması şart değildir.
Bu yüzden bir bilginin sonraki sohbette görünmesi tek başına “model benim konuşmamla yeniden eğitildi” kanıtı olmaz. Tersi de geçerli: bir şeyi hatırlamaması, uygulamanın hiçbir kayıt tutmadığını kanıtlamaz. Cevap için kullanılan bağlam ile verinin saklanması veya sonraki eğitimlerde kullanılması ayrı sorulardır. Bu yazı bir ürünün veri saklama politikasını denetlemiyor.
Kendi belgelerimle başlarken kontrol listem
- Önce tek bir gerçek soru seçerim. “Belgelerimi öğrensin” yerine, hangi belgedeki hangi bilgiyi bulmasını istediğimi yazarım.
- Beklenen dayanağı kendim belirlerim. Doğru cevapla birlikte doğru sayfa veya bölümü de kaydederim.
- Basit yolu sınarım. İlgili parçayı doğrudan vermek yeterliyse ilk aşamada ayrıca eğitim kurmam.
- Arşiv gerekiyorsa aramayı ayrı kontrol ederim. Cevap üretmeden önce getirilen parçaların doğru sürümden geldiğine bakarım.
- İnce ayar gerekiyorsa ayrı test örnekleri tutarım. Eğitimde gördüğü metni tekrarlamasını genel bir iyileşme saymam.
- Bilginin olmadığı soruyu da denerim. Belgede cevap yokken bunu söyleyebiliyor mu? Tahmini, kaynaktan alınmış bilgi gibi sunuyor mu?
Benim için sonuç
Belgeyi okutmak, belge arşivinde aratmak ve örneklerle eğitmek aynı “öğretme” işleminin üç adı değil. Birinde cevabın önüne malzeme koyuyorum, birinde o malzemeyi bulacak düzen kuruyorum, diğerinde modelin davranışını eğitimle değiştiriyorum. İşe bu ayrımla başlamak, gerekmeyen bir eğitim projesine girmekten veya yalnız arama kurup doğruluk sorununu çözülmüş saymaktan kaçınmaya yardımcı oluyor.
Kaynaklar, yöntem ve sınırlar
13 Kasım 2026 tarihinde erişilen birincil teknik belgeler temel alındı. Bu, teknik belgelere dayanan açıklayıcı bir rehberdir; hız, doğruluk oranı, fiyat ve eğitim süresi ölçülmedi. Senaryolar açıklama amaçlıdır; çalıştırılmış istem veya model çıktısı değildir. Ürünlerin bağlam yönetimi, hafıza ve veri politikaları ayrıca incelenmelidir.
- Anthropic: Context windows — çalışma bağlamı ile eğitim verisi ayrımı ve bağlamı paylaşan içerikler.
- Hugging Face Transformers: RAG — dış kaynaktan ilgili parçaları getirerek cevap üretme.
- Hugging Face PEFT resmî deposu — az sayıda parametreyle uyarlama ve LoRA örneği.
Okurun aynı işi kurarken kendi belge ve sorularıyla doğrulama yapması gerekir. Daha uzun bağlamın, RAG’in veya ince ayarın her görevde daha iyi sonuç verdiği iddia edilmiyor.