 zekayapar
Model tablosundaki yüksek puan ezber olabilir mi?
Model tablosundaki yüksek puan ezberden gelebilir mi? GSM1k, LiveBench ve şık tahmini çalışmalarıyla bir benchmark sonucunu okurken baktığım beş şey.
İncelenen çalışmalar
- GSM1k: Zhang vd. (Scale AI), 2024
- Eksik şık tahmini (TS-Guessing): Deng vd., 2023
- LiveBench: White vd., 2024
İnceleme kapsamı
- Kaynaklı rehber; yeni model ya da sızıntı ölçümü yapılmadı
- Kendi YKS 2026 testimde kullandığım kontroller örnek olarak anlatıldı
Yeni bir model çıktığında ilk gördüğüm şey genellikle bir puan tablosu oluyor: matematikte şu kadar, genel bilgide bu kadar. Kısa cevap şu: yüksek bir puan ezberden de gelebilir. Puan yanlış yazılmış olmayabilir; ama model o soruları ya da çok benzerlerini eğitim sırasında gördüyse, ölçülen şey "yeni bir soruyu çözebiliyor mu" olmaktan çıkar, "bu testi tanıyor mu" sorusuna kayar. Bu yazıda bunun nasıl araştırıldığını ve kendi testlerimde bir puanı okurken nelere baktığımı anlatıyorum.
Baştan söyleyeyim: bu yazı için yeni bir model ölçümü yapmadım. Aşağıdaki sayılar yayımlanmış üç çalışmanın kendi özetlerinden geliyor; kendi deneyimim ise daha önce yayımladığım YKS testinde uyguladığım yöntemle sınırlı.
Ezber ya da "test sızıntısı" ne demek?
Büyük dil modelleri internetten toplanmış çok büyük metinlerle eğitiliyor. Popüler test setleri de internette duruyor: sorular, çoğu zaman cevaplarıyla birlikte GitHub'da, forumlarda, ders sitelerinde. Bir testin soruları ya da çok benzerleri eğitim verisine karışırsa buna test sızıntısı (İngilizcesi contamination) deniyor. Sonuç, sınav sorularını önceden görmüş bir öğrenciye benziyor: notu yüksek, ama aynı konudan yeni bir soruda ne yapacağı belli değil.
Burada önemli bir ayrım var. Sızıntı modelin hiçbir şey bilmediği anlamına gelmez. Sadece o puanın, modelin yeni sorulardaki başarısını ne kadar temsil ettiği belirsizleşir.
Araştırmalar ne buldu?
Aynı tarzda yeni 1.000 soru
Scale AI'dan Zhang ve arkadaşlarının 2024 çalışması bunu doğrudan sınadı. İlkokul düzeyi matematikte çok kullanılan GSM8k testinin tarzına ve zorluğuna benzeyen 1.000 yeni soru hazırlattılar (GSM1k); bu sorular modellerin eğitim verisinde bulunmayacak şekilde sıfırdan yazıldı. İki setin insan çözme oranı, çözüm adımı sayısı ve cevapların büyüklüğü gibi ölçülerde karşılaştırılabilir olmasına dikkat ettiler. Sonra aynı modelleri iki sette de çalıştırdılar.
Çalışmanın özetine göre bazı modellerde yeni sette doğruluk düştü; özet bu düşüşü “%8’e kadar” diye veriyor (bunun yüzde mi, yüzde puan mı olduğu özette ayrıca belirtilmiyor). Ayrıca bazı model ailelerinde neredeyse her boyutta sistematik bir aşırı uyum işareti görüldü. Bir modelin eski testteki örnekleri üretme olasılığı ile iki set arasındaki puan farkı arasında pozitif bir ilişki bulundu (Spearman r² = 0,36); yazarlar bunu bazı modellerin GSM8k'yi kısmen ezberlemiş olabileceğine işaret olarak yorumluyor.
Aynı özette dengeleyici bir cümle de var ve onu atlamamak gerekiyor: birçok model, özellikle en güçlüleri, aşırı uyuma dair çok az işaret gösterdi ve bütün modeller, eğitim verisinde bulunmadığı garanti edilen yeni sorulara genel olarak genelleme yapabildi. Yani tablo "hepsi ezber" değil; "bazılarında puanın bir kısmı ezber olabilir".
Eksik şıkkı tahmin ettirmek
Deng ve arkadaşlarının 2023 çalışması başka bir yol denedi. Çoktan seçmeli bir sorunun yanlış şıklarından birini gizleyip modelden boşluğu doldurmasını istediler. Soruyu hazırlayanın uydurduğu yanlış bir şıkkı kelimesi kelimesine bilmek, sorunun kendisinden kolayca çıkarılabilecek bir şey değil. Çalışmanın özetine göre MMLU testinde ChatGPT gizlenen şıkkı yüzde 52, GPT-4 ise yüzde 57 oranında birebir tahmin etti. Bu, modelin o test sorularıyla daha önce karşılaşmış olabileceğini düşündürüyor; ama tek başına sızıntıyı kanıtlamıyor.
Bu sayılar 2023'teki o modellere ait; bugünün modelleri için aynı oranı söyleyemem. Ama yöntem fikri hâlâ işe yarıyor: model, sorunun kendisinde olmayan bir ayrıntıyı biliyorsa dikkat etmek gerekir.
Her ay yenilenen sorular
Soruna bir çözüm önerisi de LiveBench (White ve arkadaşları, 2024). Fikir basit: soruları sürekli yeni kaynaklardan, örneğin yakın tarihli matematik yarışmalarından, arXiv makalelerinden ve haberlerden üretmek, cevapları da hakem modele bırakmadan nesnel doğru cevaplarla otomatik puanlamak. Özete göre sorular her ay ekleniyor ve güncelleniyor. Yakın tarihli kaynaklardan yeni sorular eklemek, modelin bu soruları eğitim sırasında görmüş olma riskini azaltmayı amaçlıyor. Makalenin yayımlandığı tarihte en iyi modeller bile yüzde 70'in altında kalıyordu.
Kendi testimde ne yaptım?
YKS 2026 testinde aynı soruyla karşılaştım: sınav soruları yayımlandıktan sonra çıkan bir model o soruları görmüş olabilir mi? O yazıda üç şey yaptım. Her modelin eğitim verisinin nerede bittiğine yapımcının açıklamasından baktım ve sınav tarihiyle karşılaştırdım; kesim tarihini açıklamayan ve sınavdan sonra yayımlanan modellerde ezber ihtimalini dışlayamadığımı açıkça yazdım. Şıkların sırasını karıştırıp tekrar sordum. Bir de eski bir sınavla yenisini karşılaştırdım; eski sorular modellerin hepsinin eğitim verisine girmiş olabileceği için, eski sınavda belirgin biçimde daha iyi olmak ezbere işaret edebilir.
Oradan çıkardığım ders: tek bir kontrol, ezberi ne kesin olarak kanıtlar ne de ezber ihtimalini ortadan kaldırır. Şıkları bir kez karıştırmak ezberi kanıtlamaz da, aklamaz da. Birkaç işaretin aynı yöne bakıp bakmadığına bakmak gerekiyor.
Bir puanı okurken baktığım beş şey
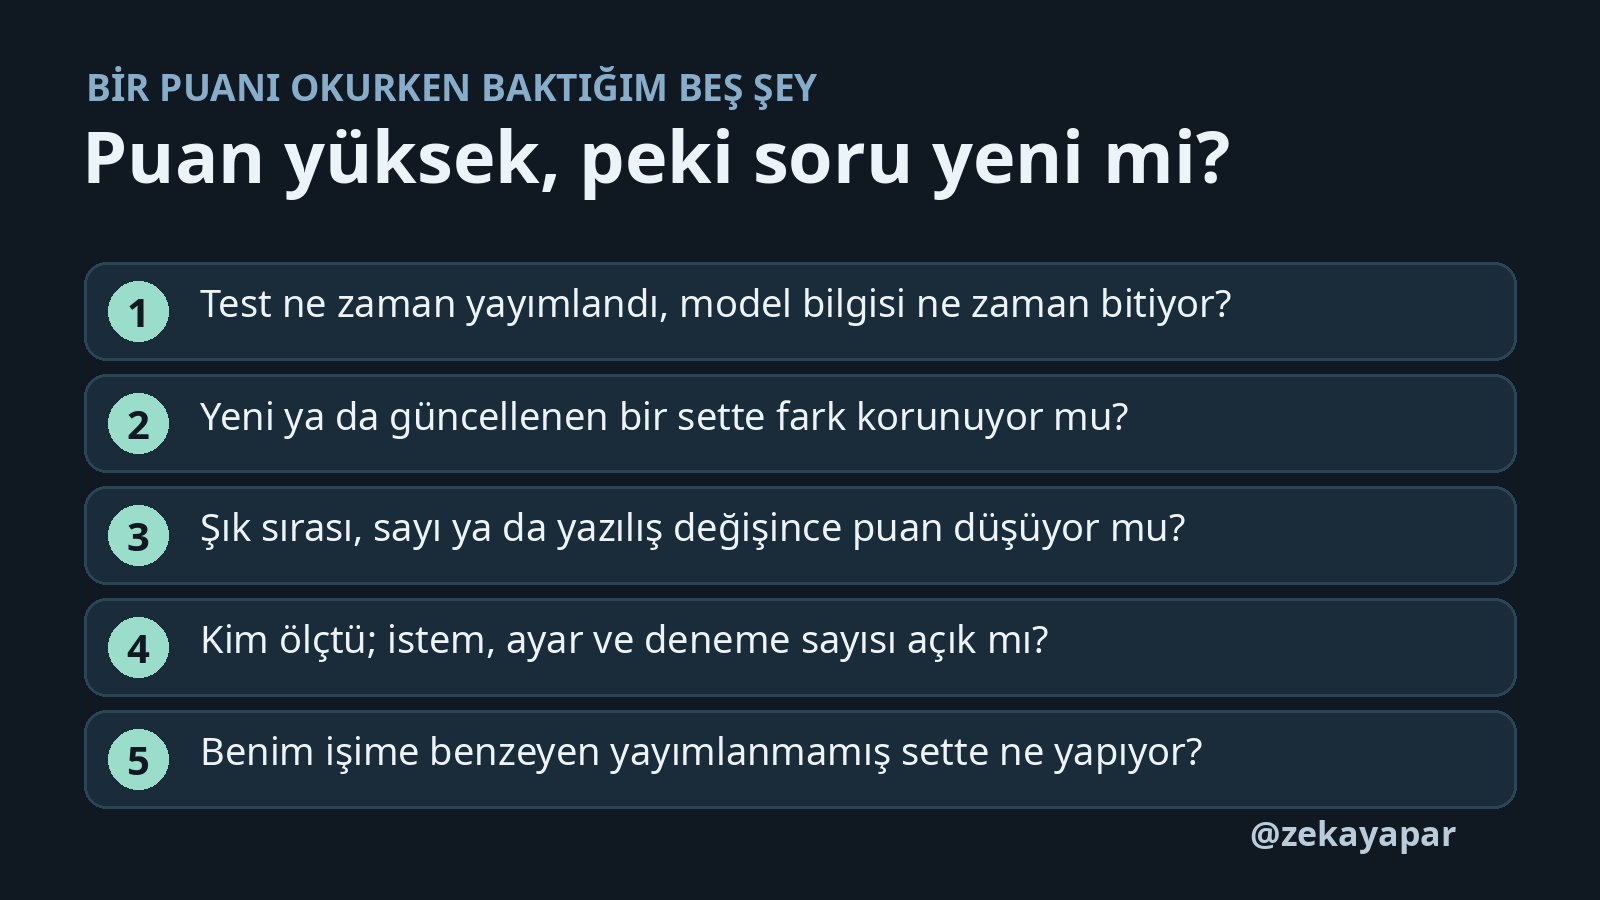
- Test ne zaman yayımlandı, modelin bilgisi ne zaman bitiyor? Test modelin eğitim verisinin kesim tarihinden önce internetteyse, sızıntı ihtimali vardır. Kesim tarihi açıklanmamışsa bunu bilinmiyor diye not ediyorum.
- Yeni ya da güncellenen bir sette fark korunuyor mu? Eski ve çok bilinen bir testte öne çıkan model, LiveBench gibi sürekli yenilenen bir sette de öndeyse puana daha çok güveniyorum.
- Küçük değişikliklere dayanıyor mu? Şıkların sırası, sayılar ya da sorunun yazılışı değişince puan sert düşüyorsa model soruyu değil, kalıbı tanıyor olabilir.
- Kim ölçtü, nasıl ölçtü? Puanı yapımcı mı verdi, bağımsız biri mi? Kullanılan istem, ayarlar ve deneme sayısı açık mı? Aynı testte farklı ayarlarla farklı puanlar çıkabiliyor.
- Benim işime benziyor mu? İngilizce ilkokul matematiğindeki puan, Türkçe bir dilekçe ya da fatura okuma işinde ne yapacağını doğrudan söylemez.
Kendi küçük test setini kurmak
Bir model seçeceksem en güvendiğim yol, hiçbir yerde yayımlanmamış küçük bir set. Kendi işinden 20–30 gerçek örnek seçmek, beklenen cevabı ayrı bir dosyada tutmak ve her modele aynı istemle sormak iyi bir başlangıç. Bu seti internete koymamak önemli; koyduğun anda gelecekteki modellerin eğitim verisine girebilir. Kişisel ya da gizli bilgi içeren örnekleri de önce temizlemek gerekiyor.
Bu küçük set genel bir sıralama vermez ve kesin bir hüküm için azdır; ama asıl merak ettiğim soruya ilk fikri verir: bu model benim işimde ne kadar iyi?
Sınırlar
- Bu yazı kaynaklı bir rehber; yeni bir model ölçümü ya da sızıntı testi yapmadım.
- Araştırmalardaki sayılar o çalışmalarda denenen modellere ve o tarihlere ait. Bugünkü bir modele aynen taşınamaz.
- Puan farkı yalnız ezberden gelmez; iki set arasındaki zorluk farkı ya da istem farkı da puanı değiştirebilir. Tersine, fark çıkmaması da kesin olarak temiz olduğu anlamına gelmez.
- Kesim tarihleri yapımcı beyanıdır; eğitim verisinin içeriği çoğu modelde açık değil.
Kaynaklar
- Zhang, Da, Lee vd., A Careful Examination of Large Language Model Performance on Grade School Arithmetic (GSM1k), 2024: arxiv.org/abs/2405.00332
- Deng, Zhao, Tang vd., Investigating Data Contamination in Modern Benchmarks for Large Language Models, 2023: arxiv.org/abs/2311.09783
- White, Dooley, Roberts vd., LiveBench: A Challenging, Contamination-Limited LLM Benchmark, 2024: arxiv.org/abs/2406.19314