 zekayapar
Aynı iki 5090 üzerinde Devstral ve Qwen kod teslimi
Üç projede aynı görev ve test akışı: ilk teslim, ek düzeltmeler, token tüketimi ve süre.
Modeller ve inference
- Qwen3.8-27B · NVFP4
- Devstral Small 2 24B · FP8
- 2× RTX 5090 · kart başına 32 GB
- vLLM 0.30.0 · FlashInfer
- TP2 · BF16 KV · MTP kapalı
- 16K bağlam · CUDA graph 32
Kod ve değerlendirme
- Python 3.12.15
- Transformers 5.10.4
- mistral_common 1.12.0
- İşlevsel testler · çıktı biçimi kontrolleri
Neyi yazdırdım
Qwen’den sonra aynı iki 5090 üzerinde Devstral’a da üç küçük proje yazdırdım: tekrar içe aktarmada kayıt çoğaltmayan bir olay defteri, kaynak satırı döndüren belge arama ve iki worker aynı işe atlamasın diye atomik kayıt kullanan bir iş kuyruğu. Her model için üç ayrı seed kullandım; toplam 18 teslim vardı.
İlk ve son teslim
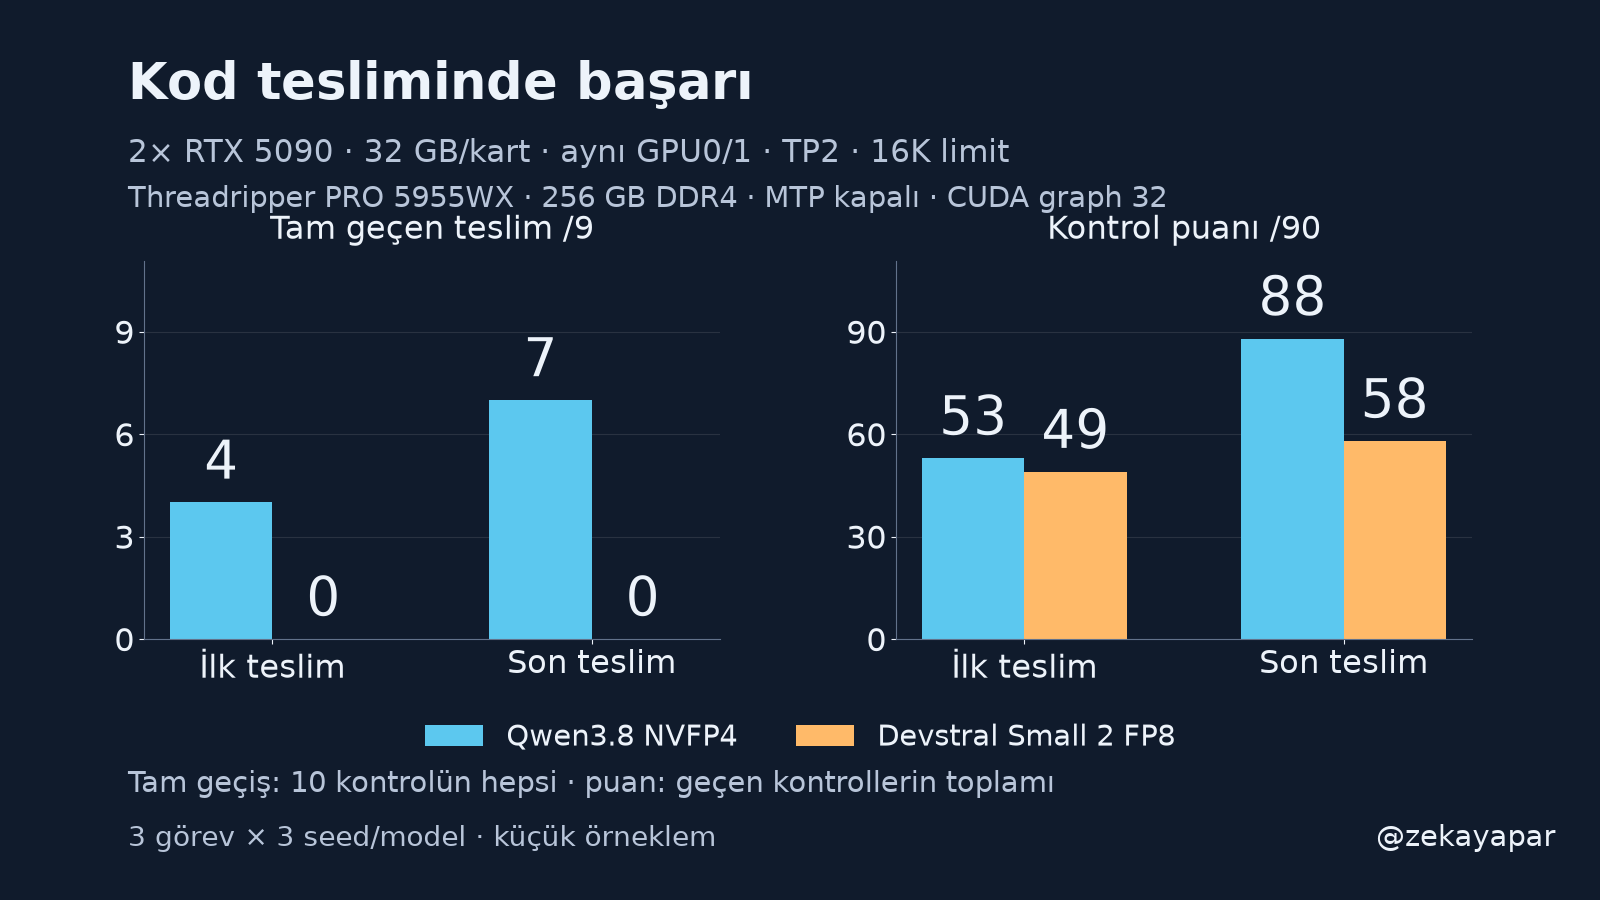
İlk yanıtların Qwen’de 4/9’u, Devstral’da 0/9’u tüm kabul kontrollerini geçti. Son teslimde değerler 7/9 ve 0/9 oldu. Son teslimlerin toplam kontrol puanı Qwen için 88/90, Devstral için 58/90. Tek bir kontrol eksikse o teslim tam geçmiş sayılmadı.
Aynı koşullar
İki model sırayla aynı fiziksel GPU0 ve GPU1 RTX 5090 üzerinde TP2 ile çalıştı. 16K toplam bağlam limiti, tek aktif istek, 1.024 batch tokenı, BF16 KV, FlashInfer ve 32 yakalama limitli CUDA graph ayarı aynıydı. MTP iki tarafta da kapalıydı. GPU işlemlerini önceden kaydedip tekrar kullanan CUDA graph optimizasyonu iki tarafta da açıktı; süreleri bu ortak test ayarıyla ölçtüm. Threadripper PRO 5955WX ve 256 GB DDR4 RAM kullandım. Üçüncü kart bu karşılaştırmaya katılmadı.
Profillerin önemli farkı
Qwen3.8-27B NVIDIA NVFP4 ağırlıklarıyla, Devstral Small 2 24B resmi FP8 ağırlıklarıyla çalıştı. Bu yüzden sonucu bu iki yerel profilin kod teslim karşılaştırması olarak okuyorum. Hassasiyet etkisinden bağımsız bir model sıralaması veya aynı quantization altında hız sonucu çıkarmıyorum. Chat şablonu her modele uygundu; Qwen thinking kapalıydı.
Teslimi nasıl değerlendirdim
Her projeye aynı görev sözleşmesi, başlangıç dosyaları ve modelin gördüğü basit çalışma testi verildi. Ürün kodunu ilgili model yazdı. Her teslim için ayrıca 10 saklı kabul kontrolü vardı: kalıcılık, sınır değerler, doğru kaynak, hatada geri alma veya eşzamanlı claim gibi davranışlar. İlk çağrıdan önce sözleşmeler, testler ve ölçüm kodu hashleri sabitlendi. Değerlendirme Python 3.12.15 ile yapıldı.
Düzeltme turu neyi gösteriyor
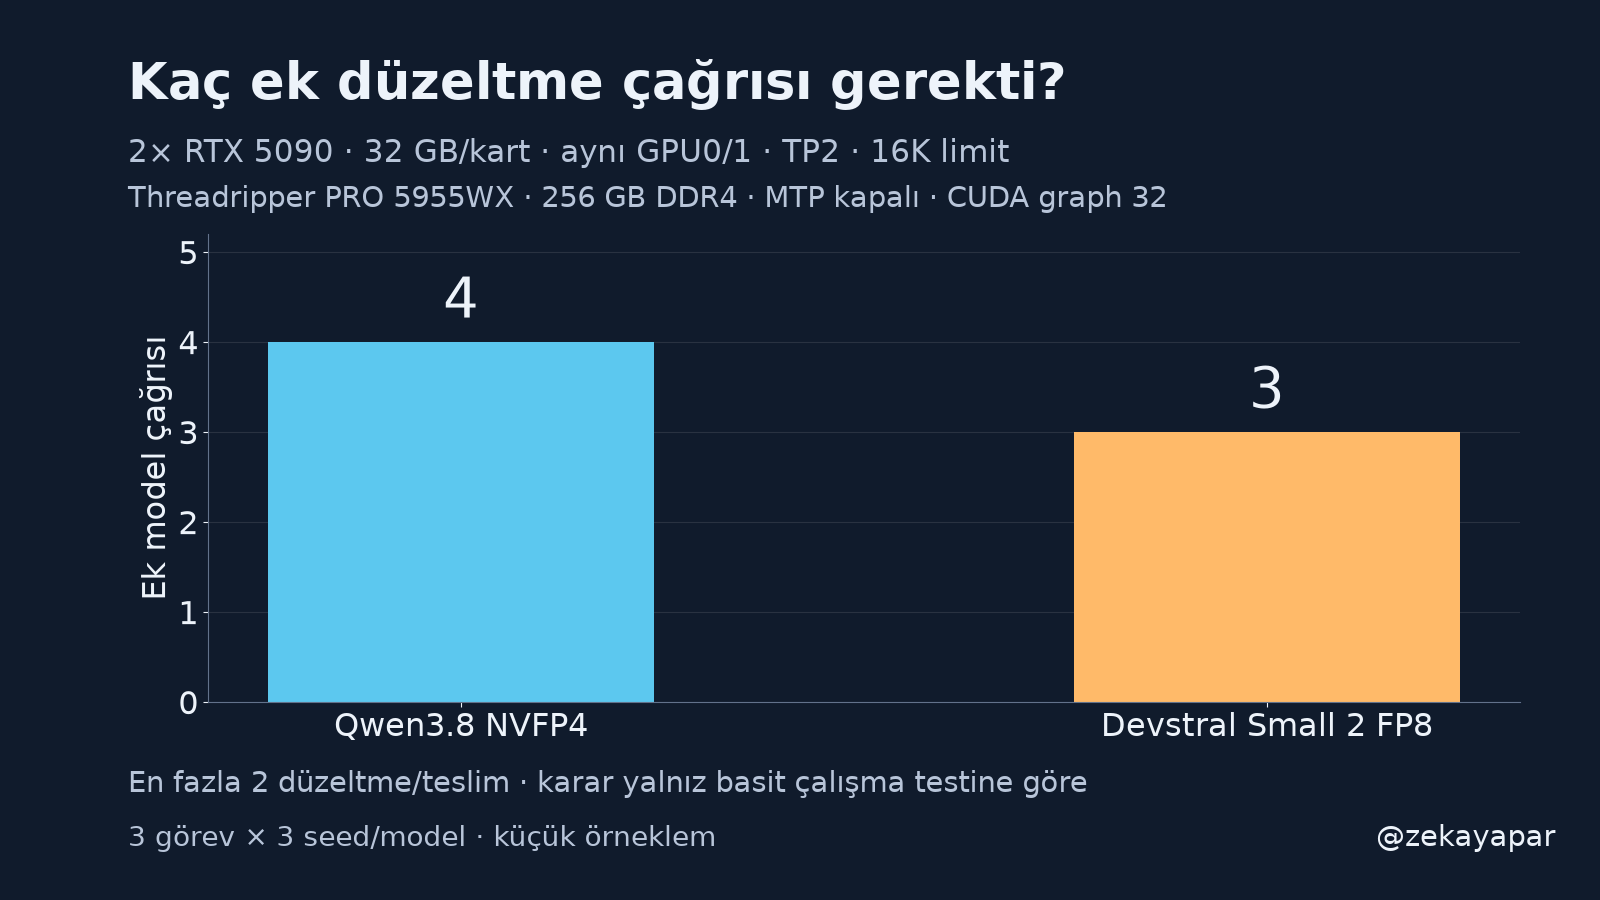
Basit çalışma testi veya çıktı biçimi başarısızsa en fazla iki düzeltme çağrısına izin verdim. Qwen için 4, Devstral için 3 ek çağrı yapıldı. Saklı kontroller modele gösterilmedi ve durma kararını değiştirmedi. Yani basit testi geçen ama daha ayrıntılı kabul kontrolünde kalan proje de orada durdu. Bu sayı, bütün saklı hataların onarım maliyeti değil; yalnız bu geri bildirim akışındaki ek çağrı sayısı.
Token tüketimi
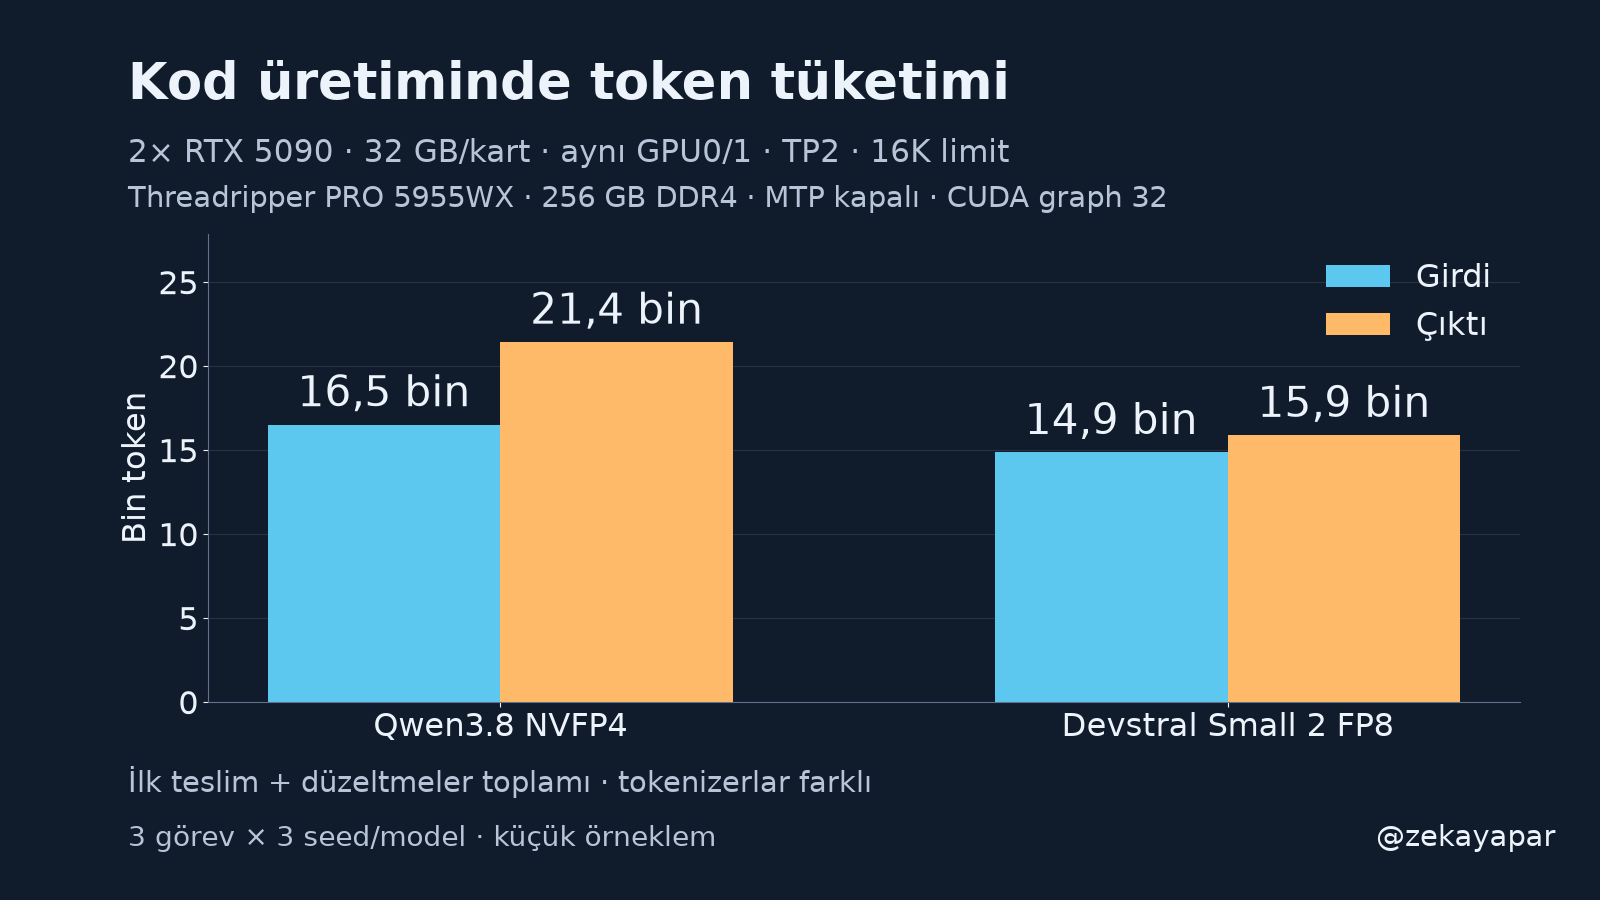
İlk teslim ve varsa düzeltmeler birlikte Qwen 16.517 girdi ve 21.432 çıktı tokenı kullandı. Devstral 14.862 girdi ve 15.882 çıktı tokenı kullandı. Tokenizerlar farklı; aynı token sayısı aynı metin miktarı anlamına gelmiyor. İlk görev metni aynıydı; düzeltmede her model kendi yanıtını ve aynı basit testin geri bildirimini aldı. Yanıtlar modelin doğal bitişinde durdu; çağrı başına en çok 8.000 çıktı tokenı istendi.
Model ve ek süre
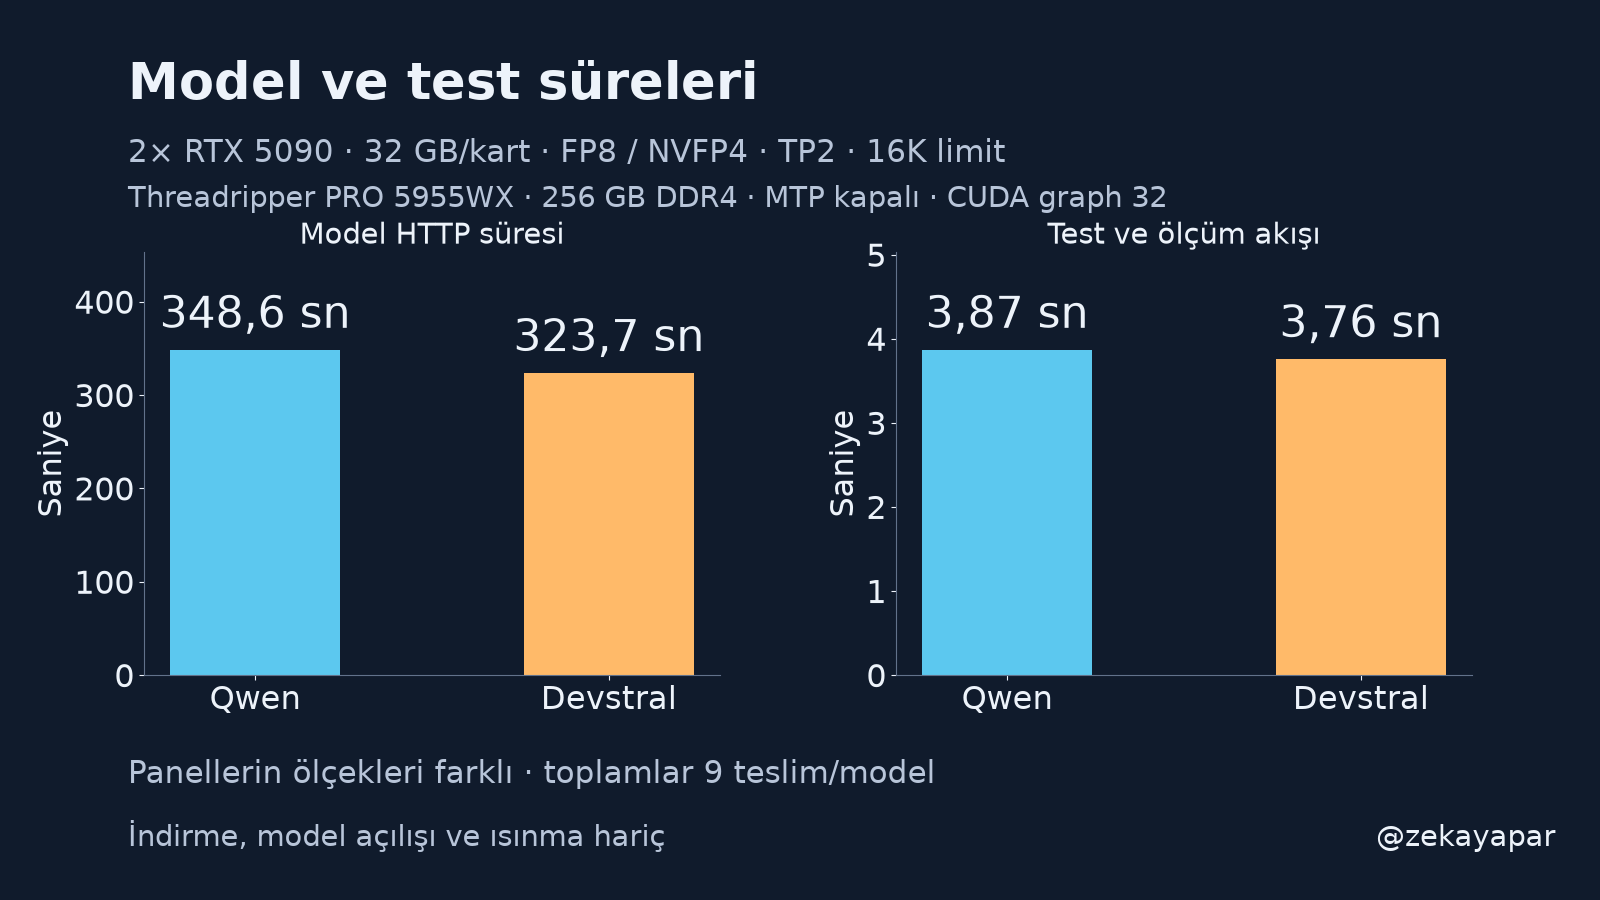
Ölçülen çağrıların toplam model HTTP süresi Qwen için 348,59 saniye, Devstral için 323,71 saniye oldu. Test ve değerlendirme toplamı 2,54 ve 2,55 saniyeydi. Teslim akışının toplam geçen süresi 352,46 ve 327,47 saniye. İndirme, model açılışı, ısınma ve yazı hazırlama bu toplamlara katılmadı. Grafikteki ek akış süresi, teslim akışı toplamından HTTP süresinin çıkarılmasıyla hesaplandı: Qwen için 3,87, Devstral için 3,76 saniye. Bu fark testleri ve ölçüm aracının diğer işlerini içeriyor; yalnız test çalıştırma süresi ayrıca yukarıda verildi. İki panelin ölçekleri farklı.
Bu sonucu nasıl okuyorum
Her modelde dokuz teslim ve üç görev var. Bunlar genel yazılım geliştirme yeteneğini ölçen geniş bir benchmark değil. Aynı dosya sözleşmesi ve aynı test akışında bu yerel profillerin nasıl teslim yaptığını gösteriyor. Hata, biçim sorunu ve kesilmiş çıktılar ham kayıtlarda tutuldu; insan eliyle düzeltilmiş kod bu karşılaştırmaya eklenmedi. Üretim profilini ölçüm sonunda geri açıp gerçek JSON yanıtıyla doğruladım.
İlk koşuyu neden tekrar ettim
İlk koşudaki çalıştırıcı, hata mesajında kullanılan zararsız type(...).__name__ ifadesini engelledi. Böyle bir teslimde işlev testleri hiç başlamadığı için onu kod hatası saymak yanıltıcı olurdu. Salt okunur bu alanı iki model için aynı şekilde serbest bıraktım ve bütün 18 teslimi aynı görev ve kabul testleriyle yeniden ürettim. Yeni koşuda iki tarafın CUDA graph ayarı da ortaktı. Önceki koşunun tamamlanmış 33 kod üretim çağrısı ayrıca 96.347 token ve 4.025,05 saniye model HTTP süresi kullandı. Bu kayıtları sakladım; karşılaştırma grafiklerine katmadım. Bu hazırlık sayıları indirme, model açılışı ve ısınmayı içermiyor.
Tekrar çalıştırma
Model revisionları, backend sürümleri, dondurulmuş protokol, ham istek ve SSE yanıtları, kod dosyaları, test stdout/stderr kayıtları ve token/süre ölçümleri saklandı. Qwen revisionı 482ca0f3832238542f8f5295dde86b5f22711d80; Devstral revisionı 55c5b41e98c2dbd21b0c8afffc540dcfc9eb5128. vLLM 0.30.0, Transformers 5.10.4 ve mistral_common 1.12.0 kullanıldı.
Devstral resmi model kartı ↗ · Önceki belge arama projesi