 zekayapar
Model indirirken hangi dosyayı seçmeli? GGUF, safetensors ve Q4 ne demek?
GGUF ile safetensors aynı şeyi mi anlatıyor? Q4 neden tam dört bit değil? Gerçek bir modelin dosya listesinden indirme ve bellek hesabını ayırıyorum.
Bu yazıda incelenenler
- GGUF biçim tanımı · safetensors · llama.cpp belgeleri
- Hugging Face Hub dosya ve sürüm kayıtları
Yöntem ve sınır
- Gerçek dosya listesi: Qwen3.5-0.8B-GGUF, sabit depo sürümü
- Yeni model çalıştırma, hız veya kalite testi yok
Bir modelin indirme sayfasında BF16, Q4, GGUF ve safetensors yan yana durunca sanki aynı sorunun farklı cevaplarıymış gibi görünüyor. Değiller: GGUF ve safetensors dosyanın nasıl saklandığını, Q4 gibi adlar ise ağırlıkların hangi sayısal gösterimle tutulduğunu anlatıyor. Hangi dosyayı indireceğime karar verirken önce kullanacağım uygulamaya, sonra onun desteklediği modele ve sayısal biçime bakıyorum. Dosyanın küçük olması tek başına çalışacağı anlamına gelmiyor.
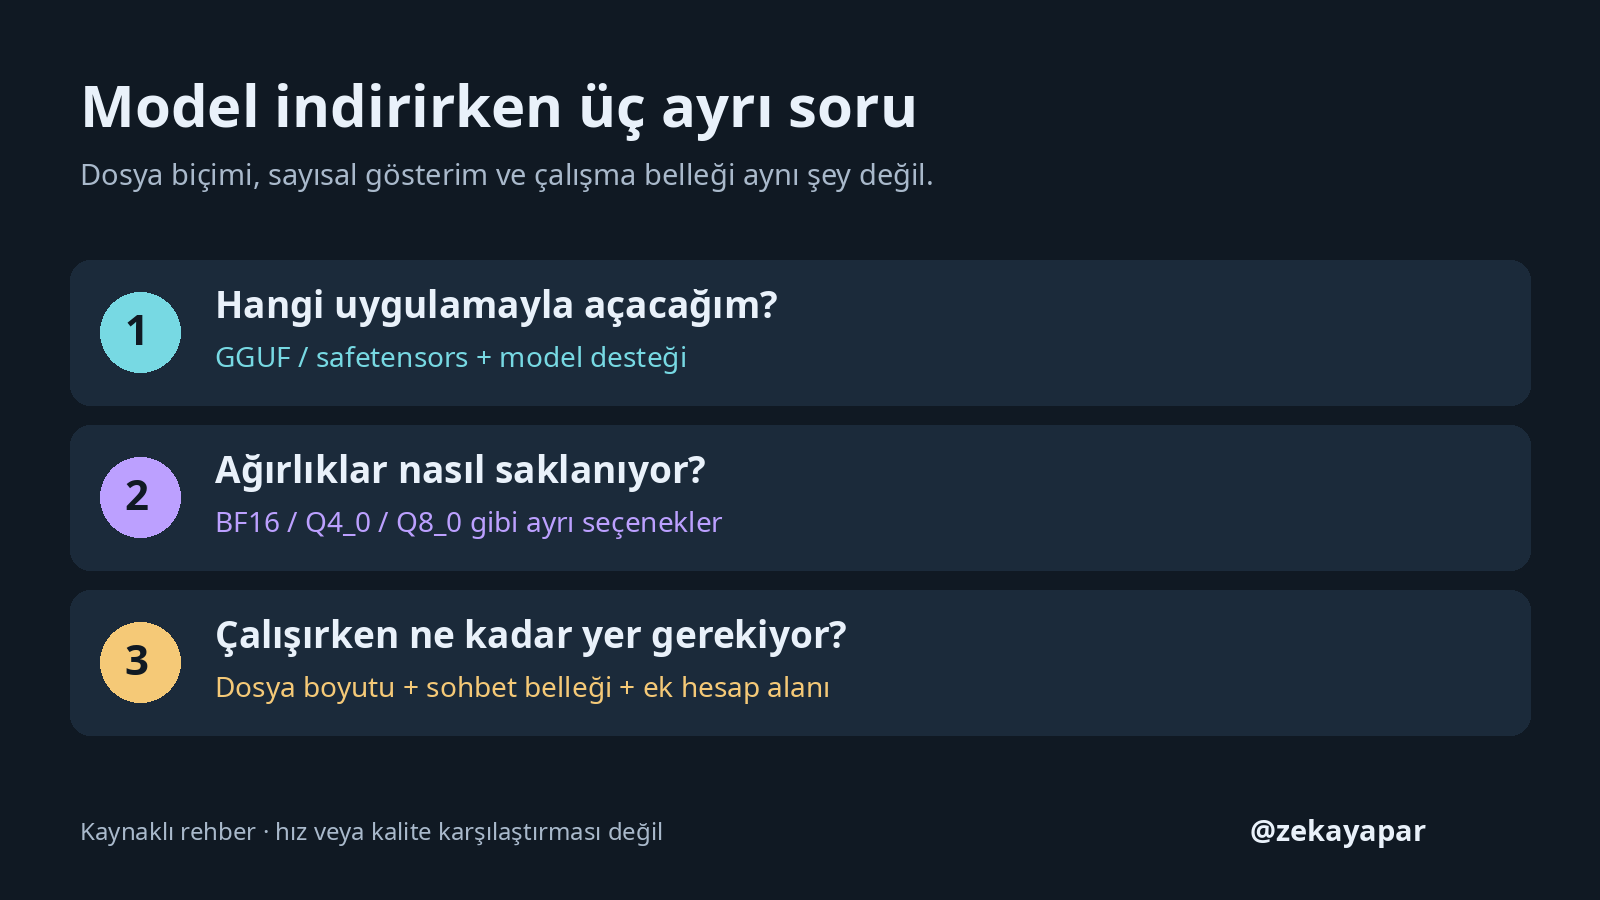
Bu yazı yeni bir hız ya da kalite testi değil. Hugging Face ve llama.cpp belgelerini, gerçek bir model deposunun sürümü sabitlenmiş dosya listesiyle birlikte okuyorum. Hiçbir model ağırlığını indirip çalıştırmadım; aşağıdaki boyutlar deponun bildirdiği dosya uzunlukları.
Önce dosya uzantısına değil, kullanacağım uygulamaya bakıyorum
İlk soru “hangisi daha iyi?” değil, “bunu neyle açacağım?” olmalı. Bir masaüstü sohbet uygulamasının GGUF içe aktarması, aynı modelin safetensors dosyasını da açacağı anlamına gelmez. Tersi de geçerli. Uygulamanın yalnız dosya biçimini değil, modelin mimarisini ve seçtiğim nicemleme türünü de desteklemesi gerekiyor.
Burada çalıştırıcı dediğim, modelin hesabını yapan yazılım. llama.cpp bunun bir örneği; resmî belgeleri GGUF dosyalarını ve farklı donanım arka uçlarını anlatıyor. Aynı çalıştırıcının eski bir sürümünde yeni bir modelin desteği bulunmayabilir. Bu yüzden bir indirme sayfasındaki “GGUF” etiketini genel uyumluluk mührü olarak okumuyorum. [1] [3]
GGUF ile safetensors arasındaki asıl ayrım
| Etiket | Ne anlatıyor? | Tek başına ne söylemiyor? |
|---|---|---|
| GGUF | Ağırlık dizilerini ve modelle ilgili standart üst verileri saklayan bir dosya biçimi. | Modelin her uygulamada açılacağını, dört bit olduğunu veya belirli bir hızda çalışacağını. |
| safetensors | Ağırlık dizilerini, pickle'ın kod çalıştırma riskinden kaçınan bir biçimde saklama yöntemi. | Modelin kaç bit olduğunu, ne kadar RAM isteyeceğini veya bütün indirme paketinin güvenilir olduğunu. |
| BF16 / Q4_0 / Q8_0 | Sayısal gösterim ya da nicemleme türü hakkında bilgi. | Dosya biçimini tek başına veya modelin Türkçe cevap kalitesini. |
GGUF tanımı, ağırlıkların yanında mimari ve tokenizer bilgileri gibi üst verilere de yer veriyor; sohbet şablonu için de bir alan tanımlı. safetensors ise ağırlık dizilerini saklamaya odaklanıyor. Bu biçimde dağıtılan bir modeli kullanırken yapılandırma ve tokenizer gibi eşlik eden dosyalar da gerekebiliyor. “Tek dosyayı aldım, paket tamam” varsayımıyla ilerlemek yerine modelin ve uygulamanın yönergesini izlemek daha sağlam. [1] [2] [4]
safetensors adındaki “safe” kelimesine de bir sınır koymak gerekiyor. Ağırlık dosyasının pickle gibi davranmaması, depodaki ayrı Python betiklerinin veya kurulum komutlarının güvenli olduğunu garanti etmez. Dosya biçimiyle bütün pakete verdiğim güveni birbirine karıştırmıyorum.
Gerçek bir indirme sayfasında üç ayrı seçenek
Somut örnek olarak ggml-org/Qwen3.5-0.8B-GGUF deposuna baktım. Bu, güncel modeller arasında bir öneri ya da sıralama değil; aynı depoda dosya biçimiyle sayısal gösterimin nasıl ayrıldığını gösteren küçük bir örnek. Sabitlenen sürümde şu üç GGUF dosyası var:
| Dosya | Depodaki boyut | Buradan okuyabildiğim |
|---|---|---|
Qwen3.5-0.8B-BF16.gguf | 1.557.662.496 bayt yaklaşık 1,56 GB | BF16 gösterimi; dosya biçimi yine GGUF. |
Qwen3.5-0.8B-Q4_0.gguf | 563.036.064 bayt yaklaşık 563 MB | Q4_0 nicemlemesi; dosya biçimi yine GGUF. |
Qwen3.5-0.8B-Q8_0.gguf | 833.592.096 bayt yaklaşık 834 MB | Q8_0 nicemlemesi; dosya biçimi yine GGUF. |
Yaklaşık boyutlarda 1 GB = 1.000.000.000 bayt, 1 MB = 1.000.000 bayt kullanıldı. Bunlar çalışma belleği ölçümü değil.
Burada önemli olan yalnız küçük dosyayı bulmak değil: BF16 dosyası da GGUF. Dolayısıyla “GGUF indirdim” cümlesi “dört bit model indirdim” demek değil. Dosya listesinden boyut farkını görebiliyorum; hangi sürümün belirli bir Türkçe işte ne kadar doğru cevap vereceğini ise bu liste göstermiyor. Bunun için aynı görevlerle ayrıca ölçüm yapmak gerekir. [5]
Deponun açıklaması dosyaların otomatik dönüştürüldüğünü söylüyor. .src_sha kaydı da kaynak modelin belirli bir sürümüne işaret ediyor. Bu, dönüşümün kökenini izlemeyi sağlıyor; dönüştürülmüş her dosyanın kalitesinin bağımsız test edildiği anlamına gelmiyor.
Q4, neden dosyanın her yerinde tam dört bit demek değil?
Nicemlemeyi kabaca, ağırlıkları daha az yer kaplayan bir sayısal gösterime dönüştürmek olarak düşünebiliriz. Fakat dosyada yalnız bu ağırlık değerleri yok. Sayıları geri yorumlamak için ölçekler ve başka yardımcı bilgiler de tutulabiliyor; ayrıca modelin bütün ağırlık dizileri aynı türde saklanmak zorunda değil.
Hugging Face'in teknik tablosunda Q4_K için ağırlık başına 4,5 bit yazıyor: dört bitlik değerlerin yanında blok ölçekleri ve minimum bilgileri var. Bu, yukarıdaki Q4_0 ile aynı tür değil; “Q4” ailesinin adını görünce bütün yöntemleri tek biçim saymamak için bir örnek. “Parametre sayısı × 4 ÷ 8” hesabı kaba bir başlangıç olabilir, kesin dosya boyutu değildir. [1]
Bu nedenle model sayfasındaki gerçek dosya boyutunu kontrol ediyorum. Nicemleme etiketinden tek başına yüzde kalite kaybı ya da hız kazancı çıkarmıyorum. Bunlar model, yöntem, donanım ve yapılan işe göre ayrıca incelenmesi gereken sonuçlar.
Diskteki boyut, çalışırken gereken bellek değil
Model dosyası indirilince diskte bir yer kaplıyor. Çalıştırınca bunun yanında sohbetin geçmişini tutan bellek ve hesap sırasında kullanılan ek alanlar da gerekiyor. Transformers belgeleri, önceki tokenların anahtar ve değerlerini saklayan KV önbelleğinin uzun metinlerde önemli bir bellek tüketicisi olabileceğini özellikle anlatıyor. Kullanılan mimari ve önbellek yöntemi bu hesabı değiştiriyor. [6]
O yüzden “dosya ekran kartı belleğinden küçük, kesin sığar” demiyorum. Aynı modelde daha uzun sohbet veya aynı anda daha çok istek de bellek ihtiyacını değiştirebilir. Bazı çalıştırıcılar modeli CPU ile GPU arasında paylaştırabiliyor; bu da ekran kartı belleğiyle sistem RAM'ini ayrı ayrı düşünmeyi gerektiriyor. Böyle bir paylaşımın mümkün olması, tamamen GPU'da çalışmakla aynı hızda olacağına kanıt değil. [3]
İndirmeden önce baktığım beş şey
- Çalıştırıcı: Uygulamam bu dosya biçimini, mimariyi ve nicemlemeyi destekliyor mu? Gerekli sürüm belirtilmiş mi?
- Köken: Dosyayı modelin geliştiricisi mi, başka bir dönüştürücü mü yayımlamış? Kaynak model ve sürümü yazıyor mu?
- Paketin tamamı: Bölünmüş ağırlıkların tüm parçaları, gerekli tokenizer ve yapılandırma dosyaları var mı? Görsel özellik kullanacaksam ayrıca ne gerekiyor?
- Bellek payı: Yalnız dosya boyutuna değil, hedef sohbet uzunluğuna ve uygulamanın bellek yönergesine de baktım mı?
- Tekrar bulunabilirlik: Depo adresini, tam dosya adını ve sürüm kimliğini kaydettim mi? Sağlanan SHA256 ile dosyanın aynı olduğunu kontrol edebilir miyim?
Bir dosyanın SHA256 değerinin eşleşmesi, eldeki dosyanın beklenen dosyayla aynı olduğuna dair denetimdir; kaynağın güvenilir veya modelin cevaplarının doğru olduğuna dair garanti değildir. Hugging Face indirme araçları da belirli bir sürüm kimliğiyle indirmeyi destekliyor. Böylece hareket eden bir “main” yerine, daha sonra tekrar bulunabilen bir dosya kümesinden söz edebiliyorum. [7]
Kısa cevap: önce uygulama, sonra dosya
Benim için seçim sırası şu: uygulama ve model desteği, doğru dosya kümesi, uygun sayısal gösterim, yeterli çalışma belleği. “GGUF mu, Q4 mü?” diye sormak yerine “bu uygulamanın desteklediği modelin hangi GGUF sürümünü indireceğim?” sorusu daha işe yarıyor. Çünkü biri kutunun biçimi, diğeri içindeki sayıların nasıl saklandığı.
Bu yazıdan bir hız ya da kalite sıralaması çıkmıyor. Buna karşılık indirmeden önce yanlış dosyaya, eksik pakete veya yalnız disk boyutuna bakarak verilmiş bir bellek kararına takılmamak için kullanılabilir bir kontrol sırası çıkıyor.
Tam dosya kaydı, yöntem ve sınırlar
12 Kasım 2026'da resmî belgeler ve Hugging Face model API'si okundu. Ağırlık indirilmedi, çıkarım yapılmadı, süre veya elektrik ölçülmedi. Q4_K açıklaması teknik biçim tablosundan; örnek depodaki Q4_0 boyutları ayrı kaynaktan alındı. Bunlar aynı nicemleme türü gibi karşılaştırılmadı.
Örnek depo sürümü: 807dfd9a6fadbf703207aac3bfb0b2b3040d077c. Depodaki kaynak sürüm kaydı: 2fc06364715b967f1860aea9cf38778875588b17. API'de bildirilen dosya boyutları ve SHA256 değerleri aşağıdaki indirilebilir kayıtta. Ağırlıklar indirilmediği için bu SHA256 değerleri yerelde yeniden hesaplanmış dosya doğrulamaları değil, sağlayıcının bildirdiği değerlerdir.
Kaynaklar
- Hugging Face Hub: GGUF ve nicemleme türleri.
- Safetensors resmî belgeleri.
- llama.cpp: desteklenen arka uçlar ve CPU/GPU paylaşımı.
- GGUF biçim tanımı: ağırlık türleri ve üst veri alanları.
- Örnek deponun sabit sürümdeki dosya listesi; kaynak sürüm kaydı.
- Transformers: KV önbelleği stratejileri ve bellek kullanımı.
- Hugging Face Hub: belirli sürümden dosya indirme.