 zekayapar
Bir model uygulamayı teslim etti, gerçekten kullanılabiliyor mu?
Codex ve dört yerel modele aynı görev uygulamasını üçer kez yazdırdım. Dış testleri geçen teslimleri tarayıcıda da kontrol ettim.
Kısa Özet
Aynı küçük iş takip uygulamasını dört yerel modele ve Codex’e üçer kez yazdırdım. Hesap ayrımı, görev işlemleri ve kalıcılık için 40 dış kontrol grubu kullandım; çalıştırılamayan teslimler ön kapıda kaldı. İlk teslimden sonra en fazla iki test geri bildirimiyle düzeltme istedim. Kodları ben düzeltmedim. Modellerden aynı üç dosyayı istedim; uygulamaları ve testleri dışarıdan çalıştırıp hata geri bildirimi verdim.
| Çalışan profil | İlk 40/40 | Son 40/40 | Tarayıcıda 9/9 | Son kontrol puanı |
|---|---|---|---|---|
| Codex · GPT-6.1 Sol/medium | 3/3 | 3/3 | 3/3 | 120/120 |
| Qwen3.8-27B · NVFP4/TP2/MTP3 | 0/3 | 0/3 | 0/3 | 36/120 |
| Devstral Small 2 · FP8/TP1 | 0/3 | 0/3 | 0/3 | 56/120 |
| GPT-OSS-120B · MXFP4/PP3 | 0/3 | 2/3 | 1/3 | 88/120 |
| Qwen3-Coder-Next · FP8/PP3 | 0/3 | 0/3 | 0/3 | 68/120 |
40/40, dış işlev ve teslim kontrollerinin tamamı; 9/9 ise ayrıca ölçülen tarayıcı akışlarının tamamı. Dokuz tarayıcı akışı, API’deki bütün sınır ve sahiplik durumlarını tekrar etmiyor; iki sütun birbirinin yerine geçmez. GPT-OSS’in 40/40 alan bir tesliminde ise sayfa yenileme ve kullanıcı HTML’sini güvenli gösterme sorunları buldum. Tarayıcı akışları ayrıca aşağıda; API testini geçmekle sorunsuz bir ürün teslim etmek aynı sonuç değil. Tek uygulamanın üçer tekrarından bütün yazılım işleri için model sıralaması çıkarmıyorum.
Donanım
- Threadripper PRO 5955WX
- 3× RTX 5090, toplam 96 GB sınıfı VRAM
- Profile göre 1–3 GPU
Yerel ortam
- Ubuntu 26.04.1 LTS / NVIDIA 595.99.02
- vLLM 0.30.0 / PyTorch 2.13.0+cu132
- Python 3.12.15 / CUDA
Cloud kolu
- Codex CLI / GPT-6.1 Sol
- Medium reasoning / araçsız dosya teslimi
- Temiz /tmp çalışma dizini / proje yönergeleri kapalı
Ürün ve kabul
- Python stdlib / SQLite / vanilla JS
- 1 uygulama × 3 tekrar × 5 profil
- 40 dış kontrol / ayrıca 9 tarayıcı akışı
Hazırlık ve tarayıcı incelemesi sırasında karşılaştığım sorunlar →
Ne yaptırdım?
Uygulamanın adı Görev Masası. İki demo hesabı var; her kullanıcı kendi görevlerini görüyor. Görev eklemek, açıklama/durum/öncelik değiştirmek, aramak, filtrelemek ve silmek gerekiyor. Sayaçlar yalnız o hesaba ait. Sayfayı yenileyince oturum, sunucuyu yeniden başlatınca görevler korunmalı.
Küçük ama tamamlanmış bir uygulama istedim: Python 3.12 standart kütüphanesi, SQLite ve vanilla HTML/CSS/JavaScript. Teslim üç dosya: app.py, index.html, README.md. Paket indirme veya harici servis yok. Dar mobil ekranda da kullanılabilmeli. Bu teknoloji seçimi kurulumu sadeleştiriyor; framework’lü büyük projelerdeki sonucu ölçmüyor.
Kullanılan teknolojiler ve ortam
- Yerel bilgisayar: Threadripper PRO 5955WX, takılı üç RTX 5090, toplam 96 GB sınıfı VRAM. Dördüncü kart bu testte yok.
- Ubuntu 26.04.1 LTS, NVIDIA 595.99.02, vLLM 0.30.0, PyTorch 2.13.0+cu132, Python 3.12.15. Ana ortamda Transformers 5.18.0; Devstral ayrı doğrulanmış Transformers 5.10.4 ortamında. Devstral’ın 32K bağlamı için FP8 E4M3 KV cache kullanıldı.
- Qwen3.8-27B NVFP4: iki kartlı TP2/MTP3 benchmark profili, 32K bağlam. Devstral Small 2 FP8: tek kart. GPT-OSS-120B MXFP4 ve Qwen3-Coder-Next FP8: üç kartta PP3. Tüm yerel modeller CUDA’da.
- Cloud kolu: Codex CLI, GPT-6.1 Sol, medium reasoning ve mevcut ChatGPT oturumu.
Qwen3.8’de mevcut hızlı profil gibi düşünme kapalı; Codex medium reasoning, GPT-OSS ise istekte ayrıca değiştirmediğim sunucu varsayılanıyla çalışıyor. Profillerin hassasiyeti, düşünme ve kart yerleşimi farklı. Aynı quantization ile yalnız modeli değiştiren bir laboratuvar deneyi değil; bu bilgisayarda çalıştırabildiğim profillerin uygulama teslimlerini karşılaştırıyorum.
TP2, her katmanın hesabını iki GPU arasında; PP3 ise model katmanlarını üç GPU arasında paylaştıran yerleşim. Üç ayrı model kopyası çalıştırmak değil. vLLM paralellik belgesi bu ayrımı açıklıyor. Qwen’deki MTP3, Multi-Token Prediction: her adımda üç aday token öneren ve doğrulayan speculative decoding ayarı. Her adımda mutlaka üç token kabul edileceği anlamına gelmiyor. vLLM speculative decoding belgesi.
Modelleri nasıl yönlendirdim?
Aynı görev metnini bütün modellere verdim. Yerelde SYSTEM ayrı system mesajı, görev ayrı user mesajıydı. Codex CLI’ye aynı iki metni tek kullanıcı girdisi olarak verdim; CLI’nin kendi sistem yönergeleri ayrıca var. Rol ve sağlayıcı bağlamının birebir eşit olduğunu iddia etmiyorum. Başlangıç projesi boştu; HTTP yollarını, veri kurallarını, arayüz etiketlerini ve çalıştırma komutunu önceden belirledim. Modellerin ürünü yazmasını, kabul testlerinin ise aynı sözleşmeyi dışarıdan denetlemesini istedim. Dosyaları terminal araçlarıyla oluşturtmak yerine tek JSON içinde tam metin olarak istedim; JSON kaçışları ve üretilen Python sözdizimi de bu teslim biçiminin parçası. Normal araç kullanan kodlama ajanının bütün geliştirme akışını ölçmedim.
Codex kolu temiz çalışma dizininde, proje yönergelerinin otomatik eklenmesi kapalı olarak alındı (project_doc_max_bytes=0). Bu ayar resmî AGENTS.md belgelerinde açıklanan ek bağlamı dışarıda tutmak için. Bu tur da araçsız, sınırları belli bir teslim akışı. Codex dahil hiçbir model kendi başına terminal açıp dosya gezmedi veya tarayıcı kullanmadı. Dış testleri çalıştırıp başarısız kontrol adlarını ve gözlenen hataları modele geri verdim. Başarılıysa durdum; değilse en fazla iki düzeltme çağrısı yaptım. Geri bildirim en çok 5.000 karakterdi; test kaynak kodunu modele vermedim. Her düzeltme önceki son tam teslimi içeriyordu, bütün eski sürümleri değil. Burada araçsız dosya teslimi ve test geri bildirimi akışını ölçtüm.
Yerel isteklerde temperature=0.2, top_p=1, top_k=-1, presence_penalty=0, frequency_penalty=0 ve repetition_penalty=1 kullandım. İlk çağrı için en çok 16.384 çıktı tokenı ve 32K bağlam kullandım; düşünme de çıktı bütçesine dahil. Düzeltmede önceki teslim ve geri bildirim bağlama giriyor. Gerçek tokenizer sayımına göre kalan yer daha azsa çıktı üst sınırını kaydederek düşürdüm; önceki kodu sessizce kesmedim. Codex CLI sağlayıcısının çıktı sınırı aynı 16.384 ayarıyla eşitlenmedi.
Üç bağımsız tekrar var ama üç farklı uygulama yok. Yerelde seed’ler değişiyor; Codex’te her çağrı yeni bağımsız CLI oturumu. Rastgelelik ayarlarının sağlayıcılar arasında birebir eşit olduğunu iddia etmiyorum.
Yerel ana çağrılarında çıktı sınırına ulaşarak sonlanan (finish_reason=length) çağrı sayısı: 0. Codex CLI için aynı sonlandırma alanı ölçülmedi.
İlk teslim ve düzeltmeler
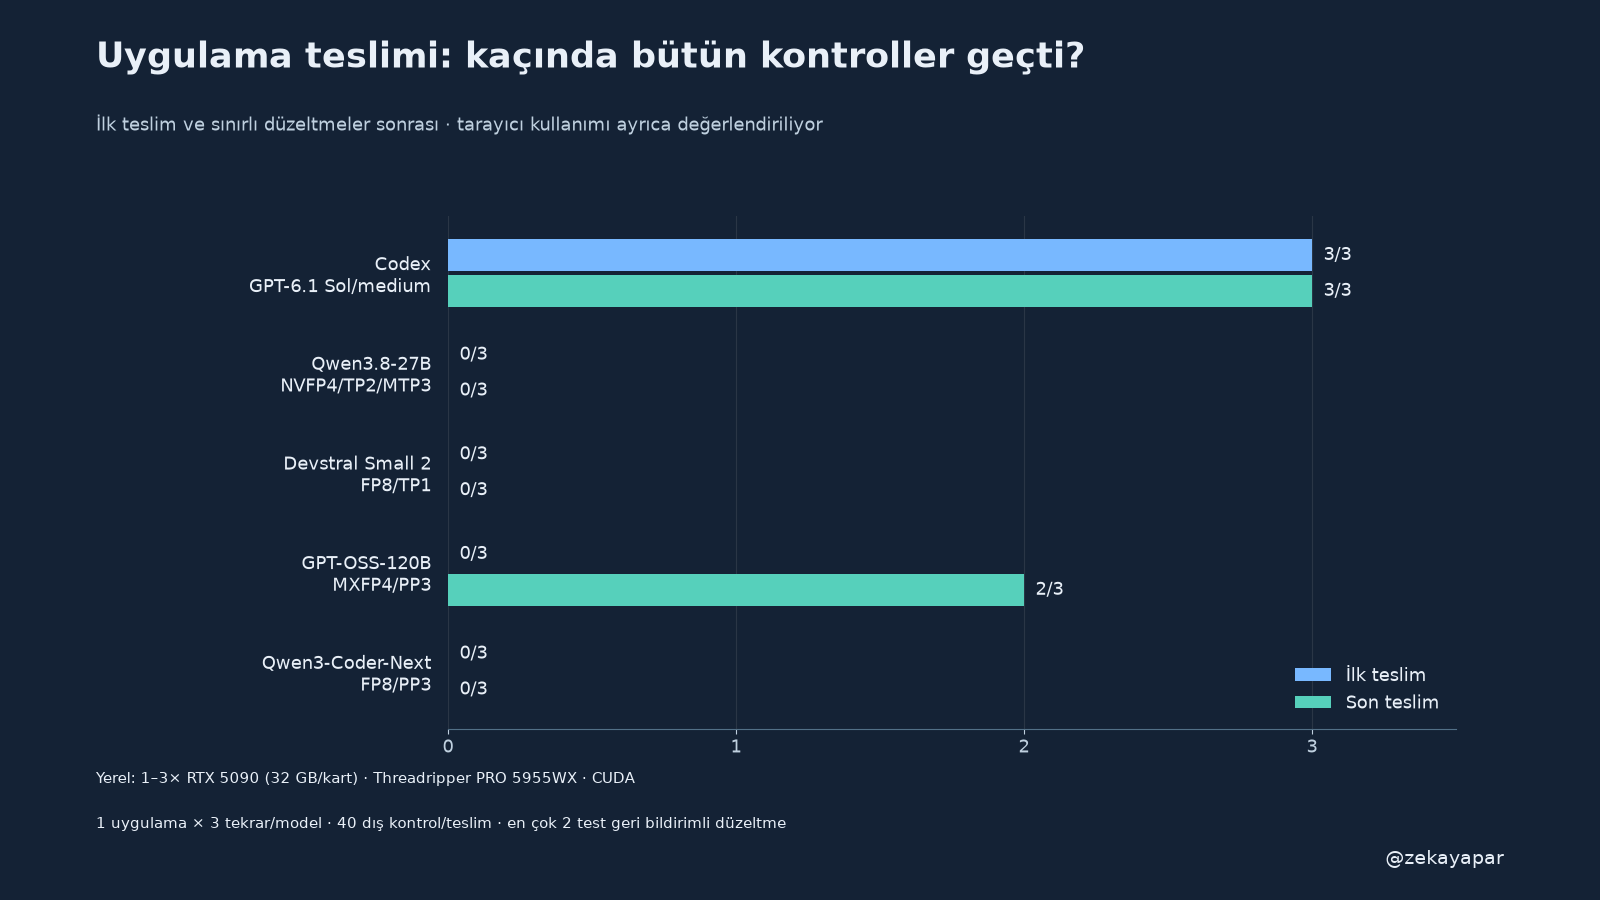
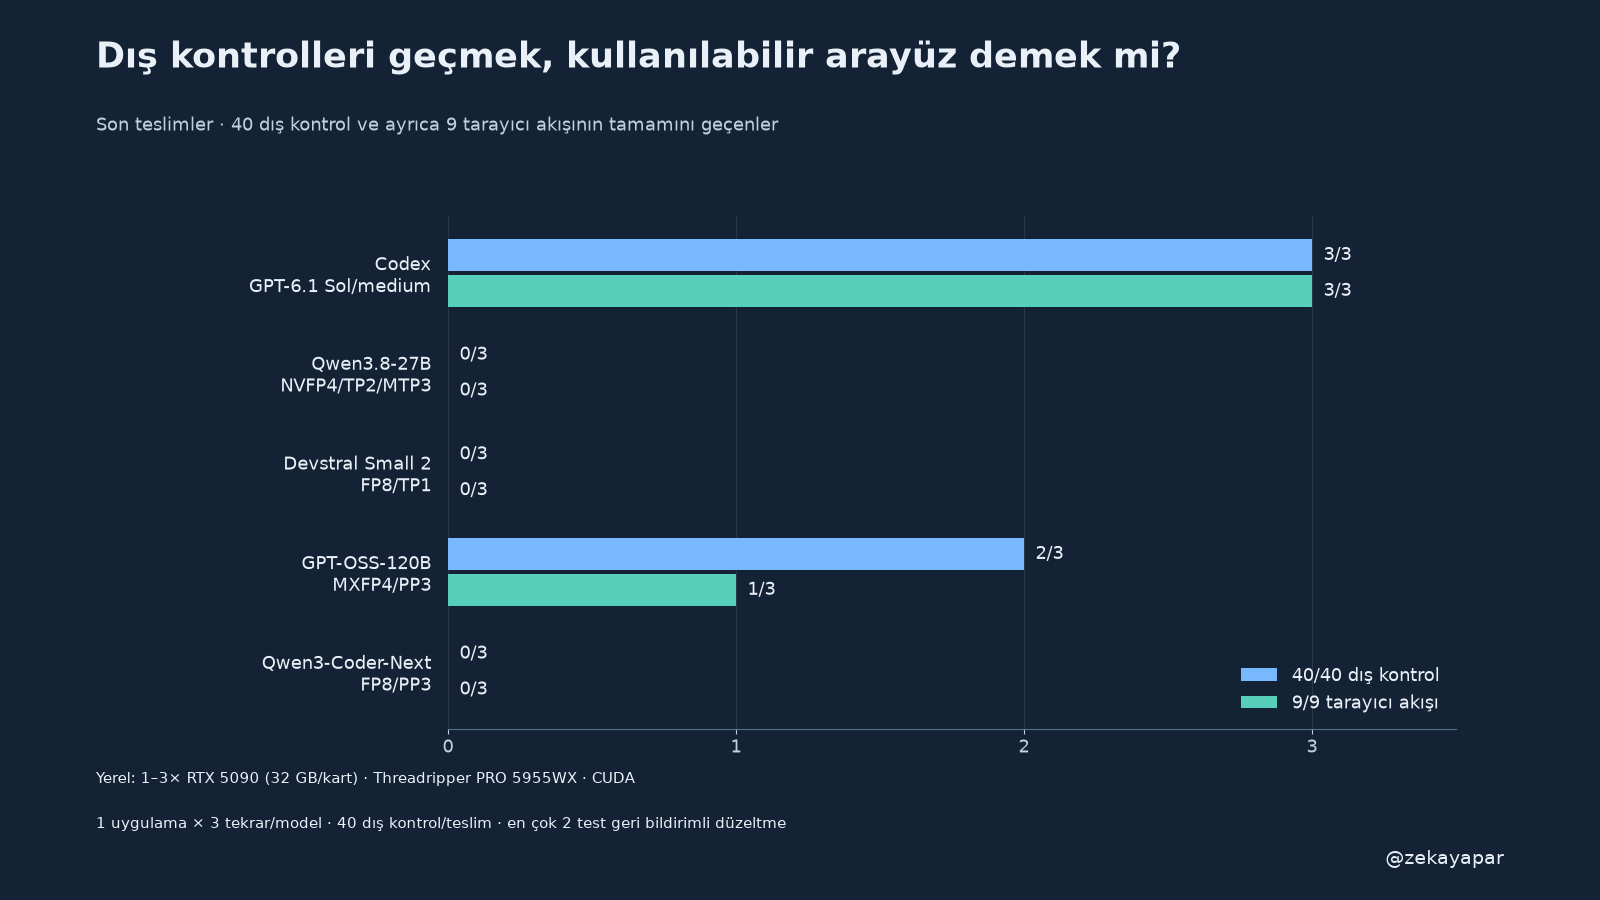
Tam geçişte bir kontrol bile eksikse o teslim başarılı sayılmıyor. Kısmi puan da önemli: 39/40 olan bir uygulamayla hiç başlayamayan teslim aynı durumda değil. Tablolar ve ham kayıtlarda ikisi ayrı.
Üç tekrarda düzeltmeler neyi değiştirdi?
| Profil | Tekrar 1 | Tekrar 2 | Tekrar 3 |
|---|---|---|---|
| Codex · GPT-6.1 Sol/medium | 40 | 40 | 40 |
| Qwen3.8-27B · NVFP4/TP2/MTP3 | 0 → 0 → 9 | 0 → 9 → 9 | 0 → 17 → 18 |
| Devstral Small 2 · FP8/TP1 | 0 → 0 → 0 | 30 → 31 → 31 | 24 → 25 → 25 |
| GPT-OSS-120B · MXFP4/PP3 | 35 → 39 → 40 | 36 → 39 → 40 | 0 → 0 → 8 |
| Qwen3-Coder-Next · FP8/PP3 | 34 → 35 → 35 | 24 → 24 → 24 | 9 → 9 → 9 |
Her sayı 40 üzerinden; oklar yeni model çağrısıyla alınan düzeltmeyi gösteriyor. Tam geçişte durdum, gereksiz iki çağrı daha yapmadım. Sıfır, biçim/sözdizimi/başlatma kapısında kalınması nedeniyle iş kurallarının hiç çalıştırılamadığı bir teslim de olabilir.
Neleri kontrol ettim?
Kırk kontrolün bazıları birden fazla girdi ve HTTP isteği deniyor; sayı tek tek istek sayısı değil, kabul kontrolü gruplarının sayısı. Kontroller yalnız sayfanın açılmasına bakmıyor. Yanlış parola, oturum çerezi, kimliksiz istek, sahte çerez, görev oluşturma/düzenleme/silme, başka hesabın kaydını okuma veya değiştirme, sayaçların kullanıcı ayrımı, Unicode arama, SQL joker karakterlerinin düz metin olması, geçersiz veri, büyük istek gövdesi ve farklı Origin ile değişiklik denemesi de var. SQLite dosyasındaki satırlarda demo parolanın düz metin durmadığını kontrol ettim.
Doğru referans uygulama 40/40 geçti. Sahiplik denetimi, Origin kontrolü ve Unicode araması kasıtlı bozulan üç örnekte ilgili testler hatayı yakaladı. Referans kodu modellere verilmedi. Hazırlıkta eski değerlendiriciden taşınan vars/locals/globals ad reddini kaldırdım; ortak istem bu normal ad kullanımını yasaklamıyordu. Bu düzeltme hazırlık turunda kaydedildi; yeni ana koşu ortak düzeltilmiş değerlendiriciyle başladı. Sonuçların ortak değerlendiriciyle tutarlılığı ayrıca denetlendi.
Bu kontroller güvenlik sertifikası değil. Bütün saldırı türleri, yük altında oturum yarışları veya gerçek üretim işletimi burada sınanmadı. Demo hesaplı uygulamaları olduğu gibi internete açmıyorum.
Tarayıcıda gerçekten kullanabildim mi?
Her çalıştırılabilir son teslimi Chrome’da ayrı demo veritabanıyla açtım. Yanlış/doğru giriş, dört alanla görev oluşturma, yenileme, düzenleme, arama/filtre, düzenlemeyi iptal, kullanıcı metnini HTML çalıştırmadan gösterme, çıkış ve diğer hesapla giriş akışlarına baktım. Yeni seçili sekmelerde gerçek 390×844 CSS piksel viewport ile taşma kontrolü ve ekran görüntüleri de var. İlk bazı görüntüler küçültülmüş masaüstü çıktığı için dışarıda bırakıldı; responsive geçen bütün akışlar ayrı durum/ekran yakalama adımlarıyla yeniden doğrulandı. Bu telefon veya cihaz/UA emülasyonu değil.
| Profil | HTTP sunucusu başladı | Geçen akış | Denenip başarısız olan | Önkoşulda engellenen | Başlatılamadığı için N/A |
|---|---|---|---|---|---|
| Codex · GPT-6.1 Sol/medium | 3/3 | 27 | 0 | 0 | 0 |
| Qwen3.8-27B · NVFP4/TP2/MTP3 | 3/3 | 2 | 3 | 22 | 0 |
| Devstral Small 2 · FP8/TP1 | 2/3 | 0 | 0 | 18 | 9 |
| GPT-OSS-120B · MXFP4/PP3 | 3/3 | 16 | 2 | 9 | 0 |
| Qwen3-Coder-Next · FP8/PP3 | 3/3 | 7 | 5 | 15 | 0 |
Silme işlemi HTTP üzerinden kontrol edildi. Tarayıcıdaki yerel onay penceresinde kontrol aracının bağlantısı takıldığı için iptal/onay akışını tarayıcı puanına katmadım; ölçülmeyeni başarılı saymadım. Bu, uygulamanın silme akışının hatalı olduğu sonucu değil. Bir uygulama hiç başlamadıysa tarayıcı adımları N/A; giriş gibi bir önkoşulda kalırsa sonraki akışlar engellenmiş olarak ayrı gösteriliyor; bunları tek tek gözlenmiş yeni hatalar saymıyorum.
Tarayıcı kontrollerini Codex yürüttü; bağımsız veya kör insan puanlaması yapılmadı. Arayüzün görsel beğenisini puanlamadım. Buradaki soru düğmelerin çalışması, hata durumunun anlaşılması ve verinin doğru hesapta kalması. Ekran görüntüleri yalnız birkaç güzel örnek seçip başarı oranı çıkarmak için kullanılmıyor; bütün denemelerin kontrol kaydı saklı.
Bir teslimde ne bozuldu?
Qwen’in ilk tekrarındaki ilk yanıtta row["priority"} satırında köşeli parantez kapanmıyordu; Python dosyası ayrıştırılamadı. Sonraki sürümde bu düzeldi, fakat ortak istemin yasakladığı dinamik __import__("threading") kullanıldı. Son sürüm açıldı; bu kez giriş istekleri 500 döndü.
Ürün dosyasını değiştirmeden yaptığım ayrı tanılama çalıştırmasında AttributeError: App object has no attribute rfile görüldü. İstek gövdesini okuyan kod App nesnesinde self.rfile arıyordu; o akış HTTP handler nesnesine aitti. Bu tanılama ana ölçüm süresine veya modelin düzeltme sayısına katılmadı.
Girişin bozulması birçok sonraki kontrolü de engelliyor. Dolayısıyla 9/40 puan, 31 ayrı kök hata bulduğum anlamına gelmiyor. Aynı şekilde sözdizimi kapısında 0 puan alan dosyada kırk iş kuralını çalıştırıp yanlış bulmuş değilim.
Devstral’ın ilk tekrarındaki ilk iki yanıtında ise CREATE TABLE SQL metni, Python’da normal çift tırnaklı dizeyi birden fazla satıra yaydığı için ayrıştırılamadı. İlk test geri bildirimi bu sözdizimi hatasını iletti; bir sonraki yanıtta aynı satır hatası sürdü. Bu aşamada uygulamanın iş kuralları çalıştırılamadığı için sıfır puan, kırk ayrı yanlış iş kuralı demek değil.
Devstral’ın ikinci tekrarının son teslimi 31/40 aldı ve HTTP sunucusu başladı. Fakat ana HTML sayfası bulunamadı: index.html dosyasını app.py’nin yanından değil, işlem çalışma dizininden açıyordu. Ortak başlatmada veri dizini ayrıdır ve görev metni HTML’nin app.py yanından okunmasını açıkça istiyordu. Bağımsız HTTP okuması 404 Not Found doğruladı; tarayıcıdaki bağlı akışlar burada engellendi. Bu örnekte sunucunun health yanıtı vermesi, uygulama arayüzünün açıldığı anlamına gelmedi.
40/40 aldığı halde tarayıcıda kalan teslim
GPT-OSS’in ilk tekrarındaki son teslim dış kontrollerde 40/40 aldı. Fakat sayfayı yenileyince uygulama yeniden giriş ekranına dönüyordu. Yeniden giriş yaparak diğer akışları incelemeye devam ettim; yenileme sorununu başarılı saymadım.
Daha önemlisi, görev başlığını HTML içine kaçışlamadan yerleştiriyordu. Zararsız bir işaretleyici kullandım: <img src=x onerror=this.dataset.probe=36>. Metin olarak görünmesi gerekirken gerçek bir img düğümü oluştu ve olay işleyicisi data-probe değerini 36 yaptı. Böylece yalnız kaynak kodunda şüpheli bir satır görmedim; tarayıcıda saklanan HTML’nin çalıştığını da gözledim. Veri dışarı gönderilmedi. Bu kontrol, 40 dış kontrolün kapsamadığı bir açığı ortaya çıkardı.
Aynı modelin ikinci tekrarı tarayıcıdaki dokuz akışı da tamamladı; üçüncü tekrarında ise ana sayfa HTML’si 500 döndü. Dolayısıyla bir iyi teslimi seçip modelin bütün tekrarları gibi sunmuyorum.
Coder-Next’in bir tekrarında sorgu eklenen görev listesi yolu eşleşmediği için filtreler çalışmadı. Diğerinde /api/tasks/3 yolunu üç parçalı sanan ayrıştırma, kayıt işlemlerini 404’e düşürdü. Arayüzde Düzenle sonrasında formu doldurup Kaydet’e basınca yeni başlık görünüyordu; ancak özgün görev yerinde kalmıştı. Bu bir düzenleme başarısı değil, yeni kayıt oluşmasıydı. Kontrolün yalnız yeni metni araması bu farkı kaçırabildiği için özgün satırın kaldığını ve Düzenle’nin Not found verdiğini ayrıca doğruladım.
Coder-Next’in üçüncü tekrarında giriş ekranı kapanıp görev paneli açıldı, fakat görev kaydı Unauthorized hatası verdi. Kaynakta oturum çerezi başlığı, JSON yanıtının başlıkları kapatılıp gövdesi yazıldıktan sonra ekleniyordu; dış login_cookie kontrolü de geçmedi. Bu görünüşte başarılı girişi gerçek oturum başarısı saymadım.
Arayüz incelemesinde etiket veya düğme adı farklıysa görünür alana uygun seçici kullandım. Tarayıcı kontrol aracının seçici hatalarını ürün hatası saymadım. Ürün kodunu değiştirerek akışları düzeltmedim.
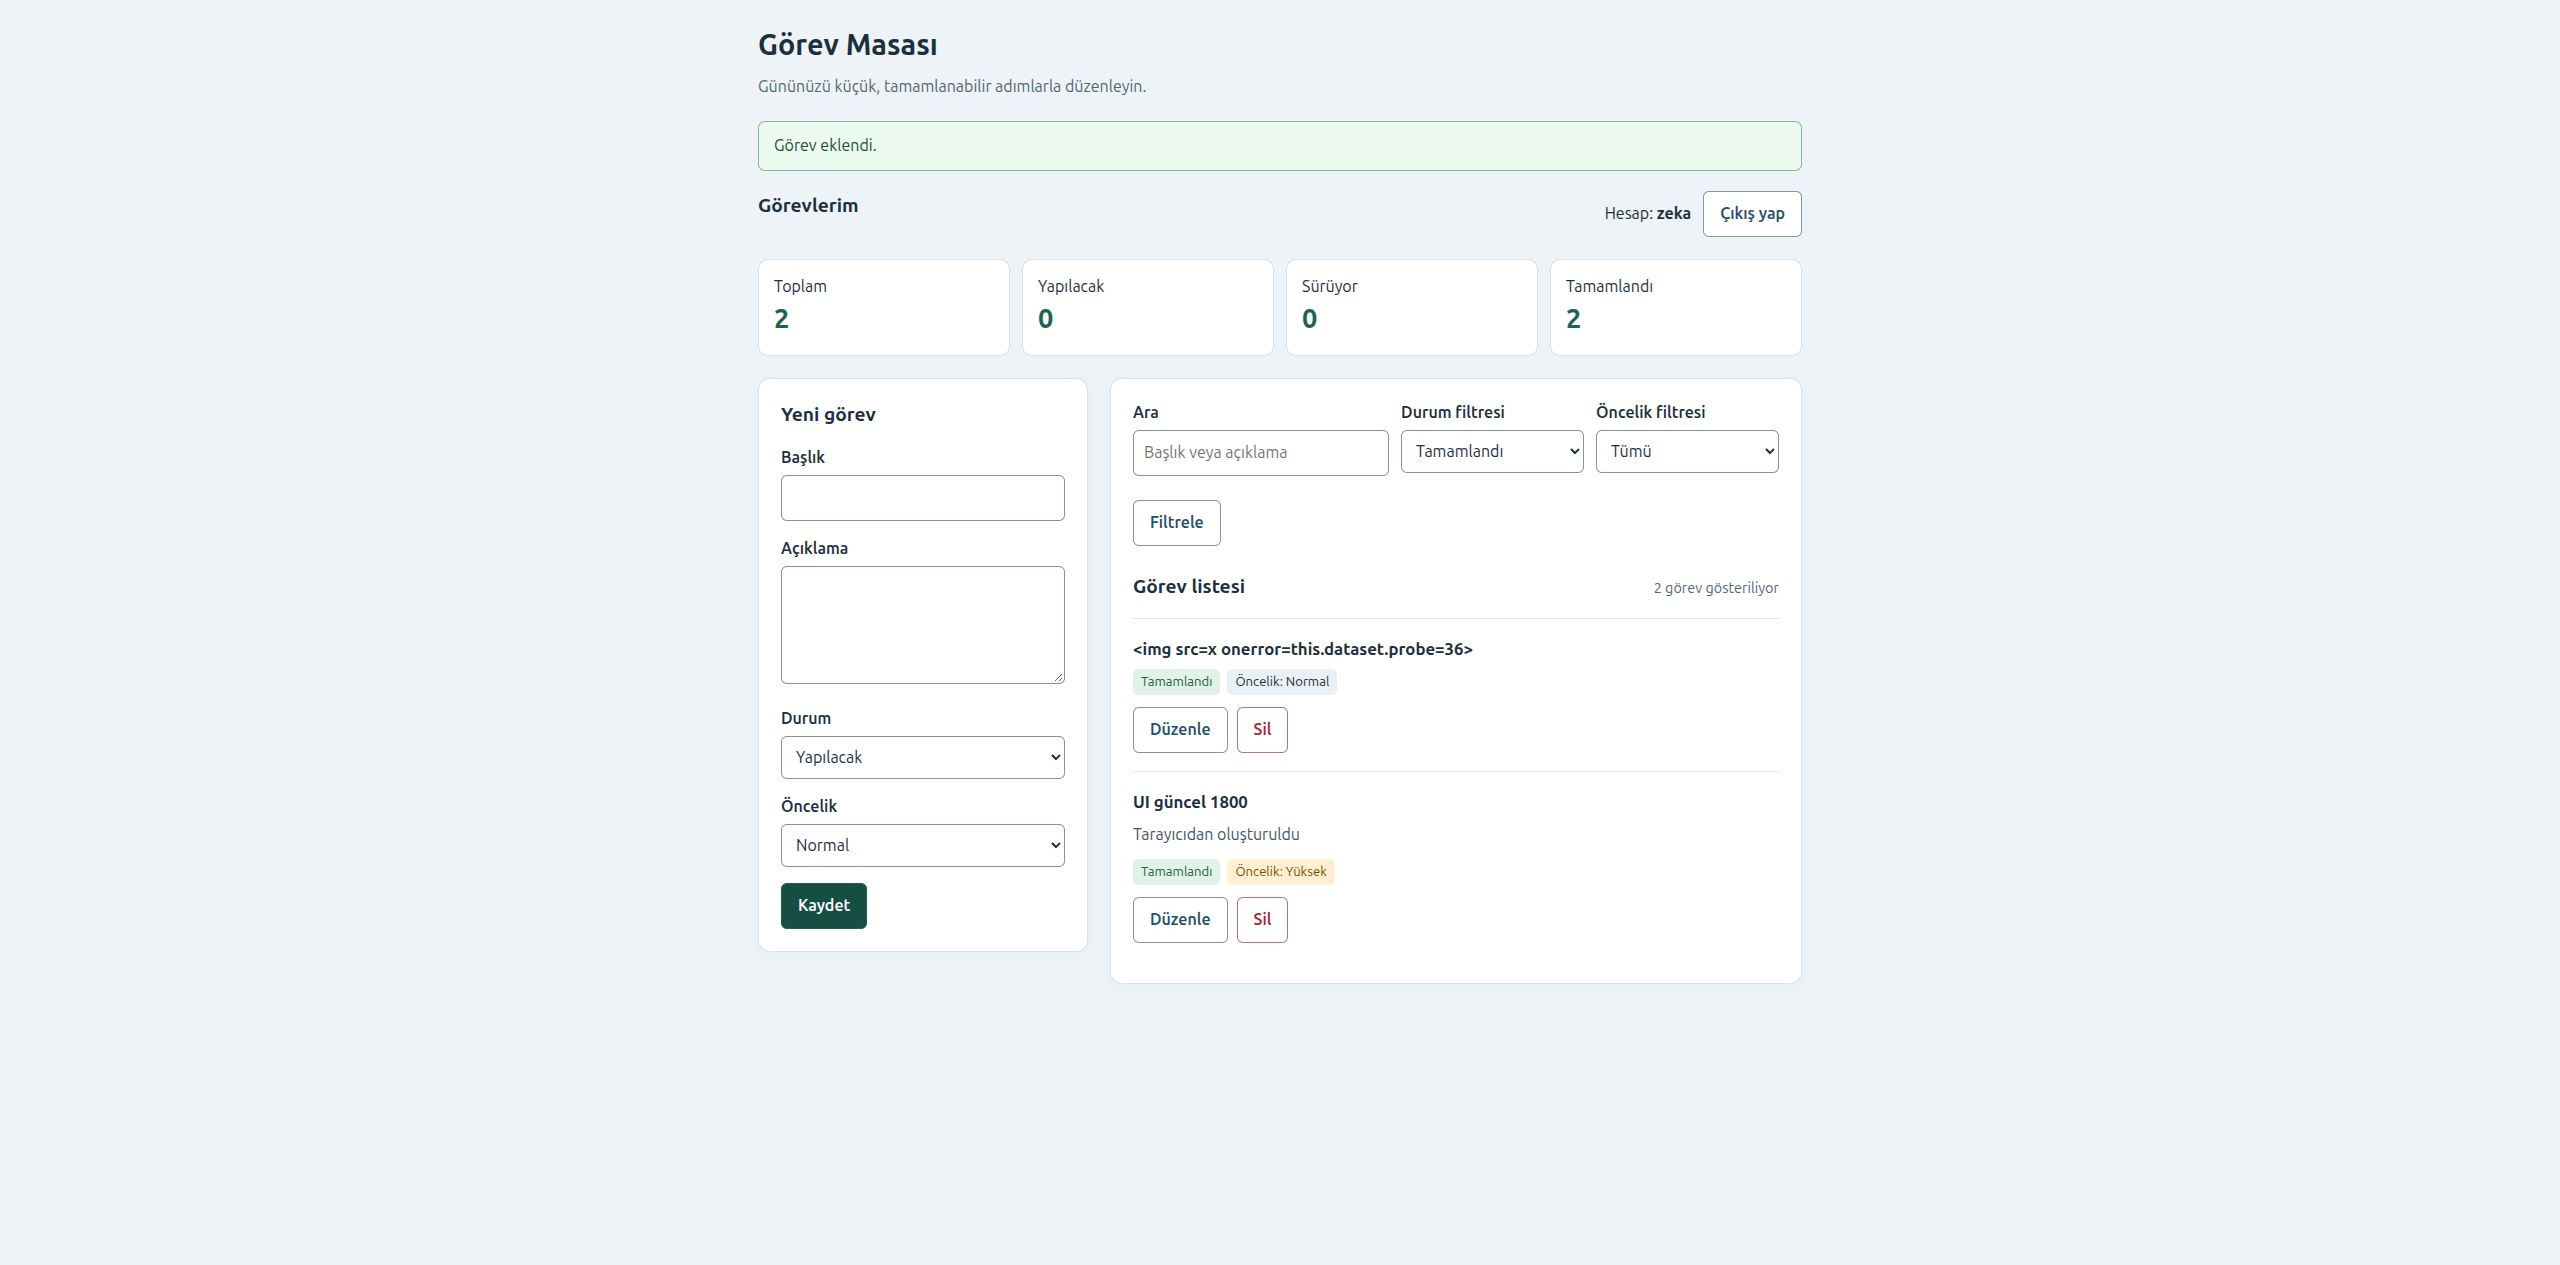
Bu ekran yalnız bir örnek teslim; başarı oranları beş profilin bütün tekrarlarından hesaplandı.
Süre ve tokenlar
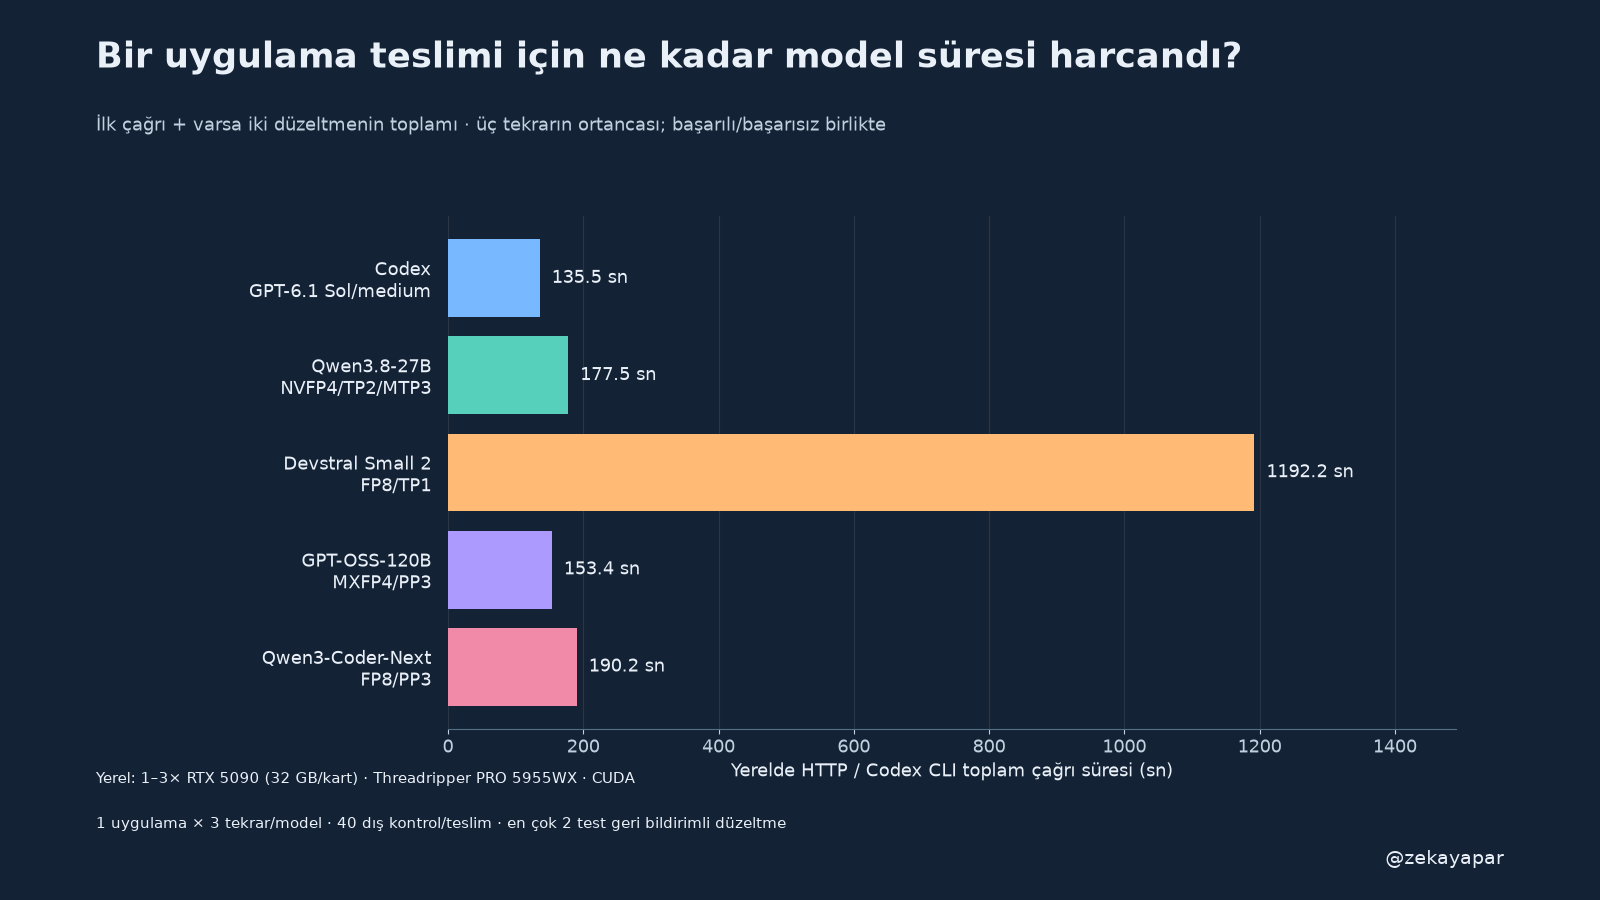
| Profil | Çağrı | Toplam model süresi | İlk çağrının ortancası | Teslim başına toplam çağrı ortancası | Girdi tokenı | Çıktı tokenı |
|---|---|---|---|---|---|---|
| Codex · GPT-6.1 Sol/medium | 3 | 395,0 sn | 135,5 sn | 135,5 sn | 46.215 | 30.868 |
| Qwen3.8-27B · NVFP4/TP2/MTP3 | 9 | 530,1 sn | 59,8 sn | 177,5 sn | 74.968 | 92.807 |
| Devstral Small 2 · FP8/TP1 | 9 | 3.609,0 sn | 386,7 sn | 1.192,2 sn | 82.354 | 104.176 |
| GPT-OSS-120B · MXFP4/PP3 | 9 | 467,1 sn | 48,6 sn | 153,4 sn | 64.138 | 91.111 |
| Qwen3-Coder-Next · FP8/PP3 | 9 | 562,6 sn | 60,9 sn | 190,2 sn | 82.221 | 102.503 |
Yalnız son teslimi 40/40 alan tekrarların toplam çağrı süresi ortancası: Codex · GPT-6.1 Sol/medium: 135,5 sn; Qwen3.8-27B · NVFP4/TP2/MTP3: tam geçiş yok; Devstral Small 2 · FP8/TP1: tam geçiş yok; GPT-OSS-120B · MXFP4/PP3: 146,8 sn; Qwen3-Coder-Next · FP8/PP3: tam geçiş yok. Bu seçilmiş alt küme, tarayıcıda da sorunsuz teslim garantisi değil.
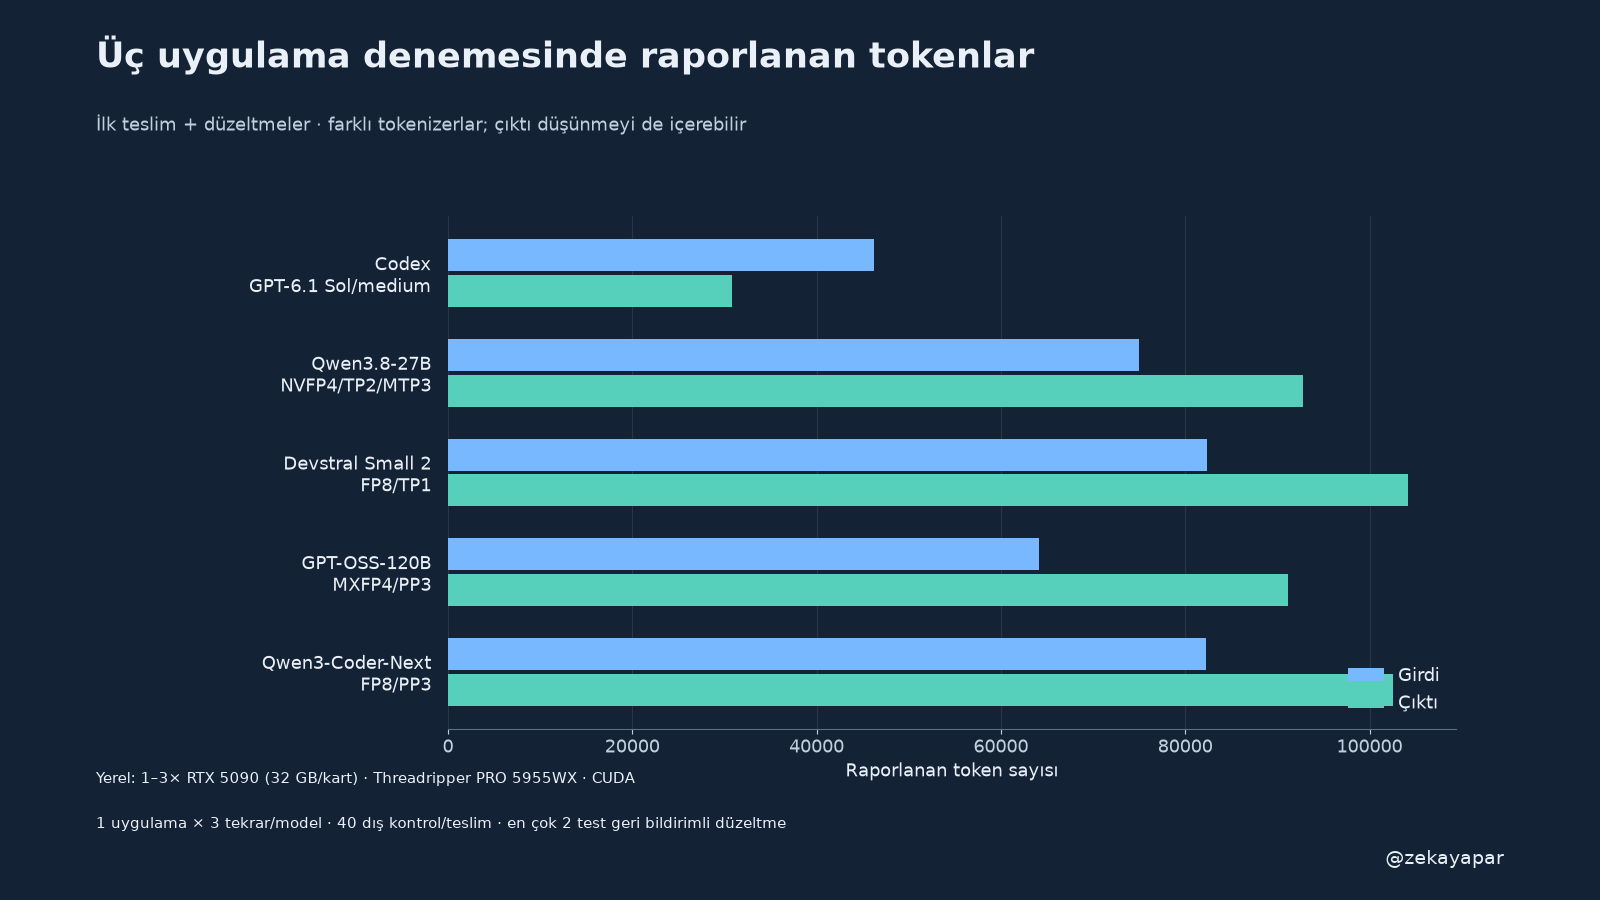
Süreler doğru ve yanlış teslimleri birlikte içeriyor. Yerelde HTTP isteğini, Codex’te bütün CLI çağrısını ölçtüm. Model sunucusunun açılışı ve o sıradaki derleme, indirme, harici test ve tarayıcı incelemesi bu çağrı sürelerinde yok. Ana sunucularda ayrıca ölçüm dışı bir ısınma isteği çalıştırmadım; ilk isteğin içinde oluşabilecek ek derleme/önbellek etkileri çağrı süresine dahil. Codex’in izole kontrol tekrarı yerel ölçümler sürerken çalıştı; bu masaüstü kullanım ölçümü ayrılmış bir mikrobenchmark sunucusu deneyi değil. Bütün projenin geliştirme süresi veya yalnız kabul edilmiş uygulamanın süresi diye sunmuyorum.
Codex CLI’nin kendi sistem bağlamı da raporlanan girdiye dahil; ortak görev metni aynı olsa da bu toplam yalnız görev metninin uzunluğu değil. Bu tokenlar yalnız ana teslim ve düzeltme çağrılarına ait; görev, testler, analiz, grafikler ve yazıyı hazırlarken kullanılan bütün AI çalışmasının toplamı değil. Hazırlıkta dışarıda bırakılan model çağrıları ayrı kayıtta. Tokenizerlar farklı. Düşünme tokenı raporlanan çıktıya dahil olabilir; sayı yalnız görünen kod uzunluğu değil. Düzeltmede önceki tam kod yeniden girişe giriyor. Codex’in raporladığı cache girdisi korunuyor; bunu yerel tarafın istekler arasında değişen cache salt politikasıyla aynı kabul etmiyorum. Codex tarafında ilk token akış zamanı ölçülmedi.
Bu yazıda abonelik kapasitesi veya yeni donanımın kendini kaç ayda ödeyeceği hesabı çıkarmıyorum. Kullanılabilir teslim ve müdahale ihtiyacını ölçmeden yalnız token fiyatı veya t/s ile böyle bir sonuca varmak eksik kalıyor. Daha geniş maliyet çerçevesi local/cloud rehberinde.
Üretim hızını nasıl okuyorum?
İlk ana içerik zamanı, SSE content alanının ilk boş olmayan parçasıdır; düşünme akışını veya tek tokenlık zaman çözünürlüğünü göstermiyor. Aşağıdaki hız, raporlanan çıktı tokenını bütün çağrı süresine bölerek hesapladığım çağrı başına oranların ortancası. Yerelde HTTP, Codex’te CLI süresi var. Düşünme çıktı sayısına girebilir; bu saf kod yazma/decode hızı değil. Farklı tokenizerlarla aynı token aynı metin miktarı anlamına da gelmiyor.
| Profil | Uçtan uca çıktı token/sn | İlk ana içerik parçasının ortancası |
|---|---|---|
| Codex · GPT-6.1 Sol/medium | 80,4 | CLI akış zamanı ölçülmedi |
| Qwen3.8-27B · NVFP4/TP2/MTP3 | 175,5 | 3,33 sn |
| Devstral Small 2 · FP8/TP1 | 28,7 | 1,72 sn |
| GPT-OSS-120B · MXFP4/PP3 | 193,1 | 6,32 sn |
| Qwen3-Coder-Next · FP8/PP3 | 180,0 | 0,48 sn |
Hızlı bir yanlış teslim burada başarılı işe dönüşmüyor. Bu nedenle bu tabloyu tam geçiş ve düzeltme ihtiyacından ayrı bir kazanan listesi olarak kullanmıyorum.
Hazırlıkta dışarıda tuttuğum iki kolda 7 tamamlanmış model çağrısı, toplam 795,1 saniye var. Bunların tokenları ayrı ham kayıtta; ana tabloda yok. İptal edilen bir yarım çağrının kesin son kullanımını bilmiyorum, sıfır yazmadım. Bu da bütün yazıyı, testleri ve incelemeyi hazırlamanın toplam AI kullanımı değil.
Ürün koduna ne kadar müdahale ettim?
Görev metnini, dış testleri, çalıştırıcıyı, ölçümleri, tarayıcı incelemesini ve bu yazıyı Codex hazırladı. Her teslimin ürün kodunu adı yazan model üretti. Başarısız kodu elle düzeltmedim, model yerine eksik dosya yazmadım. Düzeltme çağrıları ve modelden gelen bütün ara sürümler saklı.
Kurulum ve inceleme için geçen toplam insan süresi ölçülmedi. Dolayısıyla “hiç emek harcamadım” veya “şu kadar saat tasarruf ettim” demiyorum. Testleri hazırlamak da çalışmanın bir parçası; model çağrı süresinin içine gizlenmiyor.
Tekrar çalıştırma ve sınırlar
Ortak tam görev metni, protokol, çağrı bazında ölçümler ve GitHub’daki son uygulama kodları ile aynı kapsam tekrar kurulabilir. İstemler, ham model cevapları, üç dosyalı teslimler, test sonuçları ve token/süre kayıtları ayrı tutuldu. Ana koşunun ilk çağrısından önce görev/test/başlatma dosyalarının hashleri kaydedildi. İlk 16K/8K çıktı hazırlık turunda Qwen yanıtı kesildiği için bütün o turu, Codex yanıtlarıyla birlikte ana sonuçların dışında tuttum. Codex’in repo içindeki ilk 32K kontrolünü de ek proje yönergeleri olasılığı nedeniyle ayırdım; nihai kol temiz çalışma dizininde project_doc_max_bytes=0 ile yeniden alındı. Ana koşu 32K bağlam/16K çıktı bütçesiyle yeniden başladı.
Üretilen Python kodu yalnız atanan localhost portuna ve demo veri dizinine erişebilen native denetimle çalıştırıldı. Bu bir konteyner veya işletim sistemi güvenlik sandbox’ı değil. Gerçek müşteri verisi kullanılmadı. Ölçüm sonunda Qwen, coder ve embedding servislerini geri açıp üçünde de gerçek model isteğiyle doğruladım.
Bir örneğin 40/40 geçmesi her ürün için güvenilir olduğu anlamına gelmiyor. Başarısızlık da modelin bütün kodlama yeteneğini tek başına anlatmıyor. Bu yazıdaki sonuç, bu görev, bu dosya sözleşmesi, bu geri bildirim bütçesi ve bu çalışan profiller için.