 zekayapar
Perceptron: 1958’in öğrenen makinesini yazılımla yeniden kurdum
Perceptron’un öğrenme kuralını NumPy ile sıfırdan yazdım: sol-sağ kartları, 20 koşuda öğrenme, XOR sınırı ve Qwen’in verdiği yanlış ağırlıklar. Ham kayıtlarla.
Yazılım yeniden kuruluşu
- Python 3.14.4 · NumPy 2.5.4 · Linux · yalnız işlemci
- 20×20 kartlar · 20 tohum · 1.000 kartlık kontrol seti
- 400→1 piksel modeli ve 400→512→1 rastgele ara birimli sürüm
XOR ve bugünün modeli
- NumPy ile sigmoid + geri yayılım · 2 veya 4 gizli birim
- Qwen3.8-27B · yerel RTX 5090 · vLLM 0.30.0 (TP2)
- Sıcaklık 0 · düşünme kapalı · en çok 400 çıktı tokenı
1958’de bir bilgisayara biri solda, öbürü sağda işaretli kartlar gösteriliyor. Makine önce yanılıyor, sonra ayırmayı öğreniyor. Bu küçük gösteriden yürüyen, konuşan, hatta kendi varlığının farkında olan makineler beklenmiş. Ben de o büyük beklentinin arkasındaki küçük öğrenme kuralını kendi bilgisayarımda denemek istedim.
Bu, Yapay zekâ tarihi serimin 2. bölümü. Burada özgün IBM 704 programını veya Mark I donanımını çalıştırmıyorum. Kaynaklarda anlatılan fikirden yola çıkarak, öğrenme kuralını NumPy ile sıfırdan yazdığım bir yazılım yeniden kuruluşu yapıyorum. Önce kartları ayırttım, sonra XOR’da nerede durduğunu gördüm. Son olarak aynı soruyu bugünün yerel modeli Qwen’e sordum.
1958’de gösterilen şey neydi?
Frank Rosenblatt, Cornell’de psikoloji doktorası yapmış bir araştırmacıydı. Cornell Havacılık Laboratuvarı’nda gördüğünü tanıyabilen bir makinenin en az hangi parçalara ihtiyaç duyacağını araştırıyordu. 1957’de raporunu yazdı; kuramsal makalesi 1958’de Psychological Review dergisinde yayımlandı.
7 Temmuz 1958’de Washington’daki gösteri, sonradan yapılan fiziksel Perceptron ile değil, modelin IBM 704 üzerinde çalışan programıyla yapıldı. Ertesi gün New York Times’ta çıkan UPI haberinde Donanma’nın beklentileri sıralanıyordu: bir gün yürümek, konuşmak, görmek, yazmak, kendini çoğaltmak ve kendi varlığının farkında olmak. Bunlar makinenin o gün yaptığı işler değil, haberin aktardığı beklentilerdi.
Cornell’in tarihçesi, makinenin yaklaşık 50 denemeden sonra solda işaretli kartlarla sağda işaretli kartları ayırdığını anlatıyor. NYT haberinin gövdesinde soldaki işaretler için Q, sağdakiler için O basıldığı aktarılıyor. Haberin ilk paragrafını arşiv sayfasından okuyabildim; gövdesini ikincil yeniden basımlardan kontrol ettim. Özgün programın ayrıntıları elimde yok.
Mark I’in hafızası motorlarla değişiyordu
Gerçek Mark I Perceptron Haziran 1960’ta halka gösterildi. Kullanım kılavuzuna göre değiştirilmiş bir kameranın içinde 20×20 dizilmiş 400 ışık algılayıcısı vardı. Bu girişler 512 ara birime bağlanıyordu. Bağlantı düzeni için IBM 704’te yazılmış bir programla sözde rastgele kablolama üretilebiliyordu.
Benim en sevdiğim ayrıntı hafızası oldu: motorların çevirdiği potansiyometreler. Kılavuz, 512 potansiyometrenin konumlarının makinenin hafızasını oluşturduğunu söylüyor. Tam geri besleme geriliminde miller dakikada yaklaşık bir turun on altıda biri kadar dönüyordu. Bugün bir dizideki sayıyı değiştiriyorum; o makinede fiziksel bir parça hareket ediyordu.
1960 Donanma bülteni, tek bir yazı tipindeki 26 harfi hatasız tanıması için her harfin 40 kez gösterildiğini bildiriyor. Bu, aşağıda yaptığım sol-sağ kare deneyiyle aynı görev değil. Mark I bugün Smithsonian Amerikan Tarihi Müzesi koleksiyonunda.
Benim kuralım: yalnızca yanılınca değiştir
Kartlarımı 20×20 piksel yaptım. İçlerinde kenarı 3–6 piksel olan dolu bir kare var; sol ya da sağ yarıda, rastgele bir konumda duruyor. Bu boyutu Mark I’in gözünden aldım; 1958’deki kartların birebir kopyası olduğunu söylemiyorum.
En basit sürümde her pikselin bir ağırlığı var. Hepsini sıfırdan başlatıyorum. Ağırlıklı toplam ve sapma sıfırdan büyükse cevap sağ, değilse sol. Cevap doğruysa dokunmuyorum. Yanlışsa aktif piksellerin ağırlıklarını doğru yönün etiketi kadar değiştiriyorum; sapma da değişiyor. Solun etiketi −1, sağınki +1.
pred = 1 if int(w @ x + b) > 0 else -1
if pred != y:
    w += y * x
    b += y
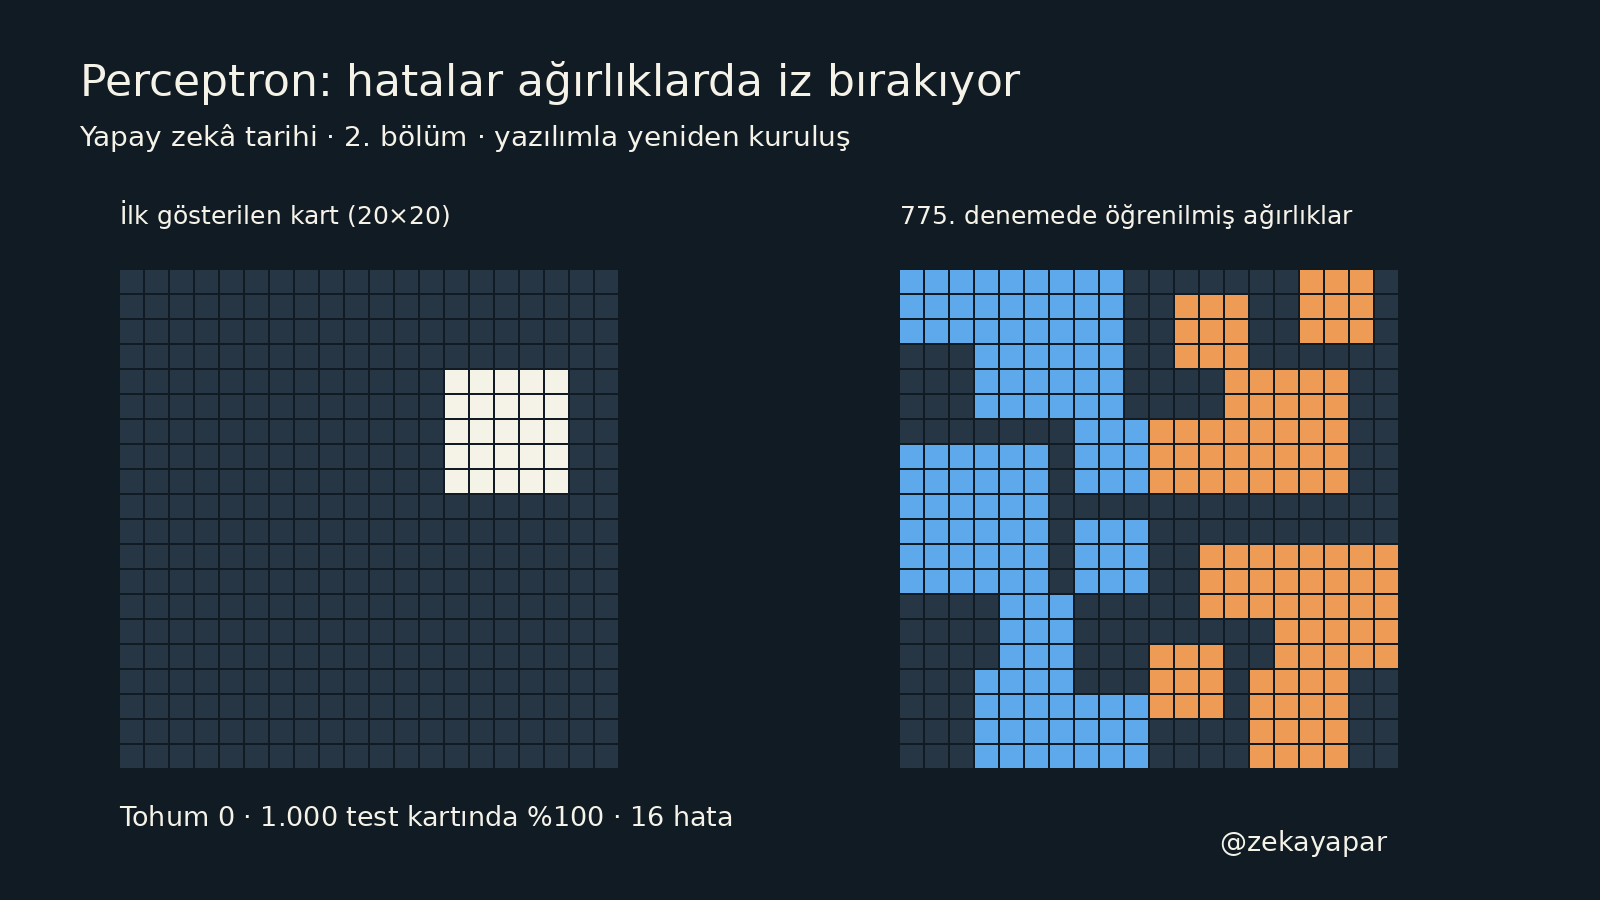
Öğrenmek her adımda daha iyi olmak değilmiş
Tohum 0 koşusunda altıncı karttan sonra ayrı tuttuğum 1.000 kartın %91,5’ini doğru biliyordu. Ama 30. karttaki düzeltmeden sonra doğruluk %66,9’a düştü. Kural son hatayı düzeltirken başka kartlardaki doğru kararları bozabiliyor. Videodaki “yüzde altmış yedinin altı” ifadesinin ham değeri bu.
775. denemede test setinin tamamını doğru sınıflandırdı. O noktaya kadar yaptığı hata 16’ydı. 775, gösterilen kart sayısı; 16, ağırlıkların değişmesine yol açan yanlış cevap sayısı. Aynı şey değiller.
Tek koşuyla yetinmedim. Aynı 1.000 kartlık ayrı test setini koruyup kart akışını 20 farklı tohumla tekrarladım. Ağırlıklar her seferinde sıfırdan başlıyor; piksel modelinde değişen başlangıç ağırlıkları değil, gösterilen kartların sırası ve içeriği.
| Ölçüt | 20 koşunun ortancası | En az – en çok |
|---|---|---|
| Testte %90 doğruluğa ilk erişim | 16 kart | 6 – 48 |
| Testte %95 doğruluğa ilk erişim | 44,5 kart | 14 – 118 |
| Testte %99 doğruluğa ilk erişim | 219 kart | 48 – 665 |
| Testte %100 doğruluğa ilk erişim | 731 kart | 78 – 2.496 |
| O noktaya kadar yapılan hata | 17,5 hata | 11 – 21 |
44,5 ile 50 bir eşleşme değil
%95 doğruluğa ulaşmanın ortancası 44,5 kart çıktı. Haberdeki 50’ye yakın görünmesi güzel bir hikâye olurdu. Ama buna aynı sonucun tekrarı diyemem: benim kartlarım başka, durdurma ölçütüm başka, 1958 programının bağlantılarını ve eğitim ayrıntılarını bilmiyorum.
Bunu görmek için iki ek sürüm denedim. Yalnızca biri solda, biri sağda işaretli iki sabit kartı sırayla gösterince 20 koşunun hepsinde üçüncü sunumdan sonra o iki kart doğru ayrıldı. Burada ölçülen iki kartı bilmek; yeni kartlara genellemek değil. Başka 1.000 karta bakınca aynı başarı çıkmıyor; ham kayıtta bu doğruluklar da var.
Diğer sürümde Mark I’den esinlenerek 400 girişin önüne değil, arkasına 512 sabit rastgele ara birim koydum; yalnız çıkış ağırlıkları öğreniyor. Her ara birim rastgele seçilen 10 pikselden +1/−1 bağlantı alıyor. Bu da donanımın birebir simülasyonu değil. %95’e ortanca 57 kartta ulaştı, fakat 20 koşunun 5’i 3.000 kartlık sınır içinde testte %100’e ulaşmadı. Süre sınırında ulaşamamak, hiçbir zaman ulaşamayacağının ispatı değil.
XOR’da sorun beklemekle çözülmüyor
XOR, iki giriş farklıysa 1, aynıysa 0 demek. Dört noktayı düzlemde işaretleyince 1’lerle 0’ları tek bir düz çizgiyle ayıramıyorsunuz. Ham iki girişe bakan tek doğrusal eşik biriminin sınırı bu; daha uzun eğitmek o sınırı kaldırmıyor.
| Giriş 1 | Giriş 2 | XOR |
|---|---|---|
| 0 | 0 | 0 |
| 0 | 1 | 1 |
| 1 | 0 | 1 |
| 1 | 1 | 0 |
Benim sabit örnek sıramla yaptığım 1.000 turluk eğitimde, her turun sonunda en fazla iki satır doğruydu. İkinci turdan sonra tur sonu ağırlıkları aynı duruma dönüyor. İki doğru, tek perceptronun XOR’daki matematiksel üst sınırı değil; bu eğitim akışının kaydı. Farklı bir çizgi dört noktanın üçünü ayırabilir, dördünü ayıramaz.
Araya öğrenen gizli katman ekleyip sigmoid birimler ve geri yayılım kullandığımda durum değişti. İki gizli birimli ağ 20 koşunun 16’sında, dört gizli birimli ağ 20 koşunun hepsinde XOR’u çözdü. Her koşuya 20.000 tur ve 0,5 öğrenme oranı verdim. Burada ayrı bir test seti yok: XOR’un dört satırının tamamı hem eğitim hem kontrolde kullanılıyor.
Minsky ve Papert’in 1969 tarihli Perceptrons kitabı bu tür modellerin sınırlarını inceledi. Bunu “bir kitap bütün sinir ağlarını bitirdi” diye anlatmak fazla düz olur. Mikel Olazaran’ın 1996 çalışması bu yaygın tarih anlatısına itiraz ediyor. Rosenblatt 1971’de, 43. doğum gününde bir tekne kazasında öldü; fikrinin sonraki yükselişini göremedi.
Qwen sınırı bildi, verdiği ağ çalışmadı
Aynı tabloyu kendi bilgisayarımda çalışan Qwen3.8-27B’ye sordum. İlk cevap doğruydu: XOR ve tek perceptronla öğrenilemez. Sonra iki gizli birimli, basamak fonksiyonlu bir ağın ağırlıklarını istedim. Verdiği sayıları değiştirmeden denediğimde ağ dört girişe de sıfır dedi. Yalnız iki satır doğruydu.
Qwen denemesi 1: tam istem ve değiştirilmemiş çıktı
Sistem istemi gönderilmedi. Sıcaklık 0, en çok 400 çıktı tokenı, düşünme kapalı. Model: Qwen/Qwen3.8-27B.
Bu ilk çağrının gerçek girdisi aşağıdaki tek kullanıcı mesajıydı. Kayıt betiği aynı mesaj listesine sonradan ekleme yaptığı için JSON’daki ilk istek.messages alanı sonraki konuşmayı da içeriyor. Bunu gizlemiyorum: betik ve ham kayıt indirilebilir. Sunucunun istem token sayıları ilk çağrıda 100, ikincide 297.
Aşağıdaki tabloda iki giriş ve bir çıkış var:
0 0 -> 0
0 1 -> 1
1 0 -> 1
1 1 -> 0
Bu hangi mantık işlemi? Tek bir perceptron (tek katmanlı doğrusal eşik birimi) bu tabloyu öğrenebilir mi? Kısa cevap ver, en fazla üç cümle.
Ham cevap
Bu tablo XOR (Özel Veya) mantık işlemini temsil eder. Tek bir perceptron, XOR problemini doğrusal olarak ayıramadığı için bu tabloyu öğrenemez.
İstekten tam cevaba geçen süre: 0,51 saniye. Bu bir donanım hız karşılaştırması değil.
Qwen denemesi 2: tam istem ve değiştirilmemiş çıktı
Sistem istemi gönderilmedi. Sıcaklık 0, en çok 400 çıktı tokenı, düşünme kapalı. Model: Qwen/Qwen3.8-27B.
İkinci çağrıda ilk soru ve cevap da bağlamda bulunuyordu. Giden konuşmanın tamamı:
user
Aşağıdaki tabloda iki giriş ve bir çıkış var:
0 0 -> 0
0 1 -> 1
1 0 -> 1
1 1 -> 0
Bu hangi mantık işlemi? Tek bir perceptron (tek katmanlı doğrusal eşik birimi) bu tabloyu öğrenebilir mi? Kısa cevap ver, en fazla üç cümle.
assistant
Bu tablo XOR (Özel Veya) mantık işlemini temsil eder. Tek bir perceptron, XOR problemini doğrusal olarak ayıramadığı için bu tabloyu öğrenemez.
user
Bu tabloyu (XOR) hesaplayan, iki gizli birimli bir ağ için ağırlık ve eşik değerleri ver. Bütün birimler basamak fonksiyonu kullansın: toplam > 0 ise 1, değilse 0. Gizli birim h = adım(w1*x1 + w2*x2 + b), çıkış = adım(v1*h1 + v2*h2 + c). Yalnızca JSON ver, açıklama yazma: {"gizli": [[w1, w2, b], [w1, w2, b]], "cikis": [v1, v2, c]}
Ham cevap
{"gizli": [[1, 1, -1], [1, 1, -2]], "cikis": [1, 1, -1.5]}
İstekten tam cevaba geçen süre: 0,46 saniye. Bu bir donanım hız karşılaştırması değil.
| Girişler | Beklenen | Qwen ağı |
|---|---|---|
| [0, 0] | 0 | 0 |
| [0, 1] | 1 | 0 |
| [1, 0] | 1 | 0 |
| [1, 1] | 0 | 0 |
İstemde açıkça “toplam > 0” demiştim. Qwen’in ilk gizli birimi ancak iki giriş de 1 olunca açılıyor, ikincisi bu dört girdide hiç açılmıyor. Çıkışın −1,5 sapması yüzünden tek açık gizli birim de yetmiyor. Doğru teşhisi koymak, doğru çalışan sayıları vermekle aynı şey değilmiş. Bu iki cevap tek bir konuşma; Qwen’in genel başarı oranını ölçmüyorum.
Bende kalan
ELIZA’da davranış kurallarını elle yazmıştım. Burada sol ve sağ kararını kodlamadan, örnekler ve yanlış cevaplardan çıkan bir ağırlık haritası gördüm. Ama öğrenme düz bir yükseliş değil; bir düzeltme başka kararları bozabiliyor. Görevin geometrisi de daha baştan neyin mümkün olduğunu belirliyor.
Sıradaki bölümde o gizli katmanların nasıl eğitildiğine geçiyorum: geri yayılım ve LeNet. 1989’da LeCun ve ekibi Buffalo postanesinden geçen gerçek mektuplardaki el yazısı rakamlarla çalışmıştı. Benim kuracağım deneyin verisini ve sınırlarını da ayrıca göstereceğim.
Yöntem, sınırlar, kaynaklar ve indirilebilir kayıtlar
Deney ortamı
{
  "python": "3.14.4 (main, Aug 20 2026, 10:41:58) [GCC 15.2.0]",
  "numpy": "2.5.4",
  "platform": "Linux-7.0.0-38-generic-x86_64-with-glibc2.43",
  "cpu": "x86_64",
  "komut": "perceptron.py",
  "tarih": "2026-10-26T02:12:27+0300",
  "gpu": "kullanilmadi (yalniz CPU, numpy)"
}
Bu ortam kaydı özgün deneyin kaydıdır; yazıyı üreten Python’un sürümü değildir. NumPy deneyleri yalnız işlemcide çalıştı. Qwen kaydı yerel RTX 5090 sunucusundan geldi; yanıtların sistem parmak izi vllm-0.30.0-tp2-cdcfd252. Kayıt dosyası model ağırlıklarının nicemleme biçimini doğrulamıyor; buradan bir nicemleme iddiası çıkarmıyorum.
Ölçütler ve tekrarlar
- Piksel ve rastgele ara birimli kart deneylerinde tohumlar 0–19; test seti tohum 999 ile üretilmiş sabit 1.000 kart. Eğitimde test kartlarıyla ağırlık güncellenmiyor, ama test doğruluğuna her sunumdan sonra bakılıyor. Bu bağımsız bir son değerlendirme değil, öğrenme eğrisini izlediğim kontrol seti.
- “Öğrendi”, bu sonlu kontrol setinde ilk kez %100 görülen sunum demek; olası bütün kartlarda ispat veya kalıcı %100 garantisi değil. Azami 3.000 sunum var. İki sabit kart deneyinin başarı ölçütü yalnız o iki kart.
- Mark I benzeri sürümde giriş–ara katman sabit ve rastgele; geri yayılımla eğitilen XOR ağıyla karıştırılmamalı. Ara birim etkinleşme eşiği toplam ≥ 1; çıkış eşiği toplam > 0.
- XOR tek perceptronu 1.000 tur; gizli katmanlı sigmoid ağlar 20 tohum × 20.000 tur, öğrenme oranı 0,5, karar eşiği 0,5. XOR burada genelleme deneyi değil.
- Qwen’e iki ardışık istek gitti; sıcaklık 0 olsa da bunlar modelin genel güvenilirliğini temsil eden bir istatistik değil. Süreler hazır sunucuda istek–tam cevap aralığı; model yükleme süresi değil.
- Mark I’in donanımı, 1958 programı veya tarihi çalışma hızı yeniden üretilmedi. 44,5 ile 50 arasında deneysel eşdeğerlik yok.
- Grafik kayıttan çizildi. Videodaki üretilmiş tarih sahneleri temsilî canlandırma (yerel modeller: Qwen-Image 2.1 + Wan2.2); gerçek arşiv görüntüsü diye sunulmuyor.
Kaynaklar
- UPI / New York Times, 8 Temmuz 1958: New Navy Device Learns by Doing (arşiv ilk paragrafı; gövde için yukarıdaki erişim notu)
- Frank Rosenblatt (1958), The perceptron: A probabilistic model for information storage and organization in the brain, Psychological Review 65(6), 386–408
- Hay, Lynch ve Smith (1960), Mark I Perceptron Operators’ Manual, özellikle A.1, A.3 ve A.10
- ONR Digital Computer Newsletter, Temmuz 1960, Cilt 12 Sayı 3: Mark I gösterisi ve harf deneyi
- Smithsonian NMAH: Electronic Neural Network, Mark I Perceptron, 1987.0819.01
- Cornell Chronicle, 25 Eylül 2019: Professor’s perceptron paved the way for AI — 60 years too soon
- Cornell Faculty Memorial Statement: Frank Rosenblatt
- Marvin Minsky ve Seymour Papert (1969), Perceptrons
- Mikel Olazaran (1996), A Sociological Study of the Official History of the Perceptrons Controversy
- Yann LeCun ve diğerleri (1989), Handwritten Digit Recognition with a Back-Propagation Network
İndir
JSON dosyaları özgün deney kayıtlarıyla byte düzeyinde aynı. Kodları da ekledim; yeniden çalıştırmak eski sonuç dosyalarının üzerine yazabilir, ayrı bir dizinde deneyin. Qwen betiği yerel bir model sunucusu gerektirir.