 zekayapar
Qwen ve Devstral’a aynı uygulamayı yazdırdım
Deney Defteri: aynı iki RTX 5090 ve FP8 profillerinde üçer teslim, API ve arayüz testleri, token tüketimi ve süreler.
Modeller ve inference
- Qwen3.8-27B · FP8
- Devstral Small 2 24B · FP8
- 2× RTX 5090 · kart başına 32 GB
- vLLM 0.30.0 · FlashInfer
- TP2 · BF16 KV · MTP kapalı
- 32K bağlam · 8.000 çıktı sınırı
Uygulama ve test
- Python 3.12.15 · SQLite
- HTML · CSS · JavaScript
- Transformers 5.10.4
- mistral_common 1.12.0
- Chrome · HTTP API testleri
Küçük görevlerden aynı uygulamaya
Önceki karşılaştırmada Qwen ve Devstral’a üç küçük kod görevi vermiştim. Bu kez ikisinden de aynı uygulamayı baştan sona yazmasını istedim: Deney Defteri. Deney adı, model, etiketler, girdi/çıktı tokenı, süre ve not tutan; tarayıcıdan ekleme, düzenleme, silme, filtreleme ve CSV indirme sunan küçük bir Python + SQLite uygulaması.
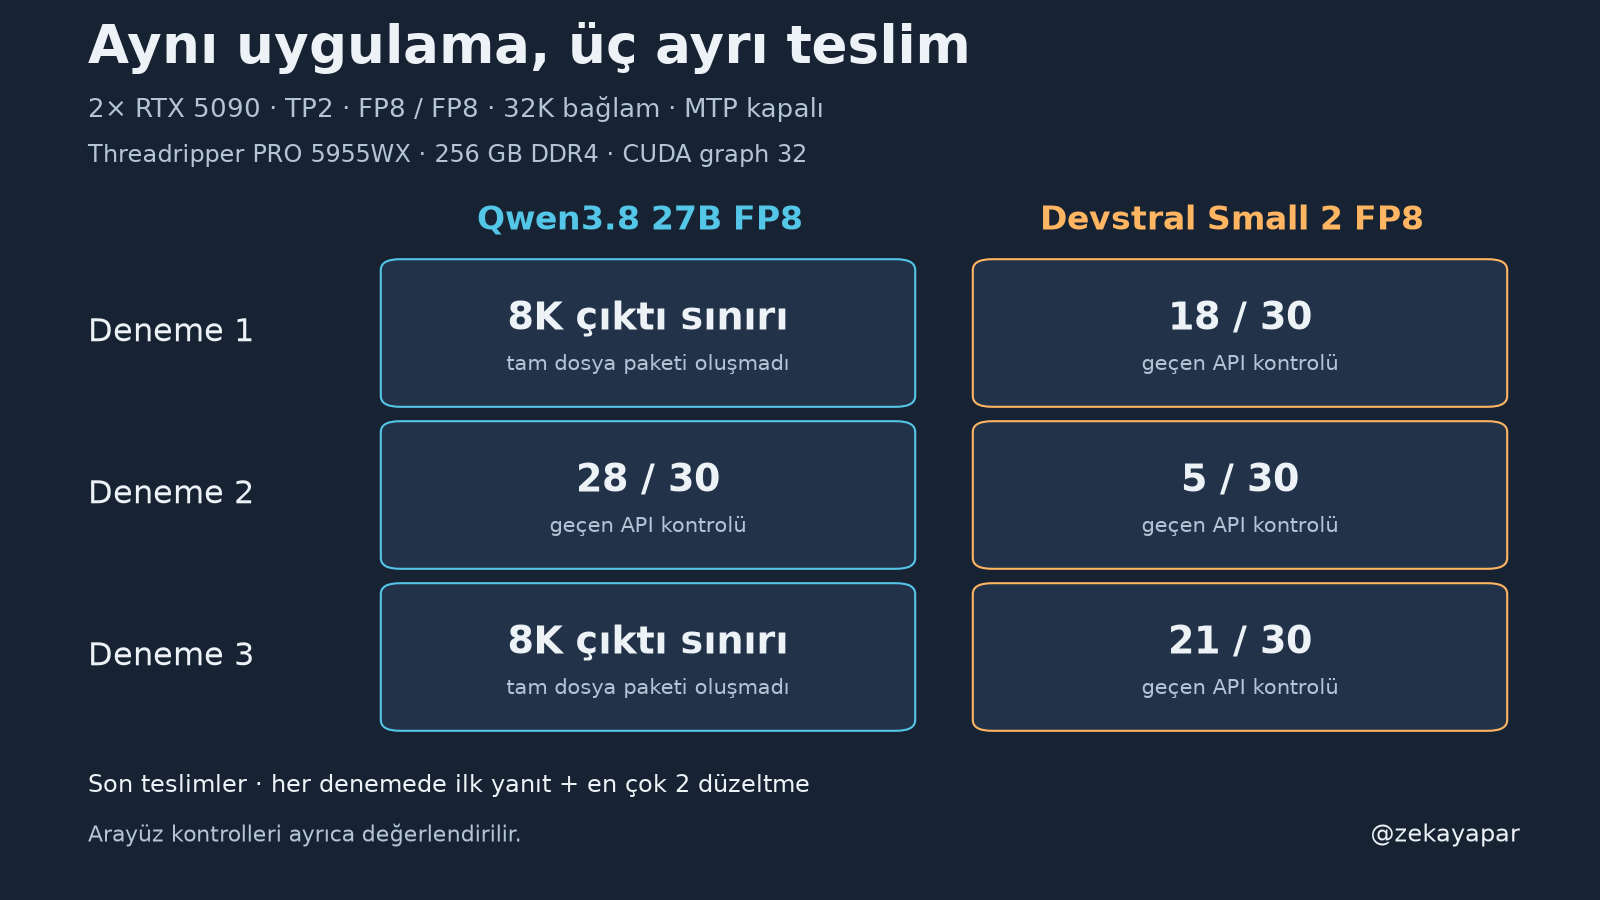
Her modele üç bağımsız deneme verdim. Sonuçta iki model de üç teslimin hiçbirinde 30 API kontrolünün tamamını geçemedi. Sayfanın açılması ve kayıt eklenmesi, uygulamanın tamamlandığı anlamına gelmedi.
Aynı koşullarda neyi sabitledim?
İki model sırayla aynı fiziksel GPU0 ve GPU1 üzerinde, 2× RTX 5090 32 GB ile TP2 çalıştı. Threadripper PRO 5955WX ve 256 GB DDR4 RAM kullandım. Üçüncü GPU karşılaştırmaya katılmadı. Bu kez Qwen3.8 27B ve Devstral Small 2 24B için de resmî FP8 ağırlıkları kullandım; önceki yazıdaki Qwen NVFP4 profiliyle süreleri birleştirmedim.
32K toplam bağlam limiti, çağrı başına en çok 8.000 çıktı tokenı, tek aktif istek, 1.024 batch tokenı, BF16 KV, FlashInfer ve CUDA graph 32 ayarları ortaktı. MTP kapalıydı. Temperature 0,2; top_p 1; top_k -1 ve tekrar cezası 1 olarak sabitlendi. Modeller kendi doğru sohbet şablonlarını kullandı; Qwen thinking kapalıydı. FP8 etiketi uygulamaları özdeş yapmıyor: Qwen dinamik, 128×128 bloklu; Devstral statik aktivasyon quantization kullanıyor. Mimari, parametre sayısı ve tokenizer farkı da sürüyor.
Teslim ve düzeltme bütçesi
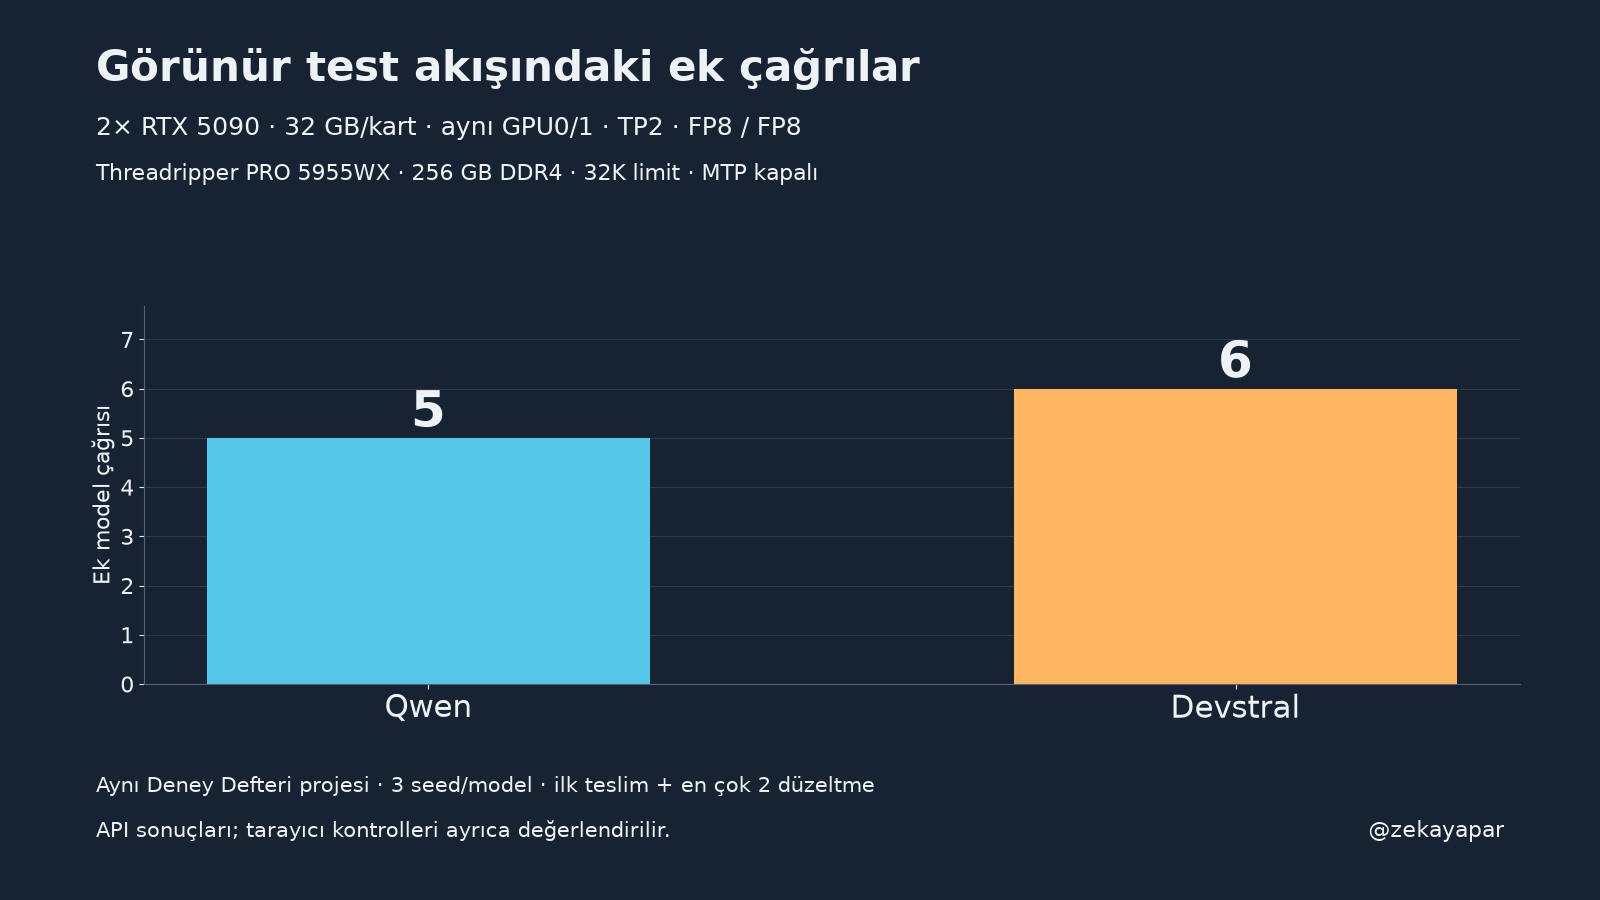
Aynı brief, aynı dosya sözleşmesi ve aynı JSON şemasıyla app.py ve index.html dosyalarını istedim. Ürün kodunu ilgili model yazdı; kaynakları elle düzeltmedim. Her denemede ilk yanıtın ardından en fazla iki ek çağrı vardı. Düzeltmede model kendi yanıtını ve yalnız ortak basit çalışma testinin hatasını gördü. Modeller birbirinin çıktısını görmedi.
Basit test sağlık yanıtı, HTML, kayıt ekleme, okuma, güncelleme ve silmeyi kontrol etti. Geçerse üretim durdu. Ayrı 30 kabul kontrolü ve tarayıcı gözlemleri modele geri verilmedi, ek çağrı kararını etkilemedi. Bu yüzden aşağıdaki düzeltme sayısı, bütün hataları giderme maliyeti değil; bu sabit akışta yapılan ek çağrı sayısı.
Son teslimler nerede kaldı?
Qwen’in birinci ve üçüncü denemeleri 8.000 çıktı tokenı sınırında kesildi; iki kaynak dosyasını taşıyan JSON paketi tamamlanmadı. Bu teslimlerde uygulama/API değerlendirmesi başlayamadı. İkinci deneme bir düzeltmeden sonra basit testi geçti ve 30 ayrıntılı API kontrolünün 28’ini geçti. Eksik isteğe bağlı alanların varsayılanları ve Unicode/filtre davranışı testte kaldı.
Devstral üç final teslimde de tamamlanmış dosya paketi üretti ve uygulamalar başladı. Son API sonuçları sırasıyla 18/30, 5/30 ve 21/30 oldu. Tek kayıt endpointinin beklenen nesne yerine liste döndürmesi, HTTP sözleşmesi, sayı/tür doğrulaması ve dışa aktarma gibi farklı eksikler vardı. Üçünde de basit test geçmedi; iki düzeltme hakkı kullanıldı.
İlk teslimde de iki tarafta tam API geçişi 0/3’tü. Qwen’in ilk üç yanıtı API kontrollerine ulaşamadı; Devstral’ın ilk sonuçları 18/30, 5/30 ve başlatma hatasıydı. Sonuçları tek bir toplam puanda sıralamıyorum: bir tarafta testleri hiç çalıştırılmayan iki teslim varken 28 ve 44 toplamını doğrudan kod kalitesi karşılaştırması gibi okumak yanıltıcı olur.
Gerçek tarayıcıda durum
Başlatılabilen dört final uygulamayı Chrome’da ayrıca açtım. Her biri için sekiz kontrol grubu kullandım: Türkçe form/liste, ekleme, düzenleme, HTML deneme metninin düz yazı kalması, birleşik filtre ve CSV, negatif giriş, onaylı silme/yeniden başlatma ve 400 piksel genişlikte kullanım. Bu manuel inceleme model sürelerinin dışında.
Qwen’in ikinci tesliminde ekleme, düzenleme ve yeniden başlatma sonrası kalıcılık çalıştı. Var olan kayda uygulanan birleşik filtre boş sonuç verdi; CSV de yalnız başlık satırı içerdi. 400 pikselde sayfa genişliği 599 piksele taştı. Sekiz grubun altısı geçti, ikisi kaldı.
Devstral’ın ilk iki tesliminde ekleme çalışırken düzenleme çalışmadı. İkinci teslimde düzenleme kaydı yüklenemediği için kullanılabilir silme akışı da tamamlanamadı. Üçüncü teslimde ekleme, düzenleme, onaylı silme ve restart sonrası kalıcılık çalıştı. Üçü de dar ekranda yatay taştı: sırasıyla 686, 626 ve 577 piksel.
Devstral’ın üç tesliminde birleşik filtre doğru tek kaydı gösterdi; CSV düğmesinin açtığı adresi Chrome ERR_BLOCKED_BY_CLIENT ile engelledi. Bu engeli aşmadım ve tarayıcı CSV indirmesini başarılı saymadım. Uygulamanın API dışa aktarma davranışı ayrı otomatik testlerde değerlendirildi; tarayıcı engeli tek başına uygulama hatasının kanıtı değil. Devstral için kontrol grupları sırasıyla 5 geçen/2 kalan/1 engellenen, 4/3/1 ve 6/1/1 oldu.
Düzenlemenin çalışmadığı iki arayüzde filtreyi bağımsız inceleyebilmek için aynı güncellenmiş test kaydını ayrıca ekledim; bu hazırlık farkı gözlem kaydında tutuldu. Negatif girişte satır artmadı; ikinci Devstral tesliminin hata mesajı kullanıcı dostu doğrulama yerine teknik JSON ayrıştırma hatasıydı. HTML deneme metni dört arayüzde de düz yazı kaldı. Bunlar sınırlı işlev gözlemleri; güvenlik sertifikası veya geniş kullanıcı testi değil.
Token tüketimi
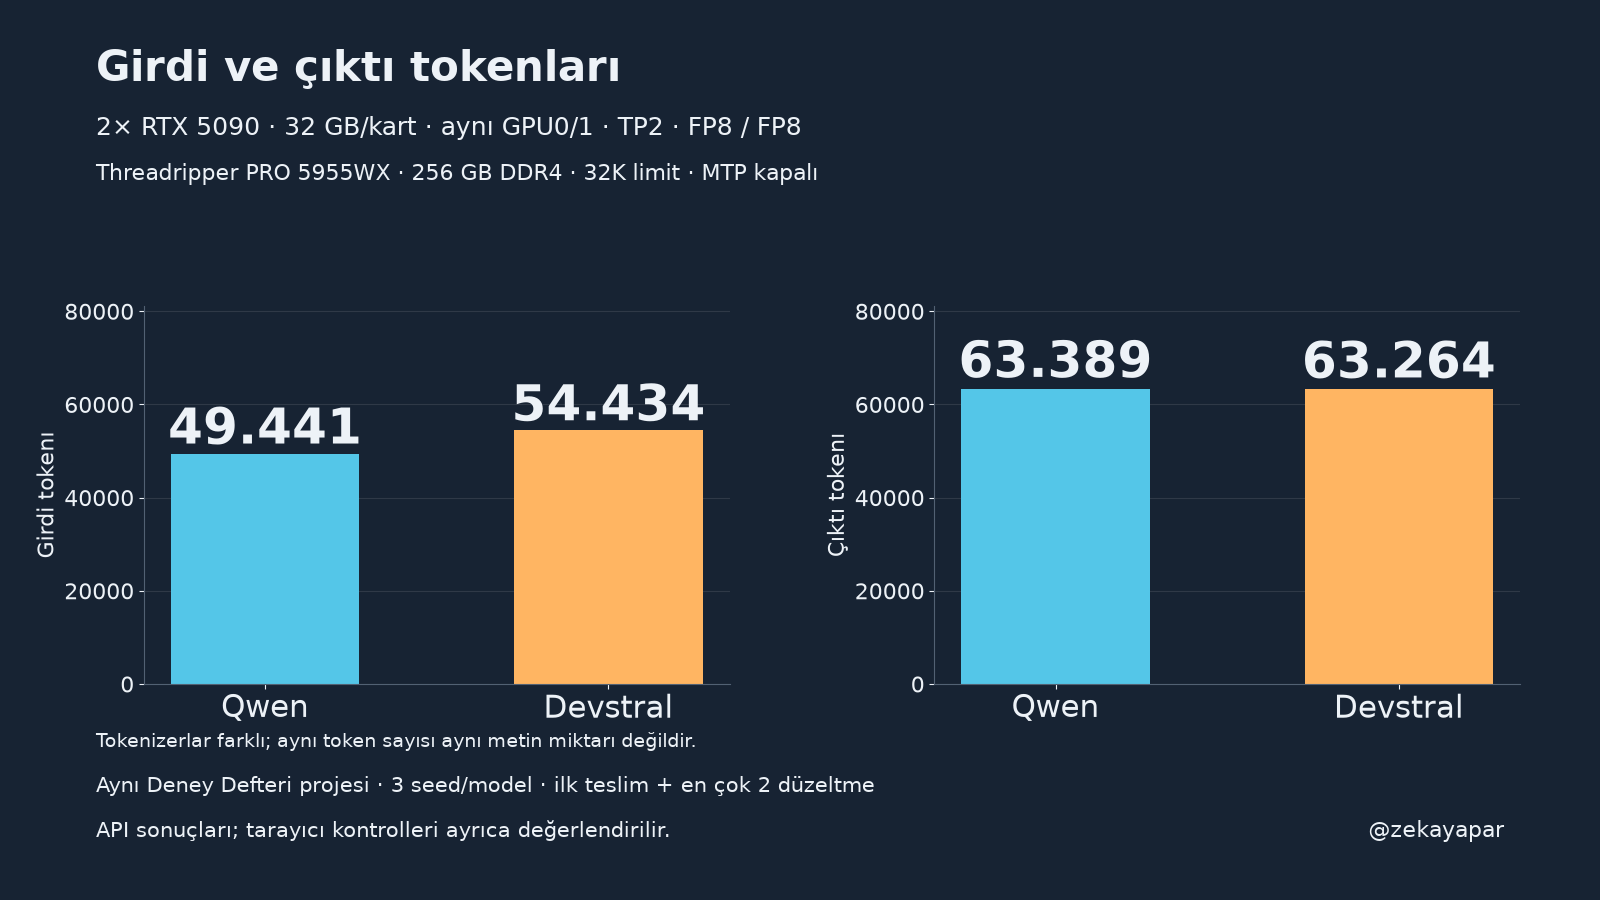
Geçerli altı denemenin ilk yanıt ve düzeltmeleri birlikte Qwen 49.441 girdi + 63.389 çıktı = 112.830 token kullandı. Devstral 54.434 girdi + 63.264 çıktı = 117.698 token kullandı. Tokenizerlar farklı; aynı token sayısı aynı metin miktarı değildir. Düzeltme isteklerinde her model kendi farklı kaynaklarını taşıdığı için toplam girdi tokenı da aynı kalmıyor.
Süreyi nasıl okumalı?
Model HTTP toplamı Qwen için 827,79 saniye, Devstral için 1.306,24 saniye. Teslim akışının geçen süreleri 829,43 ve 1.309,74 saniye; aradaki ek test/ölçüm akışı 1,64 ve 3,50 saniye. Bunun yalnız test çalıştırma kısmı 0,24 ve 1,98 saniye. İlk token bekleme süresinin çağrılar arasındaki medyanı 2,70 ve 0,36 saniye.
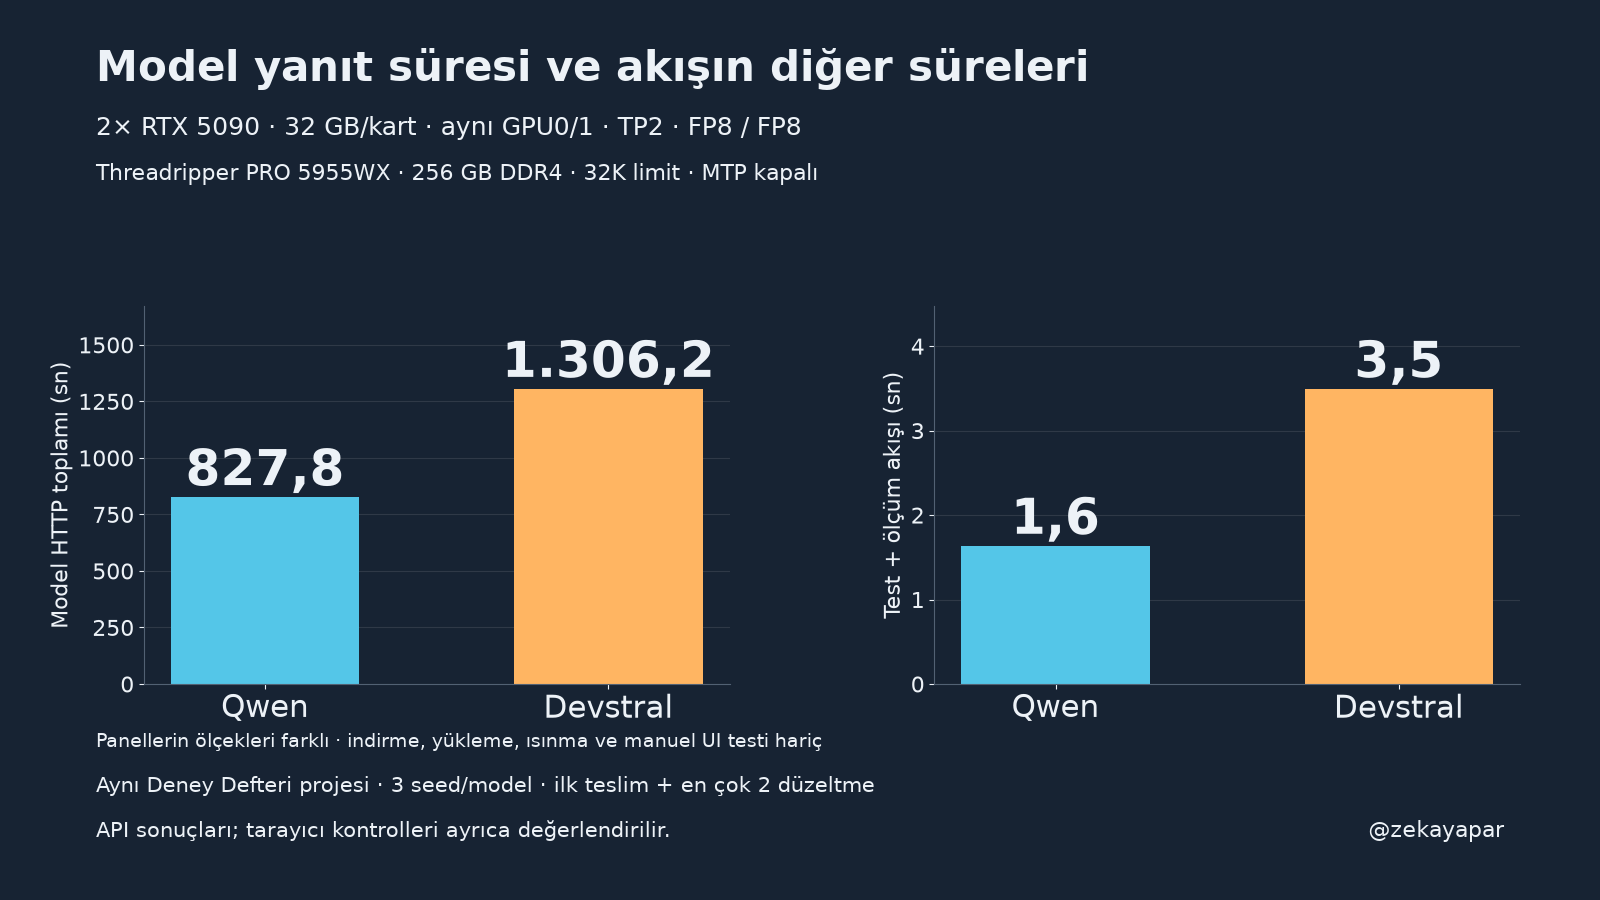
Qwen’in daha kısa HTTP toplamı, projeyi daha hızlı tamamladığını göstermiyor: iki final çıktı yarım kaldı ve iki tarafta da tam API kabulü yok. Bu ölçüm tüm geliştirme süresi veya çoklu kullanıcı kapasitesi testi değil.
Hazırlıkta neden iki koşuyu dışarıda bıraktım?
İlk hazırlık koşusunda uygulama yanlış çalışma dizininde başlatılıyordu; göreli index.html okuyan teslim haksız yere kalabiliyordu. İkinci hazırlıkta ise kaynak kontrolü Python’un normal super().__init__ kurucusunu fazla katı biçimde engelledi. Bu iki koşuyu ana sonuca katmadım. Ortak başlatıcıyı ve kontrolü düzelttikten sonra iki model için altı teslimi de yeniden, sıfırdan ürettim. Eski çözümler ve geri bildirimler yeni çağrılara aktarılmadı.
Dışarıda tutulan iki koşunun tamamlanmış çağrıları ayrıca en az 218.776 token ve 2.156,43 saniye model HTTP süresi kullandı. Kesilen iki çağrının son kullanım bilgisi olmadığı için bu bir alt sınır. İndirme, yükleme ve ısınma burada da yok. Bu hazırlık maliyetleri ana grafiklere eklenmedi.
Tekrarlanabilirlik ve sınır
Brief, sistem metni, JSON şeması, testler ve profiller çağrılardan önce hash ile sabitlendi. Normal kurucu ve göreli HTML okuyan referans uygulama 30/30 geçti; kasıtlı hatalı örnekler ve dosya/ağ sınırları ayrıca denetlendi. Model dosyaları, ham yanıtlar, API sonuçları, süre/token kayıtları ve tarayıcı ekranları saklandı. Yerel kaynak denetimleri bir işletim sistemi sandbox’ı iddiası taşımıyor.
Qwen revisionı 017b9c7af6b5689d5dd426a76e0bc077eb5ca20a; Devstral revisionı 55c5b41e98c2dbd21b0c8afffc540dcfc9eb5128. vLLM 0.30.0, Transformers 5.10.4, mistral_common 1.12.0 ve Python 3.12.15 kullanıldı. Ölçüm sonunda çalışan model profilini geri açıp gerçek JSON yanıtıyla doğruladım.
Bu, tek uygulamada üçer bağımsız teslimin sonucu. Daha yüksek çıktı bütçesi veya farklı geri bildirim akışı sonucu değiştirebilir; onları bu deney ölçmedi. Buradan genel bir “en iyi kod modeli” sıralaması çıkarmıyorum. Bu görev ve bütçede, dosya teslimi ile kullanılabilir uygulama arasında kalan farkı kaydediyorum.
Önceki küçük görev karşılaştırması · Qwen resmî FP8 modeli ↗ · Devstral resmî modeli ↗