 zekayapar
Yapay zekâya uzun metin verince ilk kelime ne kadar gecikiyor?
Yerel Qwen’de 214 istekle ölçtüm: her 1.000 token 0,25 sn bekleme ekliyor, aynı belgenin Türkçesi 1,37 kat geç, ikinci soruda önbellek 0,33 sn.
Model ve sunucu
- Qwen3.8-27B NVFP4 · vLLM 0.30.0 · MTP açık
- 2× RTX 5090 (TP2) · 16.384 token bağlam · prefix cache açık
- Sıralı tek istek · yük testi değil
Veri ve ölçüm
- FLORES-200 dev+devtest · 2.009 paralel Türkçe/İngilizce cümle
- 13 uzunluk × 2 dil × 5 tekrar + tekrar ve 128 token deneyleri (214 istek)
- Akışta ilk parçanın zamanı · cevap 128 token sabit
Yapay zekâya kısa bir soru sorunca cevap hemen akmaya başlıyor. Uzun bir rapor yapıştırınca ise ekranda bir süre hiçbir şey olmuyor. Bu bekleme neye bağlı, metin uzadıkça nasıl artıyor ve Türkçe metin İngilizcesinden daha mı geç cevaplanıyor? Evdeki Qwen sunucusunda bunu ölçtüm.
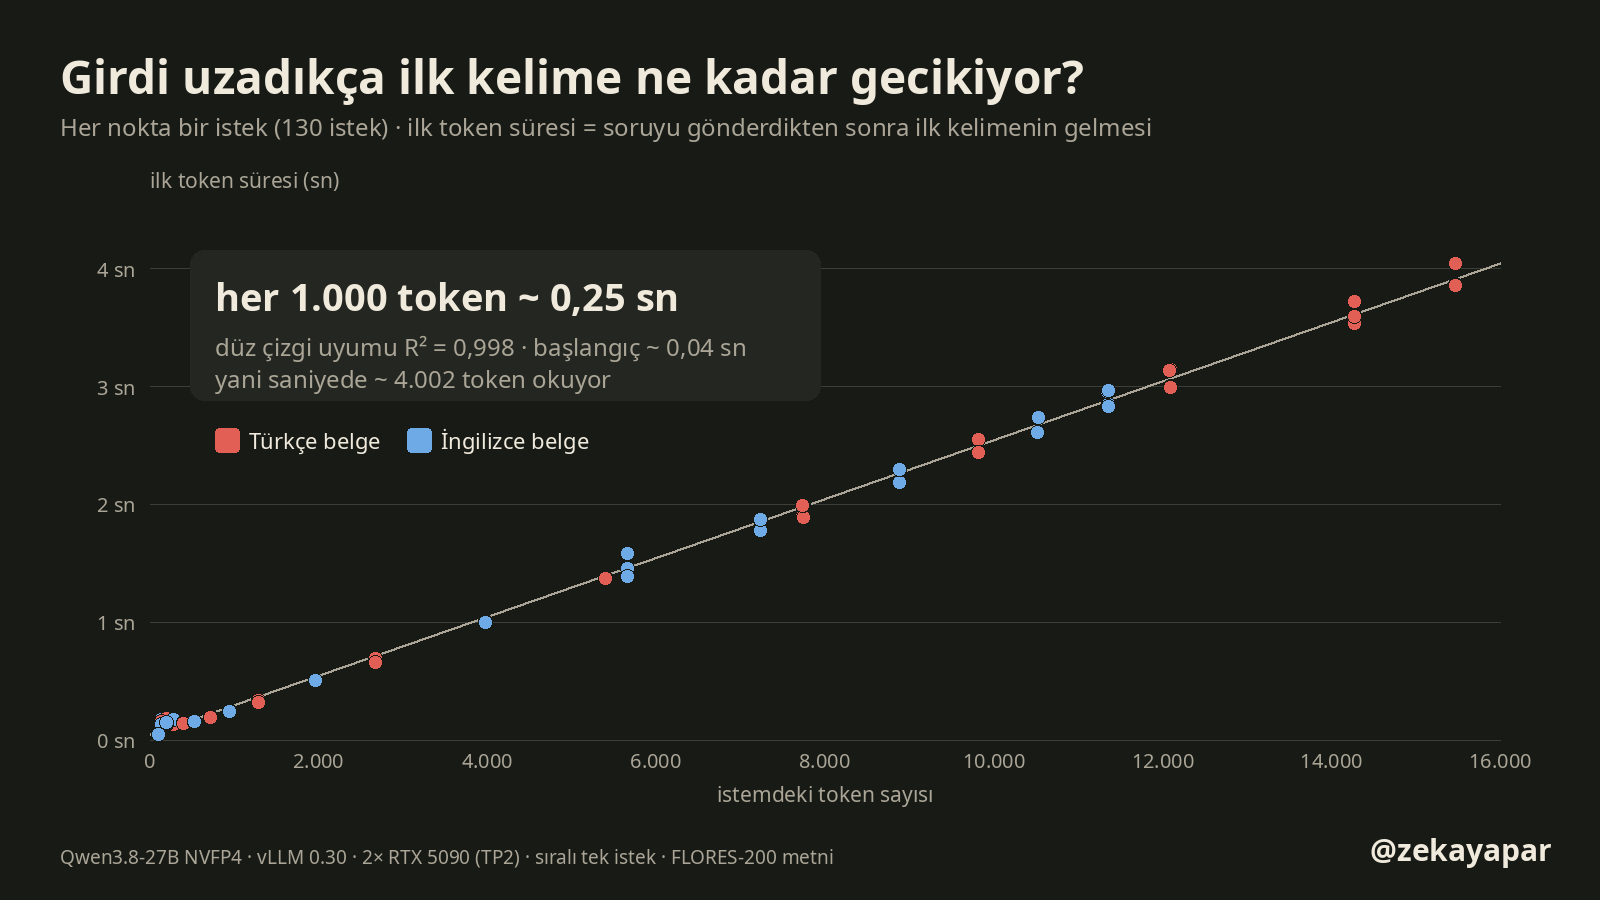
Kısa cevap: ilk kelimenin gelmesi neredeyse tamamen metnin token sayısına bağlı. Benim düzenimde her 1.000 token yaklaşık 0,25 saniye bekleme ekliyor; model girdiyi saniyede 4.002 token civarında okuyor. Aynı belgenin Türkçesi 1,36 kat fazla token tuttuğu için ilk kelime de o kadar geç geliyor: 15.473 tokenlık Türkçe metinde 4,05 sn, aynı içeriğin İngilizcesinde 2,96 sn. Aynı belgeyi ikinci kez sorunca ise bekleme 3,85 saniyeden 0,33 saniyeye indi.
Nasıl ölçtüm
Ölçtüğüm şey: “ilk token süresi”. Soruyu gönderdiğim andan cevabın ilk parçasının ekrana düştüğü ana kadar geçen süre. Sohbet ekranında “düşünüyor” gibi görünen boşluk bu. Bu sürede model cevap yazmıyor, verdiğim metnin tamamını okuyup hesaplıyor.
Metin: Kendi yazdığım örnekler yerine FLORES-200’ü kullandım. Bu, aynı cümlelerin onlarca dile profesyonelce çevrildiği açık bir çeviri seti (CC BY-SA 4.0). Türkçe ve İngilizce “dev” ve “devtest” bölümlerinde 2.009 paralel cümle var. Her istekte ilk N cümleyi belge olarak verdim: 1 cümleden 412 cümleye kadar 13 farklı uzunluk. Türkçe ve İngilizce belge aynı anlamı taşıyor, yalnız dili farklı.
İstem: Her istekte aynı Türkçe talimat vardı: “Aşağıdaki metni oku ve ne anlattığını tek cümleyle Türkçe özetle.”. Cevabı her seferinde tam 128 tokena sabitledim, sıcaklık 0. Her istemin en başına rastgele bir kayıt numarası koydum. Böylece sunucu önceki istekten hiçbir parçayı hazır bulamadı; sunucunun sayacı da bu isteklerde önbellekten gelen token göstermedi.
Tekrar ve sıra: Her uzunluk ve dil için 5 tekrar, toplam 130 istek. Sırayı sabit bir tohumla karıştırdım, istekleri tek tek gönderdim. Her istekten önce sunucuda başka iş olup olmadığını okudum: 5 istekte o an başka bir istek de çalışıyordu. Bunları çıkarınca eğim değişmiyor (0,250 ve 0,250 sn); hepsini grafikte bıraktım.
Sunucu: Her gün kullandığım Qwen3.8-27B (NVFP4), vLLM 0.30 ile iki RTX 5090 üzerinde, model iki karta bölünmüş halde (TP2) çalışıyor. Bağlam sınırı 16.384 token, tahmini hızlandıran MTP açık, önbellek açık. Ayarlara dokunmadım; yük testi değil, tek kullanıcının gördüğü süre. Token sayılarını sunucunun kendi döndürdüğü usage.prompt_tokens değerinden aldım; aynı istemi Qwen’in tokenizer’ıyla kendim saydığımda fark her istekte sabit 12 token çıktı (sohbet şablonunun eklediği kısım).
Sonuç: bekleme düz bir çizgi
130 isteğin hepsini tek grafiğe koyunca noktalar neredeyse cetvelle çizilmiş bir doğrunun üstüne oturuyor (R² = 0,998). Kabaca formül şu: bekleme ≈ 0,04 sn + her 1.000 token için 0,25 sn. 16 bin tokenın sınırına yakın en uzun istemde bile eğri yukarı kıvrılmadı; bu boyda metin için süre metinle doğru orantılı arttı.
Kırmızı ve mavi noktaların aynı çizgide durması önemli: Türkçe ya da İngilizce olması değil, token sayısı belirliyor. Dil ancak token sayısını değiştirdiği kadar etkili.
Aynı belge Türkçe olunca
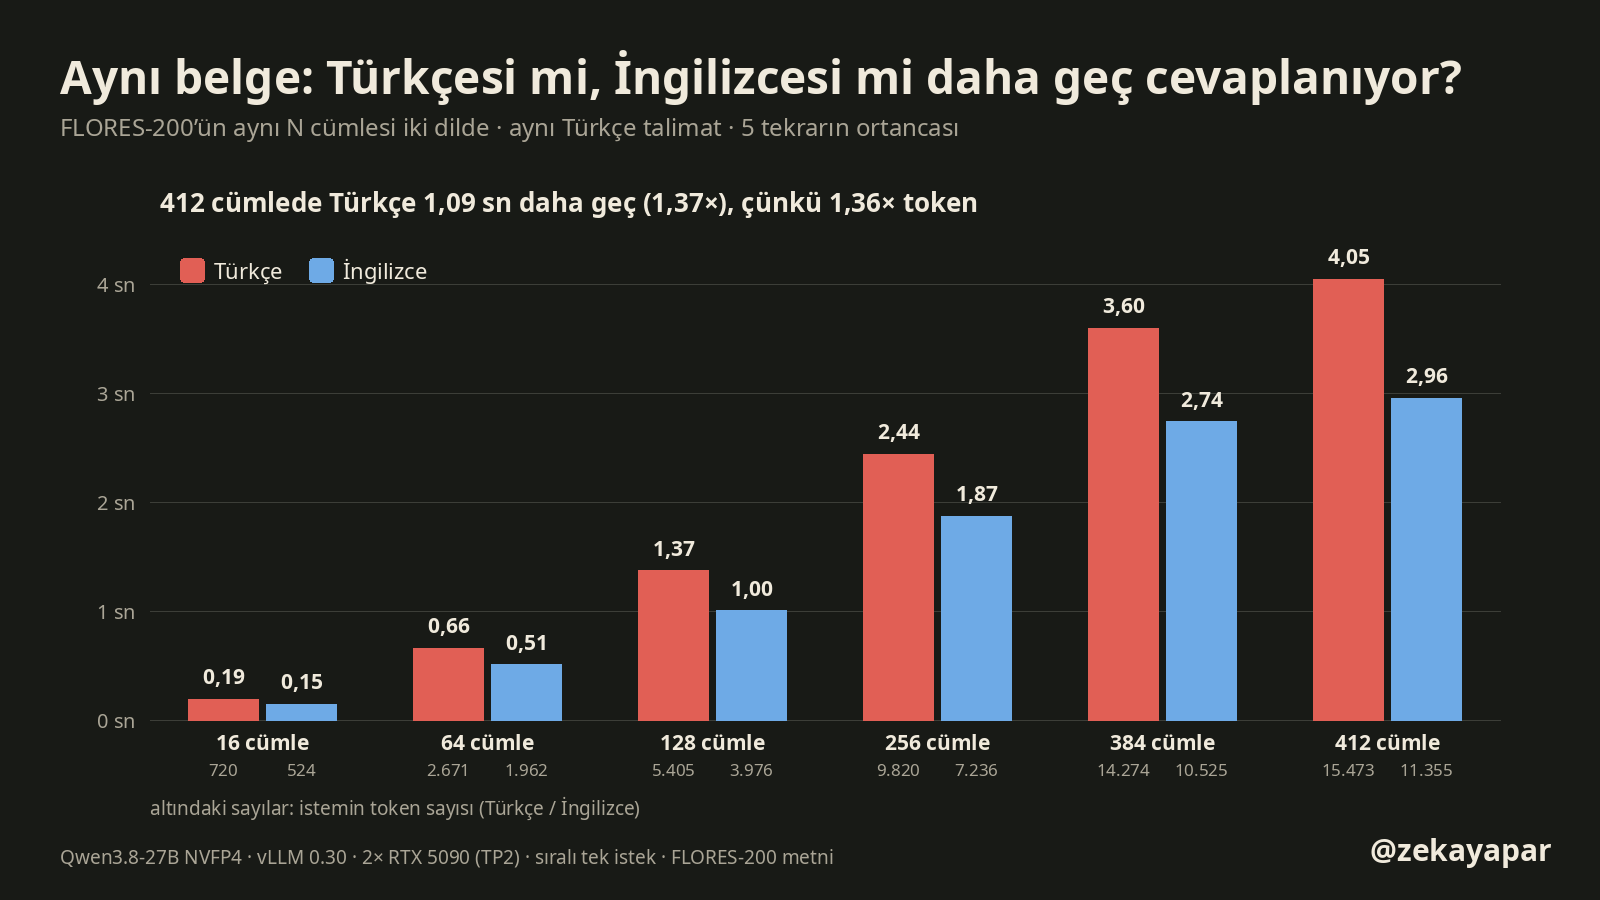
Aynı cümlelerin Türkçesi her uzunlukta daha geç cevaplandı. 64 cümlelik belgede fark 0,15 sn, 412 cümlede 1,09 sn. Oran 1,37 kat ve token oranına (1,36 kat) çok yakın. Yani Türkçe metin modeli yavaşlatmıyor; model aynı hızla okuyor, sadece okuyacak daha çok parça var.
Çok kısa belgelerde (2–8 cümle) iki dil arasında fark yok; ikisi de 0,14 sn civarında. Bunun nedeni biraz aşağıda, 128 token basamağında.
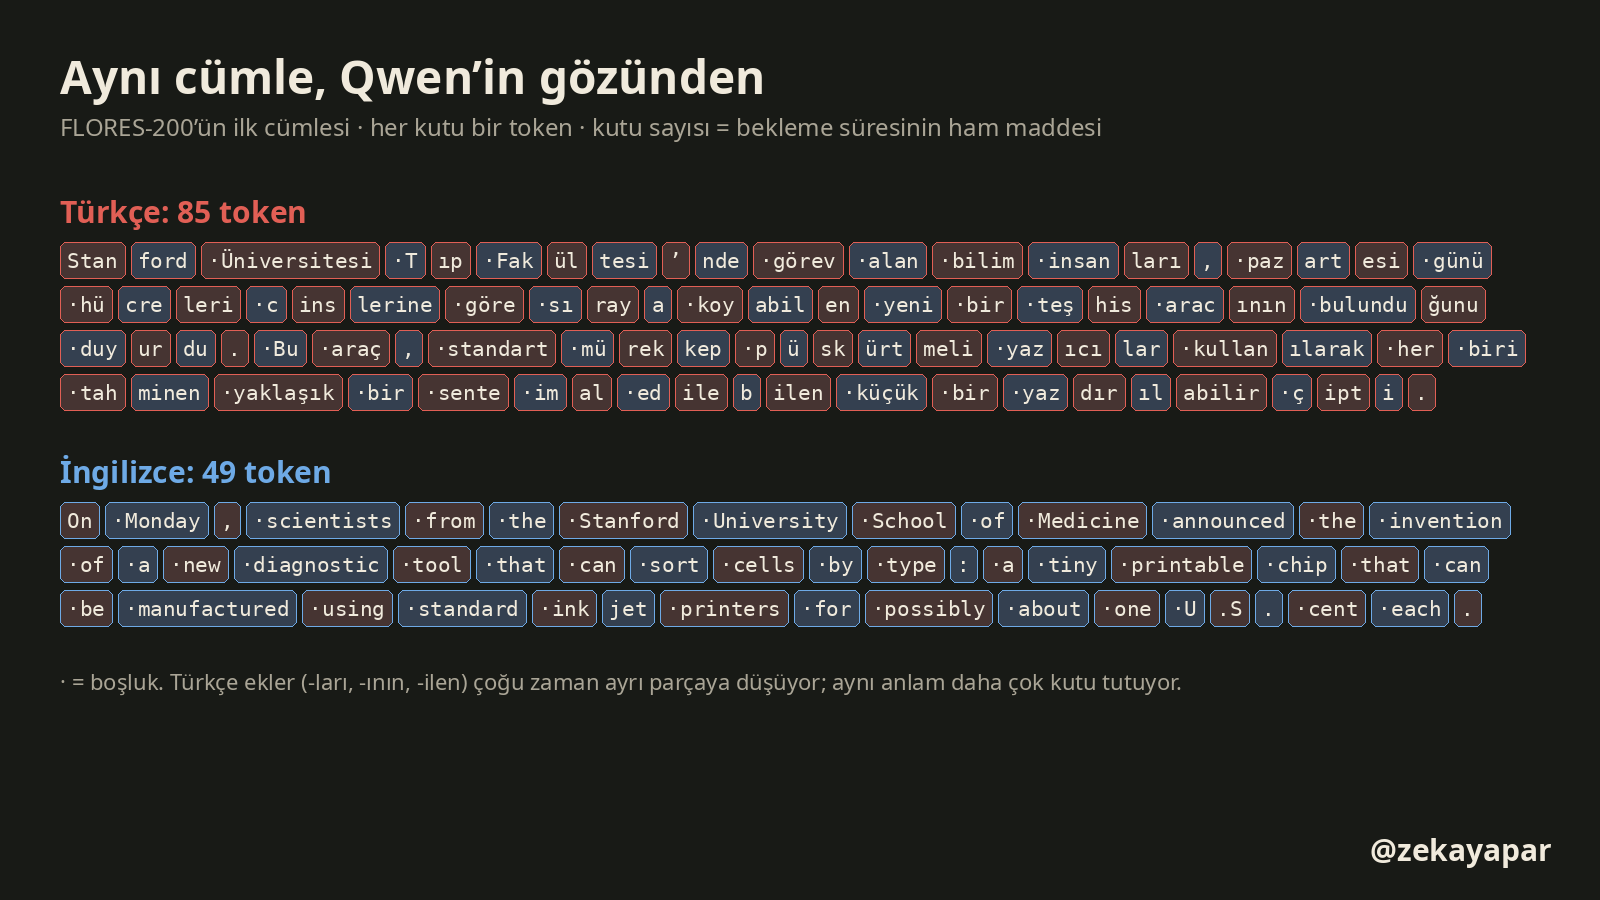
Neden daha çok token? Seti açan cümleyi Qwen’in tokenizer’ıyla böldüm. İngilizcesi 49 parça, Türkçesi 85 parça. İngilizcede “scientists”, “announced”, “diagnostic” birer kutu; Türkçede “Fakültesi’nde” beş, “yazdırılabilir” dört kutuya bölünüyor. Sözlükte Türkçe kelimelerin çekimli halleri az olduğu için ekler sık sık ayrı parçaya düşüyor. Bütün sette Türkçe cümle başına 38,1, İngilizce 26,7 token düştü. Bu oranı Türkçe token maliyeti yazısında on dört tokenizer için ölçmüştüm; burada aynı farkın faturadan sonra beklemeye de yansıdığını görüyorum.
128 tokenda bir basamak
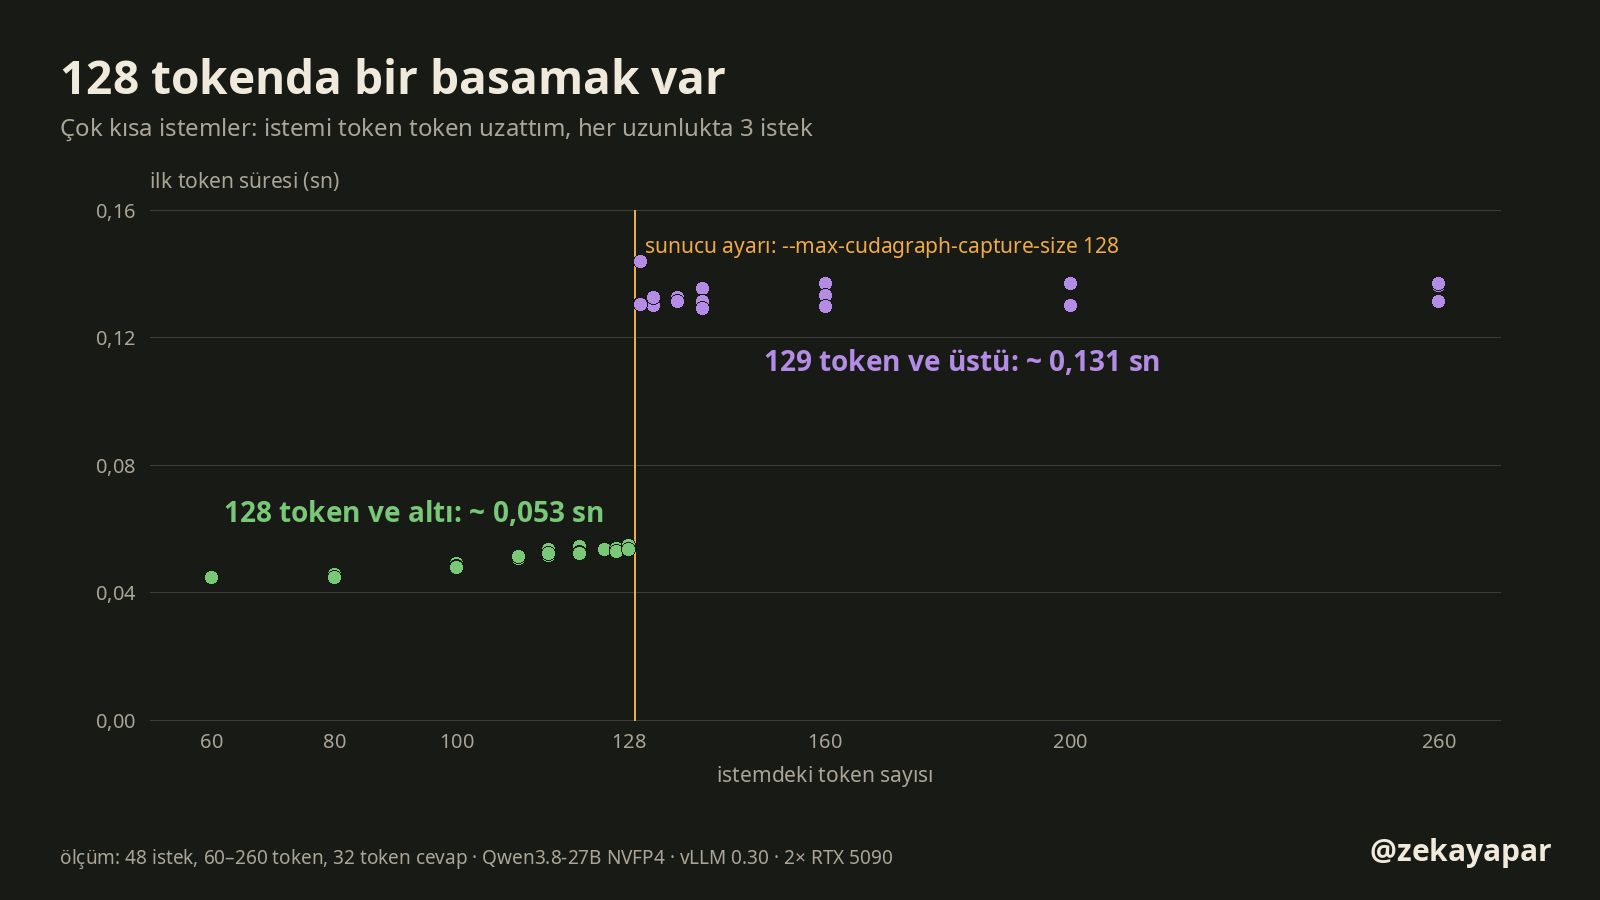
İlk ölçümde tuhaf bir şey gördüm: tek cümlelik İngilizce istem 0,05 sn’de cevaplanırken tek cümlelik Türkçe istem 0,15 sn sürdü. İkisinin arasında yalnız 35 token fark vardı. Sınırı bulmak için istemi token token uzatıp ayrı bir ölçüm yaptım (48 istek). Sonuç keskin: 128 tokena kadar 0,053 sn, 130 tokendan itibaren 0,131 sn. Arada geçiş yok, tek adımda iki buçuk katına çıkıyor.
128 sayısı sunucunun ayarlarında da var: --max-cudagraph-capture-size 128. vLLM, bu boya kadar olan işleri ekran kartına önceden kaydedilmiş hazır bir işlem dizisi olarak tek seferde gönderebiliyor; daha büyük işler adım adım gönderiliyor. Basamağın tam bu sınırda olması bu açıklamayla uyumlu, ama ayarı değiştirip tekrar ölçmedim; neden kısmını kesin bir sonuç olarak değil, en olası açıklama olarak yazıyorum. Günlük kullanımda fark 0,08 saniye, hissedilmez. Ama kısa istemlerde ölçüm yapan biri için iki istem arasındaki farkın dil değil bu basamak olabileceğini bilmek iyi.
Model saniyede kaç token okuyor
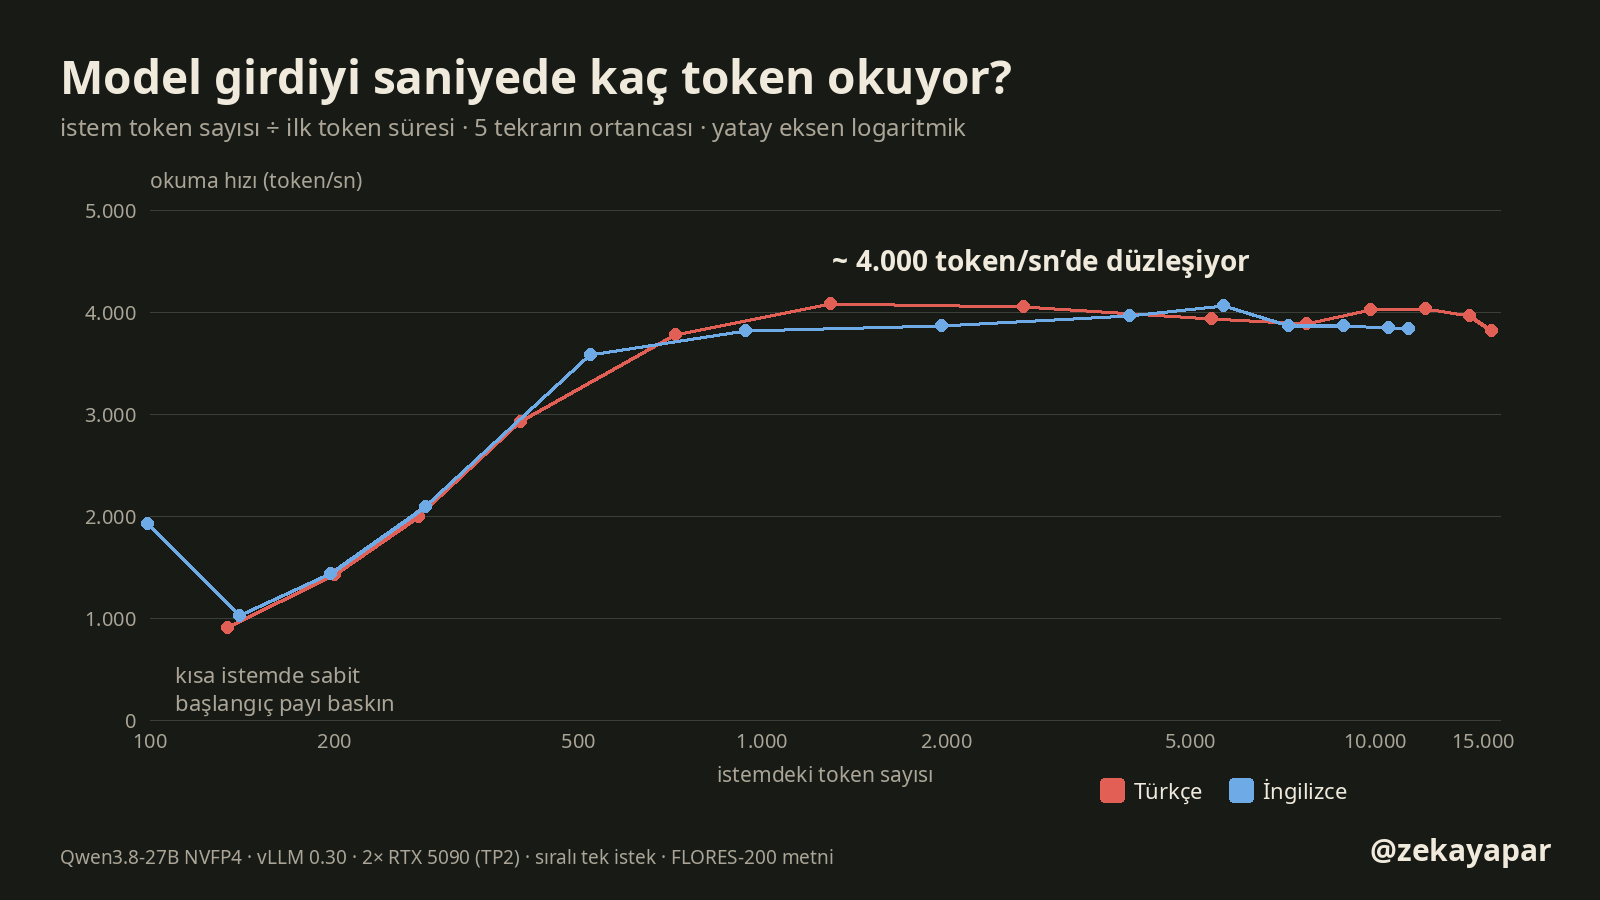
İstemdeki token sayısını ilk token süresine bölünce modelin okuma hızı çıkıyor. Birkaç yüz tokenın altında sabit başlangıç payı baskın olduğu için hız düşük görünüyor. 1.000 tokendan sonra ise 3.822 ile 4.083 token/sn arasında sabitleniyor. Yani 15 bin tokenlık uzun bir istem de, 1.000 tokenlık bir istem de aynı hızla okunuyor; uzun istemin tek farkı daha uzun sürmesi.
Beklemek mi, yazmak mı?
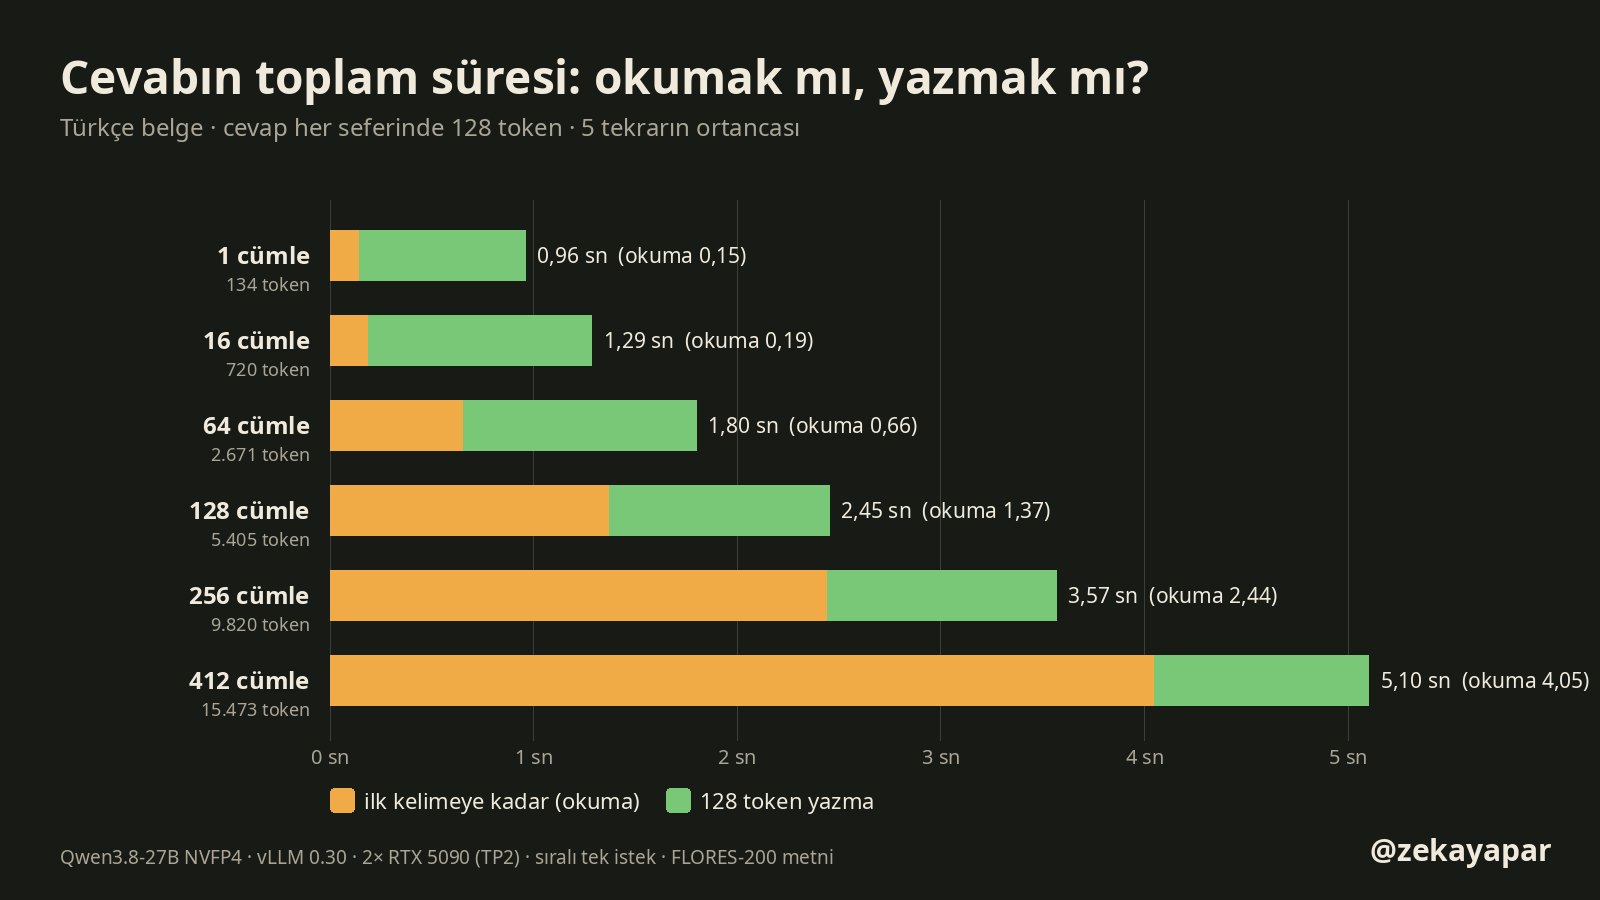
Cevap süresi iki parçadan oluşuyor: metni okumak ve cevabı yazmak. 128 tokenlık cevabı yazmak her uzunlukta 0,8–1,3 sn sürdü. Kısa soruda toplam sürenin çoğu yazma. 64 cümlelik bir belgede (1.167 kelime) okuma 0,66 sn, yazma 1,14 sn; 412 cümlede (6.631 kelime) ise 5,10 saniyenin 4,05 saniyesi yalnız okuma. Uzun belgeyle çalışırken beklemenin asıl sebebi cevabın uzunluğu değil, belgenin kendisi.
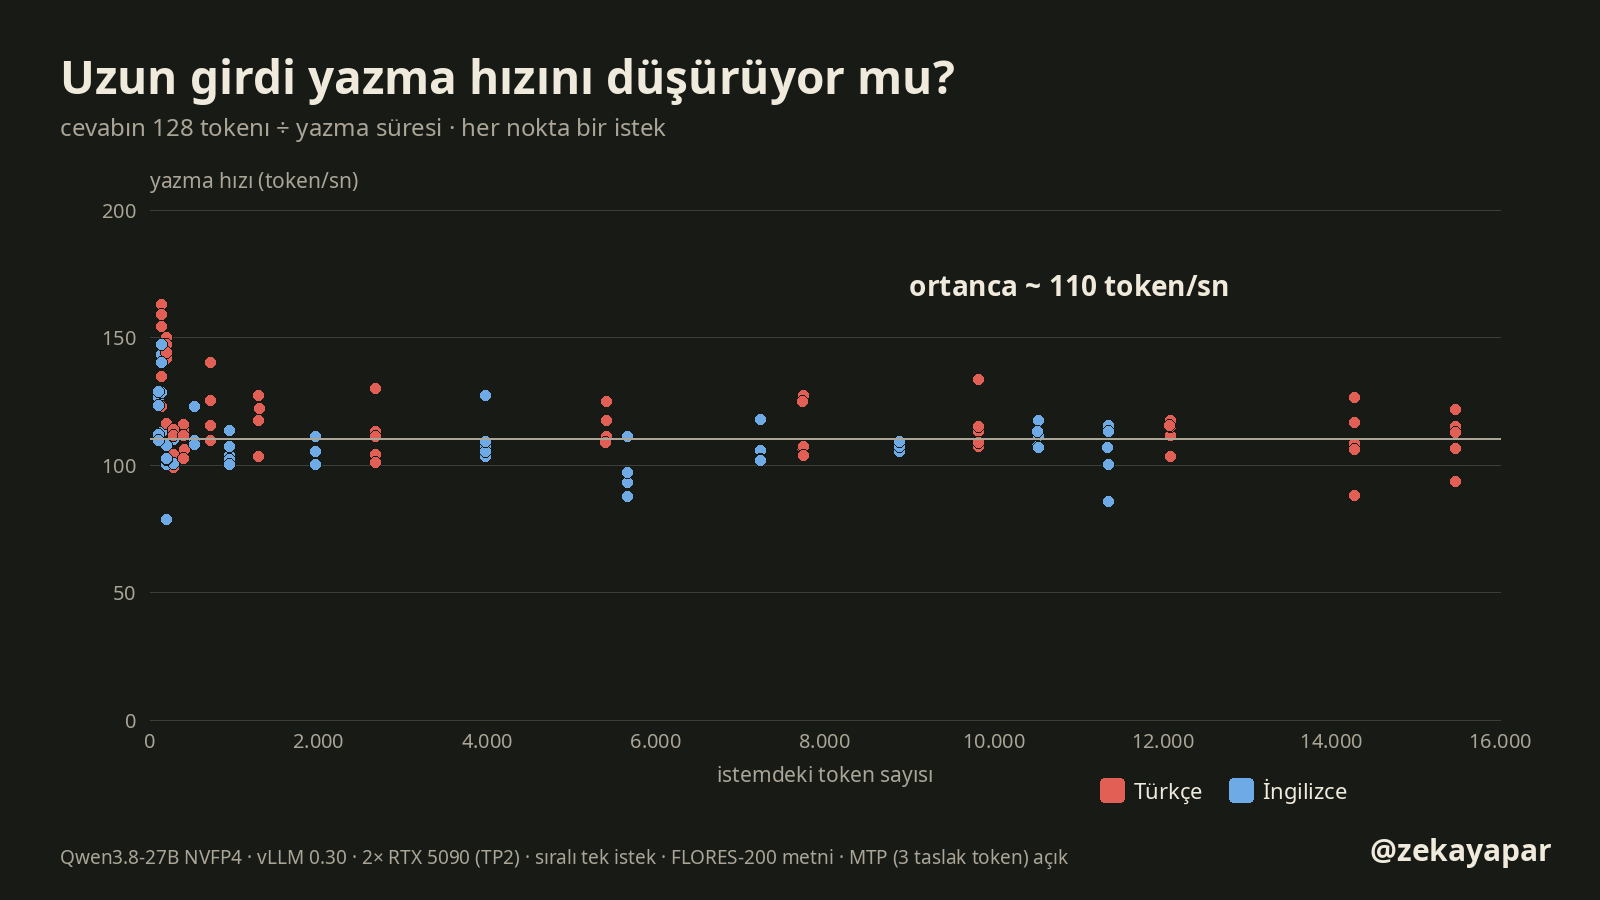
Uzun metin cevabın yazılma hızını düşürüyor mu diye de baktım. Ortanca yazma hızı 110 token/sn. 15 bin tokenlık istemde de 1.000 tokenlıkta da noktalar aynı bant içinde. En kısa istemlerdeki biraz yüksek değerler, sunucudaki tahmin hızlandırıcının (MTP) kısa ve tekrarlı metinde daha çok isabet etmesinden kaynaklanıyor olabilir; bunu ayrıca ölçmedim. Bu uzunluklarda yazma tarafında uzun girdinin bedeli görülmedi.
Aynı belgeyi ikinci kez sorunca
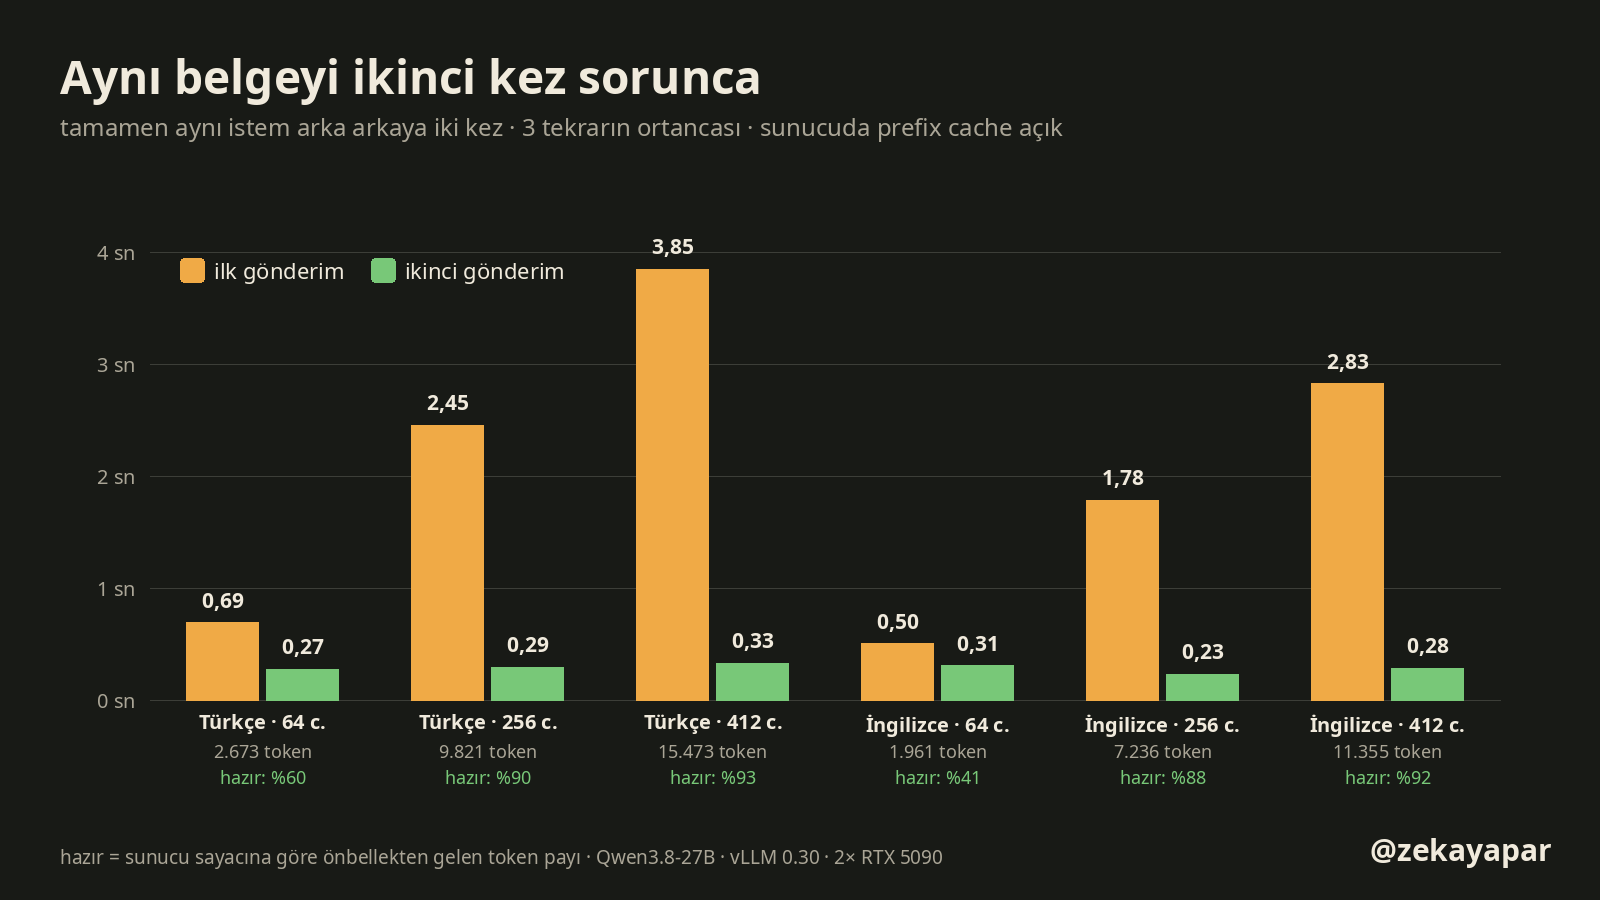
Sohbette aynı belge üzerine ikinci, üçüncü soruyu sorduğumuzda belge her seferinde tekrar gönderiliyor. Sunucuda önbellek açık; aynı başlangıcı daha önce hesapladıysa o kısmı yeniden kullanabiliyor. Bunu görmek için aynı istemi, kayıt numarası dahil birebir aynı haliyle, arka arkaya iki kez gönderdim. 15.473 tokenlık Türkçe belgede bekleme 3,85 saniyeden 0,33 saniyeye indi. Sunucunun sayacına göre bu istekte 14.400 token önbellekten geldi.
Sayaç önbelleği 800 tokenlık parçalar halinde saydı. Bütün sonuçlar 800’ün katı çıktı; son yarım parça her seferinde yeniden hesaplanıyor. 64 cümlelik Türkçe belgede (2.673 token) bu yüzden ancak 1.600 token hazır geldi, bekleme 0,69 saniyeden 0,27 saniyeye indi.
Ana ölçümde her istemin başına farklı bir kayıt numarası koyduğum için önbellek hiç devreye girmedi. Bu da pratik bir ders: önbellek ancak metnin başı aynı kaldığında işe yarıyor. Uzun bir belgenin en başına her seferinde değişen bir şey (tarih, saat, sıra numarası) koyarsam, sonrasındaki binlerce token tekrar baştan hesaplanıyor.
16 bin tokenlık pencereye ne sığıyor
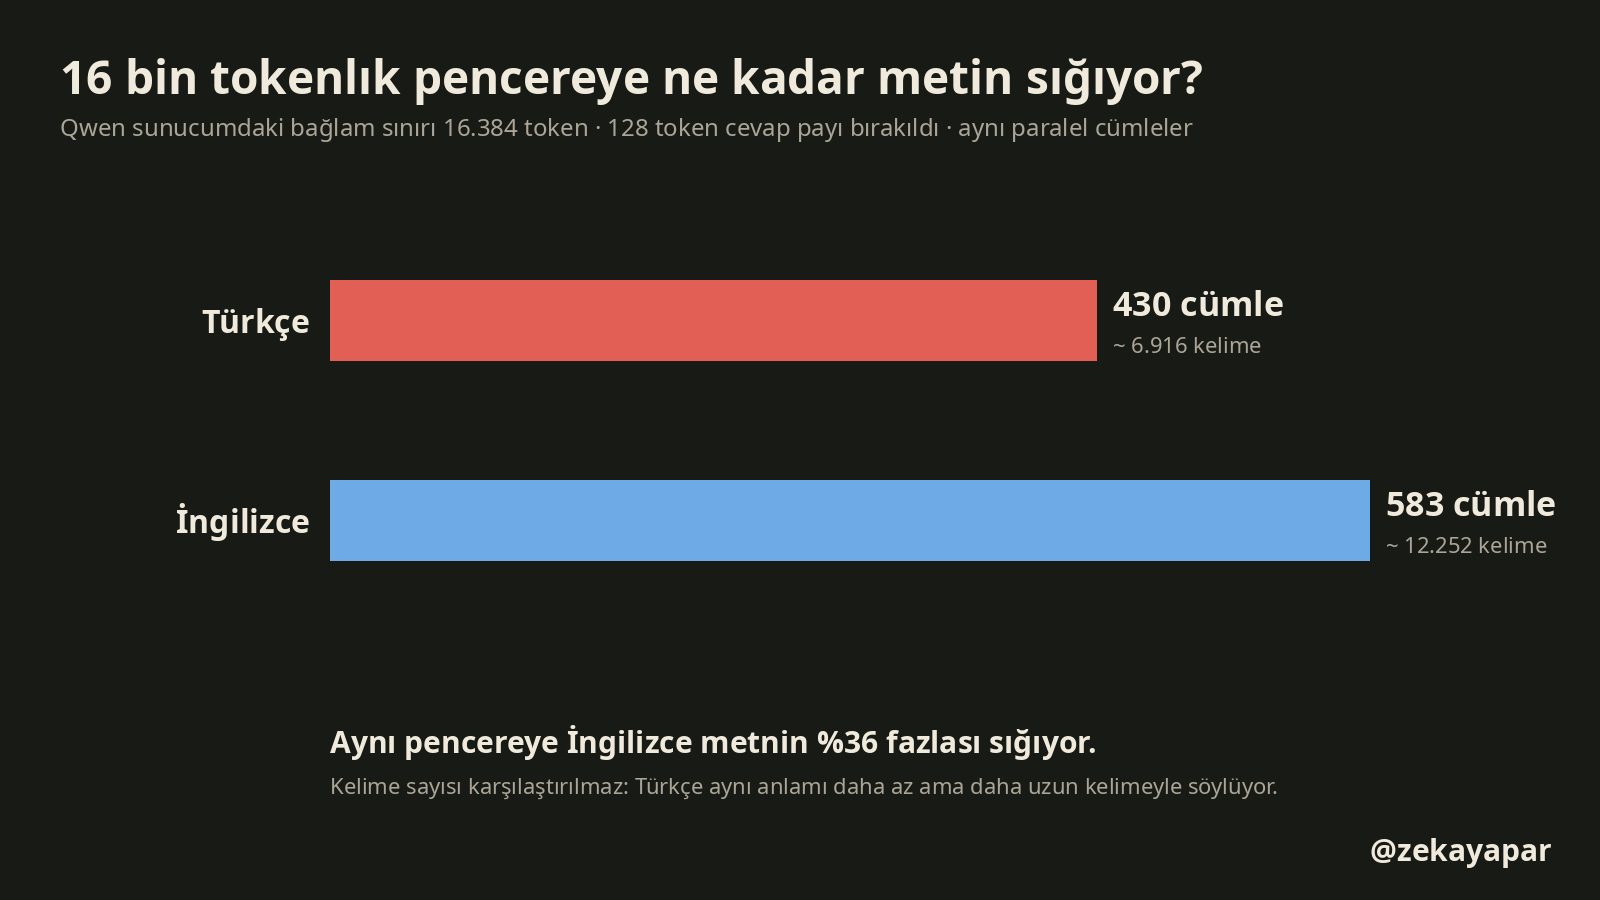
Token farkının bir yan etkisi daha var: modelin bir seferde görebildiği metin. Benim sunucumda sınır 16.384 token. 128 token cevap payı bırakınca aynı paralel cümlelerden 430 Türkçe cümle sığdı, İngilizcede 583. Aynı pencereye İngilizce içeriğin yüzde 36 fazlası giriyor. Bulut servislerinde pencere çok daha büyük ve her şirketin tokenizer’ı farklı, ama o yazıda ölçtüğüm tokenizer’ların çoğunda Türkçe 1,3 ile 2 kat arasında fazla token tutuyordu: Türkçe belge pencereyi daha çabuk dolduruyor.
Günlük kullanımda ne demek
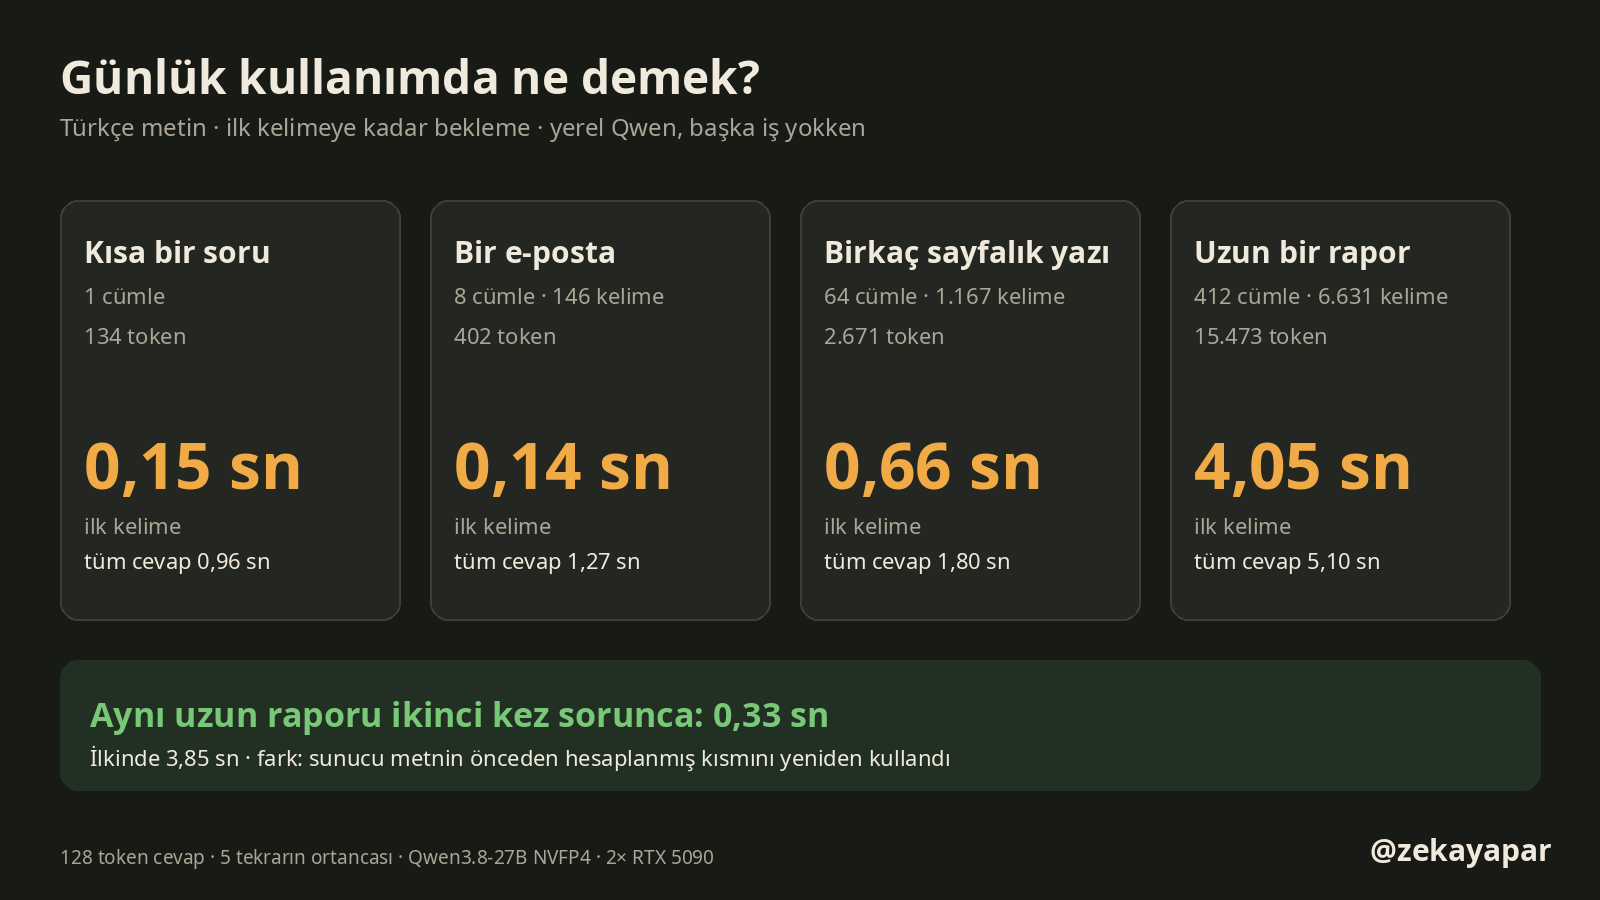
Bu kurulumda kısa bir soru ya da e-posta uzunluğunda bir metin için bekleme 0,15 saniyenin altında; fark edilmiyor. Birkaç sayfalık bir yazıda (1.167 kelime) 0,66 sn. 6.631 kelimelik uzun bir raporu yapıştırdığımda ilk kelime için 4,05 sn bekliyorum. Aynı rapor üzerine ikinci soruyu sorduğumda bekleme yeniden saniyenin altına iniyor.
Bu sayılar benim iki kartıma ve bu modele ait. Daha küçük bir model ya da daha güçlü bir sunucu çizginin eğimini değiştirir. Bulut servisinde ağ gecikmesi ve sıra da eklenir. Ama düz çizgi mantığı ve Türkçe metnin token farkı kadar fazla beklemesi aynı kalıyor.
Benim için sonuç
Uzun belgeyle çalışırken birkaç şeyi deneyebilirim. Belgenin yalnız ilgili bölümünü vermek, beklemeyi doğrudan token sayısı oranında kısaltıyor. Aynı belge üzerine birkaç soru soracaksam belgeyi istemin başına koyup hiç değiştirmemek önbelleğin işini görmesini sağlıyor; başa değişen bir tarih ya da numara koymamak gerekiyor. Belge İngilizce ise çevirip vermek beklemeyi uzatıyor; İngilizce haliyle verip cevabı Türkçe istemek bu ölçümde daha kısa bekletti. Bunlar test edilecek seçenekler; cevabın kalitesini bu yazıda ölçmedim.
Gerçek istem ve cevap örnekleri
Tek cümlelik Türkçe istemin tamamı (kayıt numarası her istekte farklıydı):
Kayıt no: 1a773ca5

Aşağıdaki metni oku ve ne anlattığını tek cümleyle Türkçe özetle.

Stanford Üniversitesi Tıp Fakültesi’nde görev alan bilim insanları, pazartesi günü hücreleri cinslerine göre sıraya koyabilen yeni bir teşhis aracının bulunduğunu duyurdu. Bu araç, standart mürekkep püskürtmeli yazıcılar kullanılarak her biri tahminen yaklaşık bir sente imal edilebilen küçük bir yazdırılabilir çipti.
Qwen’in cevabı, hiç düzeltmeden:
Stanford Üniversitesi'ndeki bilim insanları, standart yazıcılarda yaklaşık bir sent maliyetle üretilebilen ve hücreleri cinslerine göre ayırt edebilen yeni bir teşhis çipi geliştirdiklerini duyurdu.

Kayıt no: 1a773ca5


Stanford Üniversitesi'ndeki bilim insanları, standart yazıcılarda yaklaşık bir sent maliyetle üretilebilen ve hücreleri cinslerine göre ayırt edebilen yeni bir teşhis çipi geliştirdiklerini duyurdu.

Kayıt no
Cevabın tekrarlayan ikinci yarısı bir ölçüm etkisi: cevap uzunluğunu herkes için aynı tutmak için modelin erken durmasını engelledim (128 token zorunlu). Model özeti bitirdikten sonra da yazmaya devam etmek zorunda kaldı, istemdeki satırları tekrar etti. Bu, süre ölçümünü eşit tutmak için yapıldı; günlük kullanımda model ilk cümleden sonra durur.
412 cümlelik İngilizce belgeye verdiği cevap (istem 51.041 karakter olduğu için burada yalnız başı var; tamamı indirilebilir dosyada):
Kayıt no: 70ce01c4

Aşağıdaki metni oku ve ne anlattığını tek cümleyle Türkçe özetle.

On Monday, scientists from the Stanford University School of Medicine announced the invention of a new diagnostic tool that can sort cells by type: a tiny printable chip that can be manufactured using standard inkjet printers for possibly about one U.S. cent each.
Lead researchers say this may bring early detection of cancer, tuberculosis, HIV and malaria to patients in low-income countries, where the survival rates for illnesses such as breast cancer can be half those of richer countries.
The JAS 39C Gripen …
Metin, Stanford Üniversitesi'nin mürekkep püskürtmeli yazıcılarla düşük maliyetle üretilebilen yeni bir hücre ayırt etme çipini duyurmasıyla başlayıp, çeşitli ülkelerdeki hava olayları, siyasi gelişmeler, spor sonuçları, bilimsel keşifler ve tarihsel olayları içeren birbirinden bağımsız çok sayıda kısa haber parçasını bir araya getiren bir derlemedir.
*(Not: Metin, tek bir konu etrafında şekillenen bütünlüklü bir anlatı değil,Sınırlar
- Tek sunucu, tek model, tek ayar. Başka kart, model ya da vLLM ayarı farklı eğim verir.
- İstekler tek tek gönderildi. Aynı anda birkaç kişi kullanırken bekleme sıraya göre artar; bunu ölçmedim.
- Cevap kalitesini puanlamadım; yazı yalnız süre ve token sayısıyla ilgili. Cevaplar 128 tokena zorlandığı için doğal uzunlukta değil.
- Metin haber ve ansiklopedi cümleleri. Kod, tablo ya da sohbet geçmişinde token oranı farklı olabilir.
- 128 token basamağının nedeni ayar değiştirilerek doğrulanmadı.
- 5 ana istekte sunucuda aynı anda başka bir istek de vardı; grafikte bırakıldı, eğimi değiştirmiyor.
Tam tablo ve yöntem
Ana ölçüm: 5 tekrarın ortancası, süreler saniye. “Okuma” = istem tokenı ÷ ilk token süresi (token/sn).
| Cümle | Token TR | Token EN | İlk token TR | İlk token EN | Aralık TR | Aralık EN | Toplam TR | Toplam EN | Okuma TR | Okuma EN |
|---|---|---|---|---|---|---|---|---|---|---|
| 1 | 134 | 99 | 0,147 | 0,050 | 0,136–0,153 | 0,050–0,054 | 0,96 | 1,08 | 905 | 1.925 |
| 2 | 200 | 140 | 0,139 | 0,135 | 0,136–0,182 | 0,133–0,175 | 1,02 | 1,04 | 1.427 | 1.028 |
| 4 | 274 | 197 | 0,137 | 0,137 | 0,134–0,147 | 0,135–0,151 | 1,27 | 1,39 | 1.994 | 1.440 |
| 8 | 402 | 282 | 0,138 | 0,135 | 0,136–0,145 | 0,134–0,174 | 1,27 | 1,40 | 2.928 | 2.091 |
| 16 | 720 | 524 | 0,191 | 0,146 | 0,188–0,200 | 0,146–0,158 | 1,29 | 1,31 | 3.778 | 3.579 |
| 32 | 1.290 | 938 | 0,316 | 0,246 | 0,315–0,332 | 0,235–0,248 | 1,36 | 1,46 | 4.083 | 3.815 |
| 64 | 2.671 | 1.962 | 0,658 | 0,507 | 0,657–0,693 | 0,500–0,509 | 1,80 | 1,77 | 4.057 | 3.867 |
| 128 | 5.405 | 3.976 | 1,372 | 1,002 | 1,371–1,375 | 0,992–1,005 | 2,45 | 2,19 | 3.939 | 3.965 |
| 192 | 7.741 | 5.657 | 1,989 | 1,390 | 1,893–1,991 | 1,383–1,583 | 3,09 | 2,70 | 3.892 | 4.069 |
| 256 | 9.820 | 7.236 | 2,443 | 1,871 | 2,439–2,554 | 1,779–1,876 | 3,57 | 3,07 | 4.021 | 3.866 |
| 320 | 12.090 | 8.880 | 2,999 | 2,294 | 2,991–3,144 | 2,184–2,298 | 4,22 | 3,46 | 4.031 | 3.871 |
| 384 | 14.274 | 10.525 | 3,598 | 2,738 | 3,534–3,720 | 2,608–2,740 | 4,79 | 3,82 | 3.967 | 3.843 |
| 412 | 15.473 | 11.355 | 4,048 | 2,955 | 3,863–4,058 | 2,835–2,968 | 5,10 | 4,12 | 3.822 | 3.842 |
İkinci gönderim (aynı istem arka arkaya, 3 tekrarın ortancası; önbellek = ikinci gönderimde sunucu sayacının artışı):
| Dil | Cümle | Token | İlk | İkinci | Önbellekten token |
|---|---|---|---|---|---|
| Türkçe | 64 | 2.673 | 0,690 | 0,275 | 1.600 |
| Türkçe | 256 | 9.821 | 2,454 | 0,292 | 8.800 |
| Türkçe | 412 | 15.473 | 3,851 | 0,328 | 14.400 |
| İngilizce | 64 | 1.961 | 0,503 | 0,306 | 800 |
| İngilizce | 256 | 7.236 | 1,784 | 0,232 | 6.400 |
| İngilizce | 412 | 11.355 | 2,827 | 0,282 | 10.400 |
128 token basamağı (3 tekrarın ortancası, cevap 32 token):
| İstem token | İlk token (sn) |
|---|---|
| 60 | 0,045 |
| 80 | 0,045 |
| 100 | 0,048 |
| 110 | 0,051 |
| 115 | 0,052 |
| 120 | 0,053 |
| 124 | 0,054 |
| 126 | 0,053 |
| 128 | 0,053 |
| 130 | 0,131 |
| 132 | 0,130 |
| 136 | 0,131 |
| 140 | 0,131 |
| 160 | 0,133 |
| 200 | 0,130 |
| 260 | 0,136 |
Düz çizgi uyumu (130 istek): başlangıç 0,044 sn, eğim 249,9 ms/1.000 token, R² 0,9981. Yalnız 2.000 token üstü: 255,6 ms/1.000 token.
Kaynaklar ve sürümler: Qwen3.8-27B NVFP4 (nvidia, Hugging Face revizyonu 482ca0f3832238542f8f5295dde86b5f22711d80) · vLLM 0.30.0 · TP2, 2× RTX 5090 (450 W sınırı) · --max-model-len 16384 --max-num-batched-tokens 2048 --max-cudagraph-capture-size 128, MTP 3 taslak token, prefix cache açık, KV bfloat16, FlashInfer · FLORES-200 dev+devtest tur_Latn / eng_Latn (CC BY-SA 4.0; dosya SHA256 değerleri indirilebilir özet dosyasında) · istekler: temperature 0, max_tokens = min_tokens = 128, akış (stream) ile ilk içerik parçasının zamanı.
İndir: betikler, ham istek kayıtları ve tam istem/cevaplar (ZIP) · özet (JSON) · istek başına sonuçlar (CSV) · run.py