 zekayapar
Yapay zekâ PDF’yi gerçekten okudu mu? Metin, tarama ve tablo farkı
PDF yüklemek, her satırın doğru okunduğu anlamına gelmiyor. Metin katmanı, OCR ve tablo düzeni farkını resmî belgelerle ve pratik kontrollerle ayırıyorum.
Bu yazıda incelenenler
- PyMuPDF: metin çıkarma, okuma sırası, tablo ve OCR belgeleri
- Anthropic: PDF işleme yolunda metin ve sayfa görüntüsü
- Kaynak kontrolü: 16 Kasım 2026
Yöntem ve kapsam
- Kaynaklı rehber; OCR veya model performans testi değil
- Yeni model çalıştırılmadı, gerçek kullanıcı belgesi yüklenmedi
- Şema ve örnek istem açıklama amaçlı; ölçüm sonucu değil
PDF yükledim, cevap da geldi. Bu, belgedeki her satırın doğru okunduğunu gösterir mi? Hayır. Önce dosyadan neyin çıkarıldığını, sonra cevabın hangi sayfaya dayandığını kontrol etmek gerekiyor. Metni seçilebilen bir rapor, taranmış dilekçe ve çok sütunlu tablo aynı okuma işi değil.
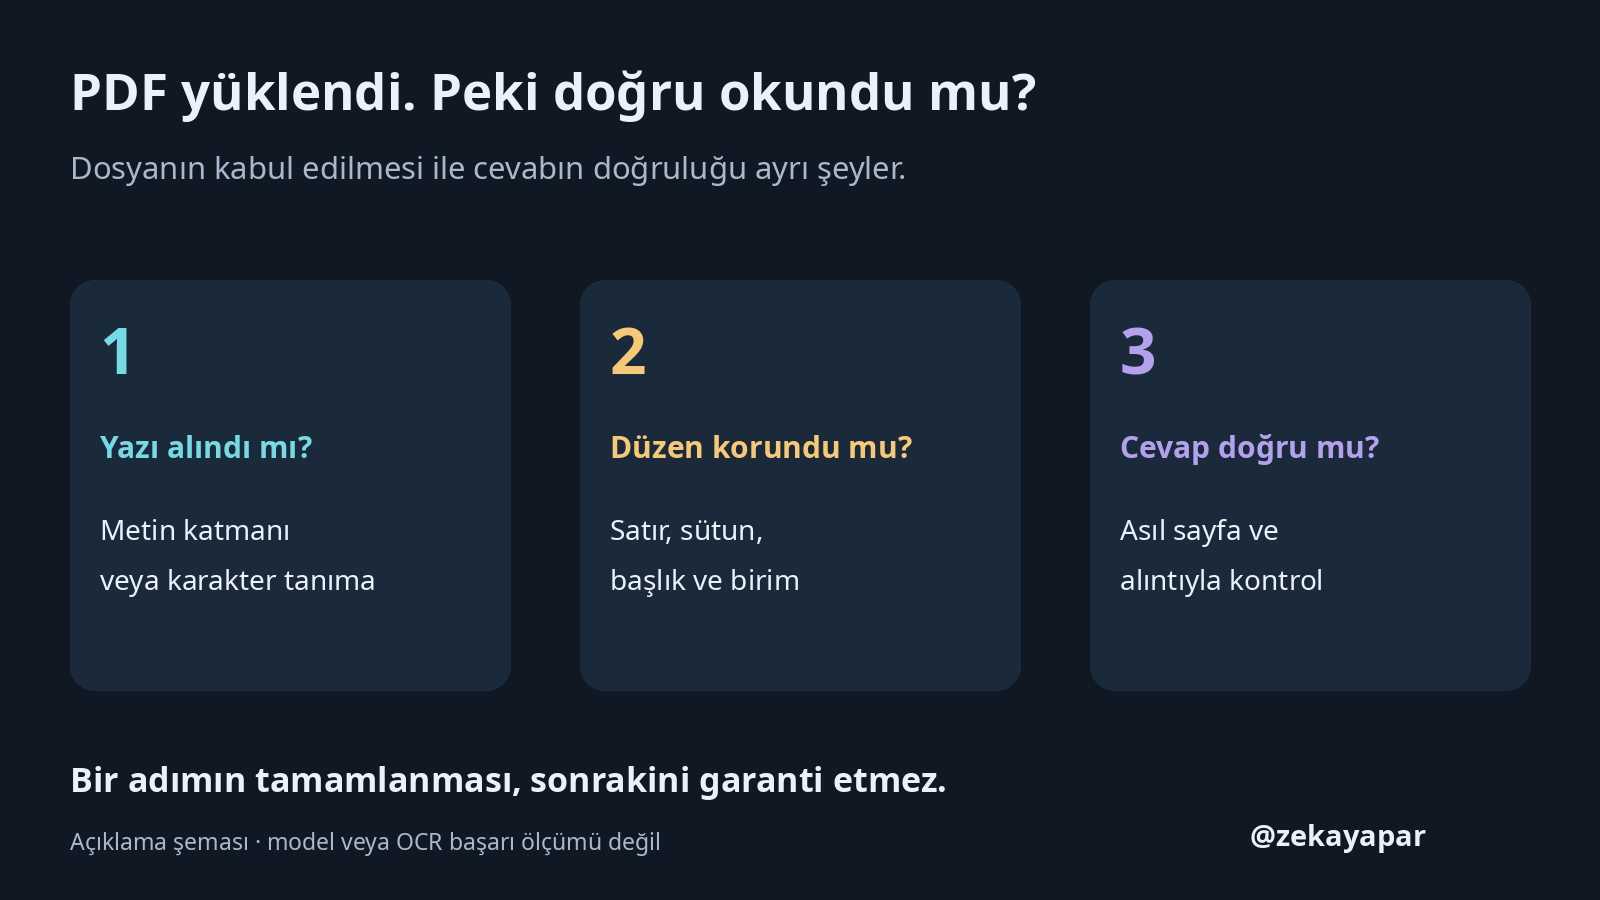
Bu yazıda model yarıştırmıyorum. PyMuPDF’nin metin çıkarma ve karakter tanıma belgeleriyle Anthropic’in PDF işleme kılavuzunu okuyup, dosya yüklerken kolayca birbirine karışan üç adımı ayırıyorum: yazıyı elde etmek, sayfanın düzenini anlamak ve soruya doğru cevap vermek. Bir adımın tamamlanması diğerini garanti etmiyor.
Aynı PDF uzantısı, farklı içerik
Bir kelime işlemciden dışa aktarılan PDF’de çoğu zaman doğrudan alınabilen yazı bulunur. Kâğıttan taranan belgede ise sayfa yalnızca bir resim olabilir. Bazı dosyalar ikisini birleştirir: görünen taramanın arkasında, daha önce bir yazılımın tanıdığı görünmez metin vardır. Aynı dosyanın farklı sayfaları da farklı türde olabilir.
Bu yüzden ilk küçük kontrol olarak, modelle konuşmadan önce PDF görüntüleyicisinde sorunlu sayfadan bir cümleyi seçip düz metin alanına kopyalamak denenebilir. Metin geliyor mu? Türkçe harfler korunuyor mu? Yan yana duran iki sütun birbirine karışıyor mu? Bu, bir ön kontrol; ne bütün dosyanın sağlam olduğunu ne de kullandığım uygulamanın aynı metni modele göndereceğini kanıtlar. Metin seçilemiyorsa da dosya mutlaka okunamaz demek değildir: karakter tanıma veya sayfayı görüntü olarak işleyen bir araç gerekebilir.
Metin çıktı ama sırası doğru mu?
PyMuPDF’nin resmî kılavuzu, düz metin çıkarma sonucunun doğal okuma sırasında olmayabileceğini açıkça söylüyor. Sayfanın üstünde görünen başlık, dosyaya sonradan eklendiği için çıkarılan metnin sonunda bulunabilir. Ekranda düzgün görünen düzen, dosya içindeki metin sırasıyla aynı şey değil.
İki sütunlu bir makalede bunun pratik karşılığı önemli: soldaki paragrafın devamı yerine sağdaki sütundan bir satır gelebilir. Böyle bir girişten akıcı özet üretilmesi, kaybolan bağlantıyı geri getirmiş olmaz. Belgede yer almayan bir ilişki kurulmaması için, özellikle özetin dayandığı bölümün başını ve sonunu orijinal sayfayla karşılaştırmak gerekir.
Kılavuz, konum bilgisiyle metin bloklarını kullanmak veya metni sıralamak gibi yollar gösteriyor. Bunları her belgeyi çözen bir düğme olarak okumuyorum. Sol üstten sağ alta konumsal sıralama, karmaşık sayfa düzeninin anlamını tek başına kuramaz.
Taramadan metin çıkarmak: OCR da son kontrol değildir
OCR, resimdeki yazıyı bilgisayarın işleyebileceği metne dönüştüren karakter tanıma işlemidir. PyMuPDF belgelerinde, görüntüden üretilen PDF’ye görünmez bir metin katmanı eklenebildiği anlatılıyor. Böylece sayfa aynı görünürken arama ve kopyalama mümkün olabilir.
Ancak kopyalanabilen metnin varlığı, o metnin taramayla birebir olduğu anlamına gelmez. Kılavuz, görünür içerikle hizası bozuk veya hatalı kodlanmış metin katmanları olabileceğini de belirtiyor. Özellikle ad, tarih, tutar ve olumsuzluk bildiren sözcükleri orijinal görüntüden kontrol etmek iyi bir önlem. Burada “OCR şu kadar hata yapar” diye bir oran vermiyorum; bu yazı için bir belge setinde tanıma başarısı ölçmedim.
Her dosyayı yeniden OCR’dan geçirmek de otomatik iyileştirme değil. Aynı kılavuz, zaten temiz metni olan PDF’de zorla OCR kullanmanın işlemi yavaşlatabileceğini ve kaliteyi düşürebileceğini söylüyor. Amaç belgeyi tekrar tekrar dönüştürmek değil, eksik veya bozuk kısmı bulmak.
Tabloyu okumak, sayıları sırayla toplamak değil
PDF’de tablo gibi görünen şey, her zaman elektronik tablodaki gibi hücreler hâlinde saklanmaz. PyMuPDF’nin açıklamasına göre çoğu durumda belirli konumlara yerleştirilmiş normal yazıdır. Tablo alanının ve satır-sütun ilişkilerinin ayrıca bulunması gerekir.
Temsili bir örnek: Bir raporda “2024” ve “2025” sütunları, “gelir” ve “gider” satırları olsun. Dört sayının eksiksiz okunması yetmez; her sayının hangi yıla ve hangi kaleme ait olduğu da korunmalıdır. Yanlış sütuna bağlanan doğru sayı, yine yanlış cevap üretir. Bu örnek bir modelin gerçek hatası değil, kontrol edilmesi gereken ilişkiyi anlatıyor.
Tablodan cevap isterken şu alanları birlikte kontrol etmek gerekir: satır başlığı, sütun başlığı, değer, birim ve dipnot. “Bin TL” başlığını kaçırmak, tek bir rakamı yanlış okumaktan daha büyük bir anlam değişikliğine yol açabilir. Bir sonraki sayfada devam eden tabloda da önceki sayfanın başlığını görmeden karar vermemek gerekir.
Uygulama metni mi alıyor, sayfayı da görüyor mu?
Bu ayrım kullandığın uygulamaya bağlı. Yerel bir belge arama aracı PDF’den yalnızca metin çıkarıp modele gönderebilir. Böyle bir yöntemde, metne dönüşmeyen grafiğin çizgileri modele ulaşmaz. Bu, bütün yerel araçlar için geçerli bir özellik değil; uygulamanın dosyayı nasıl hazırladığına bakmak gerekir.
Anthropic’in incelenen PDF kılavuzu ise Claude’a PDF gönderildiğinde her sayfanın görüntüye çevrildiğini, çıkarılan metnin bu görüntüyle birlikte sağlandığını söylüyor. Böylece grafik ve şekiller de analize katılabiliyor. Bu açıklama belgede anlatılan PDF işleme yoluna ait; Claude adını kullanan her üçüncü taraf araca, her dosya ekleme yöntemine veya bütün sohbet ürünlerine genellenemez.
Görüntünün modele ulaşması da hatasız okuma garantisi değil. Aynı kılavuz, PDF işlemenin görsel anlama sınırlarına tabi olduğunu ve yoğun, küçük yazılı, karmaşık tablolu belgelerin modelin işleyebildiği bağlam sınırına, sayfa sınırından önce ulaşabileceğini belirtiyor. Dosya boyutu veya sayfa sayısı tek başına ne kadarının rahatça işleneceğini söylemez.
“Özetle” demeden önce uygulayabileceğin kontrol sırası
- Önemli sayfayı aç. Metin seçilebiliyor mu, kopyalanınca sıra ve Türkçe harfler korunuyor mu? Karışık bir dosyada yalnız ilk sayfayı kontrol etme.
- Görev için gerekli içeriği belirle. Düz paragraf mı, tarama mı, tablo mu, grafik mi? Kullandığın araç bu içeriği gerçekten modele iletiyor mu?
- Önce küçük bir bölüm sor. Kritik sayfayı veya birkaç sayfalık bölümü hedefle; cevaptaki ana bilgiyi orijinalle eşleştir. Kısa bölüm doğru diye bütün dosyanın doğru okunduğunu varsayma.
- Kaynağı görünür iste. PDF görüntüleyicisindeki sayfa numarası, kısa alıntı ve varsa tablo başlığıyla birlikte cevap al. Basılı sayfa numarasıyla görüntüleyicinin sayacı farklıysa hangisini kullandığını belirt.
- Sonucu yeniden kontrol et. Sayfa numarasının yazılmış olması yeterli değil. Alıntı gerçekten orada mı? Tutarın birimi ve tarihin ait olduğu olay doğru mu?
Denemek için örnek istem — ölçülmüş model çıktısı değil
Aşağıdaki metin, bu yazı için hazırlanmış bir kullanım önerisi. Bir modele gönderilmedi; karşısında gerçek bir cevap veya başarı sonucu yok.
Yalnız PDF görüntüleyicisindeki 4. sayfayı kullan.
Önce soruyla ilgili satırı kısa ve aynen alıntıla, sonra cevabı yaz.
Tablo varsa değeri satır başlığı, sütun başlığı, birimi ve dipnotuyla birlikte ver.
Okuyamadığın veya belgede bulamadığın bilgiyi tamamlamaya çalışma; açıkça belirt.
Soru: Bu sayfada belirtilen son başvuru tarihi nedir?
Bu istem, uygulamanın erişemediği sayfayı görünür yapmaz ve modelin belirsizliği mutlaka doğru bildireceğini garanti etmez. Faydası, cevabı kontrol edilecek küçük bir parçaya bağlamasıdır.
Benim için sonuç
Bu kaynaklardan çıkardığım sonuç, PDF yükleme işini “dosya kabul edildi mi?” sorusuyla bitirmemek gerektiği. Asıl ayrım şu: Yazı alınabildi mi, sayfadaki ilişkiler korundu mu, cevap gerçekten o bilgiye mi dayanıyor? Bu üç soruyu ayrı tutunca, sorunun modelin cevabında mı yoksa daha dosya hazırlanırken mi başladığını aramak kolaylaşıyor.
Gündelik bir özet için kontrolü birkaç önemli bölüme odaklamak mümkün. Ama başvuru tarihi, ödeme tutarı veya resmî bir belgenin sonucu söz konusuysa, son kararı özgün sayfaya dönmeden vermemek gerekir. Akıcı bir cevap, belgenin yerine geçmez.
Kaynaklar, yöntem ve sınırlar
Birincil kaynaklar 16 Kasım 2026’da okundu. Bu bir kaynaklı rehberdir: gerçek kullanıcı belgesi yüklenmedi; OCR, tablo çıkarma veya model doğruluğu deneyi yapılmadı. Görsel açıklama şeması, tablodaki senaryo ve örnek istem bu yazı için hazırlandı; ölçüm veya gözlenmiş hata olarak sunulmuyor. Ürün belgeleri değişebilir; güncel sürüm ve kullandığın uygulamanın dosya işleme yolu ayrıca kontrol edilmelidir.
- PyMuPDF — Text: doğal okuma sırası, konum bilgisi, tablo alanı ve sütun ilişkilerinin çıkarılması.
- PyMuPDF — OCR: tarama ve metin katmanı, bozuk katmanlar, temiz metne zorla OCR uygulamanın sınırları.
- Anthropic — PDF support: PDF’nin metin ve sayfa görüntüsüyle işlenmesi, yoğun belgeler ve görsel anlama sınırları.