 zekayapar
Yapay zekâ ses kaydında olmayan sözler yazabilir mi?
Düzgün yazılmış bir ses dökümü, doğru tutanak demek değil. Whisper belgelerinden olmayan sözleri, zaman damgalarını ve dinleyerek kontrolün sınırlarını ayırıyorum.
Bu yazıda incelenenler
- OpenAI Whisper ve large-v3 model kartları
- faster-whisper: konuşma filtresi ve kelime zamanları
- Kaynak kontrolü: 17 Kasım 2026
Yöntem ve kapsam
- Kaynaklı rehber; Türkçe ses tanıma testi değil
- Yeni kayıt yüklenmedi, model çalıştırılmadı
- Cümle örnekleri ve şema açıklama amaçlı
Bir ses kaydını yazıya çeviren yapay zekâ, kayıtta hiç söylenmemiş bir cümle yazabilir mi? Evet. Whisper’ın kendi model kartı bunu açıkça olası bir hata olarak sayıyor. Üstelik mesele yalnız yanlış duyulmuş bir isim değil: model, seste karşılığı olmayan metin de üretebiliyor. Bu yüzden düzgün Türkçe yazılmış bir dökümü, dinlenerek doğrulanmış bir tutanakla aynı şey saymıyorum.
Bu yazı bir Türkçe ses tanıma karşılaştırması değil. OpenAI’nin Whisper model kartlarını ve faster-whisper belgelerini okuyup, bir kaydı yazıya döktükten sonra neleri kontrol etmenin anlamlı olduğunu ayırıyorum. Yeni ses kaydı yüklemedim, model çalıştırmadım; aşağıdaki örnekler açıklama amaçlı, gerçek model çıktısı değil.
Ses tanıma, harfleri doğrudan kopyalamıyor
Metin belgesinde bir kelimenin karakterlerini almakla, dalga biçiminden hangi kelimenin söylendiğini çıkarmak farklı işler. Whisper, sesi işleyip metin dizisi üreten bir model. OpenAI’nin model kartı, büyük ve gürültülü verilerle yapılan eğitimin ardından, tahminlerin ses girdisinde gerçekten söylenmeyen metinler içerebildiğini belirtiyor. Belgede buna “hallucination”, yani olmayan içerik üretme deniyor.
Aynı kartta olası açıklama da ayrı tutuluyor: modelin genel dil bilgisini kullanarak sonraki kelimeyi tahmin etmesi ile sesi yazıya çevirme işi birbirine karışabiliyor. Bu, geliştiricilerin öne sürdüğü açıklama; her yanlış cümlenin nedenini teşhis eden bir kural değil. “Şu kayıtta kesin bu yüzden oldu” diyebilmek için o kaydı ayrıca incelemek gerekir.
Benim için pratik ayrım şu: cümlenin doğal görünmesi, kayıtta bulunduğunun kanıtı değil. Yazım hatasız bir paragraf da yeniden dinlemeyi gerektirebilir. Model kartının uyarısı, her kaydın hatalı olduğu ya da Türkçede belirli bir hata oranı bulunduğu anlamına da gelmiyor.
Üç farklı hatayı tek sepete koymamak gerekiyor
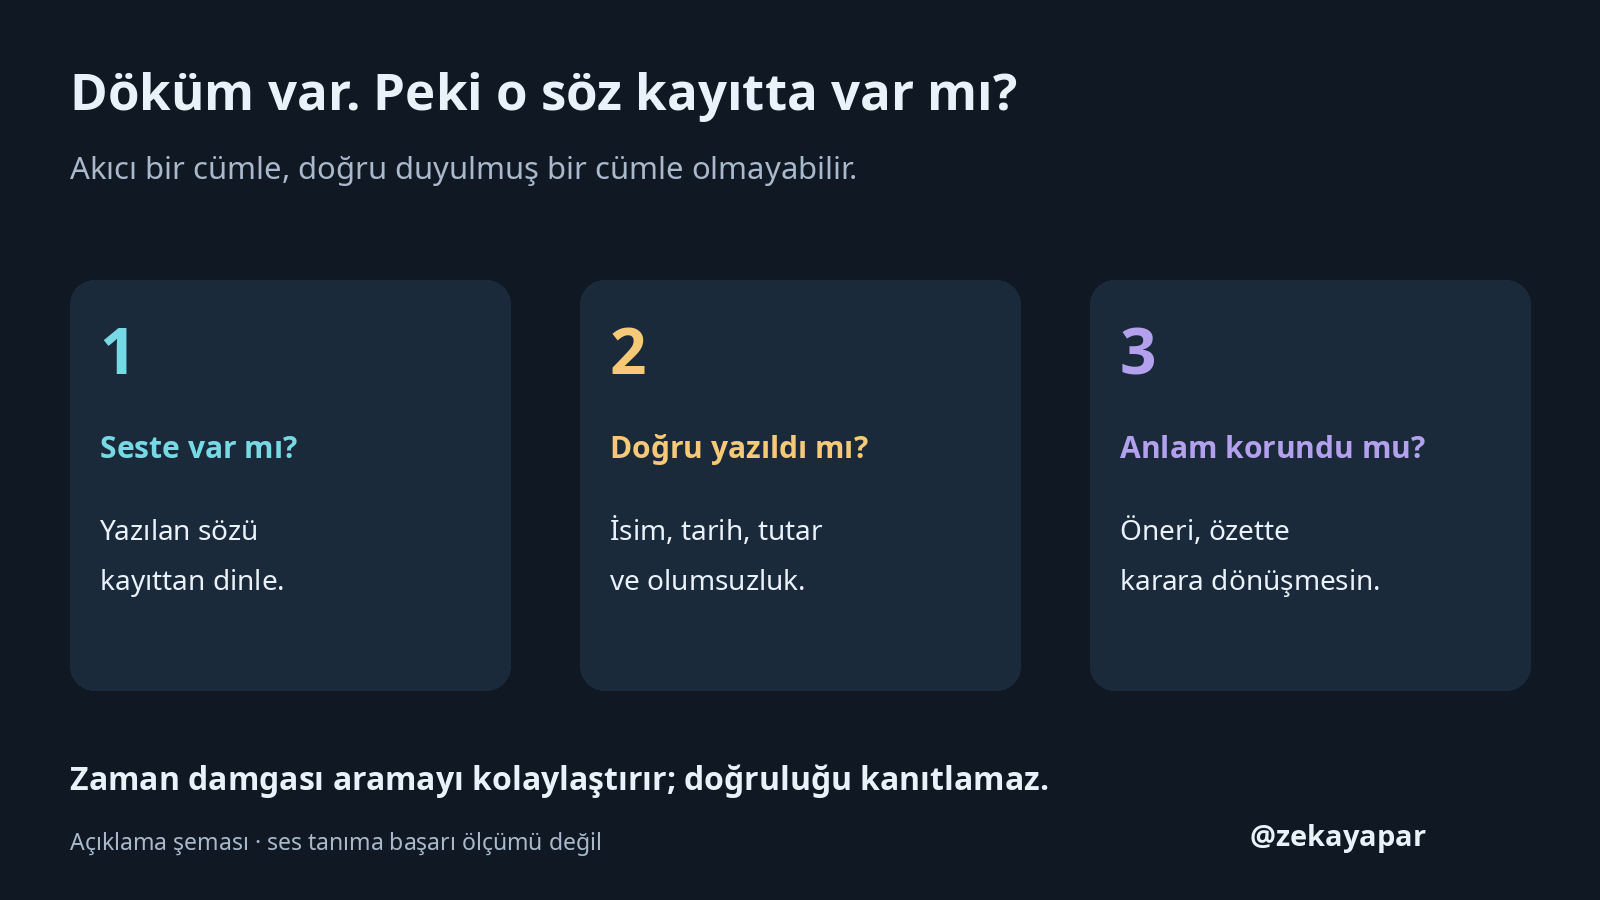
| Hata türü | Neyi kontrol ederim? | Neden önemli? |
|---|---|---|
| Yanlış duyulan söz | Kayıtta konuşma var; ama isim, sayı veya kelime yanlış yazılmış mı? | Bir tutar, tarih veya olumsuzluk anlamı değiştirebilir. |
| Seste olmayan metin | Yazılı cümlenin ses kaydında gerçekten karşılığı var mı? | Okunaklı bir ekleme, konuşmacıya söylemediği bir sözü atfedebilir. |
| Özette değişen anlam | Doğru döküm, özetlenirken karar veya kesin bilgi gibi mi sunulmuş? | İlk aşama doğru olsa bile son metin yanlış olabilir. |
Temsili bir örnek: “Salı günü gönderebiliriz” ile “Salı günü göndereceğiz” arasında küçük bir yazı farkı, büyük bir kesinlik farkı var. Bu iki cümle bir testten alınmadı; kontrolün neden yalnız yazım yanlışlarına bakmaktan ibaret olmadığını göstermek için kullanıyorum. Bir toplantı özetinde önce dökümün sese uyduğunu, sonra özetin döküme uyduğunu ayrı ayrı denetlemek gerekiyor.
Türkçe döküm mü istiyorum, çeviri mi?
Whisper belgelerinde iki ayrı görev var: konuşmayı aynı dilde yazıya çevirme ve konuşmayı İngilizceye çevirme. Türkçe bir kaydın Türkçe dökümünü istiyorsam, aradığım şey ilk görev. Uygulamadaki “çevir” seçeneği yalnız metni daha temiz yazan bir ayar değil; çıktının dilini ve amacını değiştirebilir. Sürüm desteği de aynı değil: OpenAI deposu, turbo modelinin çeviri için eğitilmediğini ve çeviri görevinde de özgün dili döndürdüğünü belirtiyor.
Whisper large-v3 model kartı, sesin dilini otomatik tahmin edebildiğini, dil önceden biliniyorsa ayrıca belirtilebildiğini söylüyor. Türkçe kayıtta dil seçimini kontrol etmek bu yüzden makul bir ilk adım. Ama “Türkçe seçtim, artık hata yapmaz” sonucu çıkmıyor. OpenAI deposu da başarının dillere göre değiştiğini belirtiyor; İngilizce için verilmiş bir hız veya doğruluk sonucunu Türkçe kaydın garantisi olarak okumamak gerekiyor.
Sessiz bölümü atlamak yardımcı olabilir; doğrulamanın yerine geçmez
faster-whisper, konuşma olmayan bölümleri filtrelemek için Silero VAD adlı konuşma etkinliği algılama modelini kullanabiliyor. Bu bölümün yaptığı iş, sesin hangi parçalarında konuşma bulunduğunu ayırmak. Söylenen cümlenin doğru yazıldığını denetlemek değil.
İncelediğim README’de tekil döküm çağrısında vad_filter=True ile bu filtrenin açılması gösteriliyor; toplu döküm yolunda ise varsayılan olarak açık olduğu yazıyor. Dolayısıyla “Whisper kullanıyorum, filtre de kesin açıktır” demek yerine kullanılan uygulamanın gerçek ayarına bakmak daha doğru. Bu rehberde VAD açık/kapalı ölçümü yapmadım; hatayı ne kadar azalttığına dair yeni bir oran vermiyorum.
Konuşma filtresi de bir model olduğundan, yalnız filtrelenmiş metni saklamak yerine özgün kaydı korumayı tercih ederim. Şüpheli bir yerde soru, “ayar açık mı?” ile bitmiyor: çıkarılan ya da yazıya dönüşen parçanın kayıtta ne olduğuna dönmek gerekiyor.
Zaman damgası, cümlenin doğruluk mührü değil
Hem Whisper large-v3 kartında hem faster-whisper belgelerinde zaman damgalı çıktı seçenekleri var. faster-whisper kelime düzeyinde zaman bilgisi de verebiliyor. Bunların pratik faydası, metindeki şüpheli bölüme seste daha hızlı dönebilmek.
Fakat bir cümlenin yanında başlangıç ve bitiş zamanı yazması, o cümlenin doğru olduğuna bağımsız kanıt sağlamıyor. Zaman bilgisi de sistemin ürettiği çıktının bir parçası. Ben bunu “bu söz doğrulandı” etiketi yerine, “burayı dinleyerek kontrol et” işareti olarak kullanmayı öneriyorum.
Benzer biçimde, cümlelerin ayrılmış olması kimin konuştuğunun doğrulandığı anlamına gelmiyor. OpenAI’nin model kartı, konuşmacı ayrımı gibi ek kullanım alanlarının sağlam biçimde değerlendirilmediği konusunda uyarıyor. Bir uygulama ayrıca konuşmacı etiketleri veriyorsa, bu özelliği yalnız “Whisper var” bilgisiyle doğrulanmış saymamak gerekir.
Bir kaydı teslim etmeden önce nasıl kontrol edebilirim?
- Özgün ses kaydını koru. Ham döküm ile sonradan düzeltilmiş sürümü ayrı tut; bir düzeltmenin sesten mi, tahminden mi geldiği kaybolmasın.
- İlk işi netleştir. Aynı dilde döküm mü, çeviri mi, özet mi istendiğini belirle. Bunları tek bir “metne çevir” işlemi gibi görme.
- Önce kritik ayrıntıları dinle. Kişi adları, para, tarihler, “değil”, “olabilir” ve “yapılacak” gibi anlamı belirleyen sözleri kayıttan doğrula. Bu önceliklendirme tam kontrolün yerine geçmez.
- Şüpheli bölümü zamanı üzerinden bul. Tekrarlayan cümleler, kopuk geçişler veya konuşmasız bölüme denk gelen metin varsa doğrudan sesi aç. Metne bakarak akla yatkın bir karşılık uydurma.
- Duyulmayanı işaretle. Anlaşılamayan yeri tahminle doldurmak yerine “[anlaşılamadı]” gibi açık bir not ve ilgili zaman aralığı bırak. Bu, benim önerdiğim çalışma biçimi; modelin garantili davranışı değil.
- Özeti en son denetle. Bir öneri karara, belirsiz bir ifade kesin tarihe dönüştürülmüş mü? Son metni kontrol edilmiş dökümle karşılaştır.
Bu liste bir doğruluk sertifikası vermiyor. Yalnız kritik ayrıntıları dinlediysem dosyanın tamamına “birebir kontrol edildi” yazamam. Tıbbi, hukuki veya başka yüksek riskli bir kullanımda kontrol ihtiyacı daha da önemli: OpenAI’nin model kartı, doğruluk hatalarının sonuçları ağırlaştırabileceği yüksek riskli karar alanlarında kullanıma karşı ayrıca uyarıyor.
Benim için sonuç: döküm bir başlangıç, tutanak değil
Ses tanımanın faydası, uzun kaydı aranabilir ve düzenlenebilir bir taslağa dönüştürmesi. Ama bir konuşmacının ne söylediği konusunda son dayanak hâlâ ses kaydı. “Model düzgün bir paragraf yazdı” ile “bu paragrafı kayıttan doğruladım” arasındaki farkı görünür tutmak, daha pahalı bir modele geçmekten önce çözülebilecek bir iş akışı meselesi.
Özellikle bir başkasına ait sözü yayımlarken kontrol sorum şu olur: Bu ifadeyi gerçekten duydum mu, yoksa yalnız ekranda mı okudum? Modelin uyarısını ciddiye almak, aracı kullanmamak demek değil; çıktıya hangi aşamada güvenebileceğini bilmek demek.
Kaynaklar, kapsam ve sınırlar
Bu yazı 17 Kasım 2026’da incelenen resmî model ve proje belgelerine dayanan bir rehberdir. Yeni ses tanıma deneyi, Türkçe doğruluk ölçümü, hız yarışı veya model sıralaması yapılmadı. Temsili cümleler model çıktısı değildir; şema ölçüm verisi göstermez. Genel Whisper model kartındaki eğitim sayıları farklı sürümlere doğrudan taşınmadı; large-v3 için ayrı kart da kontrol edildi.
- OpenAI Whisper model kartı: Performance and Limitations; Model Use. Seste bulunmayan metin, tekrarlar, dil farklılıkları ve yüksek riskli kullanım uyarıları.
- Whisper large-v3 model kartı: Usage; Performance and Limitations. Dil seçimi, döküm/İngilizce çeviri ayrımı ve zaman damgaları. Kart, bazı kısımlarının Hugging Face ekibince yazıldığını ayrıca belirtiyor.
- faster-whisper README: Word-level timestamps; VAD filter. Kelime zamanı ve konuşmasız bölümleri filtreleme seçenekleri. faster-whisper bir çalıştırma kütüphanesi; ayrı bir Türkçe başarı garantisi değil.
- OpenAI Whisper deposu: Available models and languages; Command-line usage. Dillere göre performans değişimi ve görev seçimi.
Kaynakların sürüm kimlikleri ve SHA-256 özetleri, yeniden kontrol için kaynak kayıt dosyasında bulunuyor. Önerilen kontrol listesi bu belgelerden hareketle hazırlanmış editoryal bir iş akışı; kaynakların yaptığı kontrollü bir deneyin sonucu gibi sunulmuyor. Kayıtların izinli kullanımı ve kişisel veri sorumlulukları ayrıca değerlendirilmelidir.