 zekayapar
Geri yayılım ve LeNet: el yazısı okuyan yapay zekâyı sıfırdan eğittim
Geri yayılımı NumPy ile sıfırdan yazdım, LeNet-5 benzeri ağı MNIST’te 57 saniyede eğittim: %98,93 doğru. Yazı tiplerinde %97,9, ön işlemesiz %7,6. Ham kayıtlarla.
Deneyler ve ortam
- Tek RTX 5090 · CUDA 13.2
- Python 3.12.15 · NumPy 2.3.5
- PyTorch 2.13.0+cu132 · torchvision 0.28.0
Ağlar ve veri
- Geri yayılım yalnız NumPy ile · 2-2-1 sigmoid ağ (XOR)
- LeNet-5 benzeri evrişimli ağ · 61.706 parametre · 20 tur
- MNIST 60.000 eğitim / 10.000 test · 136 yazı tipi · kalem taklidi programı
Video
- Sahneler: Qwen-Image 2.1 + Wan2.2 (temsilî canlandırma, yerel)
- Ses: ElevenLabs · bu bölümde dil modeli kullanılmadı
1989, New Jersey. Bir kamera el yazısı rakamlara bakıyor ve saniyede on rakamdan fazlasını okuyor. Ona kimse yedinin neye benzediğini söylememiş; bunu zarflardan kesilmiş binlerce rakamdan kendisi öğrenmiş. Ben de bu ağın torunu sayılabilecek LeNet-5’e çok yakın bir ağı kendi bilgisayarımda sıfırdan eğittim. Sonra ona hiç görmediği rakamlar gösterdim; beklemediğim yerlerde yanıldı.
Bu, Yapay zekâ tarihi serimin 3. bölümü. Her bölümde bir dönüm noktasını anlatıp kendi bilgisayarımda gerçekten çalıştırıyorum. Bu bölümde önce geri yayılımı hiçbir yapay zekâ kütüphanesi kullanmadan, yalnız NumPy ile yazdım. Sonra LeNet-5 benzeri ağı MNIST’te PyTorch ile eğittim ve son olarak bilgisayarımdaki yazı tipleriyle, kalem hareketini taklit eden küçük bir programın çizdiği rakamlarla sınadım. Bu bölümde dil modeli kullanmadım; aşağıdaki bütün sayılar demo kodlarının ham kayıtlarından.
Perceptron’un bıraktığı soru
Önceki bölümde tek katmanlı Perceptron’un XOR’u öğrenemediğini kendi denememde görmüştüm: iki girişten yalnızca biri açıkken “evet” diyen basit bir kural. Minsky ile Papert’in 1969 tarihli Perceptrons kitabı bu tür sınırları matematikle inceledi. Çözüm belliydi: araya bir katman eklemek.
Ama ara katmanın doğru cevabını kimse bilmiyor. Çıkıştaki hatayı görüyorsunuz; peki o hatada içerideki hangi bağlantının ne kadar payı var? Geri yayılım bu sorunun cevabı.
Matematik çoktan vardı, gündeme 1986’da girdi
Türevleri sondan başa doğru hesaplamanın genel yöntemini 1970’te Helsinki’de Seppo Linnainmaa yüksek lisans tezinde yazdı; konusu sinir ağları değil, yuvarlama hatalarıydı (1976’da BIT dergisinde yayımladığı makalenin kaynakçasında bu teze yer veriyor). Paul Werbos 1974’te Harvard’daki doktora tezinde bu hesabı tahmin modellerinde kullandı ve sinir ağlarına benzeyen sistemleri tartıştı; açık bir sinir ağı uygulamasını 1982’de yayımladı.
Fikri herkesin gündemine sokan makale 9 Ekim 1986 tarihli Nature sayısında çıktı: David Rumelhart, Geoffrey Hinton ve Ronald Williams, Learning representations by back-propagating errors. Yöntem iki geçiş: ileri geçişte girişten çıkışa hesaplıyorsunuz; geri geçişte çıkıştaki hatadan başlayıp her bağlantının bu hataya katkısını katman katman geriye doğru buluyor ve her ağırlığı hatayı azaltacak yönde biraz itiyorsunuz.
Makalenin asıl iddiası başlığında: ara katmandaki birimler, kimse söylemeden, işe yarayan özellikleri kendileri temsil etmeye başlıyor. Örneklerden biri altı bitlik girişte ayna simetrisini bulan küçücük bir ağ; 1.425 turda öğreniyor. Bir de ayrıntı: makalenin kaynakçasında Paris’te genç bir doktora öğrencisinin 1985 tarihli çalışması da var. Adı Yann LeCun.
Geri yayılımı NumPy ile sıfırdan yazdım
Bunu anlamanın en iyi yolu yazmaktı. İki giriş, iki gizli birim, bir çıkış; sigmoid birimler ve makaledeki denklemler. Geri geçişin tamamı şu birkaç satır:
xor_numpy.py dosyasından özgün kesit (gizli katman dalı):
# geri geçiş (zincir kuralı, elle)
dy = y - D
dx2 = dy * y * (1 - y)
if hidden:
    gW2 = h.T @ dx2; gb2 = dx2.sum(0)
    dh = dx2 @ P[2].T
    dx1 = dh * h * (1 - h)
    gW1 = X.T @ dx1; gb1 = dx1.sum(0)
Gerçek XOR girdileri ve değişmemiş sonuç alanları
Tam ham kayıt indirme bölümünde; aşağıdaki JSON seçilmiş alanların aynısıdır, yeni bir çalıştırma değildir.
{
  "giris": [
    [
      0,
      0
    ],
    [
      0,
      1
    ],
    [
      1,
      0
    ],
    [
      1,
      1
    ]
  ],
  "hedef": [
    0,
    1,
    1,
    0
  ],
  "ilk_deneme_tohum1": {
    "seed": 1,
    "final_E": 0.25015,
    "outputs": [
      0.0078,
      0.4999,
      0.9932,
      0.5001
    ]
  },
  "ana_kosu": {
    "seed": 2,
    "final_E": 0.000102,
    "outputs": [
      0.0066,
      0.9932,
      0.9932,
      0.0083
    ],
    "hidden_activations": [
      [
        1.0,
        0.952
      ],
      [
        0.934,
        0.018
      ],
      [
        0.933,
        0.016
      ],
      [
        0.062,
        0.0
      ]
    ],
    "weights": {
      "W1": [
        [
          -5.382,
          -7.104
        ],
        [
          -5.36,
          -6.984
        ]
      ],
      "b1": [
        8.017,
        2.978
      ],
      "W2": [
        11.423,
        -11.513
      ],
      "b2": [
        -5.485
      ]
    }
  }
}
İlk denemede ağ takıldı. Hata 0,25’e inip orada kaldı; dört çıkıştan ikisi tam ortada, 0,4999 ve 0,5001 değerinde bekliyordu. Geri yayılımın bilinen bir huyu: yokuş aşağı inerken yanlış bir çukura düşebiliyor.
İkinci rastgele başlangıçta (tohum 2) ağın hata eğrisinde 140. tur, 0,05’in altındaki ilk kayıt noktasıydı; 5.000 turun sonunda hata 0,000102 oldu. Bunun şans olup olmadığını görmek için 100 farklı başlangıç denedim: 76’ü çözdü, 24’ü takıldı. Gizli katmanı kaldırınca ise ağ hiç öğrenemedi: dört çıkışın dördü de 0,5.
| Giriş | XOR | Gizli birim 1 | Gizli birim 2 | Ağın çıkışı |
|---|---|---|---|---|
| 0 0 | 0 | 1 | 0,952 | 0,0066 |
| 0 1 | 1 | 0,934 | 0,018 | 0,9932 |
| 1 0 | 1 | 0,933 | 0,016 | 0,9932 |
| 1 1 | 0 | 0,062 | 0 | 0,0083 |
En güzel kısmı içerideydi. Birinci gizli birim, iki giriş birden açık değilse yanmayı öğrenmiş; ikincisi yalnız ikisi de kapalıyken yanıyor. Çıkış ilkini artı (11,423), ikincisini eksi (-11,513) ağırlıkla alıyor ve XOR ortaya çıkıyor. Bunu ben söylemedim; ağ kendisi buldu. Burada ayrı test seti yok: XOR’un dört satırı hem eğitimde hem kontrolde kullanılıyor.
LeCun, Bell Labs ve posta kodları
LeCun 1988’de AT&T’nin Bell Laboratuvarları’na katıldı. Kendi anlatımına göre ilk hedef, mektupları otomatik ayıran makineler için el yazısı okumaktı. Veri ABD Posta Servisi’nden geldi: Buffalo postanesinden geçen zarflardaki posta kodlarından kesilmiş 9.298 rakam (7.291 eğitim, 2.007 test); pek çok farklı insan, farklı kalemlerle yazmış. Rakamlar 16×16 piksele küçültüldü. Her pikselin her birime bağlandığı sıradan ağlar da denendi, ama makaleye göre yeni örneklerde oldukça kötü sonuç verdiler.
LeCun’un çözümü evrişim. 5×5 piksellik küçük bir pencere görüntünün üzerinde kayıyor ve nereye giderse gitsin aynı 25 ağırlığı kullanıyor: sol üstte bir kenarı tanıyan dedektör sağ altta da tanıyor. Sonra çözünürlük yarıya iniyor; özelliğin tam yeri değil, yaklaşık yeri önemli. Sonuçta 64.660 bağlantı var ama öğrenilecek bağımsız sayı yalnız 9.760. Fikrin kökü biyolojide: Hubel ve Wiesel’in kedilerin görme korteksinde bulduğu, küçük bir bölgeye bakan hücreler. Fukushima’nın Neocognitron’u benzer bir yapıyı 1980’de kurmuştu, ama onu geri yayılım gibi bir yöntemle eğitmenin yolu yoktu.
Ağ eğitim verisinin üzerinden 23 kez geçti; bir Sun iş istasyonunda 3 gün sürdü. Test setindeki 2.007 rakamın 102’sini yanlış okudu, yaklaşık %5. Eğitilen ağ, kişisel bilgisayara takılı bir sinyal işlemci kartında saniyede 10–12 rakam sınıflandırıyordu. Makaleye göre hataların çoğu rakamların birbirinden yanlış ayrılmasından geliyordu.
LeNet-5, MNIST ve çekler
1998’de LeCun, Bottou, Bengio ve Haffner LeNet-5’i anlatan uzun bir makale yayımladı: 7 katman, yaklaşık 60.000 öğrenilen parametre. Bu makaleyle bir veri seti de efsaneleşti: MNIST. ABD’nin standartlar enstitüsü NIST’in iki koleksiyonundan, Nüfus Bürosu çalışanlarının ve lise öğrencilerinin yazdığı rakamlardan hazırlandı: 60.000 eğitim, 10.000 test görüntüsü, her biri 28×28 piksel.
Makaleye göre LeNet-5 test setinde %0,95 hata yaptı; eğitimi 200 MHz’lik tek işlemcili bir sunucuda 2–3 gün sürüyordu. Ve bu ağ gerçek dünyaya çıktı: makaleye göre LeNet’li çek okuma sistemi Haziran 1996’dan beri ABD’de birçok bankada çalışıyor, her gün milyonlarca çek okuyordu. LeCun’un sayfasına göre makineyi NCR üretiyordu.
LeNet-5 benzeri ağı MNIST’te eğittim
MNIST’i indirdim ve LeNet-5’e çok yakın bir ağı PyTorch ile yazdım: iki evrişim, iki küçültme, üç tam bağlı katman, 61.706 parametre. Makaledeki gibi 20 tur eğittim, tek bir RTX 5090’da.
Yirmi turun tamamı 57,53 saniye sürdü. İlk turun sonunda test doğruluğu %97,38, yirminci turda %98,93. On bin test rakamından 107’sini yanlış okudu; hatam %1,07. Yani makaledeki %0,95’e yaklaştım ama geçemedim. %99’a hiçbir turda ulaşmadı; en iyi tur 15. tur, %98,99.
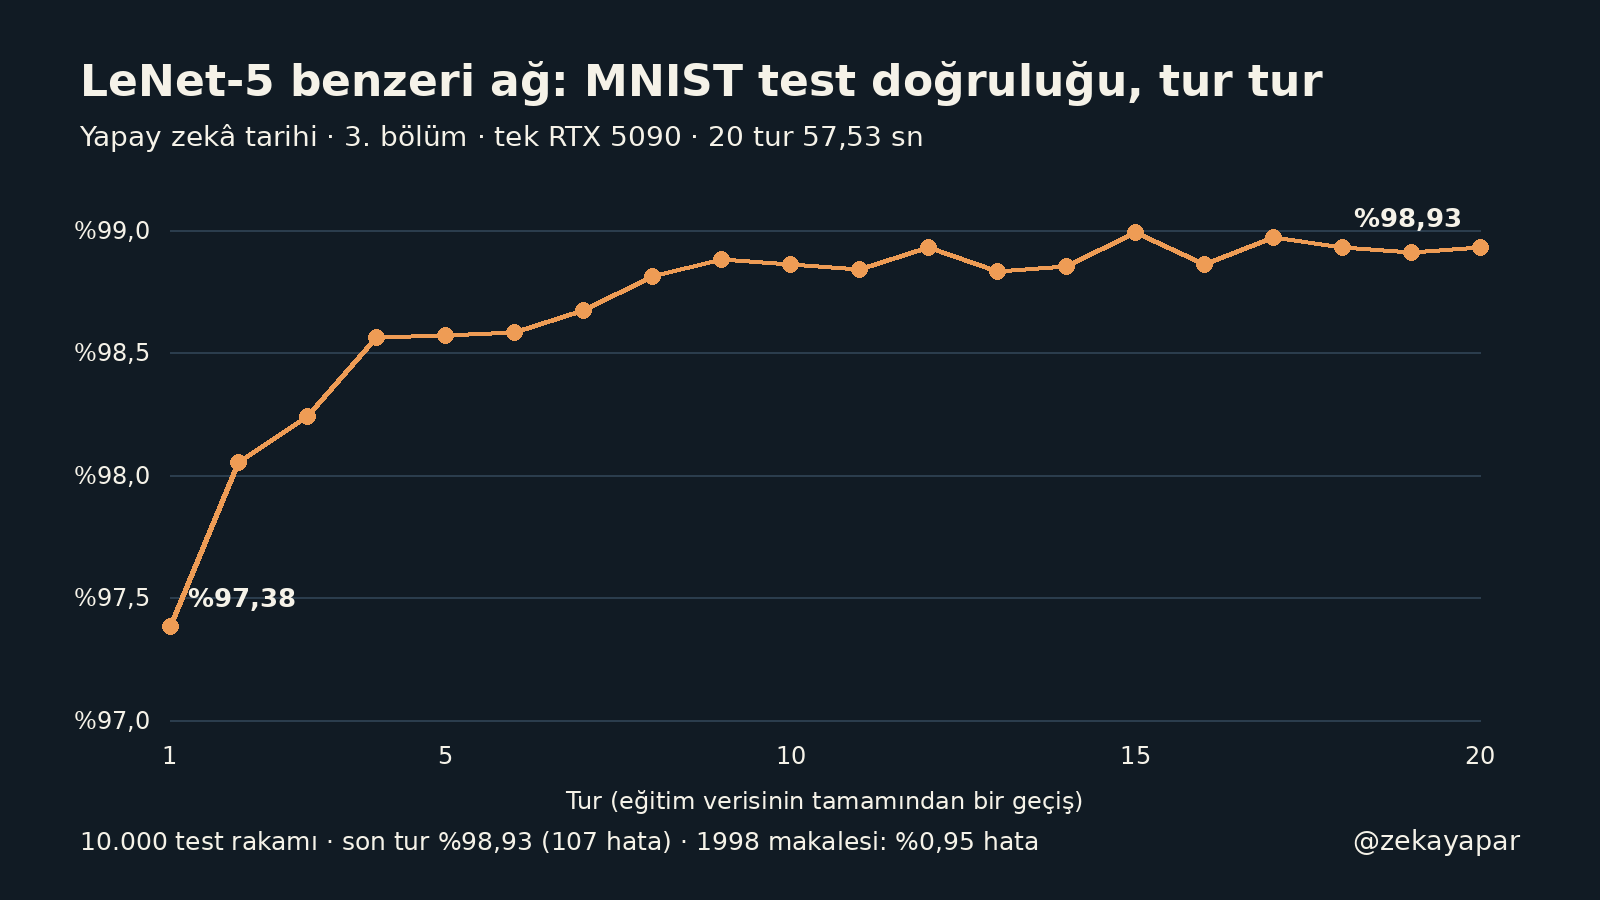
lenet-sonuc.json): her turun sonunda 10.000 test rakamındaki doğruluk. Dikey eksen %97’den başlıyor; farklar küçük olduğu için yakınlaştırıldı.LeNet’in gerçek kodu ve ham sonuç kesiti
lenet_mnist.py içindeki ağ tanımı aynen aşağıda. JSON ise lenet-sonuc.json içinden seçilmiş alanlar; en emin iki yanlış da düzeltilmeden korunuyor.
class LeNet5(nn.Module):
    def __init__(self):
        super().__init__()
        self.c1 = nn.Conv2d(1, 6, 5, padding=2)    # 28x28 -> 28x28 (32x32 girişe eşdeğer)
        self.c3 = nn.Conv2d(6, 16, 5)               # 14x14 -> 10x10
        self.c5 = nn.Linear(16 * 5 * 5, 120)
        self.f6 = nn.Linear(120, 84)
        self.out = nn.Linear(84, 10)

    def forward(self, x, maps=False):
        a1 = torch.tanh(self.c1(x)); s2 = Fn.avg_pool2d(a1, 2)
        a3 = torch.tanh(self.c3(s2)); s4 = Fn.avg_pool2d(a3, 2)
        h = torch.tanh(self.c5(s4.flatten(1))); h = torch.tanh(self.f6(h))
        y = self.out(h)
        return (y, a1, a3) if maps else y
{
  "parametre_sayisi": 61706,
  "tur_sayisi": 20,
  "toplam_egitim_sn": 57.53,
  "son_test_dogruluk": 0.9893,
  "son_test_hata_sayisi": 107,
  "ilk_yuzde99_tur": null
}
{
  "hatalar_ilk_iki": [
    {
      "indeks": 3767,
      "dogru": 7,
      "tahmin": 2,
      "guven": 1.0,
      "ikinci": 8,
      "ikinci_olasilik": 0.0,
      "dogru_sinif_olasilik": 0.0
    },
    {
      "indeks": 9009,
      "dogru": 7,
      "tahmin": 2,
      "guven": 1.0,
      "ikinci": 7,
      "ikinci_olasilik": 0.0,
      "dogru_sinif_olasilik": 0.0
    }
  ]
}
Makaledeki ağı birebir kopyalamadım. Farkları açıkça yazayım:
- C3 tam bağlantılı (makalede seyrek tablo)
- çıkış doğrusal+çapraz entropi (makalede RBF)
- Adam lr 1e-3, 8 turda bir x0.3 (makalede diyagonal Levenberg-Marquardt)
- veri artırma yok
Asıl şaşırdığım şu oldu: aynı ağın bir turunu ekran kartı yerine işlemcide (16 iş parçacığı) çalıştırdım; 3,6 saniye. Ekran kartında ilk tur 2,56 saniyeydi. Bu kadar küçük bir ağda kart pek fark yaratmıyor; 1998’de günler süren iş bugün saniyeler. Bu tek turluk bir ölçüm, kapsamlı bir hız karşılaştırması değil.
Yanlış okuduklarına da baktım. En emin olduğu iki hatada doğru cevap 7, ağın cevabı 2 ve kayıttaki güven 1 (dört basamağa yuvarlanmış). Videoda gösterdiğim bu görüntüler ortası çizgili yediler. Diğer hataların bir kısmında ben de tereddüt ederdim.
Hiç görmediği rakamlar: yazı tipleri
En doğalı kendi el yazımı okutmak olurdu, ama bu deney için elle yazılmış rakamım yoktu. O yüzden iki başka yol denedim.
Birincisi bilgisayarımdaki bütün yazı tipleri: rakam içeren 245 dosyadan, aynı piksel çıktısını verenleri tekilleştirince rakamları farklı çizilen 136 tane kaldı. Birinde rakamların yerinde semboller vardı (Dingbats), onu saymadım. Her rakamı MNIST’teki gibi hazırladım: siyah zeminde beyaz, 20×20 kutuya sığdırılmış, kütle merkezi 28×28’in ortasında.
1.360 rakamın 1.331’ini doğru okudu: %97,9. En çok zorlandığı rakam altı: 136 çizimin 122’sinde doğru. Bazı tırnaklı yazı tiplerinde dokuzu dört sanıyor: Noto Serif Display’in dört stili, Nimbus Roman Bold ve Bold Italic, Liberation Serif Bold.
| Rakam | 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 |
|---|---|---|---|---|---|---|---|---|---|---|
| Doğru (136 çizimde) | 136 | 134 | 134 | 136 | 133 | 135 | 122 | 136 | 136 | 129 |
Sonra aynı rakamları MNIST hazırlığı olmadan, beyaz kâğıtta siyah mürekkep gibi ve kutuyu dolduracak boyutta verdim. Doğruluk %7,57’ye düştü (103 doğru); 1.360 rakamın 988’ine sıfır dedi. Ölçeği doğru bırakıp yalnız renkleri ters çevirmek bile yetiyor: doğru sayısı 85’e iniyor.
Yani ağ rakamı değil, MNIST’teki bir rakamın neye benzediğini öğrenmiş: siyah zemin, beyaz mürekkep, ortada küçük bir şekil.
Kalem taklidi: birlerimin şapkası
İkinci yol olarak kalem hareketini taklit eden küçük bir program yazdım. Her rakam için çizgileri ve yayları tanımladım; program eğimi, boyu, kalınlığı ve titremeyi her seferinde rastgele değiştiriyor. Rakam başına 100 örnek, sabit tohumla.
1.000 örneğin 965’ini doğru okudu. Sıfır, iki, üç, dört, beş, yedi ve dokuzda hiç hata yok. Ama birlerimin 11’ini yedi, 8’ini dokuz sandı; altıların 11’ini beş, 4’ünü sıfır. Sekizlerden biri dokuz oldu.
| Rakam | 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 |
|---|---|---|---|---|---|---|---|---|---|---|
| Doğru (100 örnekte) | 100 | 81 | 100 | 100 | 100 | 100 | 85 | 100 | 99 | 100 |
Benim birlerimin tepesinde küçük bir şapka var. Şapkayı kaldırıp yalnızca düz bir çubuk çizdirdim: yeni çizilen 100 örneğin 100’ünü de doğru okudu. Sorun büyük ölçüde o küçük şapkadaymış.
Bu rakamları bugünün yerel modeline de göstermek isterdim, ama bilgisayarımdaki Qwen servisi yalnızca metin moduyla çalışıyor, görüntü göremiyor. Bu yüzden görüntü testi yapmadım; bu bölümde hiçbir dil modeline istem gönderilmedi.
Bende kalan
LeNet-5 bugün bakınca minicik. Ama geri yayılım hiçbir yere gitmedi: bu ağı eğiten PyTorch da türevleri aynı fikirle, sondan başa doğru hesaplıyor. LeCun, Hinton ve Bengio 2018’de Turing Ödülü’nü paylaştı; Hinton 2024’te Nobel Fizik Ödülü’nü de aldı.
1989’da 3 gün süren eğitim bende bir dakika sürmedi. Ama makinenin dünyası hâlâ gördüğü örnekler kadar: MNIST’e benzemeyen bir rakamda tam bir eminlikle yanılabiliyor. ELIZA’da kuralları elle yazmıştım, Perceptron’da ağırlıkların hatalardan çıktığını gördüm; burada içerideki katmanların kendi özelliklerini bulduğunu gördüm.
Sıradaki bölümde (15 Kasım) 1997’ye gidiyorum: Deep Blue ve Garri Kasparov. Bir yıl önce Philadelphia’da Deep Blue ilk oyunu kazanmış, bir bilgisayar normal süre kurallarında ilk kez dünya şampiyonunu yenmişti; ama maçı Kasparov 4–2 aldı. Rövanşı kendi bilgisayarımda bir satranç motoruyla anlatacağım.
Yöntem, sınırlar, kaynaklar ve indirilebilir kayıtlar
Deney ortamı
| Bileşen | Değer |
|---|---|
| Ekran kartı (LeNet ve yazı tipi testi) | NVIDIA GeForce RTX 5090 · tek kart · CUDA 13.2 |
| İşlemci (1 turluk karşılaştırma) | AMD Ryzen Threadripper PRO 5955WX 16-Cores · 16 iş parçacığı |
| Python · NumPy | 3.12.15 · 2.3.5 |
| PyTorch · torchvision | 2.13.0+cu132 · 0.28.0+cu132 |
| Tepe GPU belleği (LeNet eğitimi) | 107,2 MiB |
| Deney tarihi | 2026-10-26 |
Ölçütler ve sınırlar
- Süre tanımı:
toplam_egitim_sn, eğitim döngüsüyle tur sonlarındaki test değerlendirmelerini kapsar; veri indirme, model kurma ve son dosya yazımı dışarıdadır. CPU/GPU tur süreleri ise tur sonu test değerlendirmesini içermez. XOR hata eğrisi 10 turda bir kaydedildi: 140. tur, E<0,05 koşulunun ilk görüldüğü kayıt noktasıdır; kesin ilk geçiş turu değildir. - XOR: 2-2-1 sigmoid ağ, tüm dört örnek üzerinden toplanan gradyan + momentum (ε=0,5, α=0,9), 5.000 tur, başlangıç ağırlıkları U(-1,1), hata E = 1/2 * toplam (y-d)^2. “Çözdü”, kayıttaki
solvedalanı. Ana koşu seçimi: 1. tohumdan sonra hatası 0,1’in altına inen ilk tohum (tohum 2). XOR bir genelleme deneyi değil. - LeNet: mimari
giriş 28x28(+2 dolgu=32x32) · C1 6@5x5 tanh · S2 ort.havuz · C3 16@5x5 tanh · S4 ort.havuz · C5 120 · F6 84 · 10; yığın 64, PyTorch tohumu 0. Test seti her turun sonunda ölçüldü ama ağırlık seçimi veya erken durdurma için kullanılmadı; bildirilen sonuç 20. turun ağı. Tek koşu; farklı tohumlarla tekrar etmedim, bu yüzden 0,1 puanlık farkları yorumlamıyorum. - 1989 ağının (16×16, 2.007 test rakamı) ve 1998 LeNet-5’in sonuçları makalelerden; benim koşum MNIST üzerinde ve farkları yukarıda yazılı. Süreleri farklı veriler, yöntemler ve donanımlar arasında doğrudan kıyaslamıyorum; “günler yerine saniyeler” yalnızca büyüklük farkını anlatıyor.
- Yazı tipi testi el yazısı değil; matbaa rakamları. Aynı piksel çıktısını veren yazı tipleri tek sayıldı. Kalem taklidi benim tanımladığım yollardan çizildi (tohum 2026; düz çubuklu 1 ek deneyi tohum 2027); gerçek bir insanın el yazısını temsil ettiğini iddia etmiyorum.
- Bu bölümde dil modeli kullanılmadı; yerel Qwen servisi görüntü almadığı için görüntü testi yapılmadı.
- MNIST verisi yeniden dağıtılmıyor; kod onu
torchvisionile indiriyor, dosya MD5’leriORTAM.jsonvelenet-sonuc.jsoniçinde. Eğitilmiş ağırlık dosyası ve görüntü arşivleri de yayımlanmadı. - Grafik ham kayıttan çizildi. Videodaki üretilmiş tarih sahneleri temsilî canlandırma (yerel modeller: Qwen-Image 2.1 + Wan2.2); gerçek arşiv görüntüsü diye sunulmuyor. Seslendirme ElevenLabs ile yapıldı; arşiv fotoğrafları Wikimedia Commons’tan (CC BY-SA 2.0/4.0, NIST kamu malı).
Kaynaklar
- David E. Rumelhart, Geoffrey E. Hinton, Ronald J. Williams (1986), Learning representations by back-propagating errors, Nature 323, 533–536
- Yann LeCun ve diğerleri (1989), Backpropagation Applied to Handwritten Zip Code Recognition, Neural Computation 1(4), 541–551
- Yann LeCun, Léon Bottou, Yoshua Bengio, Patrick Haffner (1998), Gradient-Based Learning Applied to Document Recognition, Proceedings of the IEEE 86(11), 2278–2324
- Yann LeCun, Research and Contributions (kişisel sayfa)
- Seppo Linnainmaa (1976), Taylor expansion of the accumulated rounding error, BIT 16, 146–160 (kaynakçasında 1970 Helsinki yüksek lisans tezi)
- Jürgen Schmidhuber, Who Invented Backpropagation? (Werbos 1974 tezi ve 1982 makalesinin tarih/kapsam kontrolü için ikincil kaynak)
- Marvin Minsky ve Seymour Papert (1969), Perceptrons
- IBM Heritage: Deep Blue
- ACM A.M. Turing Ödülü 2018: Bengio, Hinton, LeCun
- Nobel Fizik Ödülü 2024: John J. Hopfield ve Geoffrey Hinton
- PyTorch, Autograd mechanics
Veri: MNIST (LeCun, Cortes, Burges). Lisans bilgisi kaynaklar arasında çelişkili olduğu için veriyi burada paylaşmıyorum.
İndir
Kod ve JSON dosyaları özgün deney dosyalarıyla byte düzeyinde aynı. Kodlardaki makineye özel ayarlar (ör. CUDA_VISIBLE_DEVICES) ORTAM.json’da yazılı. Yeniden çalıştırmak eski sonuç dosyalarının üzerine yazabilir; ayrı bir dizinde deneyin. rakam_testi.py, lenet_mnist.py çalıştırıldığında oluşan lenet5.pt dosyasını kullanır.