 zekayapar
Uzun girdide Qwen: cache, TP2 ve iki model kopyası
Uzun bağlamda bekleme süresi ve aynı iki RTX 5090 üzerinde tek bölünmüş model ile iki bağımsız kopyanın 864 istekli ölçümü.
Model ortamı
- Qwen3.8-27B · NVFP4
- 2× RTX 5090 · kart başına 32 GB
- Threadripper PRO 5955WX
- vLLM · CUDA · BF16 KV
- MTP3 · 16K bağlam
Karşılaştırılan ayarlar
- TP2 tek model · iki TP1 kopya
- Toplam 10 sequence · 2.048 batch tokenı
- 4K / 8K / 16K bağlam bütçesi
- Soğuk girdi · ısıtılmış ortak prefix
Önceki MTP testinde aynı Qwen’in birkaç tokenı önden tahmin etmesinin hız ve doğruluk üzerindeki etkisine bakmıştım. Bu kez soruyu değiştirdim: uzun bir belgeyi birden fazla istekle gönderince bekleme nerede büyüyor? Sonra aynı iki 5090’ı kullanmanın iki yolunu karşılaştırdım: modeli iki karta bölmek veya her kartta tam bir model kopyası çalıştırmak.
İlk çalışmada 288, yerleşim karşılaştırmasında 576 ölçülen istek vardı. Sentetik belgelerdeki üç bilinen kaydı ve bir bulunmayan kaydı sordum. Ölçülen 864 isteğin tamamı beklenen JSON biçiminde doğru yanıt verdi; HTTP hatası veya çıktı sınırında kesilme olmadı. Bu, bu soruların sonucu. Genel belge arama kalitesinin veya gerçek müşteri kapasitesinin ölçümü değil.
Aynı kalan koşullar
Qwen3.8-27B NVFP4, aynı ağırlık revisionı, MTP3, BF16 KV cache ve 16.384 token model limiti kullandım. Yerleşim testinde fiziksel GPU0 ve GPU1 aynı iki RTX 5090’dı; her kart 32 GB VRAM. Makine Threadripper PRO 5955WX ve 256 GB DDR4 RAM. Üçüncü karttaki coder ve embedding bu karşılaştırmaya katılmadı.
Her iki çalışmada da 4K, 8K ve 16K toplam bağlam bütçeleriyle 1, 5 ve 10 eşzamanlı HTTP isteği gönderdim. Gerçek girdi uzunlukları 3.558, 7.653 ve 15.843 tokendı; chat şablonu dahil. En çok 512 çıktı tokenı istedim, model doğal bitişinde durdu. Temperature 0, top_p 1, top_k −1, presence_penalty 0, seed 42; thinking kapalı. 16K girdi üstüne ayrıca 512 token eklemedim; girdi ve istenen çıktı birlikte limite sığıyordu.
Ölçüm başlamadan veri, çalıştırma ve değerlendirme kodu sabitlendi. Isınma ve cache hazırlama çağrılarını sonuçlara katmadım. Her hücre üç ayrı partiden oluşuyor. Tek kullanıcı hücresinde üç, beş istekte 15, on istekte 30 yanıt var; özellikle p95’i bu küçük örnek sayısıyla okumak gerekiyor.
Önce uzun bağlam ve cache
İlk testte üretimde kullandığım TP2/MTP3 profilini değiştirmedim. İki durumu karşılaştırdım: modelin girdiyi ilk kez işlemesi ve girdinin ortak başlangıcının önceden işlenmiş olması. İkinci durumda model, metnin bu kısmı için daha önce yaptığı hesabı yeniden kullanabiliyor. Bu hazır hesapların saklandığı belleğe cache deniyor. İlk durumda her isteğin başlangıcı farklıydı ve önceki hesabı kullanmasını engelleyen ayrı bir cache kimliği vardı. İkinci durumda aynı başlangıcı paylaşan girdilerden önce bir hazırlık isteği gönderdim. Yani yalnız bir ayarı açıp kapatmadım; metnin ortak olması ve önceden işlenmesi birlikte değişti.
| Bağlam bütçesi | Girdi ilk kez işleniyor | Ortak girdi önceden işlendi |
|---|---|---|
| 4K | 12,41 sn | 4,94 sn |
| 8K | 25,39 sn | 5,36 sn |
| 16K | 51,94 sn | 6,14 sn |
Tablo, 10 isteğin tamamının bitişine kadar geçen sürenin üç parti medyanı. Tek bir kişinin yanıt süresi değil. 16K/10 istekte tekil yanıtın medyan ilk token süresi girdi ilk kez işlenirken 27,98 saniye, ortak girdi önceden işlenmişken 2,70 saniyeydi. Medyan toplam yanıt süresi de 45,67’den 6,00 saniyeye indi.
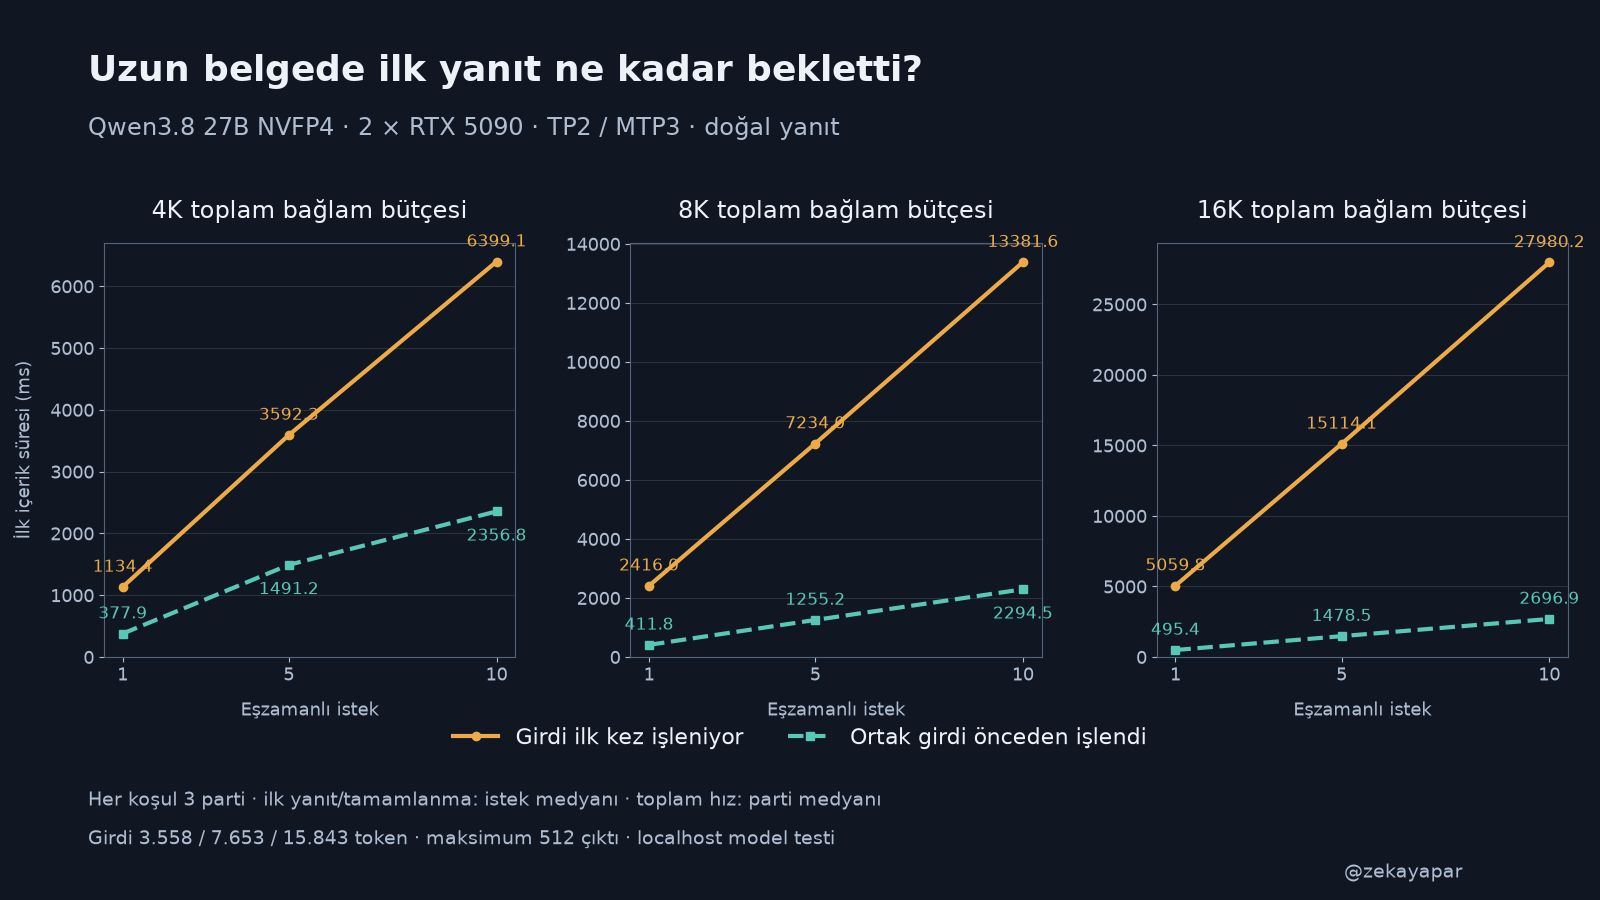
Cache sayaçları da farkı doğruladı: 10 istekli girdinin ilk kez işlendiği koşullarda isabet sıfırdı; ortak kısmı önceden işlenen girdide 4K için %67,5, 8K için %83,6, 16K için %90,9 oldu. Bu kazancın önünde ayrıca ortak girdiyi hazırlayan bir çağrı var; onun süresi bu tablonun dışında.
Sonra aynı iki kartta iki yerleşim
İkinci testte bir TP2 kopya ile iki bağımsız TP1 kopyayı karşılaştırdım. Modelin hassasiyetini veya revisionını tek tarafta değiştirmedim. Önce aynı NVFP4/MTP3 modelin tek kartta 16K ayarıyla açılıp gerçek yanıt verdiğini doğruladım.
Toplam kabul bütçesi iki tarafta da 10 sequence ve 2.048 batch tokenıydı. TP2 tek engine’de 10/2.048; iki kopyada her engine 5/1.024 kullandı. GPU bellek kullanım oranı her kartta 0,9. İki kopyada ağırlıkların iki kez tutulması ve KV havuzlarının ayrılması yerleşimin doğal maliyeti; bunları yapay olarak aynı bellek havuzu hâline getirmedim.
İstekleri istemci tarafında sırayla iki kopyaya dağıttım; 10 istekte beşer, beş istekte üç ve iki istek düştü. Tek kullanıcı tekrarlarında kart seçimi dönüşümlüydü. Üretim routerının yönlendirme veya kuyruk performansını bu teste katmadım. Altı blok sırası TP2, kopyalar, kopyalar, TP2, TP2, kopyalar; her blok yeni model süreçleri ve ayrı ısınmayla başladı. Eşlenmiş tekrarlar aynı mesajları ve aynı parti sırasını kullandı.
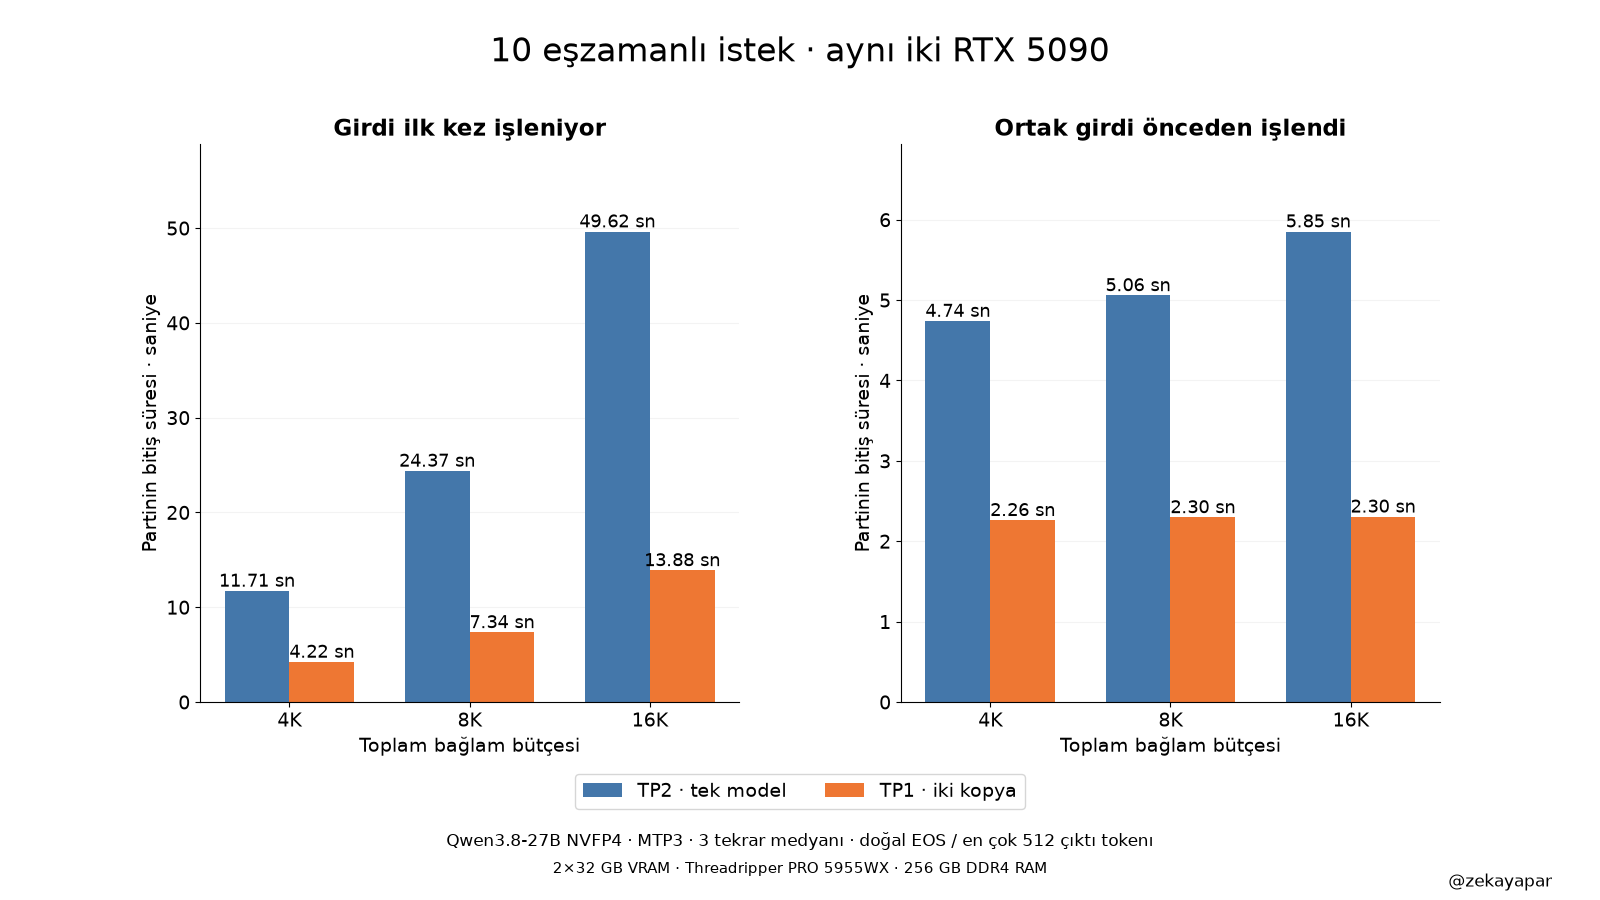
| 10 istek · girdi ilk kez işleniyor | TP2 tek model | İki TP1 kopya |
|---|---|---|
| 4K | 11,71 sn | 4,22 sn |
| 8K | 24,37 sn | 7,34 sn |
| 16K | 49,62 sn | 13,88 sn |
Bu yükte iki kopya daha kısa parti süresi verdi. 16K/10 istekte, girdi ilk kez işlenirken gerçek çıktı throughput’unun medyanı TP2’de 27,19, iki kopyada 92,91 token/sn oldu. Bunlar toplam çıktı hızı; kişi başına hız değil. Aynı hücrede ilk token p50/p95 TP2’de 26,42/48,08 saniye, iki kopyada 7,73/12,95 saniye; tekil toplam yanıt p95 ise 50,82 ve 13,84 saniyeydi.
İstenen çıktı sınırı aynı olsa da modelin doğal bitişi nedeniyle üretilen token sayısı aynı çıkmadı. 16K/10 ilk işleme koşulunun üç partisinde TP2 toplam 4.089, iki kopya 3.769 çıktı tokenı üretti. Bu yüzden yalnız duvar zamanı oranını “aynı sayıda tokenı şu kadar hızlı üretti” diye yorumlamıyorum.
Tek istekte kazanan her zaman aynı değil
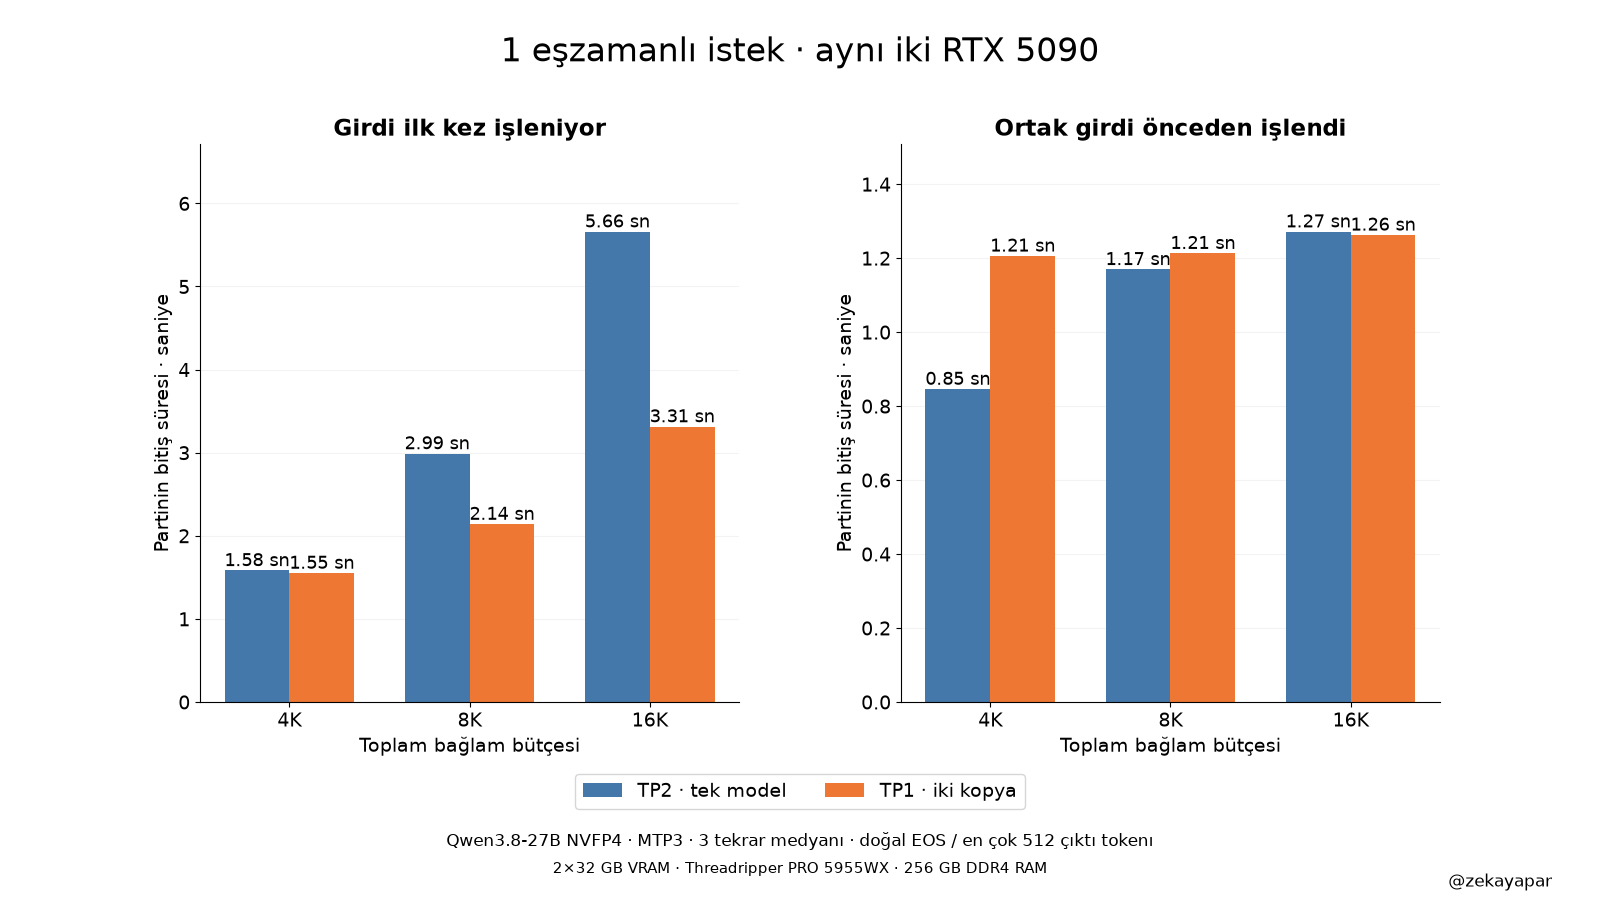
4K girdinin ortak kısmı önceden işlenmişken tek isteğin bitişi TP2’de 0,85 saniye, tek TP1 kopyada 1,21 saniyeydi. 16K girdi ilk kez işlenirken ise TP2 5,66 saniye, TP1 3,31 saniye sürdü. Birden fazla istekte iki kopya bu ölçümde açıkça avantajlıydı; tek sohbet için karar girdinin uzunluğuna ve cache durumuna göre değişiyor.
Neyi söyleyebilirim
Bu model tek 5090’a sığdığı için iki tam kopya çalıştırma seçeneği vardı. Uzun, farklı girdileri birden fazla isteğe dağıtırken bu seçenek benim testimde daha iyi sonuç verdi. Model tek karta sığmıyorsa aynı seçim zaten mümkün olmayabilir. İki ayrı kopyada ağırlıklara ayrılan toplam bellek büyür, cache paylaşımı da iki havuza bölünür.
İki engine’in kuyrukları ve TP2’nin tek kuyruğu gözlendi. Ancak istek başına saf kuyruk süresini ayrı ölçmedim. Kartlar arası iletişim olası bir açıklama; profiler kaydı olmadan hız farkının tamamını buna bağlamıyorum. MTP bu iki testte de açıktı; buradan MTP açık/kapalı sonucu çıkarılamaz.
Belgeler sentetikti: üç hedef kayıt başlangıç, orta ve sona yerleştirildi; dördüncü istenen kayıt yoktu. Cevapta tutar, kaynak kimliği ve bulunmayan bilgi için null kontrol edildi. Embedding ile kaynak getirme, OCR, gerçek kullanıcı trafiği veya geniş bir kalite değerlendirmesi yapılmadı. On HTTP isteği göndermek de on kişinin aynı anda kesintisiz decode yaptığı anlamına gelmiyor.
Ölçümlerden sonra geçici servisleri kapatıp mevcut üretim profilini geri açtım. Gerçek JSON yanıtını, ana servis betiğinin değişmediğini ve diğer servislerin PID’lerini kontrol ettim. Kalıcı yerleşimi bu sonuçla otomatik değiştirmedim.
Teknik kaynak
13 Ekim 2026 ölçümleri. vLLM 0.30.0, PyTorch 2.13.0+cu132, Transformers 5.18.0, FlashInfer 0.6.18.post1. NVIDIA Qwen3.8-27B-NVFP4 revision 482ca0f3832238542f8f5295dde86b5f22711d80. İlk çalışma 288 ölçüm, 48 ısınma, 27 primer; yerleşim çalışması 576 ölçüm, 180 ısınma ve iki engine için ayrı primerlar. Ham istek, SSE, yanıt, token ve telemetri kayıtları saklandı.
Yöntem kavramları: vLLM paralellik ve ölçekleme belgesi ↗. Önceki yazılar: MTP doğruluk ve eşzamanlı istek testi · Prefix cache denemesi · Bir, iki ve üç kartta Qwen.